

zhrnutie:
- Strojové učenie hľadá vzory v dátach. Ale umelá inteligencia môže byť „predpojatá“ – to znamená, že nájde nesprávne vzory. Napríklad, systém na detekciu rakoviny kože z fotografie môže osobitne zohľadniť snímky urobené v lekárskej ordinácii. Strojové učenie nevie rozumieť: jeho algoritmy len odhaľujú vzory v číslach a ak dáta nie sú reprezentatívne, taký bude aj výsledok ich spracovania. A odhaľovať takéto chyby môže byť zložitá úloha kvôli samotnej mechanike strojového učenia.
- Najzrejmejšou a najstrašnejšou problémovou oblastou je ľudská rozmanitosť. Existuje množstvo dôvodov, prečo dáta o ľuďoch môžu strácať objektívnosť už v fáze zberu. Ale netreba si myslieť, že tento problém sa týka len ľudí: podobné ťažkosti sa objavujú aj pri pokuse odhaliť povodeň v sklade alebo poruchu plynového turbíny. Niektoré systémy môžu mať predsudky voči farbe pokožky, iné budú mať zaujatý prístup k senzorom Siemens.
- Tieto problémy nie sú nové pre strojové učenie a nie sú typické len pre neho. Nesprávne predpoklady sa robia v akýchkoľvek zložitých štruktúrach a porozumieť, prečo bolo prijaté konkrétne rozhodnutie, je vždy zložité. S týmto treba bojovať komplexne: vytvárať nástroje a procesy na overovanie – a vzdelávať používateľov, aby neslepo nasledovali odporúčania AI. Strojové učenie naozaj robí niektoré veci oveľa lepšie ako my – ale psy, napríklad, sú omnoho efektívnejšie ako ľudia pri odhaľovaní drog, čo nie je dôvod na ich angažovanie ako svedkov a na základe ich výpovedí vynášanie rozsudkov. A psy, ak môžem podotknúť, sú oveľa múdrejšie ako akýkoľvek systém strojového učenia.
Strojové učenie dnes predstavuje jeden z najdôležitejších základných technických trendov. Je to jeden z hlavných spôsobov, ktorými technológia zmení okolitý svet v nasledujúcom desaťročí. Niektoré aspekty týchto zmien vzbudzujú obavy. Napríklad potenciálny vplyv strojového učenia na trh práce alebo jeho využitie na neetické účely (napríklad autoritárskymi režimami). Existuje ešte jeden problém, ktorému sa tento príspevok venuje: predpojatost' umelej inteligencie.
Toto nie je jednoduchý príbeh.
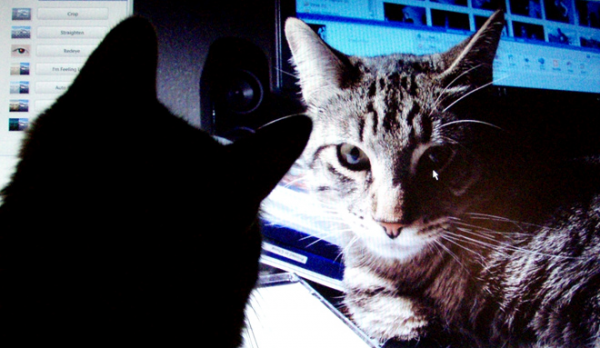
AI od Google dokáže nájsť mačky. Táto správa z roku 2012 bola v tom čase niečím výnimočným.
Čo je „predpojatosť AI“?
„Surové dáta“ sú zároveň oxymoron a zlý nápad; dáta je potrebné dobre a starostlivo spracovať. —Jeffrey Boker
Až do niekedy v roku 2013 bolo potrebné pri vytváraní systému, ktorý napríklad rozpoznáva mačky na fotografiách, popisovať logické kroky. Ako nájsť rohy na obrázku, rozpoznať oči, analyzovať textúry na prítomnosť kožušiny, spočítať labky a tak ďalej. Potom zhromaždiť všetky komponenty — a zistiť, že to všetko v podstate nefunguje. Pripomínalo to mechanického koňa — teoreticky to je možné vyrobiť, ale v praxi je to príliš zložité na opis. Na výstupe máte stovky (alebo dokonca tisíce) ručne napísaných pravidiel. A ani jednu fungujúcu model.
S príchodom strojového učenia sme prestali používať „ručné“ pravidlá na rozpoznávanie toho-ktorého objektu. Namiesto toho vezmeme tisíc vzoriek „toho“, X, tisíc vzoriek „iného“, Y, a prinútime počítač vytvoriť model na základe ich štatistickej analýzy. Potom tejto modelu poskytneme nejaký príklad dát a ona s určitou presnosťou určí, či patrí do jednej z množín. Strojové učenie generuje model na základe dát, nie pomocou človeka, ktorý ho napíše. Výsledky sú pôsobivé, najmä v oblasti rozpoznávania obrázkov a vzorov, a preto sa celá technologická industría teraz presúva k strojovému učeniu (ML).
Ale nie je všetko tak jednoduché. V reálnom svete vaše tisíce príkladov X alebo Y obsahujú aj A, B, J, L, O, R a dokonca aj L. Môžu byť rozložené nerovnomerne, a niektoré z nich sa môžu vyskytovať tak často, že systém na ne priradí väčšiu pozornosť ako objektom, ktoré vás zaujímajú.
Čo to znamená v praxi? Môj obľúbený príklad je, keď systémy rozpoznávania obrázkov . Je jasné, prečo: väčšina fotografií-príkladov „ovce“ bola vyrobená na lúkach, kde žijú, a na týchto obrázkoch tráva zaberá oveľa viac miesta ako malé biele nadýchané tvory, a práve trávu systémy považujú za najdôležitejšiu.
Sú aj vážnejšie príklady. Z nedávnych — jeden o detekciu rakoviny kože na fotografiách. Ukázalo sa, že dermatológovia často fotografujú pravítko spolu s prejavmi rakoviny kože, aby zdokumentovali veľkosť útvarov. Na príkladoch fotografií zdravej kože pravítka nie sú. Pre systém AI sa tieto pravítka (presnejšie, pixely, ktoré určíme ako „pravítko“) stali jedným z rozlišovacích znakov medzi súbormi vzoriek, a niekedy sú dôležitejšie ako malé vyrážky na koži. Tak systém navrhnutý na rozpoznávanie rakoviny kože niekedy namiesto toho rozpoznal pravítka.
Kľúčovým aspektom je to, že systém nemá semantické pochopenie toho, na čo sa pozerá. My sa pozeráme na súbor pixelov a vidíme v nich ovcu, kožu alebo pravítka, zatiaľ čo systém vidí len číselný reťazec. On nevidí trojrozmerný priestor, nevidí ani objekty, ani textúry, ani ovce. Vníma len vzory v dátach.
Zložitost diagnostiky takýchto problémov spočíva v tom, že neurónová sieť (model vytvorený vaším systémom strojového učenia) pozostáva zo tisícov, stotisícov uzlov. Neexistuje jednoduchý spôsob, ako nazrieť do modelu a zistiť, ako prijíma rozhodnutia. Existencia takého spôsobu by znamenala, že proces je dostatočne jednoduchý na to, aby sa dali všetky pravidlá popísať manuálne, bez použitia strojového učenia. Ľudia sa obávajú, že strojové učenie sa stalo akýmsi „čiernym boxom“. (Neskôr vysvetlím, prečo je toto porovnanie trochu prehnané.)
To, v základných rysoch, je problém zaujatosti umelého inteligencie alebo strojového učenia: systém na hľadanie vzorov v dátach môže nájsť nesprávne vzory, a vy si toho nemusíte všimnúť. To je základná vlastnosť technológie a je to jasné každému, kto s ňou pracuje v vedeckých kruhoch a vo veľkých technologických firmách. Ale jej následky sú zložité a naše možné riešenia týchto následkov sú tiež.
Najprv sa pozrime na následky.
AI môže implicitne robiť rozhodnutia v prospech určitých kategórií ľudí, založené na množstve nepostrehnuteľných signálov.
Scenáre zaujatosti AI
Najzjavnejšie a najdesivejšie je, že tento problém sa môže prejaviť, keď ide o ľudskú rozmanitosť. Nedávno , že Amazon sa pokúsil vytvoriť systém strojového učenia na prvotné hodnotenie uchádzačov o zamestnanie. Keďže medzi zamestnancami Amazonu je viac mužov, príklady "úspešného zamestnania" sú taktiež častejšie mužského pohlavia, a v súbore životopisov, ktoré systém navrhol, bolo viac mužov. Amazon si to všimol a systém neuviedol do produkcie.
Najdôležitejšie na tomto príklade je, že systém sa údajne uprednostňoval uchádzačov mužského pohlavia, aj keď pohlavie nebolo v životopise uvedené. Systém zaznamenal iné vzory v príkladoch "úspešného zamestnania": napríklad, ženy môžu používať špeciálne slová na opis svojich úspechov alebo mať špeciálne koníčky. Samozrejme, systém nevedel, čo je "hokej", ani kto sú "ľudia", ani čo je "úspech" — robil len štatistickú analýzu textu. Ale vzory, ktoré videl, by pravdepodobne ostali nepovšimnuté človekom a niektoré z nich (napríklad to, že muži a ženy opisujú úspech rôznymi spôsobmi) by sme pravdepodobne ťažko spozorovali, aj keby sme na ne pozerali.
Ďalej — je to horšie. Systém strojového učenia, ktorý veľmi dobre rozpoznáva rakovinu na blednej pleti, môže fungovať horšie s tmavou pleťou, alebo naopak. Nie nutne kvôli zaujatosti, ale preto, že pravdepodobne potrebujete vytvoriť pre iný odtieň pleti samostatný model, ktorý vyberie iné charakteristiky. Systémy strojového učenia nie sú zamieňateľné ani v takej úzkej oblasti, ako je rozpoznávanie obrazov. Musíte nastavovať systém, niekedy len cez experimentovanie, aby ste správne postrehli charakteristiky v údajoch, ktoré vás zaujímajú, až kým nedosiahnete požadovanú presnosť. Ale nemusíte si všimnúť, že systém je vo 98 % presný pri práci s jednou skupinou a len v 91 % (aj keď je to presnejšie ako analýza vykonaná človekom) — s inou.
Doteraz som používal najmä príklady týkajúce sa ľudí a ich charakteristík. Na tejto téme sa diskusia okolo tohto problému prevažne sústreďuje. Ale je dôležité pochopiť, že zaujatost voči ľuďom je len časťou problému. Budeme používať strojové učenie na množstvo vecí a chyba výberu bude relevantná pre všetky z nich. Na druhej strane, ak pracujete s ľuďmi, môže byť zaujatost údajov spojená nie s nimi.
Aby sme to pochopili, vráťme sa k príkladu s rakovinou kože a zvážme tri hypotetické možnosti zlyhania systému.
- Nerovnomerné rozloženie ľudí: nevyvážený počet fotografií pleti rôznych odtieňov, čo vedie k falošne pozitívnym alebo falošne negatívnym výsledkom týkajúcim sa pigmentácie.
- Data, na ktorých sa systém trénuje, obsahujú často sa vyskytujúcu a nerovnomerne rozloženú charakteristiku, ktorá nie je spojená s ľuďmi a nemá diagnostickú hodnotu: pravítko na fotografiách prejavov rakoviny kože alebo trávu na fotografiách oviec. V takom prípade sa výsledok bude líšiť, ak systém na obrázku nájde pixely niečoho, čo by ľudské oko identifikovalo ako "pravítko".
- Data obsahujú vonkajšiu charakteristiku, ktorú človek nemôže vidieť, ani keby ju hľadal.
Čo to znamená? A priory vieme, že dáta môžu rôzne reprezentovať rôzne skupiny ľudí, a minimálne môžeme naplánovať hľadanie podobných výnimiek. Inými slovami, existuje mnoho sociálnych dôvodov predpokladať, že dáta o skupinách ľudí už obsahujú isté predsudky. Ak sa pozrieme na fotografiu s pravítkom, uvidíme toto pravítko — jednoducho sme ho predtým ignorovali, pretože sme vedeli, že nemá význam, a zabudli sme, že systému nič nie je známe.
Ale čo ak sú všetky vaše fotografie nezdravej pleti vyrobené v kancelárii, kde sa používajú žiarovky, a zdravej — pri fluorescenčnom svetle? Čo ak ste, keď ste skončili so snímaním zdravej pleti, pred snímaním nezdravej aktualizovali operačný systém na telefóne, a Apple alebo Google trochu zmenil algoritmus potláčania šumu? Človek to nemusí zaregistrovať, bez ohľadu na to, koľko by takýchto vlastností hľadal. Systém strojového učenia to okamžite uvidí a využije. On o ničom nevie.
Zatiaľ sme hovorili o falošných koreláciách, ale môže sa stať aj to, že údaje sú presné a výsledky správne, no z etických, právnych alebo manažérskych dôvodov ich nechcete používať. V niektorých jurisdikciách, napríklad, nie je povolené poskytovať ženám zľavu na poistenie, aj keď ženy môžu bezpečnejšie šoférovať. Ľahko si môžeme predstaviť systém, ktorý pri analýze historických údajov pridelí ženským menám nižší koeficient rizika. Dobre, odstráňme mená z výberu. Ale spomeňte si na príklad s Amazonom: systém môže určiť pohlavie na základe iných faktorov (aj keď nevie, čo je pohlavie, a čo je auto), a vy si toho nevšimnete, kým regulátor spätne neanalyzuje ponúkané tarifné plány a nevymôže od vás pokutu.
Nakoniec sa často predpokladá, že takéto systémy budeme používať iba pre projekty, ktoré súvisia s ľuďmi a sociálnymi interakciami. To nie je pravda. Ak vyrábate plynové turbíny, určite budete chcieť aplikovať strojové učenie na telemetriu, ktorú prenáša desiatky alebo stovky senzorov na vašom produkte (audio-, video-, teplotné a akékoľvek iné senzory generujú údaje, ktoré sa veľmi ľahko dajú prispôsobiť na vytvorenie modelu strojového učenia). Hypoteticky môžete povedať: "Tu sú údaje o tisícke poruchových turbín, získané pred ich poruchou, a tu sú údaje z tisícky turbín, ktoré sa neporuchovali. Vytvorte model, ktorý určí, v čom je medzi nimi rozdiel." A teraz si predstavte, že senzory Siemens sú na 75 % zlých turbín a iba na 12 % dobrých (pričom nie je žiadna súvislosť so zlyhaniami). Systém vytvorí model, aby našiel turbíny so senzormi Siemens. Ups!

Obrázok — Moritz Hardt, UC Berkeley
Riadenie predsudkov AI
Čo s tým môžeme urobiť? Môžeme sa na otázku pozrieť z troch strán:
- Metodologická prísnosť pri zbieraní a správe údajov pre učenie systému.
- Technické nástroje na analýzu a diagnostiku správania modelu.
- Školenie, vzdelávanie a opatrnosť pri implementácii strojového učenia do produktov.
V knihe „Mestský človek v šľachte“ od Molièra je vtip: jednému mužovi povedali, že literatúra sa delí na prózu a poéziu, a on s obdivom zistí, že celý život hovoril prózou, ani o tom nevediac. Pravdepodobne sa štatistiky cítia dnes podobne: bez toho, aby si to uvedomili, zasvätili svoje kariéry umelej inteligencii a chybe vzorkovania. Hľadať chybu vzorkovania a trápiť sa kvôli nej — to nie je nová otázka, musíme sa k jej riešeniu postaviť systematicky. Ako už bolo spomenuté, v niektorých prípadoch je naozaj jednoduchšie to robiť, keď skúmame problémy spojené s údajmi o ľuďoch. A priori predpokladáme, že môžeme mať predsudky voči rôznym skupinám ľudí, ale predsudok voči senzorom Siemens si ťažko dokážeme predstaviť.
Nové na tom všetkom je, že ľudia sa už priamo nezapájajú do štatistickej analýzy. Tú vykonávajú stroje, ktoré vytvárajú veľké zložené modely, ťažko pochopiteľné. Otázka transparentnosti je jedným z hlavných aspektov problému zaujatosti. Bojíme sa, že systém nie je len zaujatý, ale že neexistuje žiadna možnosť odhaliť jeho predpojatosti, a že strojové učenie sa tým líši od iných foriem automatizácie, ktoré sa predpokladajú, že pozostávajú z jasných logických krokov, ktoré je možné overiť.
Sú tu dve problémy. Možno by sme mohli vykonať určitý audit systémov strojového učenia. A audit akejkoľvek inej sústavy nie je vlastne o nič jednoduchší.
Po prvé, jedným z smerov súčasného výskumu v oblasti strojového učenia je hľadanie metód, ako identifikovať dôležité funkcie systémov strojového učenia. Strojové učenie (v jeho aktuálnom stave) je úplne nová oblasť vedy, ktorá sa rýchlo mení, takže netreba predpokladať, že dnes nemožné veci sa čoskoro nemôžu stať celkom skutočnými. Projekt — je zaujímavý týmto príkladom.
Po druhé, myšlienka, že je možné overovať a rozumieť procesu rozhodovania v existujúcich systémoch alebo organizáciách, je dobrá teoreticky, ale na prax nie veľmi. Pochopiť, ako sa rozhoduje vo veľkej organizácii, vôbec nie je jednoduché. Aj keď existuje formálny proces rozhodovania, neodráža to, ako sa ľudia v skutočnosti interactujú, a sami často nemajú logický systémový prístup k prijímaniu svojich rozhodnutí. Ako povedal môj kolega , ľudia sú tiež čierne skrinky.
Zoberte tisíc ľudí z niekoľkých prekrývajúcich sa spoločností a inštitúcií a problém sa stane ešte zložitejším. Po skutočnosti vieme, že „Space Shuttle“ bolo predurčené rozpadnúť sa na kusy pri návrate, a jednotliví ľudia v NASA mali informácie, ktoré im dávali dôvod myslieť si, že sa môže stať niečo zlé, ale systém vo všeobecnosti to nevedel. NASA práve prešla podobným auditom, keď stratila predchádzajúci shuttle, a predsa stratila ďalší — z veľmi podobného dôvodu. Je ľahké tvrdiť, že organizácie a ľudia dodržiavajú prísne logické pravidlá, ktoré je možné overiť, pochopiť a zmeniť — ale skúsenosti dokazujú opak. Toto je "».
Často porovnávam strojové učenie s databázami, najmä s relačnými — novou základnou technológiou, ktorá zmenila možnosti informatiky a svet okolo nej, ktorá sa stala súčasťou všetkého, čo neustále používame, aniž by sme si to uvedomovali. V databázach sú tiež problémy podobného charakteru: systém môže byť postavený na nesprávnych predpokladoch alebo na zlých údajoch, ale ťažko sa to dá postrehnúť a ľudia, ktorí systém používajú, budú robiť to, čo im hovorí, bez kladenia otázok. Existuje množstvo starých vtipov o pracovníkoch daňového úradu, ktorí raz nesprávne zapísali vaše meno, a presvedčiť ich, aby chybu opravili, je omnoho ťažšie, než skutočne zmeniť meno. O tom sa dá uvažovať rôzne, ale nie je jasné, ako lepšie: ako o technickom probléme v SQL, alebo ako o chybe vo vydaní Oracle, alebo ako o poruche byrokratických inštitútov? Aké ťažké je nájsť chybu v procese, ktorý viedol k tomu, že systém nemá takú funkciu, ako oprava preklepov? Mohlo sa to zistiť skôr, než začali ľudia sťažovať?
Túto problematiku ešte jednoduchšie ilustrujú príbehy, keď vodiči kvôli zastaraným údajom v navigátore odbočia do riek. Dobre, mapy by sa mali neustále aktualizovať. Ale do akej miery môže byť TomTom zodpovedný za to, že vašu auto odváža do mora?
Hovorím to preto, že áno — predsudky strojového učenia prinesú problémy. Ale tieto problémy budú podobné tým, ktorým sme čelili v minulosti, a dá sa ich všimnúť a vyriešiť (alebo nie) zhruba tak dobre, ako to bola naša predchádzajúca skúsenosť. Preto je pravdepodobné, že scenár, v ktorom predsudok AI spôsobí škodu, sa zrejme nevyskytne u popredných výskumníkov pracujúcich vo veľkej organizácii. Skôr sa nejaký bezvýznamný technologický dodávateľ alebo dodávateľ softvéru rozhodne napísať niečo na kolene, pričom použije nezrozumiteľné open source komponenty, knižnice a nástroje. A nešťastný klient sa nechá oklamať frázou „umelá inteligencia“ v opise produktu a bez zbytočných otázok ho rozdá svojim nízkopríjmovým zamestnancom, nútiac ich robiť to, čo povie AI. To sa presne stalo s databázami. Nie je to problém umelej inteligencie ani problém softvéru. Je to ľudský faktor.
Záver
Strojové učenie môže dosiahnuť všetko, čo môžete naučiť psa — ale nikdy nemôžete byť si istí, čo presne ste tohto psa naučili.
Často mám pocit, že termín „umelá inteligencia“ len bráni diskusiám ako je táto. Tento termín vytvára falošný dojem, že sme ju skutočne vytvorili – túto inteligenciu. Že sme na ceste k HAL9000 alebo Skynet – k niečomu, čo naozaj chápe. Ale nie. Sú to len stroje a je oveľa presnejšie ich porovnávať napríklad s práčkou. Práčka sa oveľa lepšie postará o pranie ako človek, ale ak do nej dáte riad namiesto oblečenia, ten riad… oprať. Riad bude dokonca čistý. Ale nebude to to, čo ste očakávali, a stane sa to nie preto, že by systém mal nejaké predsudky voči riadu. Práčka nevie, čo je riad, ani čo je oblečenie – je to len príklad automatizácie, ktorý sa konceptuálne nelíši od toho, ako sa procesy automatizovali predtým.
O čomkoľvek sa hovorí – o strojoch, lietadlách alebo databázach – tieto systémy budú zároveň veľmi mocné a veľmi obmedzené. Budú úplne závislé od toho, ako ich ľudia používajú, aké dobré alebo zlé majú pri tom úmysly a do akej miery rozumejú ich fungovaniu.
Preto je tvrdiť, že „umelá inteligencia je matematika, takže nemôže mať predsudky“, úplne nesprávne. Ale rovnako nepresné je tvrdiť, že strojové učenie je „subjektívne vo svojej podstate“. Strojové učenie nachádza vzory v dátach a aké vzory nájde, závisí od dát, a dáta závisia od nás. Rovnako ako to, čo s nimi robíme. Strojové učenie naozaj robí niektoré veci oveľa lepšie ako my – ale psy, napríklad, sú oveľa efektívnejšie ako ľudia pri odhaľovaní drog, čo vôbec nie je dôvod na to, aby sme ich považovali za svedkov a vynášali rozsudky na základe ich výpovedí. A psy, mimochodom, sú oveľa inteligentnejšie ako akýkoľvek systém strojového učenia.
Preklad: .
Redakcia: .
Komunita: .
Zdroj: habr.com
