

Spoločnosť Stability AI vydala druhú verziu systému strojového učenia Stable Diffusion, ktorý dokáže syntetizovať a upravovať obrázky na základe predloženého vzoru alebo textového opisu v prirodzenom jazyku. Kód nástrojov na učenie neurónovej siete a generovanie obrázkov je napísaný v jazyku Python s využitím rámca PyTorch a je zverejnený pod licenciou MIT. Už naučené modely sú otvorené pod permisívnou licenciou Creative ML OpenRAIL-M, ktorá povoľuje využitie na komerčné účely. Navyše je k dispozícii demonštračný online generátor obrázkov.
Kľúčové vylepšenia v novej verzii Stable Diffusion:
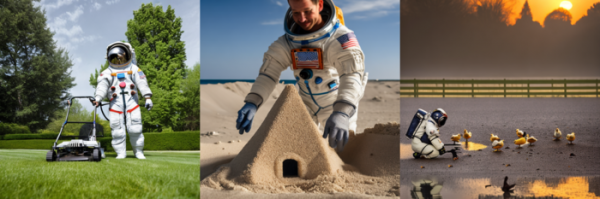
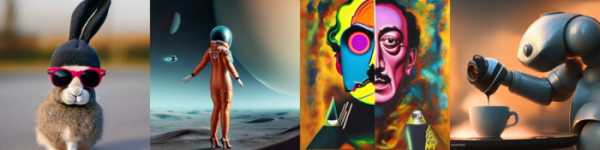
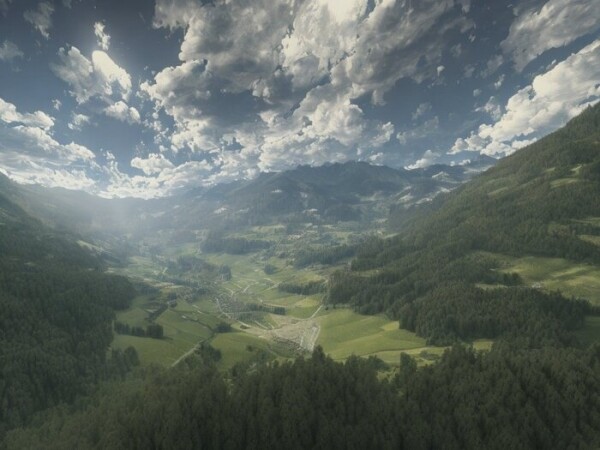
- Bola vytvorená nová modelová syntéza obrázkov na základe textového opisu — SD2.0-v, ktorá podporuje generovanie obrázkov s rozlíšením 768×768. Nový model bol trénovaný pomocou zbierky LAION-5B, ktorá obsahuje 5,85 miliardy obrázkov s textovými popismi. Model používa rovnakú sadu parametrov ako model Stable Diffusion 1.5, ale líši sa prechodom na použitie zásadne iného kodéra OpenCLIP-ViT/H, čo umožnilo podstatne zvýšiť kvalitu výsledných obrázkov.

- Bol pripravený zjednodušený variant SD2.0-base, trénovaný na obrázkoch 256×256 s využitím klasického modelu predpovedania šumu a podporujúci generovanie obrázkov s rozlíšením 512×512.

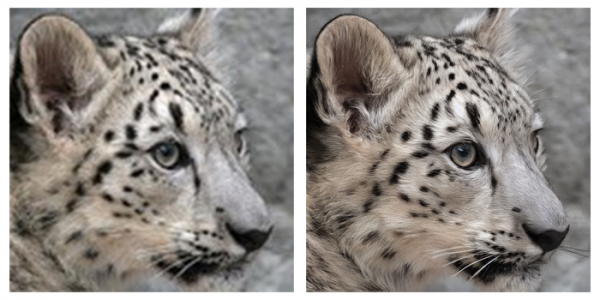
- Bola poskytnutá možnosť využitia technológie supersampling (Super Resolution) na zvýšenie rozlíšenia pôvodného obrázka bez zníženia kvality, pomocou algoritmov priestorového škálovania a rekonštrukcie detailov. Poskytnutý model spracovania obrázkov (SD20-upscaler) podporuje štvornásobné zvýšenie mierky, čo umožňuje generovať obrázky s rozlíšením 2048×2048.

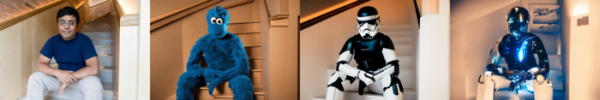
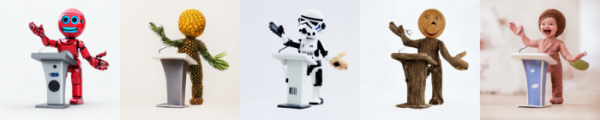
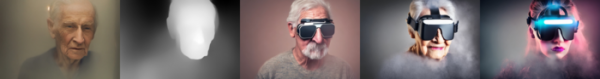
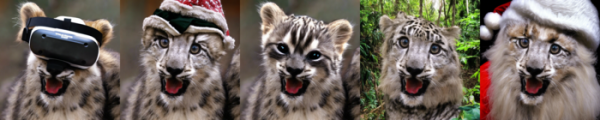
- Bola navrhnutá model SD2.0-depth2img, ktorá zohľadňuje hĺbku a priestorové usporiadanie objektov. Na monokulárne hodnotenie hĺbky sa používa systém MiDaS. Model umožňuje syntetizovať nové obrázky s použitím iného obrázka ako šablóny, ktoré sa môžu radikálne odlišovať od originálu, ale zachovávajú celkovú kompozíciu a hĺbku. Napríklad je možné použiť postoj osoby na fotografii na vytvorenie inej postavy v tej istej póze.


- Model for image modification has been updated — SD 2.0-inpainting, allowing parts of an image to be replaced and altered using text prompts.
- Models have been optimized for use on standard systems with a single GPU.
Zdroj: opennet.ru
