

V rámci výskumného projektu sa začala práca na pridávaní možnosti do GCC, ktorá umožňuje rozdeľovať proces kompilácie na niekoľko paralelne vykonávaných vlákien. V súčasnosti sa na zvýšenie rýchlosti zostavovania na viacjadrových systémoch na úrovni nástroja make používa spúšťanie jednotlivých procesov kompilátora, z ktorých každý vykonáva zostavovanie samostatného súboru s kódom. Nový projekt experimentuje s poskytovaním paralelizácie na úrovni kompilátora, čo potenciálne umožní zvýšiť efektivitu práce na viacjadrových systémoch.
Na testovanie samostatná paralelizovaná vetva GCC, pre ktorú bol navrhnutý nový parameter "--param=num-threads=N" na nastavenie počtu vlákien. V počiatočnej fáze bola realizovaná extrakcia medzi procedurálnych optimalizácií do samostatných vykonávacích vlákien, ktoré sa cyklicky volajú pre každú funkciu a dobre sa podliehajú paralelizácii. Do samostatných vlákien boli extrahované operácie GIMPLE zodpovedajúce za optimalizácie nezávislé od hardvéru, hodnotiace vzájomné interakcie funkcií.
V nasledujúcej fáze sa plánuje tiež extrakcia medzi procedurálnych RTL-optimalizácií do samostatných vlákien, berúc do úvahy špecifiká hardvérovej platformy. Potom sa plánuje realizovať paralelizáciu vnútroprocedurálnych optimalizácií (IPA), ktoré sa aplikujú na kód vo vnútri funkcie, nezávisle od špecifík volania. Obmedzujúcim článkom zatiaľ zostáva zberateľ odpadu, do ktorého bola pridaná globálna blokácia, ktorá vypína operácie zberu odpadu počas práce v multithreadovom režime (v budúcnosti bude zberateľ odpadu prispôsobený na viacvláknové vykonávanie GCC).
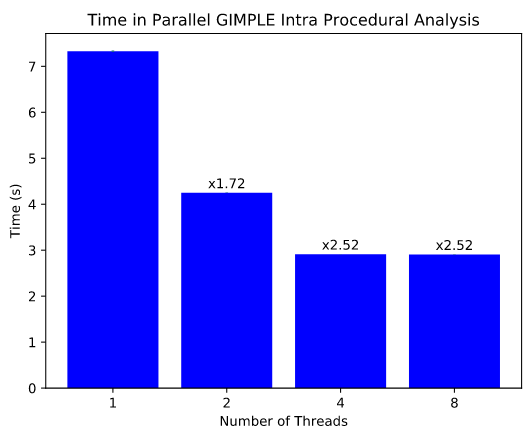
Na hodnotenie zmien výkonu bol pripravený testovací súbor, ktorý zostavuje súbor gimple-match.c s viac ako 100 000 riadkami kódu a 1700 funkciami. Testy na systéme s CPU Intel Core i5-8250U s 4 fyzickými jadrami a 8 virtuálnymi (Hyperthreading) ukázali zníženie času výkonu optimalizácií Intra Procedural GIMPLE z 7 na 4 sekundy pri spustení 2 vlákien a na 3 sekundy pri spustení 4 vlákien, čo predstavuje zvýšenie rýchlosti posudzovanej fázy zostavy o 1,72 a 2,52-krát, príslušne. Testy tiež ukázali, že používanie virtuálnych jadier pri Hyperthreading nevedie k nárastu výkonu.
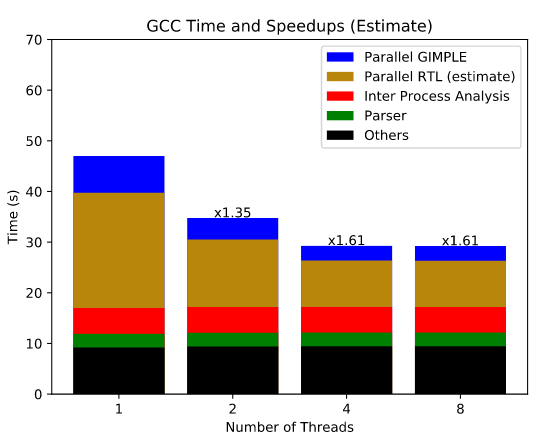
Celkový čas zostavenia sa skrátil približne o 10 %, no predpoklady naznačujú, že paralelizácia RTL-optimalizácií prinesie podstatnejšie výsledky, keďže táto fáza pri kompilácii trvá podstatne viac času. Odhaduje sa, že po paralelizácii RTL sa celkový čas zostavenia skráti o 1,61-krát. Po tomto sa ešte o 5-10 % dá skrátiť čas zostavenia prostredníctvom paralelizácie optimalizácií IPA.
Zdroj: opennet.ru
