

Vývojári OrioleDB analyzovali aktuálny stav nízkoúrovňového API, ktoré sa používa na prístup rozšírení k tabuľkám a indexom v PostgreSQL (Table/Index Access Method (AM) API), a navrhli možné zlepšenia. Od zavedenia tohto API v PostgreSQL 12 dostali vývojári možnosť vytvárať alternatívne mechanizmy ukladania dát. Napriek existencii tohto API a známej obmedzenosti vstavaného mechanizmu ukladania sa zatiaľ neobjavili plne funkčné transakčné úložné enginy, ktoré by boli implementované výhradne ako rozšírenia.
Najžiadanejšími funkciami pre alternatívne tabuľkové enginy PostgreSQL sú:
- Alternatívne implementácie MVCC, ako napríklad ukladania na základe UNDO žurnálu.
- Indexovo organizované tabuľky, kde index nie je len voliteľným doplnkom k tabuľke, ktorý urýchľuje dopyty, ale predstavuje hlavnú dátovú štruktúru, v ktorej sú uložené dáta tabuľky.
Zmeny potrebné v API Table/Index AM na podporu alternatívnych implementácií MVCC sa zvažujú s ohľadom na rozšírenie OrioleDB, ktoré bolo vyvinuté na odstránenie známych nedostatkov vstavaného mechanizmu ukladania PostgreSQL. Problém spočíva v tom, že na plnú integráciu OrioleDB s PostgreSQL sú potrebné úpravy kódu PostgreSQL, čo komplikuje zavádzanie projektu a podčiarkuje potrebu modernizácie súčasného API Table AM.
API Table AM priamo nenúti spôsob implementácie MVCC. Napriek tomu, API Table AM a API Index AM robia nasledujúce predpoklady: každé TID (Tuple/row Identifier) je buď indexované všetkými indexmi, alebo nie je indexované vôbec. Aj keď má Index AM niekoľko odkazov na jeden TID (napríklad GIN), všetky tieto odkazy musia zodpovedať jednej a tej istej indexovanej hodnote.
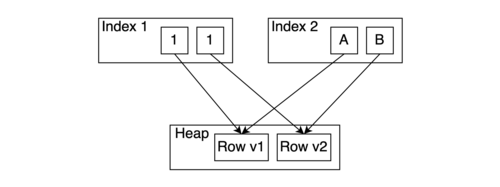
Tento princíp bol kritizovaný za zvyšovanie počtu operácií zápisu („write amplification“) — ak je aktualizovaný jeden indexovaný atribút, je potrebné aktualizovať každý index v tabuľke. Ak je potrebné plne využiť výhody UNDO žurnálu alebo vytvoriť iný spôsob ukladania bez „zvýšenia zápisu“ (napríklad metóda WARM), je potrebné porušiť tento predpoklad.
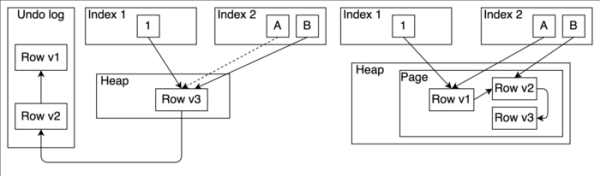
Table AM založený na UNDO, ktorý nebude porušovať túto predpoklad, pripomína existujúcu metódu HOT (Heap-Only Tuples), s výnimkou toho, že staré verzie riadkov sú uložené v protokole UNDO a nemusia sa zmestiť na tú istú stránku. Podľa autorov však táto výhoda nie je dostatočná na to, aby ospravedlnila existenciu samostatného Table AM.
Praktické obmedzenia existujúceho API:
- Počas aktualizácie riadku tabuľky sa indexy aktualizujú podľa princípu „všetko alebo nič“.
- V API Index AM chýba možnosť bodového vymazania určitých kótruxov. V súčasnosti je možné odstraňovať kótruxy z indexov masovo pomocou metód ambulkdelete a amvacuumcleanup. Pokus o implementáciu bodového vymazania cez toto API by viedol k nízkej efektivite, pretože väčšina súčasných implementácií musí prehľadávať celý index. Navyše API neumožňuje určiť, ktoré z kótruxov, odkazujúcich na rovnaké TID, by sa mali odstrániť. Môže odstrániť iba všetky.
- Indexy v súčasnosti odkazujú na riadky tabuľky podľa čísla bloku (32 bitov) a čísla posunutia (16 bitov). Iba 11 bitov čísla posunutia sa môže bezpečne prenášať z TID tabuľky do všetkých metód prístupu k indexu. V tomto ohľade alternatívne implementácie MVCC môžu potrebovať ukladať ďalšiu užitočnú záťaž (payload) spolu s TID. Napríklad v OrioleDB je potrebný jeden alebo niekoľko bitov na implementáciu indexov „delete-marking“ alebo úplných informácií o viditeľnosti.
Navrhnuté sú dva spôsoby, ako prekonávať obmedzenia v praxi:
Prístup 1: API Index AM poskytuje možnosti pre alternatívnu implementáciu MVCC.
Zatiaľ čo Table AM naďalej zodpovedá za všetky komponenty MVCC, Index AM poskytuje potrebné možnosti pre alternatívnu implementáciu MVCC, konkrétne: ukladanie používateľskej užitočnej záťaže (payload) spolu s TID, metódu bodového vymazania a dokonca aj metódu bodovej aktualizácie (ak TID v indexe nemôže byť zmenený, používateľská užitočná záťaž – môže). Okrem toho, pretože je potrebné povoliť viacerým kótruxom indexu odkazovať na rovnaké TID, metódy API používané pri skenovaní indexu tiež potrebujú aktualizáciu.
Prístup 2: Indexy podporujúce MVCC.
Alternatívou by bolo povoliť indexy podporujúce MVCC. T.j. „executora“ (alebo možno Table AM) jednoducho volá metódy insert() a delete() v Index AM, pričom Index AM poskytuje možnosť skenovania s ohľadom na MVCC. To by výrazne zjednodušilo skenovanie s využitím iba indexov (index-only). Dokonca by celý Table AM v takom prípade mohol fungovať ako medzivrstva, ktorá uchováva dáta v indexe.
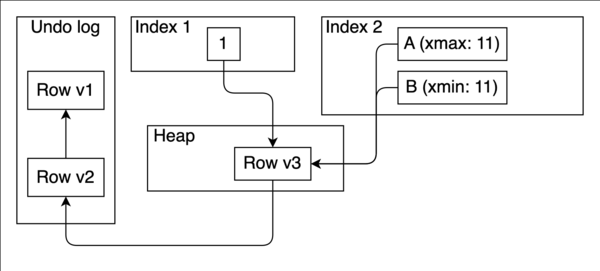
Na diagrame nižšie je uvedený príklad. Hodnota indexu 2 je aktualizovaná transakciou 11 z hodnoty „A“ na hodnotu „B“. Preto je hodnota „A“ označená ako xmax == 11, a hodnota „B“ je označená ako xmin == 11. Takto je možné skenovať index 2 a získavať iba viditeľné tuple podľa MVCC bez kontrol na hromade (heap). Garbage collection indexu 2 môže byť takisto vykonaná bez použitia hromady.
Pri implementácii všetkých uvedených inovácií do API indexových prístupových metód je nepravdepodobné, že by sa podarilo súčasne vylepšiť všetky indexy na podporu všetkých nových funkcií. Realistickejšie je povoliť niekoľko realizácií pre jednu indexovú prístupovú metódu. Napríklad, okrem bežného B-tree by rozšírenie mohlo implementovať alternatívne B-tree s podporou MVCC v rámci indexu a podporou identifikátorov záznamov ľubovoľnej dĺžky.
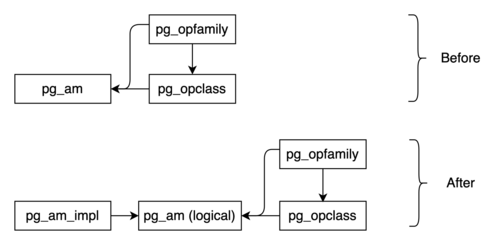
Týmto sa navrhuje prehodnotiť nielen API Table AM, ale aj API Index AM, ktoré verne slúžilo komunite PostgreSQL počas mnohých rokov. Navyše sa navrhuje rozdeliť Index AM na logickú vrstvu a vrstvu implementácie. Táto prehodnotená architektúra umožní PostgreSQL podporovať rôzne modely ukladania.
Zdroj: opennet.ru
