

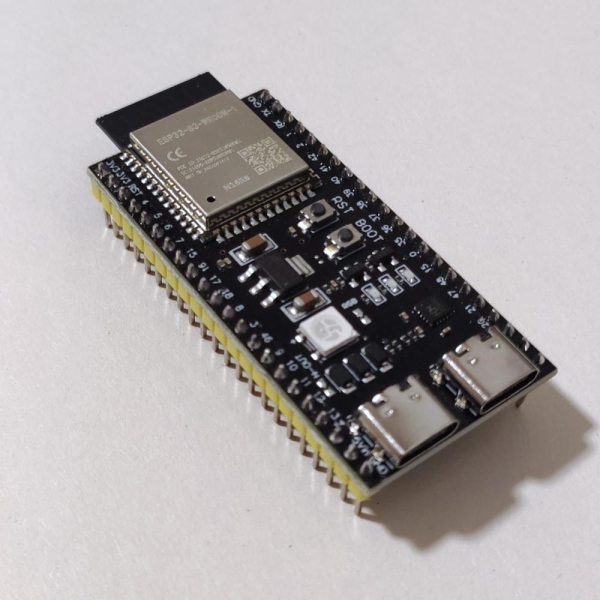
Vývojár Viacheslav Serbov, vystupujúci pod pseudonymom slvDev, predviedol úplne lokálnu generáciu textu na mikrokontroléri ESP32-S3. Vytvorený jazykový model obsahuje 28,9 milióna parametrov a generuje približne 9,9 tokenov za sekundu, bez prístupu na server alebo iné externé výpočtové zdroje. Vygenerované krátke príbehy sa zobrazujú na pripojenom OLED displeji.
Projekt esp32-ai bol testovaný na module ESP32-S3 N16R8 s 512 kB zabudovanej SRAM, 8 MB PSRAM a 16 MB flash pamäte. Kvantizovaný do štyroch bitov model zaberá 14,9 MB. V repozitári sú publikované zdrojové kódy vykonávacej prostredia v C, nástroje na učenie a kvantizáciu modelu, firmvér, testy a scénare jeho nahrávania na dosku.
Zverejnených 28,9 milióna parametrov by sa nemalo priamo porovnávať s počtom parametrov bežných desktopových LLM. Podľa podrobnej správy vývojára, model pozostáva z hustého výpočtového jadra s približne 559 tisíc parametrami, výstupnej vrstvy s 3,1 miliónmi parametrov a tabuľky po vrstvených vektorových predstaveniam s približne 25 miliónmi parametrov. Práve táto posledná zaisťuje väčšinu formálnej veľkosti modelu, ale nie je spracovaná celá pri generovaní každého tokenu.
Na umiestnenie modelu sa využívajú tri úrovne pamäte. Najčastejšie používané dáta sa nachádzajú v internej SRAM, výstupná vrstva, KV-cache a dočasné buffery — v PSRAM, zatiaľ čo 25-miliónová tabuľka zostáva vo flash pamäti a je dostupná cez zobrazenie v adresnom priestore. Pre každý token sa z nej číta len približne šesť riadkov s celkovým objemom približne 450 bajtov.
Toto zariadenie je založené na technológii Per-Layer Embeddings, aplikovanej Googlom v Gemma 3n. Podľa dokumentácie Googlu, PLE-parametre môžu byť uložené mimo pracovnej pamäte modelu a pridávané do procesu výstupu počas spracovania jednotlivých vrstiev. V esp32-ai je tento prístup prenesený na hierarchiu pamäte mikrokontroléra, kde je rýchla SRAM obzvlášť obmedzená.
Prvá správna verzia prostredia C pre vykonávanie kódu poskytovala len 0,57 tokena za sekundu. Po presunutí výstupnej vrstvy do PSRAM, prechode na osembitové aktivácie, rozdelení výpočtov medzi dva jadrá Xtensa LX7 a ďalších optimalizáciách sa oneskorenie znížilo na 94,9 ms na krok modelu. Konečná meraná rýchlosť dosiahla 9,88 tokena za sekundu pri zohľadnení celého procesu generovania. Hlavným obmedzením sa teraz stala šírka pásma PSRAM pri čítaní výstupnej vrstvy.
Model bol vyškolený na syntetickom dátovom súbore TinyStories, skladajúcom sa z jednoduchých anglicky písaných príbehov s obmedzeným slovníkom. Preto dokáže pokračovať vo frázach a vytvárať malé súvislé príbehy, ale nie je určený na odpovedanie na otázky, vykonávanie pokynov, programovanie alebo reprodukovanie skutočných znalostí. Vývojár považuje prácu predovšetkým za demonštráciu efektívneho umiestnenia modelu do pamäte mikrokontroléra, a nie ako pripraveného samostatného chatbotu.
V aktuálnej dokumentácii autor osobitne zdôrazňuje, že esp32-ai je samostatný projekt. Projekty llama2.c Andreyho Karpaty a skôr spustený model s 260 000 parametrami na ESP32-S3 sú uvedené iba ako orientačné body a príklady predchádzajúcich prác: kód, kontrolné body a metodika nie sú priamo prevzaté z nich. Zdrojový kód esp32-ai je šírený pod licenciou MIT.
Zdroj: linux.org.ru
