

V júni tohto roku sa v malebnom švajčiarskom meste Rapperswil už po desiaty raz uskutočnilo podujatie s názvom . Tentokrát sa na ňom zišlo viac ako päťsto nadšencov Haskellu, od začiatočníkov po otcov zakladateľov jazyka. Hoci organizátori nazývajú toto podujatie hackatónom, ani zďaleka nejde o konferenciu alebo hackatón v klasickom zmysle. Jeho formát sa od tradičných programátorských akcií líši. O ZuriHac sme sa dozvedeli náhodou, zúčastnili sme sa a teraz považujeme za našu povinnosť podeliť sa o túto zaujímavú skúsenosť!
O nás
Tento článok pripravili dvaja študenti 3. ročníka programu „Aplikovaná matematika a informatika“ na NÍU HSE — Peterburg: Vasilij Alfjorov a Elizaveta Vasilenková. Záujem o funkcionálne programovanie u nás oboch začal cyklom prednášok D. N. Moskvina v 2. ročníku univerzity. V súčasnosti sa Vasilij zúčastňuje programu Google Summer of Code, v rámci ktorého realizuje algebraické grafy v jazyku Haskell pod vedením tímu projektu . Elizaveta uplatnila nadobudnuté zručnosti v oblasti funkcionálneho programovania vo svojej diplomovej práci zameranej na realizáciu algoritmu anti-unifikácie s následným uplatnením v teórii typov.
Formát podujatia
Cieľovou skupinou sú vlastníci projektov s otvoreným zdrojovým kódom, programátori, ktorí sa chcú zapojiť do ich rozvoja, výskumníci funkcionálneho programovania a jednoducho zapálení Haskellisti. Tento rok sa na mieste konania – univerzite HSR Hochschule für Technik Rapperswil – zišli vývojári z viac ako päťdesiatich otvorených projektov v jazyku Haskell z celého sveta, aby sa podelili o svoje produkty a prilákali do ich rozvoja nových ľudí.
Fotografie z Twitteru
Schéma je veľmi jednoduchá: treba vopred napísať niekoľko viet o svojom projekte a poslať ich organizátorom, ktorí uverejnia informácie o vašom projekte na stránke podujatia. Okrem toho majú autori projektov v prvý deň tridsať sekúnd na to, aby veľmi stručne na scéne povedali, čomu sa venujú a čo je potrebné urobiť. Potom sa zaujímajúci ľudia hľadajú autorov a podrobne sa pýtajú na úlohy.
Aktuálne nemáme žiadne vlastné otvorené projekty, ale veľmi chceme prispieť k už existujúcim, a preto sme sa zaregistrovali ako bežní účastníci. Počas troch dní sme pracovali s dvoma skupinami vývojárov. Ukazuje sa, že spoločne skúmanie kódu a osobná komunikácia robí spoluprácu autorov projektu a prispievateľov veľmi produktívnou – na ZuriHac sme sa dokázali zorientovať v pre nás nových oblastiach a mohli sme pomôcť dvom úplne rozličným tímom, pričom v každom projekte sme uzavreli jednu úlohu.
Okrem cenných praktických skúseností sa počas ZuriHac konalo aj niekoľko prednášok a workshopov. Zapamätali sme si najmä dve prednášky. Na prvej z nich André Mohov z Newcastle University hovoril o selektívnych aplikatívnych funktoroch – triede typov, ktorá by sa mala stať medzičlánkom medzi aplikatívnymi funktorami a monádami. Na druhej prednáške jeden zo zakladateľov Haskellu, Simon Peyton Jones, rozprával o tom, ako funguje typová inference v kompilátore GHC.
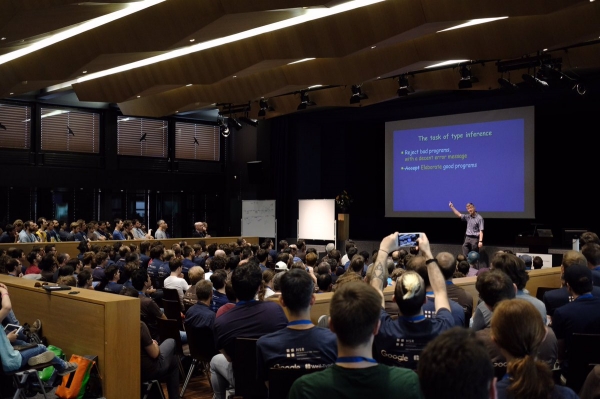
Prednáška Simona Peytona Jonesa. Foto z Twitteru
Workshopy, ktoré sa konali počas hackathonu, boli rozdelené do troch kategórií na základe úrovne prípravy účastníkov. Úlohy, ktoré boli ponúkané účastníkom zapájajúcim sa do vývoja projektov, tiež mali označenia so stupňom obtiažnosti. Početná, ale súdržná komunita funkčných programátorov s radosťou prijíma nováčikov do svojich radov. Na porozumenie prednáškam André Mohova a Simona Peytona Jonesa nám však veľmi pomohol kurz funkčného programovania, ktorý sme absolvovali na univerzite.
Pre bežných účastníkov aj autorov projektov je registrácia na podujatie bezplatná. Žiadosti o účasť sme podali v prvých dňoch júna, po čom sme boli pomerne rýchlo preložená z čakacej listiny na listinu potvrdených účastníkov.
A teraz vám povieme o projektoch, na ktorých sme sa podieľali na vývoji.
Pandoc
je univerzálny konvertor textových dokumentov, fakticky – z akéhokoľvek formátu do akéhokoľvek. Napríklad, z docx do pdf, alebo z Markdown do MediaWiki. Jeho autor John MacFarlane je profesor filozofie na Kalifornskej univerzite v Berkeley. Vo všeobecnosti je Pandoc pomerne známy a niektorí naši známi boli prekvapení, keď sa dozvedeli, že Pandoc je napísaný v Haskelli.
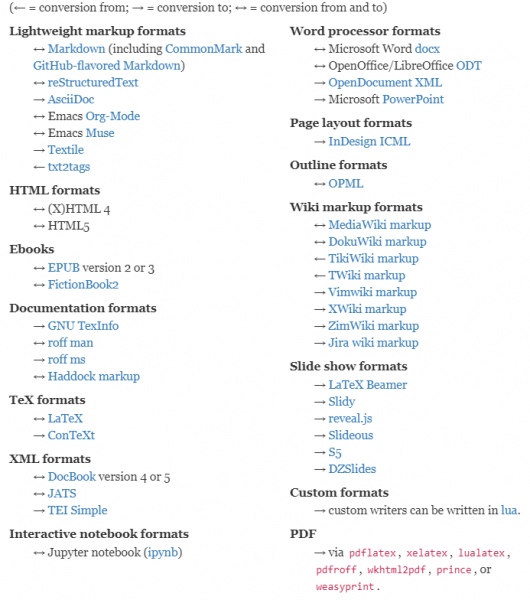
Zoznam formátov dokumentov, ktoré podporuje Pandoc. Na stránke je tiež graf, ale tento obrázok sa do článku nezmestí.
Samozrejme, Pandoc neimplementuje priamu konverziu pre každú dvojicu formátov. Na podporu takého rozsiahleho množstva konverzií sa používa štandardné architektonické riešenie: najprv sa celý dokument prevedie do špeciálneho vnútorného medziúčtu a potom sa na základe tohto vnútorného medziúčtu vygeneruje dokument v inom formáte. Vnútorné predstavenie vývojári nazývajú „AST“, čo znamená Abstract Syntax Tree, alebo . Na pohľad na vnútorné predstavenie je veľmi jednoduché: stačí zadať ako výstupný formát „native“.
$ cat example.html
<h1>Ahoj, svet!</h1>

$ pandoc -f html -t native example.html
[Header 1 ("hello-world",[],[]) [Str "Ahoj,",Space,Str "Svet!"]]
Čitatelia, ktorí aspoň trochu pracovali s Haskellom, môžu z tohto malého príkladu predpokladať, že Pandoc je napísaný práve v Haskelle: výstup tohto príkazu je reprezentácia vnútorných štruktúr Pandoc vo forme reťazca, vytvoreného podľa vzoru, ako to zvyčajne býva v Haskelle, napríklad v štandardnej knižnici.
Tu môžeme vidieť, že vnútorné predstavenie je rekurzívna štruktúra, v každom vnútornom uzle sa nachádza zoznam. Napríklad na najvyššej úrovni je zoznam z jedného prvku — nadpisu prvej úrovne s atribútmi „hello-world“,[],[]. Vo vnútri tohto nadpisu je skrytý zoznam z reťazca „Hello,“ , medzery a reťazca „World!“.
Ako sa ukazuje, vnútorné predstavenie sa príliš nelíši od HTML. Predstavuje strom, kde každý vnútorný uzol poskytuje nejaké informácie o formátovaní svojich potomkov, a v listoch sa nachádza vlastne obsah dokumentu.
Ak sa zameriame na úroveň konkrétnej implementácie, typ dát pre celý dokument je definovaný takto:
data Pandoc = Pandoc Meta [Block]Tu Block predstavuje presne tie vnútorné vrcholy, o ktorých sa hovorí vyššie, a Meta je metainformácia o dokumente, ako je nadpis, dátum vytvorenia, autori — pre rôzne formáty to môže byť rôzne, a Pandoc sa snaží uchovávať takéto informácie pri konverzii z formátu do formátu.
Takmer všetky konštruktory typu Block — napríklad Header alebo Para (odsek) — prijímajú ako argumenty atribúty a zoznam nižších prvkov — zvyčajne typu Inline. Napríklad Space alebo Str sú konštruktory typu Inline, a HTML tag
sa tiež premení na svoj špeciálny Inline typ. Nemáme zmysel uvádzať úplnú definíciu týchto typov, avšak všimneme si, že si ju môžete pozrieť tu. .
Zaujímavé je, že typ Pandoc je monoid. To znamená, že existuje nejaký prázdny dokument a že dokumenty môžeme kombinovať. Je to užitočné pri písaní Readerov — môžeme rozdeľovať dokument na časti podľa rôznej logiky, každú analyzovať osobitne, a potom všetko opäť zlúčiť do jedného dokumentu. Pri tom sa metainformácie zhromaždia zo všetkých častí dokumentu naraz.
Pri konverzii, povedzme, z LaTeXu na HTML, najprv špeciálny modul nazývaný LaTeXReader prekonvertuje vstupný dokument na AST, potom iný modul nazývaný HTMLWriter prekonvertuje AST na HTML. Vďaka takej architektúre nie je potrebné písať kvadratické množstvo konverzií — stačí pre každý nový formát napísať Reader a Writer a všetky možné páry konverzií sa automaticky sprístupnia.
Je jasné, že taká architektúra má aj svoje nedostatky, ktoré boli už dávno predpovedané odborníkmi na architektúru softvéru. Najvýznamnejším je nákladnosť zmien v syntaktickom strome. Ak je zmena dostatočne závažná, bude potrebné zmeniť kód vo všetkých Readere a Writeroch. Napríklad jednou z úloh, ktorým čelí tím Pandoc, je podpora komplexných formátov tabuliek. Momentálne Pandoc zvláda iba najjednoduchšie tabuľky so záhlavím, stĺpcami a hodnotou v každej bunke. Povedzme, atribút colspan v HTML bude jednoducho ignorovaný. Jednou z príčin tohto správania je absencia jednotnej schémy reprezentácie tabuliek vo všetkých alebo aspoň v mnohých formátoch — preto nie je jasné, v akom formáte by mali byť tabuľky uchovávané vo vnútornej reprezentácii. Ale aj po výbere konkrétneho zobrazenia bude potrebné zmeniť všetky Readere a Write, ktoré podporujú prácu s tabuľkami.
Jazyk Haskell bol zvolen nielen z veľkej lásky autorov k funkcionálnemu programovaniu. Haskell je známy širokými možnosťami spracovania textov. Jedným z príkladov je knižnica — knižnica, ktorá aktívne využíva koncepty typického funkcionálneho programovania — monoidy, monády, aplikatívne a alternatívne funktory — na písanie voľných parserov. Celú silu Parsec možno vidieť na s HaskellWiki, kde sa analyzuje kompletný parser jednoduchého imperatívneho programovacieho jazyka. Samozrejme, Parsec sa aktívne používa aj v Pandoc.
Ak by sme to opísali stručne, monády sa používajú na sekvenčné parsovanie, kde najprv ide jedno a potom druhé. Napríklad v takomto príklade:
whileParser :: Parser Stmt
whileParser = whiteSpace >> statement
Najprv sa musí prečítať medzera a potom statement — ktorý má tiež typ Parser Stmt.
Alternatívne funktory sa používajú na návrat v prípade, že parsovanie zlyhá. Napríklad,
statement :: Parser Stmt
statement = parens statement  sequenceOfStmt
To znamená, že buď sa pokúsime prečítať statement v závorkách, alebo postupne sa pokúsime prečítať niekoľko statementov.
Aplikatívne funktory sa väčšinou používajú ako skratky pre monády. Napríklad, nech funkcia tok číta nejaký token (to je skutočná funkcia z LaTeXReader). Pozrime sa na takúto kombináciu
const tok tokPrečíta dva tokeny za sebou a vráti z nich prvý.
Pre všetky tieto triedy existujú v Haskelli krásne symbolické operátory, čo robí programovanie Readerov podobným ASCII-artu. Len sa pozrite na tento úžasný kód.
Naše úlohy boli spojené s LaTeXReaderom. Úloha Vasila bola v podpore príkazov mbox a hbox, užitočných pri písaní balíkov v LaTeX. Na zodpovednosti Alžbety bola podpora príkazu epigraph, ktorý umožňuje formátovanie epigrafov v LaTeX dokumentoch.
Hatrace
V operačných systémoch podobných UNIXu je často implementovaný systémový volanie ptrace. Je užitočné pri ladení a simulácii prostredí programov a umožňuje sledovať systémové volania, ktoré program vykonáva. Napríklad veľmi užitočný nástroj strace používa vo vnútri práve ptrace.
Hatrace je knižnica, ktorá poskytuje rozhranie pre ptrace v Haskelli. Skutočnosťou je, že samotný ptrace je veľmi komplexný a jeho priame použitie je pomerne zložité, najmä v funkcionálnych jazykoch.
Hatrace pri spustení funguje ako strace a prijíma podobné argumenty. Jeho rozdiel oproti strace spočíva v tom, že je to aj knižnica, ktorá poskytuje jednoduchšie rozhranie ako len ptrace.
S pomocou hatrace sme už zachytili jednu nepríjemnú chybu v kompilátore Haskellu GHC — keď je zabitý v nevhodnom okamihu, generuje neplatné objektové súbory a neprekompiluje ich pri reštartovaní. Skriptovanie na základe systémových volaní umožnilo zaručene reprodukovať chybu pri jednom spustení, zatiaľ čo náhodné zabíjania reprodukovali chybu približne za dve hodiny.
Do knižnice sme pridávali rozhrania systémových volaní — Eliška pridávala brk a Vasily pridával mmap. Vďaka našej práci je možné jednoduchšie a presnejšie používať argumenty týchto systémových volaní pri použití knižnice.
Zdroj: habr.com
