

30. novembra - 1. decembra sa v Nižnom Novgorode konal. Účastníci mali za úlohu vytvoriť prototyp produktu za použitia Intel OpenVINO toolkit. Organizátori ponúkli zoznam približných tém, na ktoré sa dalo zamerať pri výbere úlohy, avšak konečné rozhodnutie ostávalo na tímach. Okrem toho sa podporoval aj využitie modelov, ktoré nie sú súčasťou produktu.
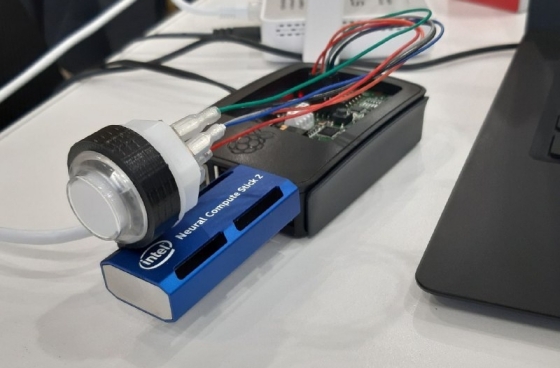
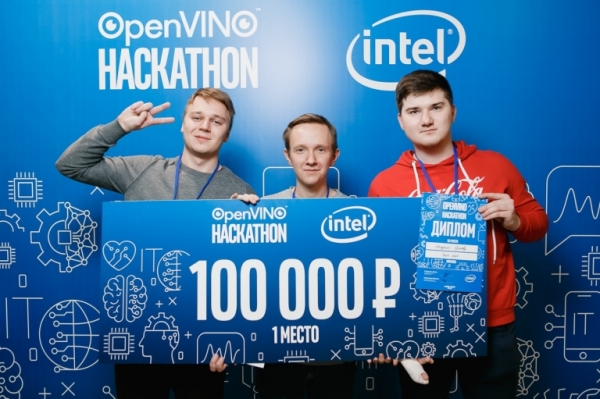
V článku sa podelíme o to, ako sme vytvárali náš prototyp produktu, s ktorým sme napokon získali prvé miesto.
Na hackathone sa zúčastnilo viac ako 10 tímov. Teší nás, že niektoré z nich prišli z iných regiónov. Miestom konania hackathonu bol zvolený komplex „Kreml na Počaiňe“, kde boli vo vnútri vyvesené historické fotografie Nižného Novgorodu, atmosféricky! (pripomínam, že v súčasnosti je centrálny úrad spoločnosti Intel práve v Nižnom Novgorode). Účastníkom bolo pridelených 26 hodín na písanie kódu, na konci museli prezentovať svoje riešenie. Samostatným plusom bola prítomnosť demo-sessie, aby sa overilo, že všetko, čo bolo zamýšľané, skutočne existuje a neostalo len v myšlienkach prezentácie. Merč, snacky, jedlo — to všetko bolo tiež!
Okrem toho spoločnosť Intel na požiadanie poskytovala kamery, Raspberry PI, Neural Compute Stick 2.
Výber úlohy
Jednou z najnáročnejších častí prípravy na hackathon s voľnou tematikou je výber úlohy. Okamžite sme sa rozhodli vymyslieť niečo, čo v produkte ešte nie je, keďže v oznámení bolo povedané, že to je veľmi vítané.
Analyzujúc , ktoré sú súčasťou produktu v aktuálnom vydaní, dospievame k záveru, že väčšina z nich rieši rôzne úlohy počítačového videnia. Je veľmi ťažké vymyslieť úlohu z oblasti počítačového videnia, ktorú nemožno vyriešiť pomocou OpenVINO, a ak takú môžeme vymyslieť, ťažko sa dajú nájsť predtrénované modely vo voľnom prístupe. Rozhodujeme sa skúmať aj iným smerom — smerom spracovania a analytiky reči. Zvažujeme zaujímavú úlohu rozpoznávania emócií na základe reči. Treba povedať, že v OpenVINO už existuje model, ktorý určuje emócie človeka na základe tváre, ale:
- V teórii je možné vytvoriť kombinovaný algoritmus, ktorý bude pracovať ako na základe zvuku, tak aj na obrázku, čo by malo priniesť zvýšenie presnosti.
- Kamery zvyčajne majú úzky uhol pohľadu, aby pokryli väčšiu plochu, je potrebné mať viac než jednu kameru, zvuk nemá také obmedzenia.
Rozvíjame myšlienku: vezmeme za základ nápad pre segment retail. Môžeme určovať spokojnosť zákazníka na pokladniach obchodov. Ak je niektorý z zákazníkov nespokojný so službou a začína zvyšovať hlas — môžeme okamžite privolať administrátora na pomoc.
V tomto prípade je potrebné pridať rozpoznávanie osoby podľa hlasu, čo nám umožní rozlišovať zamestnancov obchodu od zákazníkov, poskytovať analytiku pre každého jednotlivca. No a okrem toho, bude možné analyzovať správanie samotných zamestnancov obchodu, hodnotiť atmosféru v kolektíve, znie to dobre!
Tvoríme požiadavky na naše riešenie:
- Malá veľkosť cieľového zariadenia
- Práca v reálnom čase
- Nízka cena
- Ľahká škálovateľnosť
Nakoniec ako cieľové zariadenie vyberáme Raspberry Pi 3 s .
Tu je dôležité poznamenať jednu dôležitú vlastnosť NCS — najlepšie funguje so štandardnými CNN architektúrami, ak však bude potrebné spustiť na ňom model s vlastnými vrstvami, očakávajte nízkoúrovnovú optimalizáciu.
Zostáva už len: treba zohnať mikrofón. Postačí aj bežný USB mikrofón, hoci nebude vyzerať dobre spolu s RPI. Ale aj tu je riešenie prakticky „na dosah“. Na nahrávanie hlasu sa rozhodujeme použiť dosku Voice Bonnet zo sady , na ktorej je zapájaný stereo mikrofón.
Stiahneme Raspbian z a nahrajeme na flash disk, otestujeme, či mikrofón funguje pomocou nasledujúcej príkazu (tento príkaz nahrá zvuk dlhý 5 sekúnd a uloží ho do súboru):
arecord -d 5 -r 16000 test.wavHneď upozorňujem, že mikrofón je veľmi citlivý a dobre zachytáva šumy. Aby sme to napravili, vstúpime do alsamixeru, vyberieme zachytávacie zariadenia a znížime úroveň vstupného signálu na 50-60%.
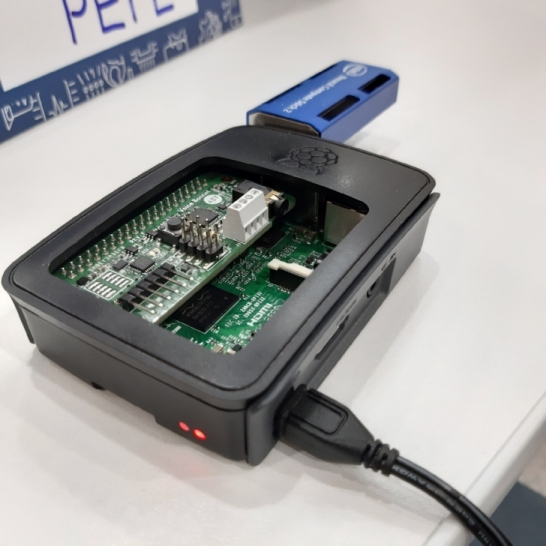
Dopracovávame krabičku pilníkom a všetko sa tam zmestí, môžeme ju dokonca zatvoriť vekom.
Pridáváme indikátorovú tlačidlo
Pri rozoberaní AIY Voice Kit na časti si spomíname, že tam je RGB tlačidlo, ktorého osvetlenie môžeme ovládať programovo. Hľadáme „Google AIY Led“ a nachádzame dokumentáciu:
Prečo by sme nemohli použiť toto tlačidlo na zobrazenie rozpoznanej emócie, máme iba 7 tried, a v tlačidle sú 8 farieb, presne dosť!
Pripojíme tlačidlo cez GPIO k Voice Bonnet, načítame potrebné knižnice (už sú nainštalované v distribúcii od AIY projects)
from aiy.leds import Leds, Color
from aiy.leds import RgbLeds
Vytvoríme dict, v ktorom bude každej emócii priradená farba vo forme RGB Tuple a objekt triedy aiy.leds.Leds, cez ktorý budeme aktualizovať farbu:
led_dict = {'neutral': (255, 255, 255), 'happy': (0, 255, 0), 'sad': (0, 255, 255), 'angry': (255, 0, 0), 'fearful': (0, 0, 0), 'disgusted':  (255, 0, 255), 'surprised':  (255, 255, 0)}
leds = Leds()
A nakoniec, po každom novom predpoklade emócie budeme aktualizovať farbu tlačidla podľa nej (podľa kľúča).
leds.update(Leds.rgb_on(led_dict.get(classes[prediction])))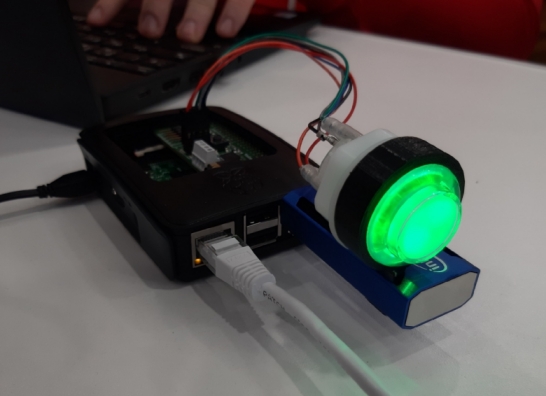
Tlačidlo, hor!
Pracujeme s hlasom
Budeme používať pyaudio na zachytávanie streamu z mikrofónu a webrtcvad na filtráciu šumu a detekciu hlasu. Okrem toho vytvoríme frontu, do ktorej budeme asynchrónne pridávať a zbierať úryvky s hlasom.
Keďže webrtcvad má obmedzenie na veľkosť predkladaného fragmentu — musí byť 10/20/30 ms, a učenie modelu na rozpoznávanie emócií (ako sa neskôr dozvieme) sa uskutočnilo na datasete 48 kHz, budeme zachytávať chunky veľkosti 48000×20 ms/1000×1(mono)=960 bajtov. Webrtcvad bude vracať True/False pre každý z týchto chunkov, čo zodpovedá prítomnosti alebo neprítomnosti hlasu v chunku.
Realizujeme nasledujúcu logiku:
- Budeme pridávať do zoznamu tie chunky, kde je hlas, ak nie je žiadny hlas, inkrementujeme čítač prázdnych chunkov.
- Ak je čítač prázdnych chunkov >=30 (600 ms), pozrieme sa na veľkosť zoznamu nahromadených chunkov, ak je >250, pridáme do fronty, ak nie, považujeme za nedostatočnú dĺžku záznamu na to, aby sme ho predložili modelu na identifikáciu rozprávača.
- Ak je však čítač prázdnych chunkov stále < 30, a veľkosť zoznamu nahromadených chunkov presiahla 300, pridáme úryvok do fronty na presnejšie predpovedanie. (keďže emócie sa časom majú tendenciu meniť)
 def to_queue(frames):
    d = np.frombuffer(b''.join(frames), dtype=np.int16)
    return d

framesQueue = queue.Queue()
def framesThreadBody():
    CHUNK = 960
    FORMAT = pyaudio.paInt16
    CHANNELS = 1
    RATE = 48000

    p = pyaudio.PyAudio()
    vad = webrtcvad.Vad()
    vad.set_mode(2)
    stream = p.open(format=FORMAT,
                channels=CHANNELS,
                rate=RATE,
                input=True,
                frames_per_buffer=CHUNK)
    false_counter = 0
    audio_frame = []
    while process:
        data = stream.read(CHUNK)
        if not vad.is_speech(data, RATE):
            false_counter += 1
            if false_counter >= 30:
                if len(audio_frame) > 250:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
                    false_counter = 0

        if vad.is_speech(data, RATE):
            false_counter = 0
            audio_frame.append(data)
            if len(audio_frame) > 300:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
Prišiel čas hľadať vo voľnom prístupe predtrénované modely, ideme na github, googlime, ale pamätáme, že máme obmedzenie na používanú architektúru. To je celkom zložitá časť, pretože je potrebné testovať modely na svojich vstupných údajoch a navyše ich konvertovať do vnútorného formátu OpenVINO — IR (Intermediate Representation). Skúsili sme asi 5-7 rôznych riešení z githubu a ak model na rozpoznávanie emócií fungoval okamžite, tak rozpoznávanie podľa hlasu nám trvalo dlhšie — používajú sa tam zložitejšie architektúry.
Zastavujeme sa na nasledujúcich:
- Emócie z hlasu —
Funguje na nasledujúcom principe: audio sa rozdelí na úryvky určitej veľkosti, pre každý z týchto úryvkov vyberáme a ďalej ich podávame na vstup do CNN - Rozpoznávanie hlasu —
Tu namiesto MFCC pracujeme so spektrálnym obrazom, po FFT podávame signál do CNN, kde na výstupe dostaneme vektorové zobrazenie hlasu.
Ďalej sa bude hovoriť o konverzii modelov, začneme s teóriou. OpenVINO obsahuje niekoľko modulov:
- Open Model Zoo, modely, ktoré je možné využiť a zahrnúť do svojho produktu
- Model Optimizer, vďaka ktorému môžeme prekonať model z rôznych formátov frameworkov (Tensorflow, ONNX atď) do formátu Intermediate Representation, s ktorým budeme ďalej pracovať
- Inference Engine umožňuje spúšťať modely v IR formáte na procesoroch Intel, čipoch Myriad a akcelerátoroch Neural Compute Stick
- Najefektívnejšia verzia OpenCV (s podporou Inference Engine)
Každý model vo formáte IR je popísaný dvoma súbormi: .xml a .bin.
Modely sa konvertujú do formátu IR cez Model Optimizer nasledujúcim spôsobom:python /opt/intel/openvino/deployment_tools/model_optimizer/mo_tf.py --input_model speaker.hdf5.pb --data_type=FP16 --input_shape [1,512,1000,1]--data_typeumožňuje vybrať formát dát, s ktorým bude model pracovať. Podporované sú FP32, FP16, INT8. Výber optimálneho typu dát môže priniesť dobrý nárast výkonu.
--input_shapeudáva rozmery vstupných dát. Možnosť dynamicky ich meniť sa údajne nachádza v C++ API, ale išli sme tak ďaleko a pre jeden z modelov sme ju jednoducho fixovali.
Ďalej sa pokúsime načítať už konvertovaný model vo formáte IR cez DNN modul v OpenCV a vykonať na ňom predikciu.import cv2 as cv emotionsNet = cv.dnn.readNet('emotions_model.bin', 'emotions_model.xml') emotionsNet.setPreferableTarget(cv.dnn.DNN_TARGET_MYRIAD)Posledný riadok v tomto prípade umožňuje presmerovať výpočty na Neural Compute Stick, základne sa výpočty vykonávajú na procesore, ale v prípade Raspberry Pi to neprejde, bude potrebný stick.
Ďalej je logika nasledujúca: rozdelíme naše audio na okná určitej veľkosti (u nás je to 0.4s), každé z týchto okien prevedieme na MFCC, ktoré potom zadáme do neurónovej siete:
emotionsNet.setInput(MFCC_from_window)
result = emotionsNet.forward()
Potom vezmeme najčastejšie sa vyskytujúcu triedu pre všetky okná. Jednoduché riešenie, ale pre hackathon nie je potrebné vymýšľať niečo príliš zložité, len ak je čas. Máme ešte veľa práce, takže ideme ďalej — zaoberáme sa rozpoznávaním hlasu. Potrebujeme urobiť akúsi databázu, v ktorej budú uložené spektrogramy vopred nahrávaných hlasov. Keďže času zostáva málo, riešime túto otázku, ako môžeme.
A to konkrétne, vytvoríme skript na nahrávanie úryvku hlasu (funguje to rovnako, ako je popísané vyššie, len pri prerušením z klávesnice ukladá hlas do súboru).
Skúšame:
python3 voice_db/record_voice.py test.wavNahrávame hlasy niekoľkých ľudí (v našom prípade troch členov tímu)
Ďalej pre každý nahratý hlas vykonáme rýchlu Fourierovu transformáciu, získame spektrogram a uložíme ho vo forme numpy array (.npy):for file in glob.glob("voice_db/*.wav"): spec = get_fft_spectrum(file) np.save(file[:-4] + '.npy', spec)Podrobnosti v súbore
create_base.py
Takže pri spustení hlavného skriptu dostaneme na začiatku embeddings z týchto spektrogramov:for file in glob.glob("voice_db/*.npy"): spec = np.load(file) spec = spec.astype('float32') spec_reshaped = spec.reshape(1, 1, spec.shape[0], spec.shape[1]) srNet.setInput(spec_reshaped) pred = srNet.forward() emb = np.squeeze(pred)Po získaní embeddingu zo zaznamenaného úryvku budeme môcť určiť, komu patrí, a to tak, že vezmeme kosínusovú vzdialenosť od úryvku ku všetkým hlasom v databáze (čím menšia, tým pravdepodobnejšie) — pre demo sme nastavili prah 0,3):
        dist_list = cdist(emb, enroll_embs, metric="cosine")
        distances = pd.DataFrame(dist_list, columns = df.speaker)
Na záver by som rád podotkol, že rýchlosť inferencie bola rýchla a umožnila by pridať ďalšie 1-2 modely (na vzorku dĺžky 7 sekúnd na inferenciu trvalo 2,5). Nové modely sme už stihnúť nemohli a zamerali sme sa na písanie prototypu webovej aplikácie.
Webová aplikácia
Dôležitý bod: berieme so sebou router z domu a nastavujeme si svoju lokálnu sieť, čo pomáha prepojiť zariadenie a notebooky v sieti.
Backend predstavuje priechodný kanál správ medzi frontom a Raspberry Pi, založený na technológii websocket (http over tcp protokol).
Prvým krokom je získanie spracovaných informácií z Raspberry, teda predikcie zabalené do json, ktoré sú počas svojej cesty uložené do databázy, aby sme mohli formovať štatistiku o emocionálnom pozadí používateľa za obdobie. Následne sa tento balík posiela na frontend, ktorý používa predplatné a získava balíky z endpoinu websocketu. Celý mechanizmus backendu je postavený na jazyku golang, výber padol naň, pretože dobre vyhovuje pre asynchrónne úlohy, s ktorými sa gorutiny dobre vysporiadajú.
Pri prístupe k endpoinu sa používateľ registruje a zapisuje do štruktúry, potom dochádza k získaniu jeho správy. Používateľ aj správa sú zapísané do spoločného hubu, z ktorého sa správy už odosielajú ďalej (na predplatný front), a ak používateľ uzavrie spojenie (Raspberry alebo front), tak jeho predplatné sa zruší a je odstránený z hubu.
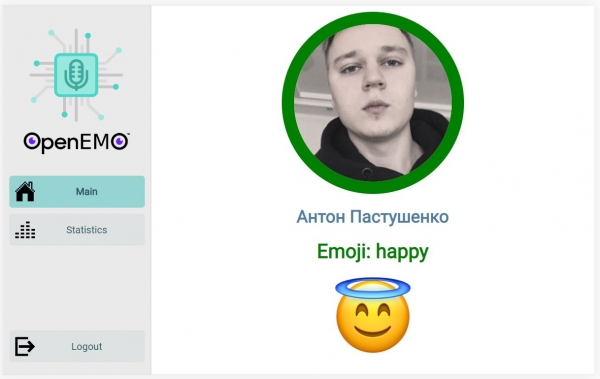
Očakávame pripojenie s backendomFront-end je webová aplikácia napísaná v JavaScripte s použitím knižnice React na urýchlenie a zjednodušenie procesu vývoja. Cieľom tejto aplikácie je vizualizácia údajov získaných pomocou algoritmov spustených na back-end strane a priamo na Raspberry Pi. Na stránke je implementované smerovanie po sekciách pomocou react-router, no hlavným zaujímavým prvkom je domovská stránka, kde v reálnom čase prichádza nepretržitý prúd údajov zo servera prostredníctvom technológie WebSocket. Raspberry Pi deteguje hlas, určuje príslušnosť k určitej osobe z registrovanej databázy a posiela zoznam pravdepodobnosti klientovi. Klient zobrazuje posledné aktuálne údaje, zobrazuje avatar osoby, ktorá s najväčšou pravdepodobnosťou hovorila do mikrofónu, ako aj emóciu, s ktorou vyslovuje slová.

Domovská stránka s aktualizovanými predikciamiZáver
Nepodarilo sa dokončiť všetko podľa plánov, jednoducho sme nestihli, a tak bola hlavná nádej na demo, že všetko bude fungovať. V prezentácii hovorili o tom, ako je všetko zorganizované, aké modely použili, s akými problémami sa stretli. Následne bola časť demo — experti chodili po sále v náhodnom poriadku a pristupovali k jednotlivým tímom, aby si pozreli fungujúci prototyp. Pýtali sa aj nás, každý odpovedal na svoju časť, na notebooku sme mali web a naozaj to všetko fungovalo tak, ako sa očakávalo.
Chcel by som poznamenať, že celkové náklady našich riešení boli 150$:
- Raspberry Pi 3 ~ 35$
- Google AIY Voice Bonnet (môžete použiť dosku respeaker) ~ 15$
- Intel NCS 2 ~ 100$
Ako zlepšiť:
- Použiť registráciu z klienta — požiadať o prečítanie textu, ktorý generujeme náhodne
- Pridať niekoľko ďalších modelov: hlasom je možné určiť pohlavie a vek
- Oddeliť súčasne znejúce hlasy (diarizácia)
Repozitár:

Unavení, ale šťastní smeNa záver by som chcel poďakovať organizátorom a účastníkom. Z projektov iných tímov sa nám osobne páčilo riešenie na monitorovanie voľných parkovacích miest. Pre nás to bola neuveriteľne skvelá skúsenosť so zorientovaním sa v produkte a vývojom. Dúfam, že v regiónoch sa bude konať stále viac zaujímavých podujatí, vrátane tých na tému AI.
Zdroj: habr.com
