

Kód softvérových produktov pre strojové učenie býva často zložitý a dosť mätúci. Odhaľovanie a odstránenie chýb v ňom je náročná úloha. Aj tie najjednoduchšie vyžadujú vážny prístup k sieťovej architektúre, inicializácii váh, optimalizácii siete. Malá chyba môže viesť k nepríjemným problémom.
Tento článok je venovaný algoritmu ladenia vašich neurónových sietí.
Skillbox odporúča: Praktický kurz .
Pripomíname: pre všetkých čitateľov „Habr“ — zľava 10 000 rubľov pri zapísaní na akýkoľvek kurz Skillbox s promo kódom „Habr“.
Algoritmus pozostáva z piatich etáp:
- jednoduchý štart;
- potvrdenie strát;
- kontrola medzivýsledkov a spojení;
- diagnostika parametrov;
- sledovanie činnosti.
Ak vám niečo pripadá zaujímavejšie ako ostatné, môžete okamžite prejsť k týmto sekciám.
Jednoduchý štart
Ladenie neurónovej siete so zložitou architektúrou, regularizáciou a plánovačom rýchlosti učenia je zložitejšie ako bežnej. Trochu klameme, pretože tento bod má nepriamy vzťah k ladenie, ale je to aj tak dôležitá rada.
Jednoduchý štart spočíva vo vytvorení zjednodušeného modelu a jeho natrénovaní na jednom súbore (bode) dát.
Najprv vytvoríme zjednodušený model
Pre rýchly štart vytvoríme malú sieť s jedinou skrytou vrstvou a overíme, že všetko funguje správne. Potom postupne zložité model a kontrolujeme každý nový aspekt jeho štruktúry (ďalšej vrstvy, parametra atď.), a ideme ďalej.
Natrénujeme model na jedinom súbore (bode) dát
Ako rýchlu kontrolu funkčnosti vášho projektu môžete na učenie použiť jeden alebo dva dáta, aby ste potvrdili, či systém funguje správne. Neurónová sieť by mala ukázať 100% presnosť učenia a testovania. Ak nie, model je príliš malý alebo už máte chybu.
Aj keď je všetko v poriadku, pripravte model na absolvovanie jednej alebo niekoľkých epôch pred tým, než pôjdete ďalej.
Hodnotenie strát
Hodnotenie strát je základný spôsob, ako doladiť výkonnosť modelu. Musíte sa uistiť, že strata zodpovedá úlohe a funkcie strát sú hodnotené na správnej škále. Ak používate viac ako jeden typ straty, uistite sa, že všetky sú v jednom poradí a správne škálované.
Je dôležité venovať pozornosť počiatočným stratám. Skontrolujte, ako blízko je skutočný výsledok k očakávanému, ak model začal s náhodným predpokladom. V : „Uistite sa, že dosahujete výsledok, ktorý očakávate pri začatí práce s malým počtom parametrov. Je lepšie ihneď skontrolovať stratu údajov (s nastavovaním stupňa regularizácie na nulu). Napríklad, pre CIFAR-10 s klasifikátorom Softmax očakávame, že počiatočné straty budú 2.302, pretože očakávaná difúzna pravdepodobnosť predstavuje 0,1 pre každú triedu (keďže existuje 10 tried), a strata Softmax je negatívnym logaritmom pravdepodobnosti správnej triedy ako –ln (0.1) = 2.302“.
Pre binárny príklad sa jednoducho vykoná podobný výpočet pre každú z tried. Tu sú napríklad dáta: 20% 0’s a 80% 1’s. Očakávaná počiatočná strata bude až –0,2ln (0,5) –0,8ln (0,5) = 0,693147. Ak výsledok presiahne 1, može to naznačovať, že váhy neurónovej siete nie sú správne vyvážené alebo dáta nie sú normalizované.
Kontrolujeme medzi výsledky a prepojenia
Na odladenie neurónovej siete je potrebné pochopiť dynamiku procesov v jejnútri a úlohu jednotlivých medzi vrstiev, pretože sú prepojené. Tu sú typické chyby, s ktorými sa môžete stretnúť:
- nesprávne výrazy pre aktualizácie gradientov;
- aktualizácie váh sa neuplatňujú;
- miznúce alebo explodujúce gradienty (exploding gradients).
Ak sú hodnoty gradientu nulové, znamená to, že rýchlosť učenia v optimalizátore je príliš malá, alebo sa stretávate s nesprávnym výrazom pre aktualizáciu gradientu.
Okrem toho je potrebné sledovať hodnoty aktivačných funkcií, váh a aktualizácií každého z vrstiev. Napríklad, množstvo aktualizácií parametrov (váh a posunov) .
Existuje jav, ktorý dostal názov “Dying ReLU” alebo , keď neuróny ReLU vrátia nulu po tom, čo sa naučili veľkú zápornú hodnotu (bias) posunutia pre svoje váhy. Tieto neuróny sa už nikdy neaktivujú nikde v údajoch.
Môžete použiť overenie gradientu na identifikáciu týchto chýb tak, že gradient priblížite pomocou numerického prístupu. Ak je blízko k vypočítaným gradientom, následné šírenie bolo realizované správne. Na vytvorenie overenia gradientu sa oboznámte s týmito skvelými zdrojmi z CS231 a , ako aj s Andrews Ng (Andrew Nga) na túto tému.
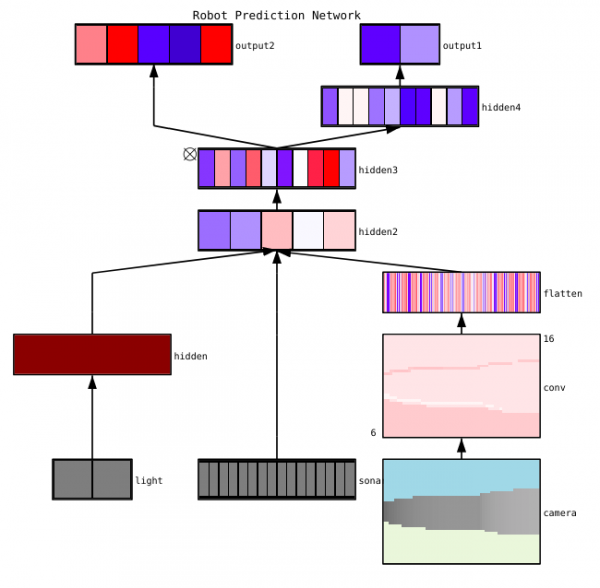
uvádza tri hlavné metódy vizualizácie neurónových sietí:
- Predbežné — jednoduché metódy, ktoré nám ukazujú celkovú štruktúru trénovaného modelu. Tieto majú zahrnuté výstupy tvarov alebo filtrov jednotlivých vrstiev neurónovej siete a parametre v každej vrstve.
- Založené na aktiváciách. V týchto vizualizujeme aktivácie jednotlivých neurónov alebo skupín neurónov, aby sme pochopili ich funkcie.
- Založené na gradientoch. Tieto metódy majú tendenciu manipulovať s gradientmi, ktoré vznikajú počas dopredu a dozadu pri trénovaní modelu (vrátane máp významu a máp aktivácie triedy).
Existuje niekoľko užitočných nástrojov na vizualizáciu aktivácií a pripojení jednotlivých vrstiev, ako sú a .
Diagnostika parametrov
Neurónové siete majú množstvo parametrov, ktoré navzájom interagujú, čo komplikuje optimalizáciu. Tento oddiel je predmetom aktívneho výskumu odborníkov, takže nižšie uvedené návrhy by mali byť považované len za rady, východiskové body, od ktorých sa môžete odraziť.
Veľkosť dávky (batch size) — je potrebné, aby bol dostatočne veľký na získanie presných odhadov gradientu chyby, ale dostatočne malý, aby stochastický gradientný zostup (SGD) mohol usporiadať vašu sieť. Malé veľkosti dávok povedú k rýchlemu konvergencii vďaka šumu v procese učenia a neskôr k ťažkostiam s optimalizáciou. Viac o tom je popísané .
Rýchlosť učenia — príliš nízka povedie k pomalej konvergencii alebo riziku zahnúť sa v lokálnych minimách. Zároveň vysoká rýchlosť učenia spôsobí rozlíšenie optimalizácie, keďže riskujete „skočiť“ cez hlbokú, ale úzku časť funkcie straty. Skúste použiť plánovanie rýchlosti na jej zníženie v procese učenia neurónovej siete. V kurze CS231n .
Orezávanie gradientov— orezávanie gradientov parametrov počas spätného šírenia na maximálnu hodnotu alebo limitnú normu. Je to užitočné na riešenie problémov s akýmikoľvek explodujúcimi gradientmi, na ktoré môžete naraziť v treťom bode.
Batched normalizácia — sa používa na normalizáciu vstupných dát každého layeru, čo pomáha riešiť problém vnútorného kovaťatného posunu. Ak používate Dropout a Batch Norm spolu, .
Stochastický gradientný zostup (SGD) — existuje niekoľko variánt SGD, ktoré používajú impulz, adaptívne rýchlosti učenia a Nesterovú metódu. Pri tom ani jedna z nich nemá zjavné výhody, pokiaľ ide o efektívnosť učenia alebo generalizáciu ().
Regularizácia — je kľúčové pre vytváranie generalizovateľného modelu, pretože pridáva pokutu za zložitosti modelu alebo extrémne hodnoty parametrov. Je to spôsob, ako znížiť variabilitu modelu bez podstatného zvýšenia jeho skreslenia. Viac .
Aby ste si to sami posúdili, musíte vypnúť regularizáciu a skontrolovať gradient straty sami.
Dropout — ďalšia metóda usporiadania vašej siete, aby sa predišlo preťaženiu. Počas učenia sa dropout realizuje iba udržaním aktivity neurónu s určitým pravdepodobnosťou p (hyperparameter) alebo jeho nastavením na nulu v opačnom prípade. Výsledkom je, že sieť musí použiť iný podmnožok parametrov pre každý tréningový batch, čo znižuje zmeny určitých parametrov, ktoré sa stávajú dominantnými.
Dôležité: Ak používate ako dropout, tak aj batched norm, buďte opatrní s poradím týchto operácií alebo aj s ich spoločným použitím. Všetko toto sa ešte aktívne diskutuje a dopĺňa. Tu sú dve dôležité diskusie na túto tému a .
Kontrola práce
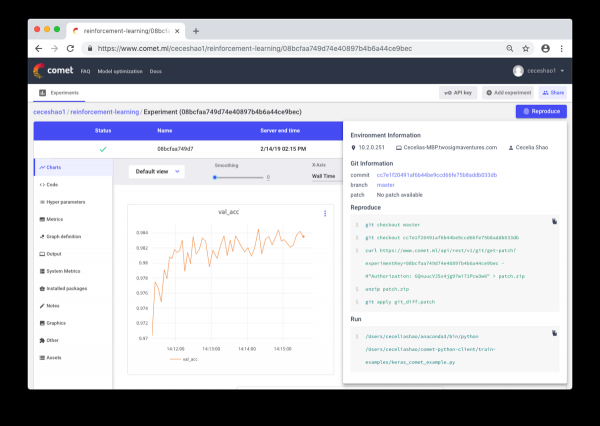
Ide o dokumentovanie pracovných procesov a experimentov. Ak nič nedokumentujete, môžete zabudnúť, akú rýchlosť učenia alebo váhu tried používate. Vďaka kontrole je možné bez problémov prezerať a reprodukovať predchádzajúce experimenty. To umožňuje znížiť počet duplicitných experimentov.
Pravda, ručné dokumentovanie sa môže stať náročnou úlohou v prípade veľkého objemu práce. Tu prichádzajú na pomoc také nástroje, ako je Comet.ml, ktoré pomáhajú automaticky logovať dátové sady, zmeny kódu, históriu experimentov a výrobných modelov, vrátane kľúčových informácií o vašom modeli (hyperparametre, výkon modelu a informácie o prostredí).
Neurónová sieť môže byť dosť citlivá na malé zmeny, čo môže viesť k poklesu výkonu modelu. Sledovanie a dokumentovanie práce je prvý krok, ktorý by ste mali podniknúť na štandardizáciu prostredia a modelovania.
Dúfam, že tento príspevok môže byť východiskovým bodom, od ktorého začnete ladenie vašej neurónovej siete.
Skillbox odporúča:
- Dvojročný praktický kurz .
- Online kurz .
- Praktický ročný kurz .
Zdroj: habr.com
