

Na začiatku trochu teórie. Čo je ?
Jednoducho povedané, je to dokument, ktorý má za cieľ zjednodušiť vývoj SaaS aplikácií a pomáha tým, že informuje vývojárov a DevOps inžinierov o praktických problémoch, ktoré sa najčastejšie vyskytovali pri vývoji moderných aplikácií.
Dokument bol vytvorený vývojármi platformy Heroku.
Metodológia dvanástich faktorov (The Twelve-Factor App) môže byť aplikovaná na aplikácie naprogramované v akomkoľvek programovacom jazyku a používajúce akékoľvek kombinácie externých služieb (backing services) (databázy, posielanie správ, cache pamäť, atď.).
Stručne o samotných faktoroch, na ktorých je táto metodológia postavená:
- Kódová základňa – Jeden kódový základ sledovaný v systéme správy verzií – množstvo nasadení
- Závislosti – Výslovne deklarujte a izolujte závislosti
- Konfigurácia – Ukladajte konfiguráciu v runtime prostredí
- Externé služby (Backing Services) – Považujte externé služby (backing services) za pripojiteľné zdroje
- Zostavenie, uvoľnenie, vykonanie – Strikne rozdeľte fázy zostavenia a vykonania
- Procesy – Spúšťajte aplikáciu ako jeden alebo viacero procesov bez ukladania vnútorného stavu (stateless)
- Zviazanie portov (Port binding) – Exportujte služby prostredníctvom viazania portov
- Paralelizmus – Škálujte aplikáciu pomocou procesov
- Odstrániteľnosť (Disposability) – Maximálne zvyšujte spoľahlivosť prostredníctvom rýchleho spustenia a správneho ukončenia
- Parita vývoja/prevádzky aplikácie – Udržujte vývojové, stagingové a produkčné prostredia čo najviac podobné
- Zaznamenávanie (Logs) – Považujte log za tok udalostí
- Administratívne úlohy – Vykonávajte administratívne/manipulačné úlohy pomocou jednorazových procesov
Viac informácií o 12 faktoroch môžete získať z nasledujúcich zdrojov:
- — určite na prečítanie
- — oficiálny preklad
- — čerstvý pohľad na 12 faktorov s cieľom ich zdokonaliť.
Čo je Blue-Green deployment?
Blue-Green deployment je spôsob dodania aplikácie na produkciu tak, že koncový zákazník nevidí žiadne zmeny z jeho strany. Inými slovami, nasadenie aplikácie s nulovým výpadkom.
Klasická schéma BG Deploy vyzerá tak, ako je znázornené na obrázku nižšie.

- Na začiatku sú 2 fyzické servery s úplne rovnakým kódom, aplikáciou a projektom, a je tu router (vyrovnávací zásobník).
- Router pôvodne smeruje všetky požiadavky na jeden z serverov (zelený).
- V momente, keď je potrebné znova urobiť release, celý projekt sa aktualizuje na druhom serveri (modrý), ktorý v súčasnosti nespracováva žiadne požiadavky.
- Po tom, čo je kód na modrom serveri úplne aktualizovaný, router dostane príkaz pre prepnutie z zeleného na modrý server.
- Teraz všetci zákazníci vidia výsledok práce kódu z modrého servera.
- N nejaký čas, zelený server slúži ako záloha v prípade zlyhania nasadenia na modrý server a v prípade zlyhania a chýb router prepne tok používateľov späť na zelený server so starou stabilnou verziou, a nový kód sa posiela na úpravu a testovanie.
- A na konci procesu sa rovnakým spôsobom aktualizuje zelený server. A po jeho aktualizácii router prepne tok požiadaviek späť na zelený server.
Vyzerá to všetko veľmi dobre a na prvý pohľad by s tým nemali byť žiadne problémy.
Ale pretože žijeme v modernej dobe, možnosť fyzického prepínania, ako je znázornené v klasickej schéme, nám nevyhovuje. Informácie si zatiaľ zapamätajte, neskôr sa k nim vrátime.
Zlé a dobré rady
Upozornenie: V príkladoch nižšie sú uvedené utilitné metódy, ktoré používam, môžeš použiť akékoľvek alternatívy s podobnými funkciami.
Veľká časť príkladov bude tak či onak prekrývať s webovým vývojom (to je prekvapenie), s PHP a Dockerom.
V bodoch nižšie sa nachádza jednoduchý praktický popis použitia faktorov na určitých príkladoch, ak chceš viac teórie v tejto téme, pozri sa na odkazy vyššie na pôvodný zdroj.
1. Kódová báza
Používaj FTP a FileZilla na nahrávanie súborov na servery po jednotlivých kusoch, neukladaj kód nikde okrem produkčného servera.
V projekte by vždy mala byť jednotná kódová báza, to znamená, že celý kód pochádza z jedného Git repozitára. Servery (produkcia, testovanie, test1, test2 …) používajú kód z vetiev jedného spoločného repo. Týmto spôsobom dosahujeme konzistenciu kódu.
2. Závislosti
Sťahujte všetky knižnice do priečinkov priamo do koreňa projektu. Aktualizácie robte jednoducho presunutím nového kódu do priečinka s aktuálnou verziou knižnice. Nainštalujte všetky potrebné utilitky priamo na hostiteľský server, kde beží ešte 20 služieb.
Projekt vždy musí mať jasný a zrozumiteľný zoznam závislostí (pod závislosťami chápem aj prostredie). Všetky závislosti musia byť jasne definované a izolované.
Ako príklad vezmeme Composer a Docker.
Composer — balíčkový manažér, ktorý umožňuje inštalovať knižnice v PHP. Composer umožňuje striktne alebo voľne určovať verzie a jasne ich definovať. Na serveri môže byť 20 rôznych projektov a každý bude mať svoj osobný zoznam balíkov a knižníc, ktorý nie je závislý od iného.
Docker — utilita, ktorá umožňuje definovať a izolovať prostredie, v ktorom bude aplikácia pracovať. Takže, rovnako ako s Composerom, ale už podrobnejšie, môžeme definovať, s čím aplikácia pracuje. Vybrať určitú verziu PHP, nainštalovať len nevyhnutné balíky pre projekt, aniž by sme pridávali niečo nadbytočné. A najdôležitejšie, aby sme sa neprenášali s balíkmi a prostredím hostiteľského stroja a iných projektov. To znamená, že všetky projekty na serveri bežiace cez Docker môžu používať akúkoľvek kombináciu balíkov a úplne rôzne prostredie.
3. Konfigurácia
Ukladajte konfigurácie ako konštanty priamo v kóde. Oddelené konštanty pre testovací server, oddelené pre produkciu. Spojte fungovanie aplikácie v závislosti od prostredia priamo v biznis logike projektu pomocou konštrukcií if else.
Konfigurácie — to je jediné, čím by sa mali líšiť nasadenia projektu (deployment). V ideálnom prípade by sa konfigurácie mali prenášať cez premenné prostredia (env vars).
To znamená, že aj keď budete uchovávať niekoľko konfiguračných súborov .config.prod .config.local a premenovávať ich pri nasadzovaní na .config (hlavný konfiguračný súbor, z ktorého aplikácia číta údaje) — to nebude správny prístup, pretože v takom prípade budú informácie z konfigurácií prístupné všetkým vývojárom aplikácie a údaje z produkčného servera budú ohrozené. Všetky konfigurácie musia byť uložené priamo v systéme nasadzovania (CI/CD) a generované pre rôzne prostredia s rôznymi hodnotami potrebnými pre konkrétne prostredie práve v okamihu nasadzovania.
4. Externé služby (Backing Services)
Pe staticky sa viažte na prostredie, používajte rôzne pripojenia pre rovnaké služby v špecifických prostrediach.
V skutočnosti tento bod silne súvisí s bodom o konfiguráciách, pretože bez prítomnosti tohto bodu nie je možné vytvoriť normálne konfiguračné údaje a vôbec možnosť konfigurácie by sa stratila.
Všetky pripojenia k externým službám, ako sú servery frontov, databázy, služby cache, by mali byť jednotné pre lokálne prostredie aj pre externé / produkčné prostredie. Inými slovami, môžem kedykoľvek zmeniť pripojovací reťazec tak, že nahradím prístup k databáze #1 databázou #2 bez zmeny kódu aplikácie. Alebo dopredu ako príklad, počas škálovania služby nemusíte pre ďalší server cache špecifikovať pripojenie nejakým špeciálnym spôsobom.
5. Kompilácia, vydanie, vykonanie
Na serveri majte iba finálnu verziu kódu, bez možnosti vrátiť vydanie späť. Nemusíte zaplniť diskový priestor. Kto si myslí, že môže nasadiť kód na produkciu s chybou, je zlý programátor!
Všetky fázy nasadzovania musia byť medzi sebou oddelené.
Majte šancu sa vrátiť späť. Robte vydania so zálohovaním starých kópií aplikácie (už zostavených a pripravených na boj), aby ste v prípade chýb mohli obnoviť starú verziu. To znamená, že existuje zložená složka releases a zloženie – prúd, a po úspešnom nasadení a zostavení sa zloženie – prúd prepojí symbolickým odkazom s novým vydaním, ktoré sa nachádza vo vnútri releases s podmieneným názvom čísla vydania.
Tu si spomenieme na Blue-Green deployment, ktorý umožňuje nielen prepínať medzi kódom, ale aj medzi všetkými zdrojmi a dokonca prostredím s možnosťou vrátiť všetko späť.
6. Procesy
Uchovávajte údaje o stave aplikácie priamo v samotnej aplikácii. Používajte relácie v pamäti aplikácie. Používajte čo najviac zdieľaných medzi externými službami. Buďte si istí, že aplikácia môže mať len jeden proces a nedovoľte možnosť škálovania.
Pokiaľ ide o relácie, uchovávajte údaje iba v cache spravovanej externými službami (memcached, redis), takže aj keď bude bežať 20 procesov aplikácie, ktorýkoľvek z nich sa obrátením na cache môže pokračovať v práci s klientom v tom istom stave, v ktorom bol používateľ, keď pracoval s aplikáciou v inom procese. Pri takomto prístupe bude všetko fungovať bez problémov s prístupom k údajom, bez ohľadu na to, koľko kópií externých služieb používate.
7. Priradenie portov (Port binding)
Vedieť, ako pracovať s externými službami, by mal len webový server. Najlepšie je zdvihnúť externé služby priamo v rámci webového servera. Napríklad ako PHP modul v Apache.
Všetky vaše služby by mali byť dostupné navzájom prostredníctvom nejakého adresy a portu (localhost:5432, localhost:3000, nginx:80, php-fpm:9000), t.j. z nginx môžem získať prístup k php-fpm aj k postgres, a z php-fpm k postgres a nginx, a vlastne z každej služby môžem získať prístup k inej službe. Takto nie je životaschopnosť služby závislá na životaschopnosti inej služby.
8. Paralelizmus
Pracujte s jedným procesom, lebo ak budú bežať viaceré procesy, nemusia si navzájom rozumieť!
Nezabudnite na možnosti škálovania. Na to je skvelý docker swarm.
Docker Swarm je nástroj na vytváranie a správu klastrov kontajnerov, či už medzi rôznymi strojmi alebo množstvom kontajnerov na jednom stroji.
Používajúc swarm, môžem určovať, koľko zdrojov pridelím každému procesu a aký počet procesov tej istej služby spustím, a vnútorný vyrovnávač záťaže, ktorý prijíma dáta na určený port, ich automaticky proxy na procesy. Týmto spôsobom, ak vidím, že sa zvýšila záťaž na serveri, môžem pridať viac procesov a tým znížiť záťaž na konkrétne procesy.
9. Zlikvidovateľnosť (Disposability)
Nepoužívajte fronty na prácu s procesmi a dátami. Zabití jedného procesu by malo ovplyvniť chod celej aplikácie. Ak zlyhá jedna služba, zlyhá všetko.
Každý proces a služba môžu byť vypnuté kedykoľvek a to by nemalo ovplyvniť ostatné služby (nejde samozrejme o to, že služba bude nedostupná pre inú službu, ale o to, že iná služba sa za touto nezastaví). Všetky procesy by sa mali ukončovať hladko, aby pri svojom ukončení nestratili dáta a pri ďalšom zapnutí systém fungoval správne. To znamená, že aj v prípade havarijného ukončenia by dáta nemali trpieť (môže byť použitý mechanizmus transakcií, dotazy do databázy pracujú iba v skupinách, a ak aspoň jeden dotaz z skupiny nebol vykonaný alebo bol vykonaný s chybou, tak žiadny ďalší dotaz z tejto skupiny sa v skutočnosti nevykoná).
10. Parita vývoja/práce aplikácie
Produkčný, staging a lokálna verzia aplikácie by mali byť rozdielne. Na produkcii máme framework Yii Lite, a lokálne Yii, aby to na produkcii išlo rýchlejšie!
V skutočnosti by všetky nasadenia a práca s kódom mali byť takmer v identickom prostredí (nejde o fyzický hardvér). Rovnako nasadiť kód na produkcii, ak je to potrebné, by mal byť schopný každý zamestnanec vyvoja, a nie nejaké špeciálne vyškolené devops oddelenie, ktoré len vďaka zvláštnej sile môže spustiť aplikáciu na produkcii.
V tom nám takisto pomáha Docker. Pri dodržaní všetkých predchádzajúcich bodov, použitím dockeru, zjednoduší proces nasadenia prostredia na produkcii aj na lokálnom počítači na zadanie jednej-dvoch príkazov.
11. Zaznamenávanie (Logs)
Logy píšeme do súborov a databázy! Soubory a databázu od logov nečistíme. Jednoducho si kúpime pevný disk na 9000 Petabytov a hotovo.
Všetky logy je potrebné považovať za tok udalostí. Aplikácia by sa nemala zaoberať spracovaním logov. Logy by mali byť odosielané buď do stdout, alebo prostredníctvom protokolu ako udp, aby práca aplikácie s logami nevytvárala žiadne problémy. Na to sa dobre hodí graylog. Graylog, ktorý prijíma všetky logy prostredníctvom udp (tento protokol si nevyžaduje čakanie na potvrdenie úspešného prijatia пакета), nijako neovplyvňuje aplikáciu a zaoberá sa iba štruktúrovaním a spracovaním logov. Logika aplikácie sa nemení na prácu s podobnými prístupmi.
12. Úlohy administrácie
Na aktualizáciu údajov, db a t.d. používajte samostatne vytvorený koncový bod v API, jeho vykonanie dvakrát po sebe môže spôsobiť, že sa údaje zdvojnásobia. Ale veď nie ste hlúpi, predsa dvakrát nekliknete, a migrácie sú nám na nič.
Všetky úlohy administrácie by sa mali vykonávať v tej istej prostredí ako celý kód, na úrovni releasov. To znamená, že ak potrebujeme zmeniť štruktúru db, nebudeme to robiť manuálne, meniac názvy stĺpcov a pridávajúc nové cez nejaké vizuálne nástroje na správu DB. Pre takéto veci vytvárame samostatné skripty — migrácie, ktoré sa vykonávajú všade a na všetkých prostrediach rovnakým spôsobom s jasným a zrozumiteľným výsledkom. Pre všetky ostatné úlohy, ako napríklad naplnenie projektu údajmi, by sa mali uplatňovať podobné metodológie.
Príklad implementácie v PHP, Laravel, Laradock, Docker-Compose
P.S. Všetky príklady boli realizované na MacOS. Väčšina z nich bude vyhovovať aj pre Linux. Používatelia Windows, prepáčte, ale s binálnou som už dlho nepracoval.
Predstavme si situáciu, že na našom PC nie je nainštalovaná žiadna verzia PHP a vôbec nič nie je.
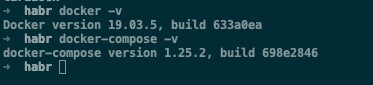
Inštalujeme posledné verzie docker a docker-compose. (to sa dá nájsť na internete)
docker -v &&
docker-compose -v
1. Inštalujeme
git clone https://github.com/Laradock/laradock.git &&
ls
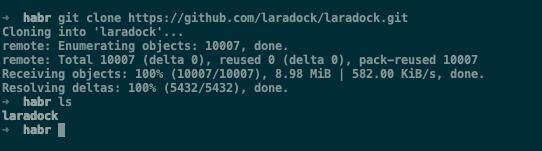
Čo sa týka Laradock, poviem, že je to veľmi skvelá vec, v ktorej je zhromaždených veľmi veľa kontajnerov a pomocných nástrojov. Ale používať Laradock bez úprav na produkcii — to by som neodporúčal kvôli jeho nadbytočnosti. Lepšie je vytvoriť vlastné kontajnery na základe príkladov v Laradock, tak sa bude dať optimalizovať, lebo nikto nepotrebuje všetko, čo tam je, naraz.
2. Konfigurujeme Laradock na prácu našej aplikácie.
cd laradock &&
cp env-example .env
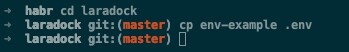
2.1. Otvoríme adresár habr (rodičovská zložka, do ktorej bol sklonovaný laradock) v akomkoľvek editore. (V mojom prípade PHPStorm)
V tomto kroku nastavíme iba názov projektu.
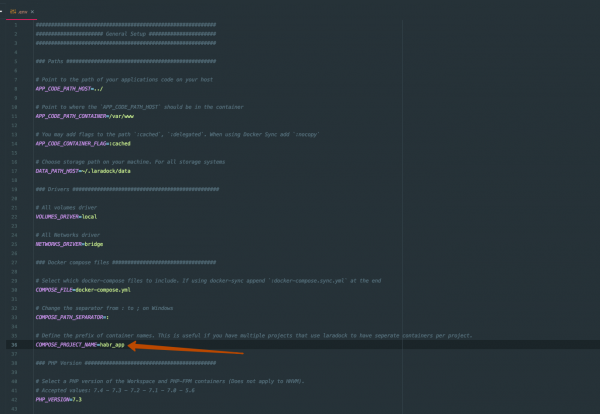
2.2. Spustíme obraz workspace. (Vo vašom prípade sa obrazy budú nejaký čas budovať)
Workspace je špeciálne pripravený obraz na prácu s frameworkom menom vývojára.
Prejdeme do vnútornosti kontajnera pomocou
docker-compose up -d workspace &&
docker-compose exec workspace bash
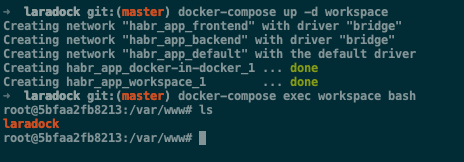
2.3. Nainštalujeme Laravel
composer create-project --prefer-dist laravel/laravel application 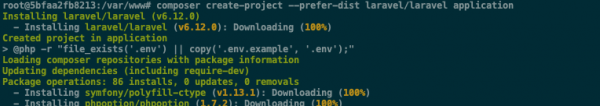
2.4. Po inštalácii skontrolujeme, či bola vytvorená zložka s projektom, a ukončíme compose.
ls
exit
docker-compose down
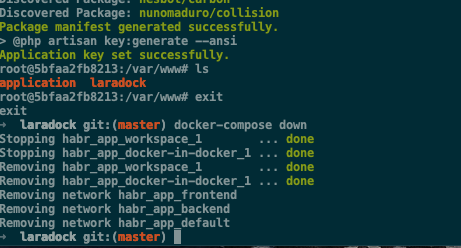
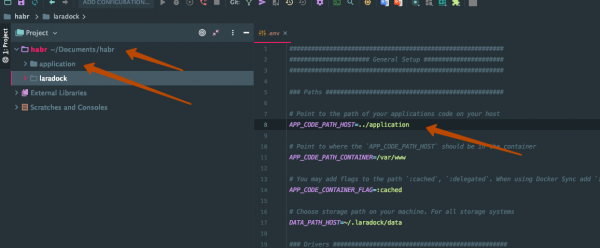
2.5. Vrátime sa späť do PHPStorm a nastavíme správnu cestu k nášmu laravel aplikácii v súbore .env.
3. Pridáme celý kód do Git.
Na toto vytvoríme na Github (alebo kdekoľvek inde) repozitár. Prejdeme v termináli do adresára habr a vykonáme nasledujúci kód.
echo "# habr-12factor" >> README.md
git init
git add README.md
git commit -m "first commit"
git remote add origin git@github.com:nzulfigarov/habr-12factor.git # tu bude odkaz na váš repozitár
git push -u origin master
git status
Skontrolujeme, či je všetko v poriadku.
Pre pohodlnosť odporúčam použiť nejaké vizuálne rozhranie pre Git, v mojom prípade je to . (tu je referral link)
4. Spúšťame!
Pred spustením sa uistite, že na porte 80 a 443 nemáte nič spustené.
docker-compose up -d nginx php-fpm 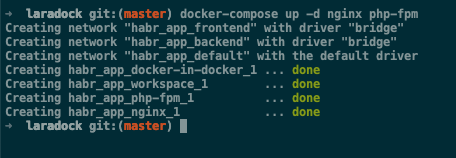
Takto náš projekt pozostáva z 3 samostatných služieb:
- nginx — webový server
- php-fpm — php na príjem požiadaviek z webového servera
- workspace — php pre vývojára
Doteraz sme dosiahli, že sme vytvorili aplikáciu zodpovedajúcu už 4 bodom z 12, a to konkrétne:
1. Kódová základňa — celý kód sa nachádza v jednom repozitári (malá poznámka: správne by mohol byť Docker zahrnutý do projektu laravel, ale to nie je zásadné).
2. Závislosti — Všetky naše závislosti sú jasne uvedené v application/composer.json a v každom Dockerfile každého kontajnera.
3. Externé služby (Backing Services) — Každá zo služieb (php-fpm, nginx, workspace) žije svojím vlastným životom a je pripojená zvonka, pričom pri práci s jednou službou nebude druhá dotknutá.
4. Procesy — každá služba je jeden proces. Každá zo služieb neukladá vnútorný stav.
5. Zviazanie portov (Port binding)
docker ps
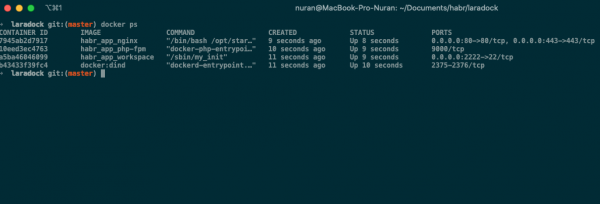
Ako vidíme, každá služba je spustená na svojom vlastnom porte a je dostupná pre všetky ostatné služby.
6. Paralelizmus
Docker nám umožňuje spúšťať niekoľko procesov tých istých služieb s automatickou vyvažovaním záťaže medzi nimi.
Zastavíme kontajnery a spustíme ich cez flag --scale
docker-compose down &&
docker-compose up -d --scale php-fpm=3 nginx php-fpm
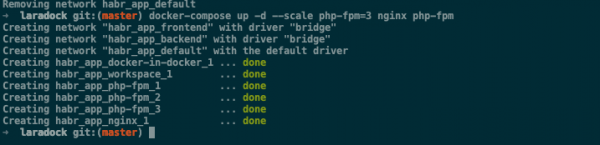
Ako vidíme, vytvorili sa kópie kontajnera php-fpm. Pri práci s týmto kontajnerom nemusíme nič meniť. Naďalej sa k nemu obraciame na porte 9000 a Docker za nás reguluje zaťaženie medzi kontajnermi.
7. Odstrániteľnosť (Disposability) — každý kontajner je možné zabiť bez škody pre iný. Zastavenie alebo reštart kontajnera nijako neovplyvní fungovanie aplikácie pri nasledujúcich spusteniach. Každý kontajner je možné spustiť aj kedykoľvek neskôr.
8. Parita vývoja/prevádzky aplikácie — všetky naše prostredia sú rovnaké. Spustením systému na serveri v produkcii nebudete musieť meniť nič vo svojich príkazoch. Všetko bude presne tak ako sa zakladá na Docker.
9. Zaznamenávanie (Logs) — všetky logy v týchto kontajneroch idú na prúd a sú viditeľné v konzole Docker. (v tomto prípade, v skutočnosti, s inými vlastnými kontajnermi, to môže byť inak, ak sa o to nezabezpečíte)
docker-compose logs -f 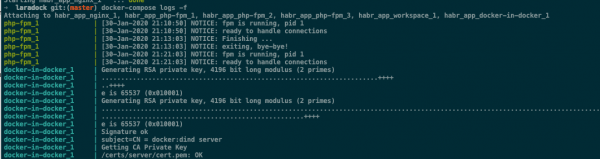
Ale tu je háčik v tom, že predvolené hodnoty v PHP a Nginx tiež zapisujú logy do súboru. Na splnenie 12 faktorov je potrebné vypnúť záznam logov do súboru v konfiguráciách každého kontajnera samostatne.
Docker tiež poskytuje možnosť smerovať logy nielen do stdout, ale aj do vecí ako graylog, o ktorom som hovoril vyššie. A vo vnútri graylogu môžeme manipulovať s logmi ľubovoľne a naša aplikácia si toho nič nevšimne.
10. Administratívne úlohy — všetky administratívne úlohy sú riešené Laravelom vďaka nástroju Artisan presne tak, ako by si to želali tvorcovia 12 faktového aplikácie.
Ako príklad ukážem, ako sa vykonávajú niektoré príkazy.
Vstúpime do kontajnera.
docker-compose exec workspace bash
php artisan list

Teraz môžeme využiť akýkoľvek príkaz. (všimnite si, že sme nenastavovali databázu a cache, takže polovica príkazov nebude správne vykonaná, pretože sú určené na prácu s cache a db).
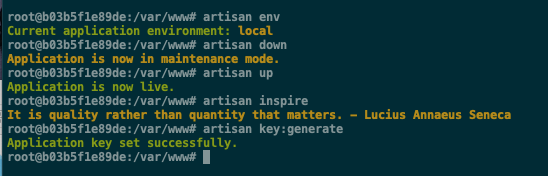
11. Konfigurácie a 12. Zostavenie, uvoľnenie, vykonanie
Túto časť som chcel venovať Blue-Green Deployment, ale ukázalo sa, že je to príliš rozsiahle pre tento článok. O tom napíšem samostatný článok.
V skratke, koncept spočíva v systémoch CI/CD typu Jenkins a Gitlab CI. V oboch môžete nastaviť prostredkové premenne týkajúce sa konkrétneho prostredia. Zodpovedajúcim spôsobom sa vykoná bod s Konfiguráciami.
A bod o Zostavenie, uvoľnenie, vykonanie sa rieši zabudovanými funkciami oboch nástrojov s názvom Pipeline.
Pipeline umožňuje rozdeľovať proces nasadzovania na mnoho fáz, vyčleňujúc fázy zostavenia, vydania a vykonania. Takisto v Pipeline môžete vytvárať zálohy, alebo vlastne čokoľvek. Tento nástroj má nekonečný potenciál.
Kód aplikácie sa nachádza na .
Nezabudnite inicializovať submodule pri klonovaní tohto repozitára.
P.S.: Všetky tieto prístupy je možné používať s akýmikoľvek inými nástrojmi a programovacími jazykmi. Dôležité je, aby podstata zostala rovnaká.
Zdroj: habr.com
