

Koda programske opreme za strojno učenje so pogosto zapletena in precej zmedena. Odkrivanje in odpravljanje napak v njej je zahtevna naloga. Tudi najpreprostejše zahtevajo resen pristop k omrežni arhitekturi, inicializaciji teže, optimizaciji mreže. Mala napaka lahko pripelje do neprijetnih težav.
Ta članek je posvečen algoritmu za odpravljanje napak vaših nevronskih mrež.
Skillbox priporoča: Praktični tečaj .
Opominjamo: za vse bralce »Habra« — popust 10 000 rubljev ob vpisu na kateri koli tečaj Skillbox s promo kodo »Habr«.
Algoritem se sestavlja iz petih faz:
- preprost začetek;
- potrditev izgub;
- preverjanje srednjih rezultatov in povezav;
- diagnostika parametrov;
- nadzor delovanja.
Če vam je kaj posebej zanimivo, lahko takoj preidete na te odseke.
Preprost začetek
Težko je odpravljati napake v nevronski mreži s kompleksno arhitekturo, regularizacijo in načrtovalnikom hitrosti učenja, kot v običajni. Tukaj se nekoliko pretvarjamo, ker ima ta točka k odpravljanju napak posreden odnos, a je kljub temu pomembno priporočilo.
Preprost začetek vključuje ustvarjanje poenostavljene modele in njegovo učenje na enem nizu (točki) podatkov.
Najprej ustvarimo poenostavljeno mrežo
Za hiter začetek ustvarimo majhno mrežo z enim skritim slojem in preverimo, da vse deluje pravilno. Nato postopoma zapletamo model in preverjamo vsak nov vidik njene strukture (dodaten sloj, parameter itd.), ter gremo naprej.
Učimo model na enem nizu (točki) podatkov
Kot hitro preverjanje delovanja vašega projekta lahko uporabite enega ali dva podatkovna točka za učenje, da potrdite, ali sistem deluje pravilno. Nevronska mreža mora pokazati 100 % natančnost pri učenju in preverjanju. Če ni tako, je bodisi model premajhen bodisi imate že napako.
Tudi če je vse v redu, pripravite model na enega ali več prehodov pred nadaljevanjem.
Ocena izgub
Ocena izgub je glavni način za natančno preučitev zmogljivosti modela. Preveriti morate, ali izguba ustreza nalogi ter ali se funkcije izgub ocenjujejo na pravilni lestvici. Če uporabljate več kot en tip izgub, se prepričajte, da so vsi enakega reda in pravilno skalirani.
Pomembno je biti pozoren na začetne izgube. Preverite, kako blizu je dejanski rezultat pričakovanemu, če je model začel s slučajnim predvidevanjem. V : „Prepričajte se, da dobivate rezultate, ki jih pričakujete ob začetku dela z majhnim številom parametrov. Bolje je takoj preveriti izgubo podatkov (s postavitvijo stopnje regularizacije na nič). Na primer, za CIFAR-10 z klasifikatorjem Softmax pričakujemo, da bodo začetne izgube 2.302, ker je pričakovana difuzna verjetnost 0,1 za vsak razred (ker je 10 razredov), izguba Softmax pa je negativna logaritmična verjetnost pravilnega razreda, kot je –ln (0.1) = 2.302“.
Za binarni primer se izvede podoben izračun za vsak od razredov. Tukaj so, na primer, podatki: 20 % 0’s in 80 % 1’s. Pričakovana začetna izguba bo do –0,2ln (0,5) –0,8ln (0,5) = 0,693147. Če je rezultat večji od 1, to lahko nakazuje, da uteži nevronske mreže niso ustrezno uravnotežene ali da podatki niso normalizirani.
Preverjamo vmesne rezultate in povezave
Za odpravljanje napak v nevronski mreži je treba razumeti dinamiko procesov znotraj omrežja in vlogo posameznih vmesnih plasti, saj so povezani. Tukaj so tipične napake, s katerimi se lahko srečate:
- napačne izraze za posodobitve gradienta;
- posodobitve uteži se ne uporabljajo;
- izgubljeni ali eksplodirajoči gradienti (exploding gradients).
Če so vrednosti gradienta ničelne, to pomeni, da je hitrost učenja v optimizatorju prenizka, ali pa ste naleteli na nepravilno izrazo za posodobitev gradienta.
Poleg tega je treba spremljati vrednosti funkcij aktivacije, uteži in posodobitve vsakega od plasti. Na primer, obseg posodobitev parametrov (uteži in premiki) .
Obstaja pojav, ki ga imenujemo „Dying ReLU“ ali , ko nevroni ReLU vrnejo nič po učenju velike negativne vrednosti (bias) premika za njihove uteži. Ti nevroni se nikoli več ne aktivirajo nikjer v podatkih.
Možete koristiti provjeru gradijenta kako biste otkrili te pogreške aproksimacijom gradijenta korištenjem numeričkog pristupa. Ako je blizu izračunatim gradijentima, tada je povratno širenje pravilno implementirano. Da biste stvorili provjeru gradijenta, upoznajte se s ovim izvrsnim resursima iz CS231. in , kao i s Andrews Nga o ovoj temi.
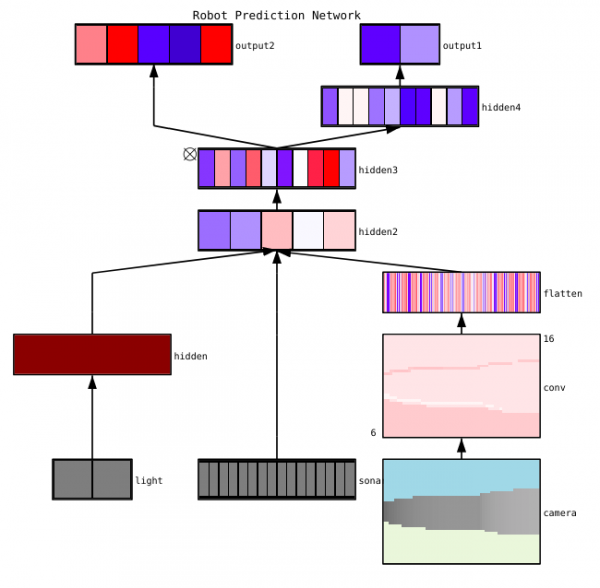
navodi tri glavne metode vizualizacije neuronske mreže:
- Predhodne — jednostavne metode koje nam prikazuju opću strukturu treniranog modela. One uključuju ispuštanje oblika ili filtara pojedinih slojeva neuronske mreže te parametara u svakom sloju.
- Temeljene na aktivaciji. U njima dekodiramo aktivacije pojedinih neurona ili grupa neurona kako bismo razumjeli njihove funkcije.
- Temeljene na gradijentima. Ove metode imaju tendenciju manipulacije gradijentima koji se formiraju tijekom naprijed i nazad prolaza prilikom treniranja modela (uključujući karte važnosti i karte aktivacije klase).
Postoji nekoliko korisnih alata za vizualizaciju aktivacija i veza pojedinih slojeva, poput in .
Dijagnostika parametara
Neuronske mreže imaju mnoštvo parametara koji međusobno djeluju, što otežava optimizaciju. Zapravo, ovaj odjeljak je predmet aktivnih istraživanja stručnjaka, stoga se prijedlozi u nastavku trebaju smatrati samo savjetima, početnim točkama s kojih se može polaziti.
Veličina paketa (batch size) — ako je potrebno, veličina paketa treba biti dovoljno velika za dobivanje točnih procjena gradijenta pogreške, ali dovoljno mala da stohastička metoda gradijentnog spuštanja (SGD) može urediti vašu mrežu. Male veličine paketa dovest će do brze konvergencije zbog šuma u procesu učenja i kasnijih poteškoća s optimizacijom. Više o tome je opisano .
Brzina učenja — previše niska će dovesti do spore konvergencije ili rizika da se zaglavite u lokalnim minimumima. U isto vrijeme, visoka brzina učenja će izazvati divergenciju optimizacije, budući da riskirate "iskakanje" kroz dubok, ali uski dio funkcije gubitka. Pokušajte koristiti planiranje brzine kako biste je smanjili tijekom učenja neuronske mreže. U tečaju CS231n. .
Gradijentna obrezovanje— obrezovanje gradijentov parametrov med povratnim širjenjem do največje vrednosti ali omejene norme. Uporabno za reševanje težav z eksplodirajočimi gradienti, s katerimi se lahko srečate v tretji točki.
Paketa normalizacija — se uporablja za normalizacijo vhodnih podatkov vsake plasti, kar pomaga rešiti težavo notranjega premika kovariacij. Če uporabljate Dropout in Batch Norma skupaj, .
Stohastični gradientni spust (SGD) — obstaja več različic SGD, ki uporabljajo zagon, prilagodljive hitrosti učenja in Nesterov način. Pri tem nobena od njih nima očitne prednosti glede učinkovitosti učenja ali generalizacije ().
Redukcija — je ključnega pomena za izgradnjo generalizabilnega modela, saj dodaja kazen za kompleksnost modela ali ekstremne vrednosti parametrov. To je način za zmanjšanje variance modela brez znatnega povečanja njegovega pristranskosti. Več .
Da bi vse sami ocenili, morate onemogočiti regularizacijo in sami preveriti gradijent izgube podatkov.
Dropout — še ena metoda za organizacijo vaše mreže, da preprečite prenajedanje. Med učenjem se dropout izvaja le z ohranjanjem aktivacije nevrona z določeno verjetnostjo p (hiperparameter) ali njegovo nastavitvijo na nič v nasprotnem primeru. Tako mora mreža uporabiti drugo podmnožico parametrov za vsak izobraževalni paket, kar zmanjša prilagoditve določenih parametrov, ki postanejo prevladujoči.
Pomembno: Če uporabljate tako dropout kot tudi paketno normalizacijo, bodite previdni pri vrstnem redu teh operacij ali celo pri njihovem skupnem uporabi. Vse to je še vedno aktivno razpravljalo in dopolnjevalo. Tu sta dve pomembni razpravi o tej temi in .
Nadzor dela
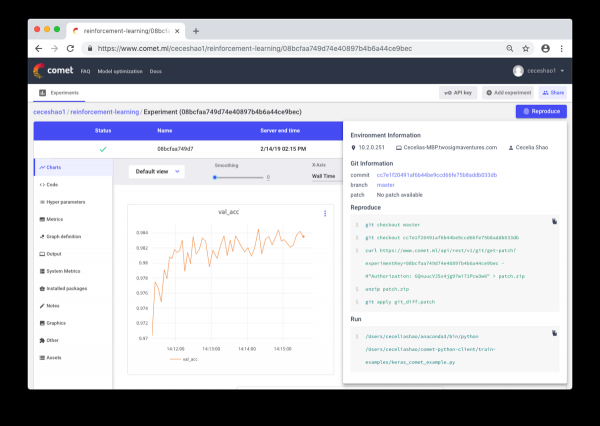
Gre za dokumentacijo delovnih procesov in eksperimentov. Če nič ne dokumentiramo, lahko pozabimo, katera hitrost učenja ali teža razredov se uporablja. Z nadzorom lahko brez težav pregledamo in ponovimo prejšnje eksperimenta. To omogoča zmanjšanje števila podvojenih eksperimentov.
Res je, da lahko ročna dokumentacija postane zahtevna naloga v primeru velikega obsega dela. Tukaj priskočijo na pomoč orodja, kot je Comet.ml, ki avtomatsko beležijo nabor podatkov, spremembe kode, zgodovino eksperimentov in proizvodne modele, vključno s ključnimi informacijami o vašem modelu (hiperparametri, zmogljivostni kazalniki modela in informacije o okolju).
Nevronska mreža je lahko zelo občutljiva na majhne spremembe, kar lahko privede do padca zmogljivosti modela. Sledenje in dokumentacija dela je prvi korak, ki ga je treba sprejeti za standardizacijo okolja in modeliranja.
Upam, da bo ta objava lahko postala izhodiščna točka, s katero boste začeli odpravljati napake svoje nevronske mreže.
Skillbox priporoča:
- Двухлетний практический курс .
- Spletni tečaj .
- Практический годовой курс .
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish