

Uvod
V tejto článku sa podrobne pozrieme na známy algoritmus Huffmana a jeho využitie pri kompresii dát.
V dôsledku toho napíšeme jednoduchý archivačný program. O tom už bol , ale bez praktickej realizácie. Teoretický materiál aktuálneho príspevku je prevzatý z hodin informatiky na škole a knihy Roberta Laforeho „Data Structures and Algorithms in Java“. Takže, všetko je pod katom!
Trošku úvah
V bežnom textovom súbore je jeden znak kódovaný 8 bitmi (kódovanie ASCII) alebo 16 (kódovanie Unicode). Ďalej sa budeme zaoberať kódovaním ASCII. Pre príklad vezmime reťazec s1 = „SUSIE SAYS IT IS EASYn“. Celkovo má reťazec 22 znakov, vrátane medzier a znaku pre prechod na novú líniu - 'n'. Súbor obsahujúci tento reťazec bude mať veľkosť 22*8 = 176 bitov. Hneď sa pýta otázka: je rozumné používať všetkých 8 bitov na kódovanie 1 znaku? Predsa len, nepoužívame všetky znaky kódovania ASCII. Dokonca aj keby sme ich používali, rozumnejšie by bolo najčastejšiemu písmenu - S - priznať najkratší možný kód, a najzriedkavejšiemu písmenu - T (alebo U, alebo 'n') - dať dlhší kód. V tom spočíva algoritmus Huffmana: je nutné nájsť optimálnu variantu kódovania, pri ktorej bude súbor minimálnej veľkosti. Je celkom normálne, že rôzne znaky budú mať rôzne dĺžky kódu - na tom je algoritmus založený.
Kodiranje
Prečo by sme znaku ‚S‘ nemohli dať kód, napríklad dĺžky 1 bit: 0 alebo 1. Nech je to 1. Potom druhému najčastejšiemu znaku - ' ' (medzera) - dáme 0. Predstavte si, že ste začali dekódovať svoju správu - zakódovaný reťazec s1 - a vidíte, že kód začína 1. Takže, čo robiť: je to znak S, alebo je to nejaký iný znak, napríklad A? Preto vzniká dôležité pravidlo:
Žiadny kód nesmie byť prefixom iného
Toto pravidlo je kľúčové v algoritme. Preto sa vytvorenie kódu začína z frekvenčnej tabuľky, v ktorej je uvedená frekvencia (počet výskytov) každého znaku:
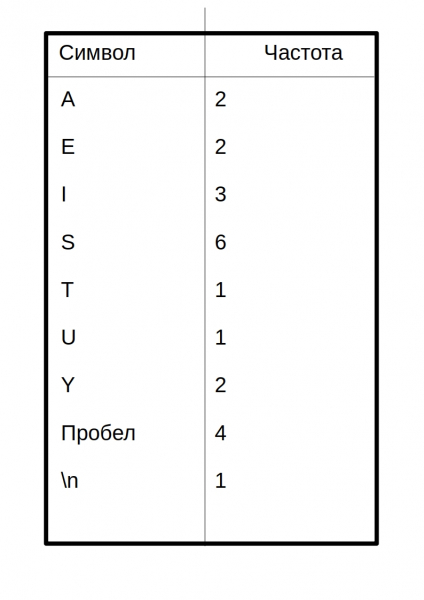 Znaky s najväčším počtom výskytov by mali byť kódované najmenším možným počtom bitov. Uvediem príklad jednej z možných tabuliek kódov:
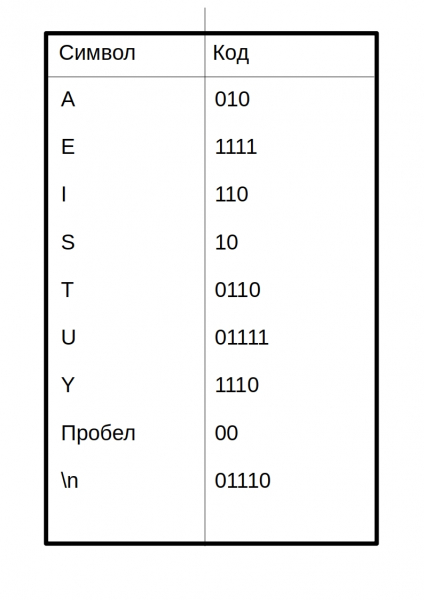 Takže zakódovaná správa bude vyzerať takto:
10 01111 10 110 1111 00 10 010 1110 10 00 110 0110 00 110 10 00 1111 010 10 1110 01110 Kód každého znaku som oddelil medzerou. V skutočnosti v komprimovanom súbore to takto nebude!
Iz tega izhaja vprašanje: kako je ta mladenič izumil kodo za ustvarjanje tabele kodov? O tem bomo govorili spodaj.
Zgraditev Huffmanovega drevesa
Tukaj priskočijo na pomoč binarna iskana drevesa. Ne skrbite, tukaj ne potrebujemo metod iskanja, vstavljanja in brisanja. Tukaj je struktura drevesa v javinem jeziku:
public class Node {
    private int frequence;
    private char letter;
    private Node leftChild;
    private Node rightChild;
    ...
}
class BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }
    public BinaryTree(Node root) {
        this.root = root;
    }
    ...
}
To ni celoten koda, celotna koda bo spodaj.
Tukaj je sam algoritem za zgraditev drevesa:
- Ustvarite objekt Node za vsako črko iz sporočila (niz s1). V našem primeru bo 9 vozlišč (objektov Node). Vsako vozlišče vsebuje dve podatkovni polji: znak in frekvenco.
- Ustvarite objekt Drevesa (BinaryTree) za vsako od vozlišč Node. Vozlišče postane koren drevesa.
- Vstavite ta drevesa v prednostno vrsto. Manjša kot je frekvenca, večji je prioritet. Tako bo ob izvleku vedno izbrano drevo z najmanjšo frekvenco.
Nato je treba ciklično izvesti naslednje:
- Izvlecite dve drevesi iz prednostne vrste in ju naredite za potomca novega vozlišča (pravkar ustvarjenega vozlišča brez črke). Frekvenca novega vozlišča je enaka vsoti frekvenc dveh dreves- potomcev.
- Za to vozlišče ustvarite drevo s korenom v tem vozlišču. Vstavite to drevo nazaj v prednostno vrsto. (Ker ima drevo novo frekvenco, se verjetno premakne na novo mesto v vrsti)
- Nadaljujte z izvajanjem korakov 1 in 2, dokler v vrsti ne ostane eno drevo — Huffmanovo drevo.
Poglejmo ta algoritem na nizu s1:
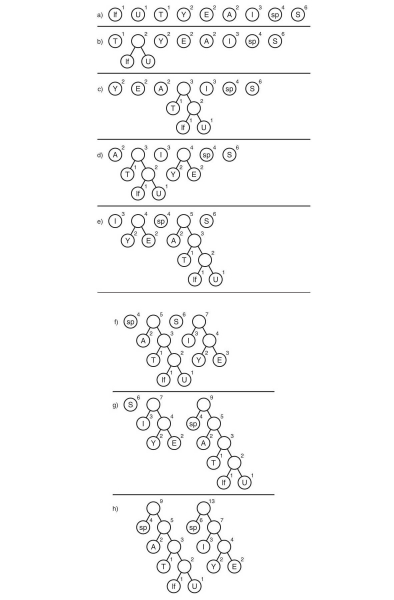
Tukaj znak „lf“ (linefeed) pomeni prehod na novo vrstico, „sp“ (space) — to je presledek.
Kaj pa naprej?
Dobili smo Huffmanovo drevo. No, v redu. Kaj zdaj z njim? Tudi brezplačno ga ne bodo vzeli. In nato je treba slediti vse možne poti od korena do listov drevesa. Dogovorimo se, da bomo označili rob 0, če pelje do levega potomca in 1 — če do desnega. Strogo gledano, v teh označbah je koda znaka — to pot od korena drevesa do lista, ki vsebuje ta simbol.
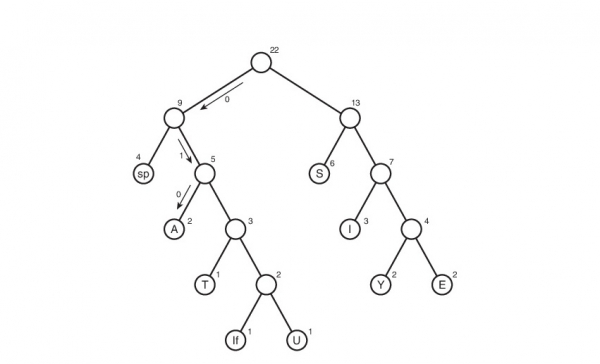
Na ta način je nastala tabela kodova. Primećujemo da, ako proučimo ovu tabelu, možemo doći do zaključka o „težini“ svakog simbola — to je dužina njegovog koda. Tada će u kompresovanom obliku originalna datoteka težiti: 2 * 3 + 2*4 + 3 * 3 + 6 * 2 + 1 * 4 + 1 * 5 + 2 * 4 + 4 * 2 + 1 * 5 = 65 bita. Na početku je težila 176 bita. Dakle, smanjili smo je čak 176/65 = 2.7 puta! Ali to je utopija. Takav koeficijent teško da će biti postignut. Zašto? O tome ćemo govoriti malo kasnije.
Dekodiranje
Pa, možda je ostalo najjednostavnije — dekodiranje. Mislim da su mnogi od vas shvatili da nije moguće jednostavno kreirati kompresovanu datoteku bez ikakvih naznaka o tome kako je kodirana — nećemo moći da je dekodiramo! Da, bilo mi je teško to prihvatiti, ali moramo kreirati tekstualnu datoteku table.txt sa tabelom kompresije:
01110
 00
A010
E1111
I110
S10
T0110
U01111
Y1110
Zapisivanje tabele u obliku 'simbol'«kod simbola». Zašto 01110 bez simbola? U stvari, on ima simbol, samo alati Java koje sam koristio prilikom ispisivanja u datoteku konvertuju simbol prelaza na novu liniju — ‘n’ — u prelaz na novu liniju (kako god to glupo zvučalo). Stoga je prazna linija iznad simbol za kod 01110. Za kod 00 simbol je razmak na početku linije. Odmah ću reći da je našem koeficijentu kraj — ovaj način čuvanja tabele može biti najneracionalniji. Ali je jednostavan za razumevanje i implementaciju. Rado ću čuti vaše preporuke u komentarima u vezi optimizacije.
Imajući ovu tabelu, veoma je lako dekodirati. Setimo se kojim pravilom smo se vodili pri kreiranju kodiranja:
Nijedan kod ne sme biti prefiks drugog
E tu igra olakšavajuću ulogu. Čitamo sekvencijalno bit po bit, i, čim dobijena string d, koja se sastoji od pročitanych bitova, odgovara kodiranju koje odgovara simbolu karaktera, odmah znamo da je kodiran simbol karaktera (i samo on!). Zatim zapisujemo karakter u dekodiranu string (string koji sadrži dekodiranu poruku), resetujemo string d, i čitamo dalje kodiranu datoteku.
Implementacija
Došlo je vreme da ponizim svoj kod i napišem arhivator. Nazvaćemo ga Compressor.
Započnimo od početka. Prvo što radimo je pisanje klase Node:
public class Node {
    private int frequence; //frekvenca
    private char letter; //črka
    private Node leftChild; //levo dete
    private Node rightChild; //desno dete

    public Node(char letter, int frequence) { //konstruktor
        this.letter = letter;
        this.frequence = frequence;
    }

    public Node() {} //preteran konstruktor za bezimene čvorove (vidi gore u delu o izgradnji Huffmanovog stabla)
    public void addChild(Node newNode) { //dodati dete
        if (leftChild == null) //ako je levo prazno => desno će takođe biti prazno => dodajemo u levo
            leftChild = newNode;
        else {
            if (leftChild.getFrequence() <= newNode.getFrequence()) //generalno, levi potomak
                rightChild = newNode; //biće onaj s manjom frekvencijom
            else {
                rightChild = leftChild;
                leftChild = newNode;
            }
        }

        frequence += newNode.getFrequence(); //konačna frekvencija
    }

    public Node getLeftChild() {
        return leftChild;
    }

    public Node getRightChild() {
        return rightChild;
    }

    public int getFrequence() {
        return frequence;
    }

    public char getLetter() {
        return letter;
    }

    public boolean isLeaf() { //provera list
        return leftChild == null && rightChild == null;
    }
}
Sada drvo:
class BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }

    public BinaryTree(Node root) {
        this.root = root;
    }

    public int getFrequence() {
        return root.getFrequence();
    }

    public Node getRoot() {
        return root;
    }
}
Prioritetna čeka:
import java.util.ArrayList; //da-da, ček će biti na osnovu liste

class PriorityQueue {
    private ArrayList data; //lista čeke
    private int nElems; //broj elemenata u čeki

    public PriorityQueue() {
        data = new ArrayList();
        nElems = 0;
    }

    public void insert(BinaryTree newTree) { //ubacivanje
        if (nElems == 0)
            data.add(newTree);
        else {
            for (int i = 0; i  newTree.getFrequence()) { //ako je frekvencija ubacivanog drveta manja
                    data.add(i, newTree); //nego trenutna, onda pomeramo sva stabla na desnim pozicijama za 1
                    break; //zatim stavljamo novo drvo na poziciju trenutnog
                }
                if (i == nElems - 1)
                    data.add(newTree);
            }
        }
        nElems++; //povećavamo broj elemenata za 1
    }

    public BinaryTree remove() { //brisanje iz čeke
        BinaryTree tmp = data.get(0); //kopiramo brisani element
        data.remove(0); //zapravo, brišemo
        nElems--; //smanjujemo broj elemenata za 1
        return tmp; //vraćamo obrisani element (element s najmanjom frekvencijom)
    }
}
Klasa koja stvara Huffmanovo stablo:
public class HuffmanTree {
    private final byte ENCODING_TABLE_SIZE = 127; // длина кодировочной таблицы
    private String myString; // сообщение
    private BinaryTree huffmanTree; // дерево Хаффмана
    private int[] freqArray; // частотная таблица
    private String[] encodingArray; // кодировочная таблица

    // ----------------constructor----------------------
    public HuffmanTree(String newString) {
        myString = newString;

        freqArray = new int[ENCODING_TABLE_SIZE];
        fillFrequenceArray();

        huffmanTree = getHuffmanTree();

        encodingArray = new String[ENCODING_TABLE_SIZE];
        fillEncodingArray(huffmanTree.getRoot(), "", "");
    }

    // --------------------frequence array------------------------
    private void fillFrequenceArray() {
        for (int i = 0; i < myString.length(); i++) {
            freqArray[(int)myString.charAt(i)]++;
        }
    }

    public int[] getFrequenceArray() {
        return freqArray;
    }

    // ------------------------huffman tree creation------------------
    private BinaryTree getHuffmanTree() {
        PriorityQueue pq = new PriorityQueue();
        // алгоритм описан выше
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) { // если символ существует в строке
                Node newNode = new Node((char) i, freqArray[i]); // то создать для него Node
                BinaryTree newTree = new BinaryTree(newNode); // а для Node создать BinaryTree
                pq.insert(newTree); // вставить в очередь
            }
        }

        while (true) {
            BinaryTree tree1 = pq.remove(); // извлечь из очереди первое дерево.

            try {
                BinaryTree tree2 = pq.remove(); // извлечь из очереди второе дерево

                Node newNode = new Node(); // создать новый Node
                newNode.addChild(tree1.getRoot()); // сделать его потомками два извлеченных дерева
                newNode.addChild(tree2.getRoot());

                pq.insert(new BinaryTree(newNode);
            } catch (IndexOutOfBoundsException e) { // осталось одно дерево в очереди
                return tree1;
            }
        }
    }

    public BinaryTree getTree() {
        return huffmanTree;
    }

    // -------------------encoding array------------------
    void fillEncodingArray(Node node, String codeBefore, String direction) { // заполнить кодировочную таблицу
        if (node.isLeaf()) {
            encodingArray[(int)node.getLetter()] = codeBefore + direction;
        } else {
            fillEncodingArray(node.getLeftChild(), codeBefore + direction, "0");
            fillEncodingArray(node.getRightChild(), codeBefore + direction, "1");
        }
    }

    String[] getEncodingArray() {
        return encodingArray;
    }

    public void displayEncodingArray() { // для отладки
        fillEncodingArray(huffmanTree.getRoot(), "", "");

        System.out.println("======================Encoding table====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            }
        }
        System.out.println("========================================================");
    }
    // -----------------------------------------------------
    String getOriginalString() {
        return myString;
    }
}
Класс, который отвечает за кодирование и декодирование:
public class HuffmanOperator {
    private final byte ENCODING_TABLE_SIZE = 127; // длина таблицы
    private HuffmanTree mainHuffmanTree; // дерево Хаффмана (используется только для сжатия)
    private String myString; // исходное сообщение
    private int[] freqArray; // частотная таблица
    private String[] encodingArray; // кодировочная таблица
    private double ratio; // коэффициент сжатия


    public HuffmanOperator(HuffmanTree MainHuffmanTree) { // for compress
        this.mainHuffmanTree = MainHuffmanTree;

        myString = mainHuffmanTree.getOriginalString();

        encodingArray = mainHuffmanTree.getEncodingArray();

        freqArray = mainHuffmanTree.getFrequenceArray();
    }

    public HuffmanOperator() {} // for extract;

    // ---------------------------------------compression-----------------------------------------------------------
    private String getCompressedString() {
        String compressed = "";
        String intermidiate = ""; // промежуточная строка(без добавочных нулей)
        //System.out.println("=============================Compression=======================");
        //displayEncodingArray();
        for (int i = 0; i
        // нужно добавить нули в конец(можно 1, нет разницы)
        byte counter = 0; // количество добавленных в конец нулей (байта в полне хватит: 0<=counter<8<127)
        for (int length = intermidiate.length(), delta = 8 - length % 8;
                counter < delta; counter++) { // delta - количество добавленных нулей
            intermidiate += "0";
        }

        // склеить кол-во добавочных нулей в бинарном предаствлении и промежуточную строку
        compressed = String.format("%8s", Integer.toBinaryString(counter & 0xff)).replace(" ", "0") + intermidiate;

        // идеализированный коэффициент
        setCompressionRatio();
        //System.out.println("===============================================================");
        return compressed;
    }

    private void setCompressionRatio() { // посчитать идеализированный коэффициент
        double sumA = 0, sumB = 0; // A-the original sum
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                sumA += 8 * freqArray[i];
                sumB += encodingArray[i].length() * freqArray[i];
            }
        }
        ratio = sumA / sumB;
    }

    public byte[] getBytedMsg() { // final compression
        StringBuilder compressedString = new StringBuilder(getCompressedString());
        byte[] compressedBytes = new byte[compressedString.length() / 8];
        for (int i = 0; i < compressedBytes.length; i++) {
                compressedBytes[i] = (byte) Integer.parseInt(compressedString.substring(i * 8, (i + 1) * 8), 2);
        }
        return compressedBytes;
    }
    // ---------------------------------------end of compression----------------------------------------------------------------
    // ------------------------------------------------------------extract-----------------------------------------------------
    public String extract(String compressed, String[] newEncodingArray) {
        String decompressed = "";
        String current = "";
        String delta = "";
        encodingArray = newEncodingArray;

        //displayEncodingArray();
        // получить кол-во вставленных нулей
        for (int i = 0; i < 8; i++)
            delta += compressed.charAt(i);
        int ADDED_ZEROES = Integer.parseInt(delta, 2);

        for (int i = 8, l = compressed.length() - ADDED_ZEROES; i < l; i++) {
            //i = 8, т.к. первым байтом у нас идет кол-во вставленных нулей
            current += compressed.charAt(i);
            for (int j = 0; j < ENCODING_TABLE_SIZE; j++) {
                if (current.equals(encodingArray[j])) { // если совпало
                    decompressed += (char)j; // то добавляем элемент
                    current = ""; // и обнуляем текущую строку
                }
            }
        }

        return decompressed;
    }

    public String getEncodingTable() {
        String enc = "";
        for (int i = 0; i < encodingArray.length; i++) {
            if (freqArray[i] != 0)
                enc += (char)i + encodingArray[i] + 'n';
        }
        return enc;
    }

    public double getCompressionRatio() {
        return ratio;
    }


    public void displayEncodingArray() { // для отладки
        System.out.println("======================Encoding table====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            //if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            //}
        }
        System.out.println("========================================================");
    }
}
Razred, ki olajša pisanje v datoteko:
import java.io.File;
import java.io.PrintWriter;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.Closeable;

public class FileOutputHelper implements Closeable {
    private File outputFile;
    private FileOutputStream fileOutputStream;

    public FileOutputHelper(File file) throws FileNotFoundException {
        outputFile = file;
        fileOutputStream = new FileOutputStream(outputFile);
    }

    public void writeByte(byte msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeBytes(byte[] msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeString(String msg) {
    	try (PrintWriter pw = new PrintWriter(outputFile)) {
    		pw.write(msg);
    	} catch (FileNotFoundException e) {
    		System.out.println("Napačna pot ali datoteka ne obstaja!");
    	}
    }

    @Override
    public void close() throws IOException {
        fileOutputStream.close();
    }

    public void finalize() throws IOException {
        close();
    }
}
Razred, ki olajša branje iz datoteke:
import java.io.FileInputStream;
import java.io.EOFException;
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.Closeable;
import java.io.File;
import java.io.IOException;

public class FileInputHelper implements Closeable {
	private FileInputStream fileInputStream;
	private BufferedReader fileBufferedReader;

	public FileInputHelper(File file) throws IOException {
		fileInputStream = new FileInputStream(file);
		fileBufferedReader = new BufferedReader(new InputStreamReader(fileInputStream));
	}


    public byte readByte() throws IOException {
    	int cur = fileInputStream.read();
    	if (cur == -1) // če je datoteka končana
    		throw new EOFException();
    	return (byte)cur;
    }

    public String readLine() throws IOException {
    	return fileBufferedReader.readLine();
    }

    @Override
    public void close() throws IOException{
    	fileInputStream.close();
    }
}
In glavni razred:
import java.io.File;
import java.nio.charset.MalformedInputException;
import java.io.FileNotFoundException;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.NoSuchFileException;
import java.nio.file.Paths;
import java.util.List;
import java.io.EOFException;
public class Main {
	private static final byte ENCODING_TABLE_SIZE = 127;

    public static void main(String[] args) throws IOException {
        try {//specifying instruction using command line arguments
            if (args[0].equals("--compress") || args[0].equals("-c"))
                compress(args[1]);
            else if ((args[0].equals("--extract") || args[0].equals("-x"))
            		&& (args[2].equals("--table") || args[2].equals("-t"))) {
            	extract(args[1], args[3]);
            }
            else
                throw new IllegalArgumentException();
        } catch (ArrayIndexOutOfBoundsException | IllegalArgumentException e) {
            System.out.println("Invalid argument format ");
            System.out.println("Please read Readme.txt");
            e.printStackTrace();
        }
    }

	public static void compress(String stringPath) throws IOException {
        List stringList;
        File inputFile = new File(stringPath);
        String s = "";
        File compressedFile, table;

        try {
            stringList = Files.readAllLines(Paths.get(inputFile.getAbsolutePath()));
        } catch (NoSuchFileException e) {
            System.out.println("Invalid path, or the file does not exist!");
            return;
        } catch (MalformedInputException e) {
        	System.out.println("The current file encoding is not supported");
        	return;
        }

        for (String item : stringList) {
            s += item;
            s += 'n';
        }

        HuffmanOperator operator = new HuffmanOperator(new HuffmanTree(s));

        compressedFile = new File(inputFile.getAbsolutePath() + ".cpr");
        compressedFile.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(compressedFile)) {
        	fo.writeBytes(operator.getBytedMsg());
        }
        //create file with encoding table:

        table = new File(inputFile.getAbsolutePath() + ".table.txt");
        table.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(table)) {
        	fo.writeString(operator.getEncodingTable());
        }

        System.out.println("Path to compressed file: " + compressedFile.getAbsolutePath());
        System.out.println("Path to encoding table " + table.getAbsolutePath());
        System.out.println("Without the table, the file will be impossible to extract!");

        double idealRatio = Math.round(operator.getCompressionRatio() * 100) / (double) 100; //ideal ratio
        double realRatio = Math.round((double) inputFile.length()
        		/ ((double) compressedFile.length() + (double) table.length()) * 100) / (double)100; //real ratio

        System.out.println("Ideal compression ratio is " + idealRatio);
        System.out.println("Compression ratio considering the encoding table " + realRatio);
    }

    public static void extract(String filePath, String tablePath) throws FileNotFoundException, IOException {
        HuffmanOperator operator = new HuffmanOperator();
        File compressedFile = new File(filePath),
        	 tableFile = new File(tablePath),
        	 extractedFile = new File(filePath + ".xtr");
        String compressed = "";
        String[] encodingArray = new String[ENCODING_TABLE_SIZE];
        //read compressed file
        //!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!check here:
        try (FileInputHelper fi = new FileInputHelper(compressedFile)) {
        	byte b;
        	while (true) {
        		b = fi.readByte();//method returns EOFException
        		compressed += String.format("%8s", Integer.toBinaryString(b & 0xff)).replace(" ", "0");
        	}
        } catch (EOFException e) {

        }

        //--------------------

        //read encoding table:
        try (FileInputHelper fi = new FileInputHelper(tableFile)) {
        	fi.readLine();//skip first empty string
        	encodingArray[(byte)'n'] = fi.readLine();//read code for 'n'
        	while (true) {
        		String s = fi.readLine();
        		if (s == null)
        			throw new EOFException();
        		encodingArray[(byte)s.charAt(0)] = s.substring(1, s.length());
        	}
        } catch (EOFException ignore) {}

        extractedFile.createNewFile();
        //extract:
		try (FileOutputHelper fo = new FileOutputHelper(extractedFile)) {
			fo.writeString(operator.extract(compressed, encodingArray));
		}

		System.out.println("Path to unpacked file " + extractedFile.getAbsolutePath());
    }
}
Datoteko z navodili readme.txt boste morali napisati sami 🙂
Zaključek
Verjetno je to vse, kar sem hotel povedati. Če imate kakšne pripombe glede moje pomanjkljivosti pri izboljšavah kode, algoritma ali kakršne koli optimizacije, me mirno obvestite. Če sem kaj slabo razložil, prav tako zapišite. Vesel bom vaših komentarjev!
P.S.
Da, da, še vedno sem tukaj, saj nisem pozabil na faktor. Za niz s1 teža kodirne tabele znaša 48 bajtov — precej več od izvirne datoteke, pa tudi dodanih ničel nismo pozabili (število dodanih ničel je 7) => faktor stiskanja bo manjši od enote: 176/(65 + 48*8 + 7)=0.38. Če ste to tudi opazili, ste res pametni. Da, ta implementacija bo bolj neskladna za majhne datoteke. Kaj pa se zgodi z velikimi datotekami? Velikosti datotek znatno presegajo velikost kodirne tabele. Tukaj pa algoritem deluje tako, kot bi moral! Na primer, za kompresor izda pravilen (ne idealiziran) faktor, enak 1.46 — skoraj enkrat in pol! In ja, predvideno je bilo, da bo datoteka v angleškem jeziku.
Izvor: habr.com
