

V letu 2017 smo zmagali na razpisu za razvoj transakcijskega jedra investicijskega poslovanja Alfa-Banka in začeli z delom (na HighLoad++ 2018 smo predstavili poročilo o jedru investicijskega poslovanja Vladimir Drynkin, vodja področja transakcijskega jedra investicijskega poslovanja Alfa-Banka). Ta sistem je moral agregirati podatke o transakcijah iz različnih virov v različnih formatih, jih usklajevati, shranjevati in omogočiti dostop do njih.
Med razvojem je sistem evolucijal in pridobival funkcionalnosti, in v nekem trenutku smo spoznali, da se nam kristalizira nekaj veliko večjega kot le aplikativna programska oprema, ustvarjena za reševanje strogo določenega kroga nalog: razvili smo sistem za gradnjo razdeljenih aplikacij s trajnim shranjevanjem. Naša pridobljena izkušnja je postavila temelje novega produkta — (TDG).
Rad bi spregovoril o arhitekturi TDG in o rešitvah, do katerih smo prišli med razvojem, vas seznanil z glavnimi funkcionalnostmi ter pokazal, kako lahko naš izdelek postane osnova za gradnjo celovitih rešitev.
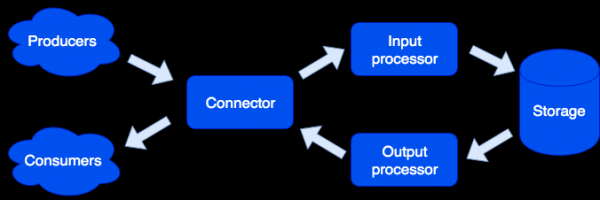
Arhitekturno smo sistem razdelili na ločene vloge, katerih vsaka je odgovorna za reševanje določenega kroga nalog. Eden zagnanega vzorca aplikacije izvaja eno ali več vrst vlog. V grozdu je lahko več vlog iste vrste:
Connector
Connector skrb za povezavo z zunanjim svetom; njegova naloga je sprejeti prošnjo, jo obdelati in, če je bila uspešna, poslati podatke v obdelavo v vhodni procesor. Podpiramo formate HTTP, SOAP, Kafka, FIX. Arhitektura omogoča enostavno dodajanje podpore novim formatom, kmalu bo podpora za IBM MQ. Če razčlenitev prošnje zaključi z napako, connector vrne napako; v nasprotnem primeru bo odgovoril, da je bila prošnja uspešno obdelana, tudi če je pri nadaljnji obdelavi prišlo do napake. To je storjeno namensko, da bi delovali s sistemi, ki ne znajo ponavljati prošenj — ali nasprotno, to počnejo preveč vztrajno. Da ne bi izgubili podatkov, se uporablja popravna vrsta: objekt najprej pride vanjo in šele po uspešni obdelavi odstrani iz nje. Administrator lahko prejme obvestila o objektih, ki so ostali v popravni vrsti, ter po odpravi programske napake ali strojne okvare izvede ponovni poskus.
Vhodni procesor
Vhodni procesor razvršča prejeti podatke po značilnostih in pokliče ustrezne obdelovalce. Obdelovalci so koda v jeziku Lua, ki se izvaja v peskovniku, s tem pa ne morejo vplivati na delovanje sistema. Na tej stopnji je mogoče podatke prilagoditi potrebnemu oblikovanju, prav tako pa po potrebi zagnati poljubno število nalog, ki lahko izvajajo potrebno logiko. Na primer, v produktu MDM (Master Data Management), zgrajenem na Tarantool Data Grid, ob dodajanju novega uporabnika, da ne bi upočasnili obdelave prošnje, ustvarjanje zlatega zapisa zagnamo kot ločeno nalogo. Peskovnik podpira poizvedbe za branje, spremembo in dodajanje podatkov, omogoča izvajanje določene funkcije na vseh vlogah tipa storage in agregacijo rezultata (map/reduce).
Obdelovalci so lahko opisani v datotekah:
sum.lua

local x, y = unpack(...)
return x + y
In nato razglašeni v konfiguraciji:
functions:
  sum: { __file: sum.lua }
Zakaj Lua? Lua je zelo preprost jezik. Na podlagi naših izkušenj, po nekaj urah spoznavanja z njim, ljudje začnejo pisati kodo, ki rešuje njihovo nalogo. In to niso samo profesionalni razvijalci, temveč na primer analitiki. Poleg tega, zahvaljujoč jit-kompilerju, Lua deluje zelo hitro.
Shramba
Storage hrani perzistentne podatke. Pred shranjevanjem se podatki validirajo glede na shemo podatkov. Za opis sheme uporabljamo razširjen format . Primer:
{
    "name": "User",
    "type": "record",
    "logicalType": "Aggregate",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "first_name", "type": "string"},
        {"name": "last_name", "type": "string"}
    ],
    "indexes": ["id"]
}
Na podlagi tega opisa se samodejno generira DDL (jezik definicije podatkov) za SGBD Tarantul in shema za dostop do podatkov.
Podpira se asinhrona replikacija podatkov (v načrtu je dodati sinhrono).
Output procesor
Včasih je treba obvestiti zunanje porabnike o prihodu novih podatkov, za to obstaja vloga Output procesor. Po shranjevanju podatkov se lahko ti prenesejo v ustrezen obdelovalec (na primer, da jih oblikujemo v obliko, ki jo zahteva porabnik) — in nato prenesejo v connector za pošiljanje. Tukaj se prav tako uporablja popravna vrsta: če objekta nihče ne sprejme, lahko skrbnik poskusi znova kasneje.
Skaliranje
Vloge connector, input procesor in output procesor nimajo stanja, kar omogoča horizontalno skaliranje sistema preprosto s dodajanjem novih primerkov aplikacije z vklopljeno vlogo ustrezne vrste. Za horizontalno skaliranje storage se uporablja k organizaciji klasterja z uporabo virtualnih vedrov. Po dodajanju novega strežnika se del vedrov s starih strežnikov v ozadju preseli na nov strežnik; to se zgodi prozorno za uporabnike in ne vpliva na delovanje celotnega sistema.
Lastnosti podatkov
Objekti so lahko zelo veliki in vsebujejo druge objekte. Zagotavljamo atomarnost dodajanja in posodabljanja podatkov, tako da shranimo objekt z vsemi odvisnostmi v eno virtualno vedro. Tako se izognemo "razmazovanju" objekta po več fizičnih strežnikih.
Podpira verzionnost': vsako obnavljanje objekta ustvari novo različico, zato imamo vedno možnost, da naredimo časovni rez in si ogledamo, kako je svet izgledal takrat. Za podatke, ki ne potrebujejo dolge zgodovine, lahko omejimo število različic ali celo shranimo le eno — zadnjo, kar pomeni, da dejansko izklopimo verzioniranje za določen tip. Prav tako lahko časovno omejimo zgodovino: na primer, izbrišemo vse objekte nekega tipa, starejše od 1 leta. Podpira tudi arhiviranje: lahko izvozimo objekte, starejše od določenega časa, s čimer sproščamo prostor v grozdu.
Zadaci
Iz zanimivih funkcij velja omeniti možnost izvajanja nalog po urniku, na zahtevo uporabnika ali programatično iz peskovnika:
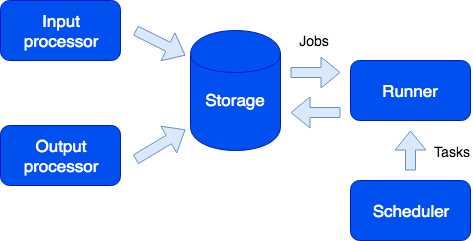
Tukaj vidimo še eno vlogo — runner. Ta vloga nima stanja in po potrebi lahko dodamo dodatne primere aplikacije s to vlogo v grozd. Odgovornost runnerja je izvajanje nalog. Kot je bilo omenjeno, je mogoče iz peskovnika ustvarjati nove naloge; te se shranijo v vrsto na shrambi in nato izvajajo na runnerju. Ta vrsta nalog se imenuje Job. Imamo tudi vrsto nalog, imenovano Task — to so naloge, ki jih določi uporabnik in jih izvajamo po urniku (uporablja se sintaksa cron) ali na zahtevo. Za zagon in spremljanje takih nalog imamo priročen upravljalnik nalog. Da bi bila ta funkcionalnost na voljo, je treba omogočiti vlogo scheduler; ta vloga ima stanje, zato ni razširljiva, kar pa tudi ni potrebno; obenem pa ima, tako kot vse druge vloge, lahko repliko, ki začne delovati, če master nenadoma odpove.
Logger
Še ena vloga se imenuje logger. Ta zbira dnevnike vseh članov grozda in ponuja vmesnik za njihovo izvoz in ogled preko spletnega vmesnika.
Storitve
Vredno je omeniti, da sistem omogoča enostavno ustvarjanje storitev. V konfiguracijski datoteki lahko navedete, katere zahteve usmeriti na obdelovalec, ki ga je napisal uporabnik in se izvaja v peskovniku. V tem obdelovalcu je mogoče na primer izvesti neko analitično poizvedbo in vrniti rezultat.
Storitev je opisana v konfiguracijski datoteki:
services:
   sum:
      doc: "dodaja dve številki"
      function: sum
      return_type: int
      args:
         x: int
         y: int
GraphQL API se samodejno generira in storitev postane dostopna za klice:
poizvedba {
   vsota(x: 1, y: 2)
}
To bo povzročilo klic obdelovalnika sum, ki bo vrnil rezultat:
3
Profiliranje poizvedb in metrike
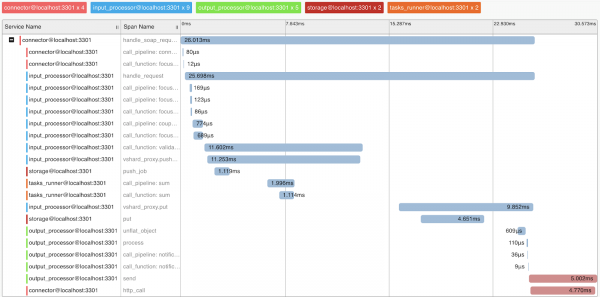
Za razumevanje delovanja sistema in profiliranje poizvedb smo implementirali podporo za protokol OpenTracing. Sistem lahko po potrebi pošlje informacije orodjem, ki podpirajo ta protokol, kot je Zipkin, kar bo omogočilo razumevanje, kako je bila poizvedba izvedena:
Seveda sistem zagotavlja notranje metrike, ki jih lahko zbiramo s pomočjo Prometheusa in vizualiziramo s pomočjo Grafane.
Implementacija
Tarantool Data Grid je mogoče namestiti iz RPM paketov ali arhiva, z orodjem iz dobave ali Ansible, prav tako je podpora za Kubernetes ().
Aplikacija, ki implementira poslovno logiko (konfiguracija, obdelovalniki), se naloži v nameščeni klaster Tarantool Data Grid v obliki arhiva prek uporabniškega vmesnika ali s pomočjo skripta, preko našega API-ja.
Primeri aplikacij
Katere aplikacije je mogoče ustvariti s pomočjo Tarantool Data Grid? V resnici so večina poslovnih nalog na tak ali drugačen način povezane z obdelavo podatkovnih tokov, shranjevanjem in dostopom do njih. Torej, če imate velike podatkovne tokove, ki jih je treba zanesljivo shraniti in do njih dostopati, vam naš izdelek lahko prihrani veliko časa pri razvoju in omogoči osredotočanje na vašo poslovno logiko.
Na primer, želimo zbirati informacije o trgu nepremičnin, da bi imeli na voljo informacije o najbolj donosnih ponudbah. V tem primeru bomo izpostavili naslednje naloge:
- Roboti, ki zbirajo informacije iz odprtih virov — to bodo naši viri podatkov. To nalogo lahko rešite z uporabo že pripravljenih rešitev ali pa napišete kodo v katerem koli jeziku.
- Nato Tarantool Data Grid sprejme in shrani podatke. Če se format podatkov iz različnih virov razlikuje, lahko napišete kodo v jeziku Lua, ki bo izvedla pretvorbo v enotni format. V fazi predobdelave boste prav tako lahko na primer filtrirali ponavljajoče se ponudbe ali dodatno posodobili informacije o agentih, ki delujejo na trgu.
- Imate skalabilno rešenje u klasteru koje možete puniti podacima i vršiti upite. Možete implementirati nove funkcionalnosti, na primer, napisati servis koji će slati upite ka podacima i izdavati najpovoljnije ponude u roku od 24 sata — to zahteva samo nekoliko redova u konfiguracionom fajlu i malo koda u Lua.
Kaj zdaj?
Naš prioritet je poboljšanje udobnosti razvoja uz pomoć . Na primer, to je IDE sa podrškom za profilisanje i debagovanje handlera koji rade u sandboxu.
Takođe, posvećujemo veliku pažnju pitanjima bezbednosti. Trenutno prolazimo kroz sertifikaciju FSTEK-a Rusije kako bismo potvrdili visoki nivo bezbednosti i ispunili zahteve sertifikacije softverskih proizvoda koji se koriste u informacionim sistemima ličnih podataka i državnim informacionim sistemima.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish