

Prihodnost je tu, tehnologije umetne inteligence in strojnega učenja že uspešno uporabljajo vaši najljubši trgovci, transportna podjetja in celo farme, ki gojijo purane.
In če kaj obstaja, potem že obstaja tudi na internetu… odprt projekt! Poglejte, kako Open Data Hub pomaga pri širjenju novih tehnologij in izogibanju težavam pri njihovem uvajanju.
Kljub vsem prednostim umetne inteligence (artificial Intelligence, AI) in strojnega učenja (machine learning, ML) se organizacijam pogosto pojavljajo težave pri širjenju teh tehnologij. Glavne težave so običajno naslednje:
- Izmenjava informacij in sodelovanje – izmenjava informacij brez odvečnih naporov in sodelovanje v načinu hitrih iteracij je praktično nemogoče.
- Dostop do podatkov – za vsako nalogo ga je treba zgraditi znova in ročno, kar vzame veliko časa.
- Dostop na zahtevo – ni možnosti pridobiti dostopa do orodij in platforme za strojno učenje ter tudi do računalniške infrastrukture po potrebi.
- Produkcija – modeli ostanejo v fazi prototipa in niso pripeljani do komercialne uporabe.
- Spremljanje in razlaga rezultatov dela AI – ponovljivost, spremljanje in razlaga rezultatov AI/ML sta otežena.
Če ostanejo te težave nerešene, negativno vplivajo na hitrost, učinkovitost in produktivnost dragocenih strokovnjakov za obdelavo in analizo podatkov. To vodi v njihovo frustracijo, razočaranje nad delom, in na koncu pričakovanja podjetja glede AI/ML gredo v pozabo.
Odgovornost za reševanje teh težav pade na IT-stroke, ki morajo zagotoviti analitikom podatkov – pravilno, nekaj kot oblak. Če podrobneje, potrebna je takšna platforma, ki nudi svobodo izbire in ima enostaven, preprost dostop. Ob tem je hitra, enostavno prilagodljiva, po potrebi razširljiva in odporna na napake. Gradnja takšne platforme na podlagi tehnologij z odprto kodo pomaga, da se izognemo odvisnosti od dobavitelja in ohranimo dolgoročno strateško prednost glede nadzora stroškov.
Pred nekaj leti se je podobno dogajalo pri razvoju aplikacij, kar je pripeljalo do pojave mikroservisov, hibridnih oblakov, IT-avtomatizacije in agilnih procesov. Da bi obvladali vse to, so IT-strokovnjaki začeli uporabljati kontejnerje, Kubernetes in odprte hibridne oblake.
Sedaj se ta izkušnja uporablja za reševanje izzivov umetne inteligence. Zato IT-strokovnjaki razvijajo platforme, ki temeljijo na kontejnerjih, omogočajo ustvarjanje AI/ML storitev v okviru agilnih procesov, pospešujejo inovacije in so zasnovane z mislijo na hibridne oblake.
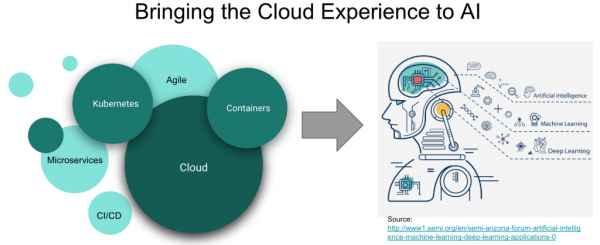
Izgradnjo te platforme bomo začeli z Red Hat OpenShift, našo Kubernetes platformo za kontejnerje v hibridnem oblaku, ki ima hitro rastoči ekosistem programske in strojne opreme ML rešitev (NVIDIA, H2O.ai, Starburst, PerceptiLabs itd.). Nekateri od naših strank Red Hat, kot so BMW Group, ExxonMobil in drugi, so že uvedli kontejnerizirane verige orodij ML in procese DevOps na tej platformi in njenem ekosistemu, da bi svoje ML arhitekture pripeljali v industrijsko obratovanje in pospešili delo analitikov podatkov.
Še en razlog, zakaj smo zagnali projekt Open Data Hub, je, da predstavimo primer arhitekture, ki temelji na več odprtokodnih projektih in pokažemo, kako izvesti celoten življenjski cikel ML rešitve na platformi OpenShift.
Projekt Open Data Hub
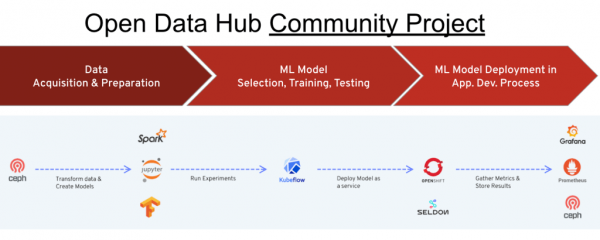
Je odprtokodni projekt, ki se razvija v okviru ustrezne skupnosti razvijalcev in izvaja celoten cikel operacij – od nalaganja in pretvorbe vhodnih podatkov do oblikovanja, usposabljanja in vzdrževanja modela – pri reševanju nalog AI/ML s pomočjo kontejnerjev in Kubernetesa na platformi OpenShift. Ta projekt je mogoče obravnavati kot referenčno realizacijo, primer, kako zgraditi odprto rešitev tipa „AI/ML kot storitev“ na osnovi OpenShift in ustreznih orodij z odprto kodo, kot so Tensorflow, JupyterHub, Spark in drugi. Pomembno je poudariti, da Red Hat ta projekt uporablja za zagotavljanje svojih storitev AI/ML. Poleg tega se OpenShift integrira s ključnimi programsko in strojno opremo ML rešitvami od NVIDIA, Seldon, Starburst in drugih ponudnikov, kar olajša izgradnjo in zagon lastnih sistemov strojnega učenja.
Projekt Open Data Hub je usmerjen k naslednjim kategorijam uporabnikov in scenarijem uporabe:
- Podatkovni analitik, ki potrebuje rešitev za izvajanje ML-projektov, postavljeno v oblaku z funkcijami za samopostrežno uporabo.
- Podatkovni analitik, ki potrebuje največjo izbiro vseh najnovejših orodij in platform AI/ML z odprto kodo.
- Podatkovni analitik, ki potrebuje dostop do virov podatkov pri učenju modelov.
- Podatkovni analitik, ki potrebuje dostop do računalniških virov (CPU, GPU, pomnilnik).
- Podatkovni analitik, ki potrebuje možnost sodelovanja in izmenjave delovnih rezultatov s sodelavci, prejemanja povratnih informacij ter uvajanja izboljšav s hitrimi iteracijami.
- Podatkovni analitik, ki želi sodelovati z razvijalci (in devops ekipami), da bi njeni ML modeli in rezultati dela prišli v produkcijo.
- Inženir podatkov, ki mora podatkovnemu analitiku omogočiti dostop do različnih virov podatkov ob upoštevanju predpisov in varnostnih zahtev.
- Administrator/operater IT-sistemov, ki potrebuje možnost brez težav nadzorovati življenjski cikel (namestitev, konfiguracija, posodobitev) komponent in tehnologij z odprto kodo. Prav tako so potrebna ustrezna orodja za upravljanje in kvotiranje.
Projekt Open Data Hub združuje vrsto orodij z odprto kodo za izvajanje popolnega cikla operacij AI/ML. Kot glavno delovno orodje podatkovnega analitika tukaj uporabljamo Jupyter Notebook. To orodje je danes zelo priljubljeno med strokovnjaki za obdelavo in analizo podatkov, Open Data Hub pa omogoča enostavno ustvarjanje in upravljanje delovnih prostorov Jupyter Notebook z vgrajenim JupyterHub-om. Poleg ustvarjanja in uvoza Jupyter notebookov projekt Open Data Hub vključuje tudi vrsto že pripravljenih notebookov v obliki knjižnice AI Library.
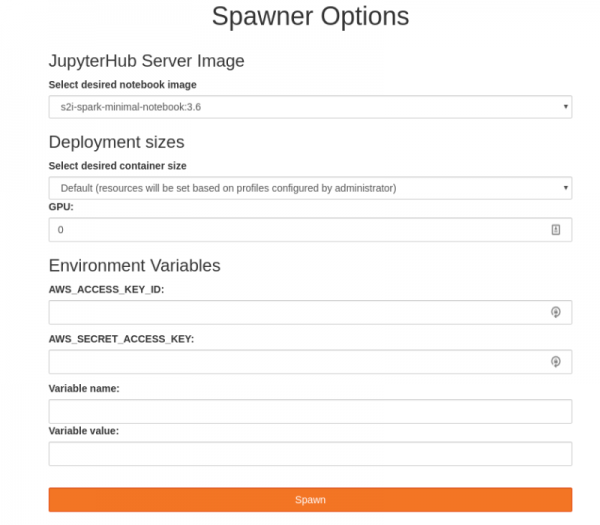
Ta knjižnica predstavlja zbirko odprtokodnih komponent za strojno učenje in rešitev za tipične scenarije, ki poenostavljajo hitro prototipiranje. JupyterHub je integriran z RBAC-modelom dostopa OpenShift, kar omogoča uporabo obstoječih računov OpenShift in implementacijo enotnega prijavnega sistema. Poleg tega JupyterHub ponuja priročen uporabniški vmesnik, imenovan spawner, s katerim lahko uporabnik enostavno prilagodi obseg računalniških virov (procesorska jedra, pomnilnik, GPU) za izbrani Jupyter Notebook.
Ko podatkovni analitik ustvari in nastavi zvezek, vse druge skrbi o njem prevzame načrtovalnik Kubernetes, ki je del OpenShift. Uporabnikom ostane le, da izvajajo svoje eksperimente, shranjujejo in delijo rezultate svoje naloge. Poleg tega lahko napredni uporabniki neposredno dostopajo do CLI-vmesnika OpenShift neposredno iz Jupyter notebookov, da uporabijo Kubernetes-primitiv, kot je Job, ali funkcionalnost OpenShift, kot sta Tekton ali Knative. Lahko pa uporabijo tudi priročen GUI OpenShift, ki se imenuje 'spletna konzola OpenShift'.
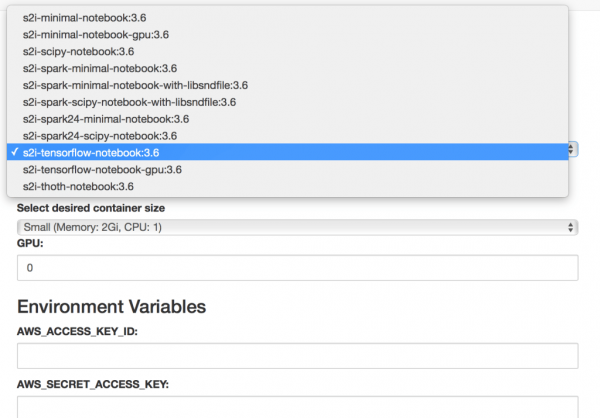
Pri prehodu na naslednji korak Open Data Hub omogoča upravljanje s cevovodi podatkov (data pipelines). To se izvede z uporabo Ceph-objekta, ki je na voljo kot S3-izvedbno objektno skladišče podatkov. Apache Spark omogoča prenos podatkov iz zunanjih virov ali vgrajenega skladišča Ceph S3, poleg tega omogoča tudi predobdelavo podatkov. Apache Kafka nudi razširjeno upravljanje s cevovodi podatkov (kjer je mogoče izvesti večkratno nalaganje, pa tudi operacije preoblikovanja, analize in shranjevanja podatkov).
Torej je podatkovni analitik pridobil dostop do podatkov in zgradil model. Zdaj čuti potrebo, da deli pridobljene rezultate s kolegi ali razvijalci aplikacij, pri tem pa jim želi poskyt model kot storitev. Za to potrebujemo izhodni strežnik, in Open Data Hub ima tak strežnik, ki se imenuje Seldon in omogoča objavo modela v obliki RESTful storitve.
S časom se na serverju Seldon pojavi več takšnih modelov, kar ustvarja potrebo po spremljanju njihove uporabe. Open Data Hub za to ponuja zbirko ustreznih metrik in poročni mehanizem, ki temelji na široko razširenih orodjih za spremljanje z odprto kodo Prometheus in Grafana. Tako dobimo povratne informacije za spremljanje uporabe AI modelov, zlasti v produkcijskem okolju.
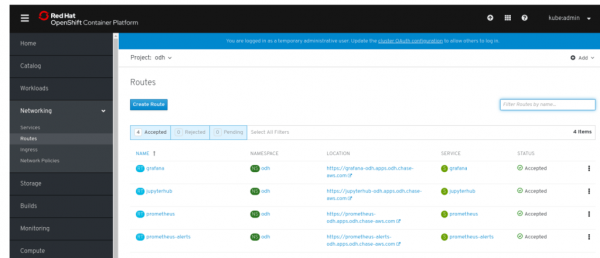
Tako Open Data Hub zagotavlja oblaku podoben pristop skozi celoten cikel operacij AI/ML, od dostopa in priprave podatkov do usposabljanja in industrijske uporabe modelov.
Zberemo vse na kup
Sedaj se postavlja vprašanje, kako vse to organizirati za administratorja OpenShift. Tu pride v igro poseben Kubernetes operator za projekte Open Data Hub.
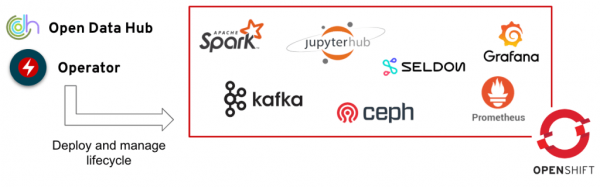
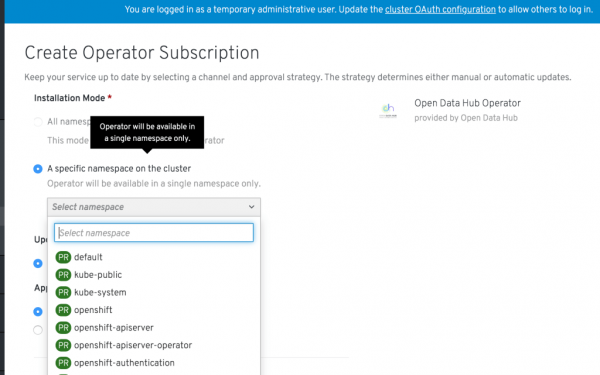
Ta operator upravlja namestitev, konfiguracijo in življenjski cikel projekta Open Data Hub, vključno z uvajanjem prej omenjenih orodij, kot so JupyterHub, Ceph, Spark, Kafka, Seldon, Prometheus in Grafana. Projekt Open Data Hub je mogoče najti v spletni konzoli OpenShift, v razdelku community-operatorji. Tako lahko administrator OpenShift določi, da se ustrezni projekti OpenShift uvrščajo v kategorijo 'projekt Open Data Hub'. To se izvede enkrat. Po tem se analitik podatkov preko spletne konzole OpenShift prijavi v svoj projektni prostor in vidi, da je ustrezen Kubernetes operator za njegove projekte nameščen in dostopen. Nato lahko z enim klikom ustvari primer projekta Open Data Hub in takoj dobi dostop do zgoraj opisanih orodij. Vse to pa je mogoče nastaviti v načinu visoke razpoložljivosti in odpornosti na napake.
Če želite sami preizkusiti projekt Open Data Hub, začnite z . Tehnične podrobnosti arhitekture Open Data Hub lahko najdete , načrti razvoja projekta - . V prihodnosti se načrtuje dodatna integracija s Kubeflow, reševanje nekaterih vprašanj glede regulacije podatkov in varnosti ter organizacija integracije s sistemi, temelječimi na pravilih Drools in Optaplanner. Svoje mnenje lahko izrazite in postanete del projekta na strani .
Povzemimo: resni problemi s skaliranjem ovirajo organizacije, da bi v celoti izkoristile potencial umetne inteligence in strojnega učenja. Red Hat OpenShift se že dolgo in uspešno uporablja za reševanje podobnih težav v programski industriji. Projekt Open Data Hub, izveden v okviru skupnosti odprtokodne razvojne skupine, ponuja referenčno arhitekturo za organizacijo celotnega cikla operacij AI/ML na osnovi hibridnega oblaka OpenShift. Imamo jasen in premišljen načrt razvoja tega projekta in smo resno zavezani k ustvarjanju aktivne in plodne skupnosti za razvoj odprtih rešitev AI na platformi OpenShift.
Izvor: habr.com
