

Pozdrav, Habr! Predstavljam vam prevod članka
.
Ko gre za relacijske baze podatkov, ne morem pobegniti občutku, da nekaj manjka. Uporabljajo se povsod. Obstaja več različnih baz podatkov: od majhnega in uporabnega SQLite do močne Teradata. Vendar pa je le nekaj člankov, ki razlagajo, kako deluje baza podatkov. Lahko sami poiščete z iskalnim nizom "howdoesarelationaldatabasework" ("kako delujejo relacijske baze podatkov"), da vidite, kako malo rezultatov dobite. Poleg tega so ti članki kratki. Če pa iščete najnovejše modne tehnologije (BigData, NoSQL ali JavaScript), boste našli več poglobljenih člankov, ki razlagajo, kako delujejo.
So relacijske baze podatkov preveč stare in preveč dolgočasne, da bi jih lahko razložili izven univerzitetnih tečajev, raziskovalnih del in knjig?
Kot razvijalec sovražim uporabljati stvari, ki jih ne razumem. In če so baze podatkov v uporabi več kot 40 let, mora biti za to razlog. V teh letih sem porabil na stotine ur, da bi resnično razumel te čudne črne škatle, ki jih uporabljam vsak dan. Relacione baze podataka so zelo zanimive, ker so temeljene na uporabnih in večkratno uporabnih konceptih. Če vas zanima razumevanje baz podatkov, a nikoli niste imeli časa ali želje raziskati to široko temo, vam bo ta članek vsekakor všeč.
Čeprav je naslov tega članka jasen, ni namen tega članka, da razume, kako uporabiti bazo podatkov. Zato moraš že znati napisati osnovno poizvedbo za povezovanje in osnovne poizvedbe CRUD; drugače morda ne boste razumeli tega članka. To je edina stvar, ki jo morate vedeti, razložil bom vse ostalo.
Začel bom z nekaterimi osnovami računalništva, kot je časovna kompleksnost algoritmov (BigO). Vem, da nekateri izmed vas sovražijo to koncept, ampak brez njega ne boste mogli razumeti podrobnosti znotraj baze podatkov. Ker je to ogromna tema, se bom osredotočil na tisto, kar smatram za pomembno: kako baza podatkov obdeluje SQL zahteva. Predstavil bom le osnovne koncepte baze podatkov, da boste na koncu članka imeli predstavo o tem, kaj se dogaja pod pokrovom.
Ker ker je to dolga in tehnička članek, ki vključuje številne algoritem in podatkovne strukture, si vzemite čas za njegovo branje. Nekatere koncepte je morda težko razumeti; lahko jih spregledate in še vedno dobite splošno predstavo.
Za tiste bolj seznanjene z zadevo, je ta članek razdeljen na 3 dele:
- Pregled nizkonivojskih in visokonivojskih komponent baze podatkov
- Pregled procesa optimizacije poizvedb
- Pregled upravljanja transakcij in pomnilniškega bazena
Nazaj k osnovam
Pred mnogimi leti (v oddaljeni, oddaljeni galaksiji...) so morali razvijalci natančno vedeti, koliko operacij kodirajo. Poznali so svoje algoritem in strukture podatkov na pamet, ker si niso mogli privoščiti, da bi porabljali CPU in spomin svojih počasnih računalnikov.
V tem delu vas bom spomnil na nekatere od teh konceptov, ker so potrebni za razumevanje baze podatkov. Prav tako bom predstavil koncept indeksa baze podatkov.
O(1) proti O(n2)
Danes mnogi razvijalci ne skrbijo za časovno zahtevnost algoritmov ... in imajo prav!
A ko imate opravka z velikimi količinami podatkov (ne govorim o tisočih) ali če se borite za milisekunde, postane kritično pomembno razumeti ta koncept. In kot razumete, morajo baze podatkov obvladovati oboje! Ne bom vas prisilil, da porabite več časa, kot je potrebno, da ujamete bistvo. To nam bo kasneje pomagalo razumeti koncept optimizacije na osnovi kostn.cost based optimization).
Koncept
Časovna zahtevnost algoritma se uporablja za oceno časa, ki ga bo algoritem potreboval za izvedbo za dano količino podatkov.. Za opis te zahtevnosti se uporabljajo matematične oznake velikih O. Ta notacija se uporablja s funkcijo, ki opisuje, koliko operacij potrebuje algoritem za dano količino vhodnih podatkov.
Na primer, ko rečem "ta algoritem ima zahtevnost O (some_function() )", to pomeni, da za obdelavo določene količine podatkov algoritem potrebuje some_function(a_certain_amount_of_data) operacij.
Ob tem pomembno ni število podatkov**, ampak to, ** kako se povečuje število operacij z naraščanjem količine podatkov. Časovna zahtevnost ne daje natančnega števila operacij, ampak je dober način za oceno časa izvedbe.
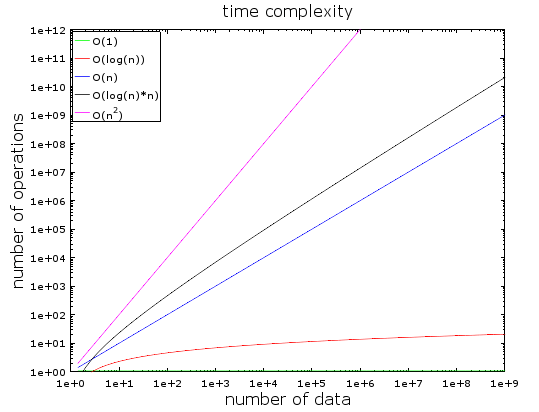
Na tem grafikonu možete videti zavisnost broja operacija od obima ulaznih podataka za različite tipove vremenskih složenosti algoritama. Koristio sam logaritamsku skalu da ih prikažem. Drugim rečima, količina podataka brzo raste od 1 do 1 milijarde. Možemo primetiti da:
- O(1) ili konstantna složenost ostaje konstantna (inače se ne bi zvala konstantna složenost).
- O(dnevnik(n)) ostaje niska čak i sa milijardama podataka.
- Najgora složenost — O(n2), gde broj operacija brzo raste.
- Dve druge složenosti takođe brzo rastu.
Primeri
Pri malom broju podataka razlika između O(1) i O(n2) nije značajna. Na primer, pretpostavimo da imate algoritam koji treba da obradi 2000 elemenata.
- Algoritam O(1) koštaće vas 1 operaciju
- Algoritam O(log(n)) koštaće vas 7 operacija
- Algoritam O(n) koštaće vas 2.000 operacija
- Algoritam O(n * log(n)) koštaće vas 14.000 operacija
- Algoritam O(n2) koštaće vas 4.000.000 operacija
Razlika između O(1) i O(n2) deluje velika (4 miliona operacija) ali ćete izgubiti maksimum 2 ms, samo vreme da trepnete. Uistinu, moderni procesori mogu obraditi . Zato performanse i optimizacija nisu problem u mnogim IT projektima.
Kao što sam već rekao, i dalje je važno poznavati ovu koncepciju kada radite sa ogromnim količinama podataka. Ako ovoga puta algoritam treba da obradi 1.000.000 elemenata (što nije mnogo za bazu podataka):
- Algoritam O(1) koštaće vas 1 operaciju
- Algoritam O(log(n)) koštaće vas 14 operacija
- Algoritam O(n) koštaće vas 1.000.000 operacija
- Algoritam O(n * log(n)) koštaće vas 14.000.000 operacija
- Algoritam O(n2) koštaće vas 1.000.000.000.000 operacija
Nisam završio proračune, ali rekao bih da imate vremena za kafu (čak i dve!). Ako dodate još 0 na obim podataka, imaćete vremena i za dremku.
Idemo dublje
Za informacijo:
- Pretraga u dobroj heš tablici pronalazi element za O(1).
- Pretraga u dobro izbalansiranom drvetu daje rezultat za O(log(n)).
- Pretraga u nizu daje rezultat za O(n).
- Najbolji algoritmi sortiranja imaju složenost O(n * log(n)).
- Loš algoritam sortiranja ima složenost O(n2).
Napomena: u narednim delovima videćemo ove alogritme i strukture podataka.
Obstaja več vrst časovne kompleksnosti algoritma:
- srednji primer
- najboljša možna varianta
- in najslabši scenarij
Časovna kompleksnost je pogosto najslabši scenarij.
Govoril sem samo o časovni kompleksnosti algoritma, vendar se kompleksnost uporablja tudi za:
- porabo pomnilnika z algoritmom
- porabo diskovnega I/O z algoritmom
Seveda so kompleksnosti slabše od n2, na primer:
- n4: to je grozno! Nekateri od omenjenih algoritmov imajo to kompleksnost.
- 3n: to je še slabše! Eden od algoritmov, ki ga bomo videli sredi tega članka, ima to kompleksnost (in se resnično uporablja v mnogih podatkovnih bazah).
- fakulteta n: nikoli ne boste dobili svojih rezultatov niti z majhnim številom podatkov.
- nn: če se srečate s to kompleksnostjo, se morate vprašati, ali je to res vaša stroka …
Opomba: dal sem vam ne pravo definicijo oznake "velik O", ampak samo idejo. To lahko preberete v za pravo (asimptotsko) definicijo.
MergeSort (združevalno sortiranje)
Kaj storite, ko morate razvrstiti zbirko? Kaj? Pokličete funkcijo sort()… Oka, dober odgovor… Ampak za podatkovne baze morate razumeti, kako deluje ta funkcija sort().
Obstaja nekaj dobrih algoritmov za razvrščanje, zato se bom osredotočil na najbolj pomembno: združevalno sortiranje. Morda zdaj ne razumete, zakaj je razvrščanje podatkov koristno, ampak to boste morali razumeti po delu o optimizaciji poizvedb. Poleg tega vam bo razumevanje združevalnega sortiranja pomagalo kasneje razumeti splošno operacijo join v podatkovnih bazah, imenovano merge pridružite se (združevanje s pomočjo združevanja).
Merge (združevanje)
Kot mnogi koristni algoritmi, je združevalno sortiranje zasnovano na triku: združitev dveh urejenih tabel velikosti N / 2 v N-elementno urejeno tabelo stane le N operacij. Ta operacija se imenuje združevanje.
Poglejmo, kaj to pomeni na preprostem primeru:
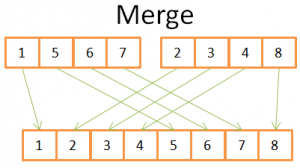
Na tej sliki je prikazano, da za ustvarjanje končne razvrščene tabele iz 8 elementov potrebujete le enkrat iterirati čez 2 4-elementni tabeli. Ker sta obe 4-elementni tabeli že razvrščeni:
- 1) primerjate oba trenutna elementa v obeh tabelah (na začetku trenutni = prvi)
- 2) nato pa vzemite najmanjši, da ga postavite v niz, dolg 8 elementov
- 3) in preidite na naslednji element v nizu, kjer ste vzeli najmanjši element
- in ponavljajte 1,2,3, dokler ne pridete do zadnjega elementa enega od nizov.
- Potem vzamete preostale elemente drugega niza, da jih postavite v niz, dolg 8 elementov.
To deluje, ker sta oba 4-elementna niza sortirana, zato vam ni treba "se vračati" v teh nizih.
Zdaj, ko smo razumeli ta trik, je tukaj moj psevdokod za združevanje:
array mergeSort(array a)
   if(length(a)==1)
      return a[0];
   end if

   //rekurzivni klici
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   array new_left_array := mergeSort(left_array);
   array new_right_array := mergeSort(right_array);

   //združevanje dveh majhnih urejenih nizov v enega velikega
   array result := merge(new_left_array,new_right_array);
   return result;
Sortiranje s prepletanjem razdeli nalogo na manjše naloge in nato najde rezultate manjših nalog, da pridobi rezultat izvirne naloge (opomba: ta vrsta algoritmov se imenuje delitev in oblast). Če ne razumete tega algoritma, ne skrbite; tudi jaz ga nisem razumel prvič, ko sem ga videl. Če vam lahko pomaga, ta algoritem vidim kot dvofazni algoritem:
- Faza delitve, kjer se niz deli na manjše nize
- Faza razvrščanja, kjer se majhni nizi združijo (z uporabo združevanja), da oblikujejo večji niz.
Faza delitve
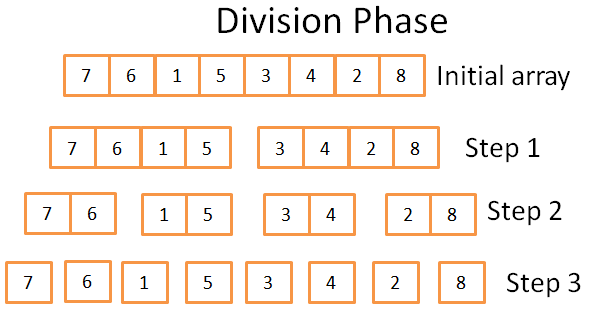
V fazi delitve se niz deli na enotne nize v 3 korakih. Formalno število korakov je log(N) (ker je N=8, log(N) = 3).
Od kod to vem?
Sem genij! Na kratko — matematika. Ideja je, da vsak korak deli velikost izvirnega niza na 2. Število korakov je število krat, ki jih lahko izvirni niz delite na dva. To je natančna definicija logaritma (osnova 2).
Faza razvrščanja
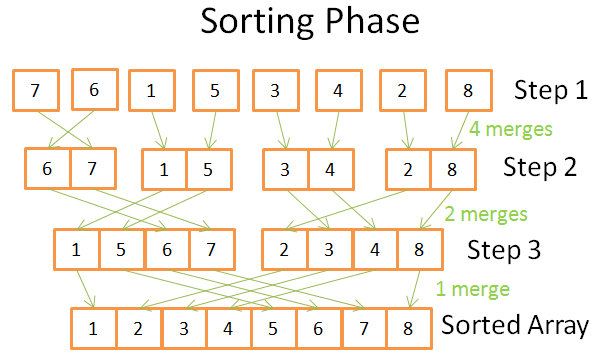
V fazi razvrščanja začnete z enotnimi (enoelementnimi) nizi. V vsakem koraku uporabite več operacij združevanja, skupni strošek pa znaša N = 8 operacij:
- V prvem koraku imate 4 združitve, ki stanejo 2 operaciji vsaka
- V drugem koraku imate 2 združitvi, ki stanejo 4 operacije vsaka
- V tretjem koraku imate 1 združitev, ki stane 8 operacij
Ker obstaja log (N) korakov, skupni strošek N * log(N) operacij.
Prednosti združevanja
Zakaj je ta algoritem tako močan?
Zato što:
- Lahko ga spremenite, da zmanjšate obseg pomnilnika, tako da ne ustvarjate novih tabel, ampak neposredno spremenite vhodno tabelo.
Opomba: ta vrsta algoritmov se imenuje (sortiranje brez dodatnega pomnilnika).
- Lahko ga spremenite za hkratno uporabo diskovnega prostora in majhne količine pomnilnika brez znatnih stroškov za diskovni vhod/izhod. Ideja je, da se v pomnilnik naložijo samo tisti deli, ki se obdelujejo v tistem trenutku. To je pomembno, ko morate razvrstiti tabelo velikosti več gigabajtov le s pomnilniškim rezervoarjem velikosti 100 megabajtov.
Opomba: ta vrsta algoritmov se imenuje .
- Lahko ga spremenite, da se izvaja na več procesih / niti / strežnikih.
Na primer, razporejeno združevanje je ena od ključnih komponent (kar je struktura v velikih podatkih).
- Ta algoritem lahko spremeni svinec v zlato (res!).
Ta algoritem sortiranja se uporablja v večini (če ne v vseh) podatkovnih bazah, vendar ni edini. Če želite izvedeti več, lahko preberete to , ki razpravlja o prednostih in slabostih skupnih algoritmov sortiranja v podatkovnih bazah.
Tabelarni, Drevesni in Hesh-tabela
Zdaj, ko razumemo idejo časovne kompleksnosti in sortiranja, vam moram povedati o treh strukturah podatkov. To je pomembno, ker so osnova sodobnih podatkovnih baz. Prav tako bom predstavil koncept indeksa baze podatkov.
Matrika
Dvodimenzionalna tabela je najpreprostejša struktura podatkov. Tabelo lahko obravnavamo kot tabelo. Na primer:
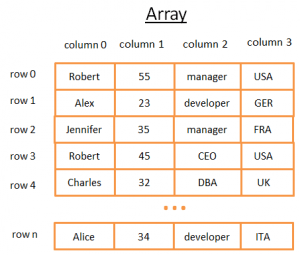
Ta 2-dimenzionalna tabela predstavlja tabelo z vrsticami in stolpci:
- Vsaka vrstica predstavlja entiteto
- Stolpci shranjujejo lastnosti, ki opisujejo entiteto.
- Vsak stolpec shranjuje podatke določene vrste (integer, string, datum …).
Tako je priročno shranjevati in vizualizirati podatke, vendar pa, ko morate najti določeno vrednost, to ni primerno.
Na primer, če želite najti vse moške, ki delajo v Združenem kraljestvu, boste morali pregledati vsako vrstico, da ugotovite, ali ta vrstica pripada Združenemu kraljestvu. To vas bo stalo N operacij, gde N — število vrstic, kar ni slabo, vendar bi lahko bil hitrejši način? Zdaj je čas, da se spoznamo z drevesi.
Opomba: večina sodobnih baz podatkov ponuja razširjene tabele za učinkovito shranjevanje tabel: heap-organizedtables in index-organizedtables. A to ne rešuje problema hitrega iskanja določenih pogojev v skupini stolpcev.
Drevo in indeks baze podatkov
Dvojno drevo iskanja je dvojno drevo s posebnim lastnostjo, ključ v vsakem vozlišču mora biti:
- večji od vseh ključev, shranjenih v levem poddrevesu
- manjši od vseh ključev, shranjenih v desnem poddrevesu
Poglejmo, kaj to vizualno pomeni
Idea
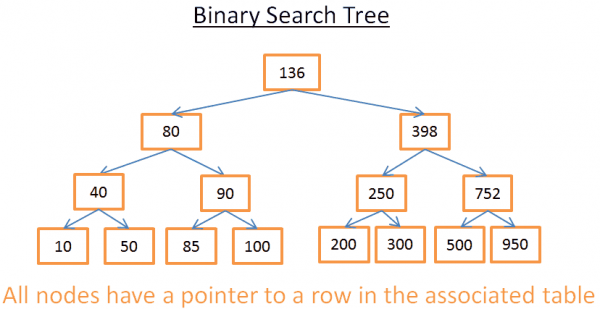
To drevo ima N = 15 elementov. Recimo, da iščem 208:
- Začnem pri korenu, katerega ključ je 136. Ker je 136<208, pogledam v desno poddrevo vozlišča 136.
- 398>208, zato pogledam v levo poddrevo vozlišča 398
- 250>208, zato pogledam v levo poddrevo vozlišča 250
- 200<208, zato pogledam v desno poddrevo vozlišča 200. A 200 nima desnega poddrevesa, vrednost ne obstaja (saj če bi obstajala, bi bila v desnem poddrevesu 200).
Zdaj recimo, da iščem 40
- Začnem pri korenu, katerega ključ je 136. Ker je 136 > 40, pogledam v levo poddrevo vozlišča 136.
- 80 > 40, zato pogledam v levo poddrevo vozlišča 80
- 40= 40, vozlišče obstaja. Izvlečem identifikator vrstice znotraj vozlišča (to na risbi ni prikazano) in pogledam v tabeli za določen identifikator vrstice.
- Poznavanje identifikatorja vrstice mi omogoča, da ugotovim, kje so podatki v tabeli, in jih zato lahko takoj pridobim.
Na koncu bosta oba iskanja stala toliko, kot je nivojev v drevesu. Če natančno preberete del o združevanju, bi morali videti, da je tu log (N) nivojev. Torej, strošek iskanja je log(N), ni slabo!
Vrnimo se k našemu problemu
To je sicer zelo abstraktno, zato se vrnimo k našemu problemu. Namesto preprostega cela števila si predstavljajte niz, ki predstavlja državo nekoga v prejšnji tabeli. Predpostavimo, da imate drevo, ki vsebuje polje "country" (stolpec 3) tabele:
- Če želite vedeti, kdo dela v Združenem kraljestvu,
- poglejte drevo, da pridobite vozlišče, ki predstavlja Združeno kraljestvo.
- znotraj "UKnode" boste našli lokacijo zapisov delavcev v Združenem kraljestvu.
Ta iskanje bo stalo log(N) operacij namesto N operacij, če boste neposredno uporabljali tabelo. To, kar ste pravkar predstavili, je bilo indeks baze podatkov.
Lahko zgradite indeksno drevo za katero koli skupino polj (niz, število, 2 niza, število in niz, datum …), dokler imate funkcijo za primerjavo ključev (tj. skupina polj), da lahko določite vrstni red med ključi (kar velja za vse osnovne tipe v bazi podatkov).
B+TreeIndex
Čeprav to drevo dobro deluje za pridobitev določenih vrednosti, obstaja VEČJA težava, ko potrebujete pridobitev več elementov med dvema vrednostma. To bo stalo O(N), ker se boste morali pogledati vsak vozlišče v drevesu in preveriti, ali je med tema dvema vrednostma (na primer pri urejanju drevesa). Poleg tega ta operacija ni prijazna do diskovnega vnosa-izpada, saj boste morali prebrati celotno drevo. Moramo najti način, kako učinkovito izvesti gledanje po obsegu. Za rešitev tega problema sodobne baze podatkov uporabljajo modificirano različico prejšnjega drevesa, imenovano B+Tree. V B+Tree drevesu:
- samo najnižje vozli (listi) shranjujejo informacije (lokacije vrstic v povezani tabeli)
- ostala vozlišča so tukaj za usmerjanje do pravega vozlišča med iskanjem.
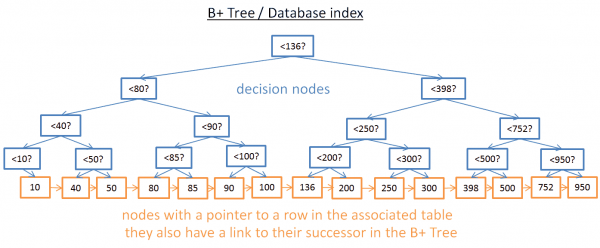
Kot lahko vidite, je tukaj več vozlišč (dvakrat). Dejansko imate dodatna vozlišča, 'odločitvena vozlišča', ki vam pomagajo najti pravo vozlišče (ki shrani lokacijo vrstic v povezani tabeli). Ampak zapletenost iskanja je še vedno O(log(N)) (obstaja samo še ena raven). Velika razlika je v tem, da vozlišča na spodnji ravni so povezana s svojimi nasledniki.
S tem B+Tree, če iščete vrednosti od 40 do 100:
- Samo morali bi poiskati 40 (ali najbližjo vrednost po 40, če 40 ne obstaja), kot ste to počeli s prejšnjim drevesom.
- Nato zberite naslednike 40, uporabite neposredne povezave do naslednikov, dokler ne dosežete 100.
Recimo, da ste našli M naslednikov, in drevo ima N vozlišč. Iskanje določenega vozlišča stane log(N), podobno kot prejšnje drevo. Ampak, ko dobite to vozlišče, boste pridobili M naslednikov v M operacijah s povezavami do njihovih naslednikov. To iskanje stane samo M+log(N) operacij v primerjavi z N operacijami prejšnjega drevesa. Poleg tega vam ni treba brati celotnega drevesa (samo M + log (N) vozlišč), kar pomeni manjšo porabo diskovnega prostora. Če je M majhno (na primer 200 vrstic) in N veliko (1.000.000 vrstic), bo to velika razlika.
Toda tukaj se pojavljajo novi problemi (spet!). Če v bazo podatkov dodate ali izbrišete vrstico (in torej v povezani indeks B+Tree):
- morate ohranjati red med vozlišči znotraj drevesa B+Tree, drugače ne boste mogli najti vozlišč znotraj nesortiranega drevesa.
- morate ohraniti minimalno možno število ravni v B+Tree, sicer bo časovna kompleksnost v O(log(N)) postala O(N).
Drugimi besedami, B+Tree mora biti samosortirano in uravnoteženo. Na srečo je to mogoče s pametnimi operacijami brisanja in vnašanja. Ampak to stane kar drago: vstavljanje in brisanje v drevesu B+ stane O(log(N)). Zaradi tega je nekateri med vami slišali, da uporaba prevelikega števila indeksov ni najboljša ideja. Resnično, upočasnite hitro vstavljanje / posodabljanje / brisanje vrstic v tabeli, saj mora baza podatkov posodobiti indekse tabele s drago operacijo O(log(N)) za vsak indeks. Poleg tega dodajanje indeksov pomeni večje obremenitve za upravljalnika transakcij (o čemer bo govora na koncu članka).
Za več podrobnosti si lahko ogledate članek na Wikipediji o . Če želite primer implementacije B+Tree v bazi podatkov, si oglejte in od vodilnega razvijalca MySQL. Obe se osredotočata na to, kako InnoDB (MySQL motor) obravnava indekse.
Opomba: bralec mi je rekel, da naj bi bilo zaradi nizko nivojskih optimizacij drevo B+ popolnoma uravnoteženo.
Hashtable (Hash tabela)
Naša zadnja pomembna struktura podatkov je hash tabela. To je zelo koristno, kadar želite hitro iskati vrednosti. Poleg tega bo razumevanje hash tabele pomagalo kasneje razumeti splošno operacijo združevanja z bazo podatkov, imenovano hash join ( hash join). Ta podatkovna struktura se tudi uporablja v bazi podatkov za shranjevanje nekaterih notranjih zadev (na primer, tabela zaklepanja ili buffer pool, videli bomo obe ti koncepti kasneje).
Hashtabela je struktura podataka koja brzo pronalazi element po njegovom ključnoj vrednosti. Za izgradnju hashtabele morate definisati:
- ključ za vaše elemente
- hash funkciju za ključeve. Izračunati hash-ovi ključeva daju lokaciju elemenata (koji se nazivaju segmentima ).
- funkciju za poređenje ključeva.Kada pronađete pravi segment, morate pronaći element koji tražite unutar segmenta koristeći ovo poređenje.
Jednostavan primer
Uzmimo jedan ilustrativan primer:
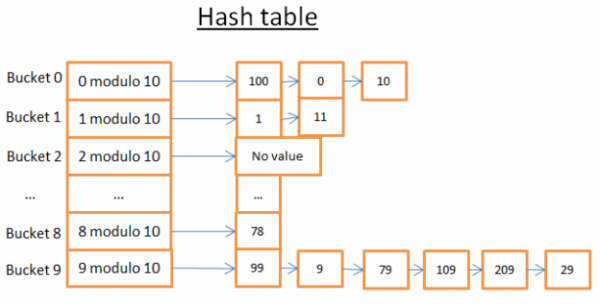
Ova hashtabela ima 10 segmenata. Pošto sam lenj, prikazao sam samo 5 segmenata, ali znam da ste pametni, pa ću vam dopustiti da zamislite ostalih 5 sami. Koristio sam hash funkciju prema modulu 10 ključa. Drugim rečima, zadržavam samo poslednju cifru ključa elementa kako bih pronašao njegov segment:
- ako je poslednja cifra jednaka 0, element ide u segment 0,
- ako je poslednja cifra jednaka 1, element ide u segment 1,
- ako je poslednja cifra jednaka 2, element ide u područje 2,
- …
Funkcija poređenja koju sam koristio jednostavno je jednakost između dva cela broja.
Recimo da želite dobiti element 78:
- Hashtabela izračunava hash kod za 78, koji je 8.
- Hashtabela gleda u segment 8, a prvi element koji nađe je 78.
- Vraća vam element 78.
- Pretraga je koštala samo 2 operacije (jedna za izračunavanje vrednosti hash funkcije, a druga za traženje elementa unutar segmenta).
Sada, recimo da želite dobiti element 59:
- Hashtabela izračunava hash kod za 59, koji je 9.
- Hashtabela traži u segmentu 9, prvi pronađeni element je 99. Pošto 99!=59, element 99 nije pravi element.
- Koristeći ovu istu logiku, uzima se drugi element (9), treći (79), …, poslednji (29).
- Element nije pronađen.
- Pretraga je kostala 7 operacija..
Dobra hash funkcija
Kao što vidite, u zavisnosti od vrednosti koju tražite, trošak nije isti!
Ako sada promenim hash funkciju po modulu 1 000 000 od ključa (tj. uzimajući poslednjih 6 cifara), druga pretraga će koštati samo 1 operaciju, pošto u segmentu 000059 nema elemenata. Pravi izazov je pronaći dobru hash funkciju koja će stvoriti segmente sa vrlo malim brojem elemenata..
V mojem primeru je enostavno najti dobro hesh-funkcijo. A to je preprost primer; težje je najti dobro hesh-funkcijo, ko je ključ:
- niz (na primer - priimek)
- 2 niza (na primer - priimek in ime)
- 2 niza in datum (na primer - priimek, ime in datum rojstva)
- …
S dobro hesh-funkcijo iskanje v hesh-tabeli poteka v O(1).
Matrika vs. hesh-tabela
Zakaj ne uporabiti matrike?
Hmmm, dobro vprašanje.
- Hesh-tabela je lahko delno naložena v pomnilnik, preostali segmenti pa lahko ostanejo na disku.
- Z matriko morate uporabiti neprekinjen prostor v pomnilniku. Če nalagate veliko tabelo, je zelo težko najti dovolj neprekinjenega prostora..
- Za hesh-tabelo lahko izberete ustrezen ključ (na primer, državo in priimek osebe).
Za dodatne informacije si lahko preberete članek o , ki je učinkovita izvedba hesh-tabele; razumeti morate, da Java ni potrebna za razumevanje konceptov, predstavljenih v tem članku.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish