

Tako, vi zbirate metrike. Tako kao i mi. I mi takođe prikupljamo metrike. Naravno, potrebne za biznis. Danas ćemo govoriti o prvom linku u sistemu našeg nadzora — serveru za agregaciju koji je kompatibilan sa statsd. , zašto smo ga napisali i zašto smo odustali od brubeck-a.
Iz naših prethodnih članaka (, ) može se saznati da smo do određenog trenutka označili metrike koristeći . Napisan je u C-u. Sa tačke gledišta koda — jednostavan poput čepa (što je važno kada želite da doprinosite) i, najvažnije, bez posebnih problema nosi se sa našim obimima od 2 miliona metrika u sekundi (MPS) na vrhuncu. Dokumentacija tvrdi da podržava 4 miliona MPS sa zvezdicom. To znači da ćete dobiti navedeni broj ako pravilno konfigurišete mrežu na Linux-u. (Koliko MPS se može dobiti ako ostavite mrežu kakva jeste, ne znamo). I pored tih prednosti, imali smo nekoliko ozbiljnih pritužbi na brubeck.
Pritužba 1. Github — developer projekta — prestao je da ga podržava: objavljivati zakrpe i ispravke, prihvatati naše (i ne samo naše) PR. U poslednjih nekoliko meseci (negde od februara-marta 2018) aktivnost je obnovljena, ali pre toga je bilo skoro 2 godine potpunog zatišja. Osim toga, projekat se razvija , što može predstavljati ozbiljnu prepreku za implementaciju novih funkcionalnosti.
Pritužba 2. Tačnost proračuna. Brubeck prikuplja samo 65536 vrednosti za agregaciju. U našem slučaju, za neke metrike tokom perioda agregacije (30 sekundi) može stizati mnogo više vrednosti (1 527 392 na vrhuncu). Kao rezultat takvog uzorkovanja, vrednosti maksimuma i minimuma izgledaju beskorisno. Na primer, ovako:
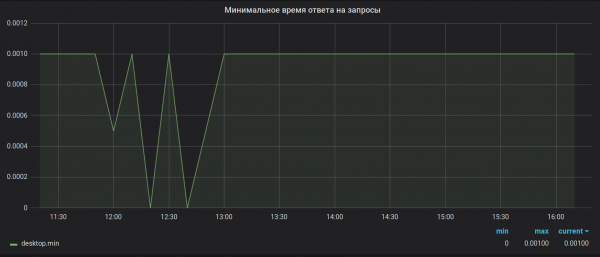
Kot je bilo
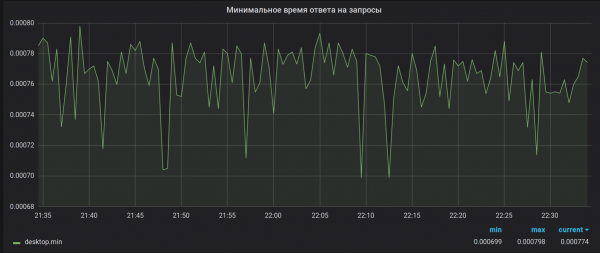
Kako je to trebalo da izgleda
Iz istog razloga, zbirove se uopšte smatraju netačnim. Dodajte ovome bug sa prelivanjem 32-bitnog float-a, koji uopšte šalje server u segfault prilikom primanja naizgled bezazlene metrike, i postaje zaista odlično. Bug, inače, nikada nije ispravljen.
In, končno, Pritužba X. Ob trenutku pisanja članka smo pripravljeni predstaviti vsem 14 bolj ali manj delujočim različicam statsd, ki smo jih uspeli najti. Predstavljajmo si, da je neka infrastruktura zrasla toliko, da sprejemanje 4 milijone MPS ni več dovolj. Ali pa naj ne bi bila še zrasla, vendar so metrike za vas že toliko pomembne, da tudi kratki, 2-3 minutni popadi na grafikonih lahko postanejo kritični in povzročijo neustavljive napade depresije pri menedžerjih. Ker je zdravljenje depresije hvaležno delo, so potrebne tehnične rešitve.
Prvič, odpornost na napake, da nenadna težava na strežniku ne povzroči psihiatričnega zombija apokalipse v pisarni. Drugič, skalabilnost, da lahko sprejmete več kot 4 milijone MPS, ne da bi kopali globoko v omrežni kup Linux in mirno rasli 'v širino' do potrebnih dimenzij.
Ker smo imeli rezerve pri skalabilnosti, smo se odločili, da začnemo z odpornostjo na napake. 'O! Odpornost na napake! To je preprosto, to znamo,' smo pomislili in zagnali 2 strežnika, na vsakem smo postavili kopijo brubeck. Za to smo morali podvojiti promet z metriko na oba strežnika in celo napisati za to . Ta problem odpornosti na napake smo rešili, ampak… ne ravno dobro. Sprva je vse izgledalo dobro: vsak brubeck zbira svojo različico agregacije, piše podatke v Graphite vsakih 30 sekund, prepisuje prejšnji interval (to se dogaja na strani Graphite). Če en strežnik nenadoma odpove, imamo vedno drugega z lastno kopijo agregiranih podatkov. Ampak tukaj je težava: če strežnik odpove, se na grafikonih pojavi 'žaga'. To je povezano s tem, da 30-sekundni intervali na brubecku niso sinhronizirani, in v trenutku, ko eden od njih pade, se ne prepisuje. Pri zagonu drugega strežnika se zgodi enako. Čisto sprejemljivo, vendar bi želeli bolje! Tudi problem skalabilnosti ni nikamor izginil. Vse metrike še vedno 'letijo' na en sam strežnik, zato smo omejeni s temi istimi 2-4 milijoni MPS, odvisno od moči mreže.
Če malo razmislimo o problemu in hkrati kopljemo sneg, nam lahko v misli pride ena očitna ideja: potrebujemo statsd, ki deluje v razdeljenem načinu. To pomeni, da mora biti implementirana sinhronizacija med vozlišči glede na čas in metrike. 'Seveda, to rešitev zagotovo že imajo,' smo rekli in šli iskati … in nismo našli ničesar. Ko smo preleteli dokumentacijo o različnih statsd ( na dan 11.12.2017), nismo našli prav nič. Očitno niti razvijalci niti uporabniki teh rešitev se do sedaj niso srečali s TAKŠNIM številom metrik, drugače bi zagotovo že nekaj izumili.
In tukaj smo se spomnili na 'igračarski' statsd - bioyino, ki smo ga pisali na hackatonu kar za zabavo (ime projekta je skrilpt pred začetkom hackatona) in spoznali, da nujno potrebujemo svoj lastni statsd. Zakaj?
- ker je na svetu premalo klonov statsd,
- ker lahko zagotovimo želeno ali skoraj željeno odpornost in razširljivost (vključno s sinhronizacijo agregiranih metrik med strežniki in rešitvijo problemov s konflikti pri pošiljanju),
- ker lahko merimo metrike natančneje, kot to počne brubeck,
- ker lahko sami zbiramo bolj podrobne statistike, ki nam jih brubeck praktično ni ponujal,
- ker se nam je ponudila priložnost, da programiramo svojo lastno visokozmogljivo distribuirano aplikacijo, ki ne bo popolnoma ponavljala arhitekture druge takšne visokozmogljive … nuvyponele.
Na čem pisati? Seveda na Rustu. Zakaj?
- ker je že obstajal prototip rešitve,
- ker je avtor članka v tistem času že poznal Rust in si je želel napisati nekaj za produkcijo z možnostjo objave v open-source,
- ker nam jeziki z GC ne ustrezajo glede na naravo prejetega prometa (praktično v realnem času) in so premori GC praktično nesprejemljivi,
- ker potrebujemo maksimalno zmogljivost, primerljivo s C-jem
- ker nam Rust omogoča brezskrbno sočasnost, a če bi začeli pisati to v C/C++, bi naleteli na še več ranljivosti, prelivanja pomnilnika, race conditions in drugih strašnih besed.
Obstaja tudi argument proti Rustu. Podjetje ni imelo izkušenj z razvojem projektov v Rustu, in tudi sedaj ne načrtujemo, da bi ga uporabili v glavnem projektu. Zato smo imeli resne pomisleke, da nam ne bo uspelo, a smo se odločili tvegati in poskusiti.
Čas je mineval…
Nazadnje, po več neuspešnih poskusih, je bila prva delujoča različica pripravljena. Kaj smo dosegli? Dosegli smo tole.
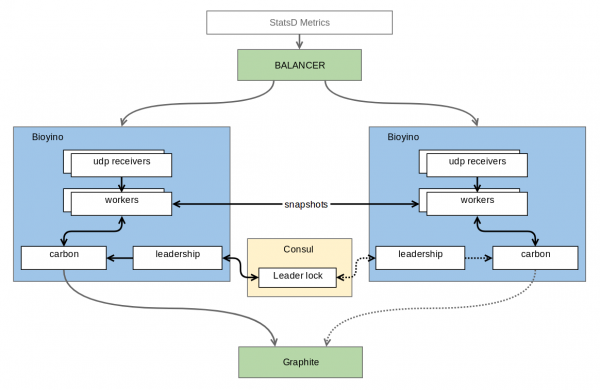
Vsaka vozlišča prejme svoj lasten nabor metrik in jih kopiči pri sebi, pri čemer ne agregira metrik za tiste tipe, kjer bo za končno agregacijo potreben njihov celoten nabor. Vozlišča so povezana med seboj preko nekega protokola razdeljene blokade (distributed lock), ki omogoča, da izberejo tisto edino (tukaj smo jokali), ki je vredna pošiljanja metrik Velikemu. Ta problem se trenutno rešuje s sredstvi , a v prihodnosti avtorjeve ambicije segajo do Rafta, kjer bo seveda tista vredna vozlišča vodilno vozlišče konsenza. Poleg konsenza, vozlišča pogosto (privzeto enkrat na sekundo) pošiljajo svojim sosedom tiste dele predagregiranih metrik, ki so jih uspeli zbrati v tej sekundi. Tako ostaja skalabilnost in odpornost na napake ohranjena — vsako vozlišče še vedno hrani celoten nabor metrik, a se metrike pošiljajo že agregirane, preko TCP in z zapisovanjem v binarni protokol, kar znatno znižuje stroške podvajanja v primerjavi z UDP. Kljub precejšnjemu številu prihajajočih metrik, zbiranje zahteva zelo malo pomnilnika in še manj CPU. Za naše dobro stisnjene metrike je to le nekaj deset megabajtov podatkov. Dodatna prednost je odsotnost odvečnih prepisov podatkov v Graphite, kot je to bilo v primeru z burbeck.
UDP paketi z metrikami so porazdeljeni med vozli na omrežni opremi prek preprostega Round Robin. Samo po sebi, omrežna oprema ne analizira vsebine paketov, zato lahko obdeluje veliko več kot 4M paketov na sekundo, še posebej v zvezi z metriko, o kateri sploh nič ne ve. Če upoštevamo, da metriki ne prihajajo posamezno v vsakem paketu, ne predvidevamo težav s učinkovitostjo na tem mestu. V primeru izpada strežnika omrežna naprava hitro (v 1–2 sekundah) odkrije to dejstvo in iz rotacije odstrani pokvarjeni strežnik. Kot rezultat se pasivna (tj. ne vodilna) vozlišča lahko vklapljajo in izklapljajo praktično neopaženo na grafih. Največ, kar izgubimo, je del metrike, ki je prišla v zadnji sekundi. Nenadna izguba/izklop/preklop vodilnega še vedno prikaže manjšo anomaliijo (30-sekundni interval je še vedno nesimetričen), vendar lahko ob prisotnosti povezave med vozlišči te težave zmanjšamo na minimum, na primer z razpošiljanjem sinhronizacijskih paketov.
Nekaj o notranji strukturi. Aplikacija je seveda večnitna, vendar se architektura niti razlikuje od tiste, ki se uporablja v brubeck. Niti v brubeck so enake – vsaka odgovarja tako za zbiranje informacij kot tudi za agregacijo. V bioyino so delovni nizi (workers) razdeljeni v dve skupini: odgovorni za omrežje in odgovorni za agregacijo. To ločevanje omogoča bolj fleksibilno upravljanje aplikacije glede na vrsto metrike: tam, kjer je potrebna intenzivna agregacija, lahko dodamo agregatorje, tam, kjer je veliko omrežnega prometa – povečamo število omrežnih niti. Trenutno na naših strežnikih delujemo z 8 omrežnimi in 4 agregacijskimi nitmi.
Del odgovoren za agregacijo je dovolj dolgočasen. Polnjeni omrežni bufri se porazdelijo med izračunane niti, kjer se nato razčlenijo in agregirajo. Na zahtevo se metriki oddajo za pošiljanje drugim vozliščem. Vse to, vključujoč prenos podatkov med vozlišči in delo s Consulom, se izvaja asinkrono, izvaja se na ogrodju .
Različni problemi pri razvoju nastali su zbog mrežnog dela zaduženog za primanje metrika. Glavni cilj izdvajanja mrežnih tokova u zasebne entitete bio je smanjenje vremena potrebnog za ne čitanje podataka iz soketa. Opcije korišćenja asinhronog UDP-a i običnog recvmsg brzo su odbačene: prvi troši previše CPU-ja na korisničkom nivou za obradu događaja, drugi — previše prebacivanja konteksta. Stoga se trenutno koristi sa velikim baferima (jer, gospodine oficiri, baferi nisu za potcenjivanje!). Podrška za običan UDP zadržana je za neopterećene slučajeve kada recvmmsg nije neophodan. U režimu multimessage uspeva se postići glavno: velika većina vremena mrežni tok razbistrava red OS-a — čita podatke iz soketa i prebacuje ih u bafer korisničkog prostora, samo povremeno se prebacujući da preda popunjeni bafer agregatorima. Red u soketu praktično se ne akumulira, a broj odbacenih paketa gotovo da ne raste.
Napomena
U podrazumevanju, veličina bafera postavljena je dovoljno velika. Ako odlučite da isprobate server samostalno, mogli biste se suočiti sa situacijom da, nakon slanja malog broja metrika, one ne stignu u Graphite, ostajući u baferu mrežnog toka. Za rad sa malim brojem metrika potrebno je u konfiguraciji postaviti manje vrednosti za bufsize i task-queue-size.
Na kraju — malo grafova za ljubitelje grafova.
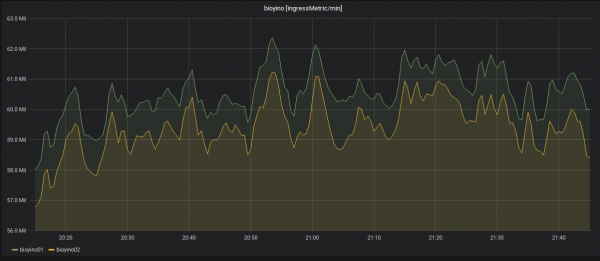
Statistika broja ulaznih metrika po svakom serveru: više od 2 miliona MPS-a.
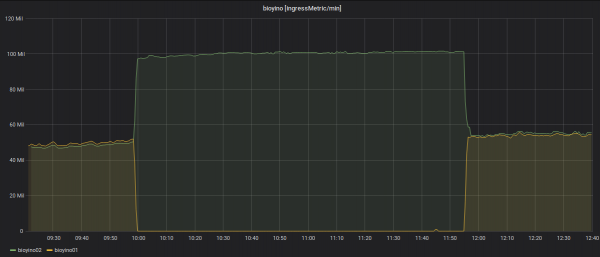
Isključenje jedne od nodova i preraspodela ulaznih metrika.
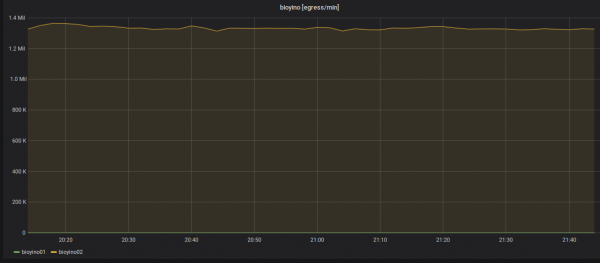
Statistika o izlaznim metrikama: samo jedna nod uvek šalje — rajboss.
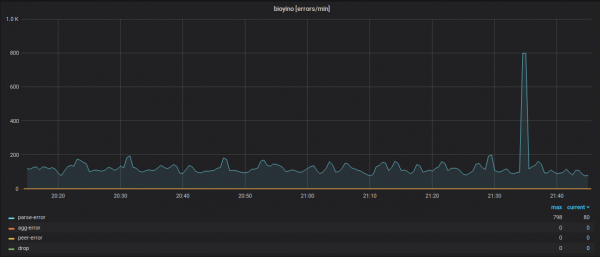
Statistika rada svake nod-e uzimajući u obzir greške u raznim modulima sistema.
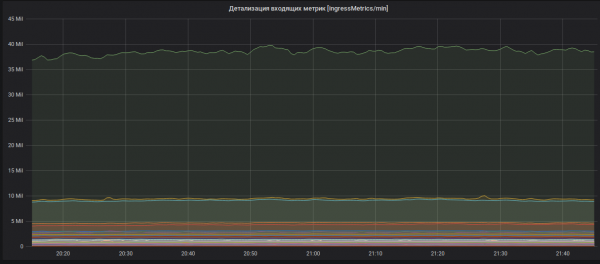
Detaljizacija ulaznih metrika (imena metrika su skrivena).
Šta planiramo dalje s ovim svim? Naravno, pisanje koda, bl...! Projekat je prvobitno planiran kao open-source i biće takav tokom celog svog života. U bližim planovima — prelazak na sopstvenu verziju Rafta, menjanje peer-protokola na prenosiviji, dodavanje dodatne interne statistike, novih tipova metrika, otklanjanje grešaka i druga unapređenja.
Seveda, vsi, ki želijo pomagati pri razvoju projekta, so dobrodošli: ustvarite PR, težave, po možnosti bomo odgovarjali, dopolnjevali itd.
Na tem, kot se reče, to je to, kupite naše slone!
Izvor: habr.com
