

Želim deliti s vami svojo prvo uspešno izkušnjo obnavljanja popolne funkcionalnosti baze podatkov Postgres. S sistemom za upravljanje baz podatkov Postgres sem se srečal pred pol leta, pred tem pa nisem imel nobenih izkušenj z upravljanjem baz podatkov.
Delam kot polovični DevOps inženir v veliki IT-podjetju. Naša družba se ukvarja z razvojem programske opreme za visoko obremenjene storitve, jaz pa skrbi za delovanje, vzdrževanje in namestitev. Pred mano je bila postavljena standardna naloga: posodobiti aplikacijo na enem strežniku. Aplikacija je napisana v Django, med posodobitvijo se izvajajo migracije (spremembe strukture baze podatkov), pred tem postopkom pa naredimo popoln izvoz baze podatkov preko standardnega programa pg_dump za vsak slučaj.
Med izvozom je prišlo do nepredvidene napake (verzija Postgres – 9.5):
pg_dump: Oumpanje vsebine tabele "ws_log_smevlog" je spodletelo: PQgetResult() je spodletelo.
pg_dump: Sporočilo o napaki iz strežnika: ERROR: neveljna stran v bloku 4123007 relacije base/16490/21396989
pg_dump: Ukaz je bil: COPY public.ws_log_smevlog [...]
pg_dunp: [paralelno arhiviranje] proces delavca je nepričakovano umrl
Napaka «neveljna stran v bloku» pove o težavah na ravni datotečnega sistema, kar je zelo slabo. Na različnih forumih so predlagali, da se izvede FULL VACUUM z možnostjo zero_damaged_pages za rešitev te težave. No, poskusimo…
Priprava za obnovitev
POZOR! Obvezno naredite varnostno kopijo Postgres pred kakršnim koli poskusom obnove baze podatkov. Če imate virtualni stroj, ustavite bazo podatkov in naredite posnetek. Če ni možnosti za narediti posnetek, ustavite bazo in kopirajte vsebino mape Postgres (vključno z wal-datotekami) na varno mesto. Najpomembneje pri našem delu je, da ne pokvarimo še bolj. Preberite .
Ker je v splošnem baza normalno delovala, sem se omejil na običajen izvoz baze podatkov, vendar sem izključil tabelo s poškodovanimi podatki (možnost -T, —exclude-table=TABLE v pg_dump).
Strežnik je bil fizičen, narediti posnetek ni bilo mogoče. Varnostna kopija je bila narejena, nadaljujemo naprej.
Preverjanje datotečnega sistema
Pred poskusom obnove baze podatkov je potrebno zagotoviti, da je z našim datotečnim sistemom vse v redu. In v primeru napak jih odpraviti, saj v nasprotnem primeru lahko le še poslabšamo situacijo.
V mojem primeru je bil datotečni sistem z bazo podatkov pritrjen v «/srv» in tip je bil ext4.
Ustavimo bazo podatkov: systemctl stop postgresql@9.5-main.service n mi preverjamo, da sistem datotek nikogar ne uporablja in ga lahko odmontiramo s pomočjo ukaza lsof:
lsof +D /srv
Moral sem še ustaviti podatkovno bazo redis, saj je tudi ta bila v uporabi «/srv». Nato sem odmontiral /srv (umount).
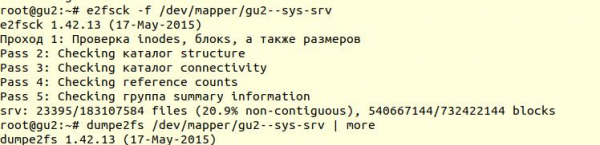
Preverjanje datotečnega sistema je bilo izvedeno s pomočjo orodja e2fsck s parametrom -f (Force checking even if filesystem is marked clean):
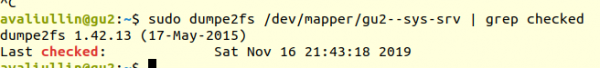
Nato sem s pomočjo orodja dumpe2fs (sudo dumpe2fs /dev/mapper/gu2—sys-srv | grep checked) lahko preverite, da je preverjanje res potekalo:
e2fsck pravi, da na ravni datotečnega sistema ext4 ni najdenih težav, kar pomeni, da lahko nadaljujemo z poskusi obnove baze podatkov, oziroma se vrnemo k vacuum full (seveda je potrebno ponovno montirati datotečni sistem in zagnati podatkovno bazo).
Če imate fizični strežnik, obvezno preverite stanje diskov (prek smartctl -a /dev/XXX) ali RAID krmilnika, da se prepričate, da težava ni na strojni ravni. V mojem primeru je bil RAID »železen«, zato sem prosil lokalnega administratorja, da preveri stanje RAID (strežnik je bil več sto kilometrov stran od mene). Rekel je, da ni napak, kar pomeni, da lahko začnemo z obnovitvijo.
Poskus 1: zero_damaged_pages
Povezujemo se z bazo preko psql računa, ki ima pravice superuporabnika. Potrebujemo prav superuporabnika, saj lahko le on spreminja možnost zero_damaged_pages only he can change it. V mojem primeru je to postgres:
psql -h 127.0.0.1 -U postgres -s [database_name]
Možnost zero_damaged_pages je potrebna, da ignorira napake branja (s strani postgrespro):
Z ugotovitvijo poškodovanega naslovnika strani Postgres Pro običajno poroča o napaki in prekine trenutno transakcijo. Če je parameter zero_damaged_pages vklopljen, namesto tega sistem izda opozorilo, ponastavi poškodovano stran v pomnilniku in nadaljuje obdelavo. Ta vedenje uničuje podatke, predvsem vse vrstice v poškodovani strani.
Vključimo možnost in poskusimo narediti full vacuum tabele:
VACUUM FULL VERBOSE 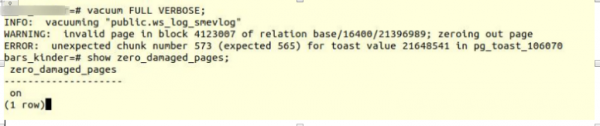
Žal, neuspeh.
Srečali smo se s podobno napako:
INFO: vacuuming "“public.ws_log_smevlog”
WARNING: invalid page in block 4123007 of relation base/16400/21396989; zeroing out page
ERROR: unexpected chunk number 573 (expected 565) for toast value 21648541 in pg_toast_106070– mehanizem za shranjevanje »dolgih podatkov« v Poetgresu, če ti ne pomestijo na eno stran (privzeto 8kb).
Poskus 2: reindex
Prvi nasvet iz googla ni pomagal. Po nekaj minutah iskanja sem našel drugi nasvet – narediti reindex poškodovane tabele. Ta nasvet sem srečal na več mestih, a ni vzbudil zaupanja. Izvedimo reindeksiranje:
reindeksiranje tabele ws_log_smevlog 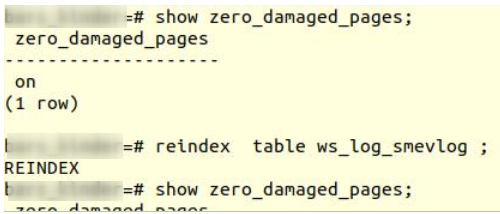
reindex se je zaključilo brez težav.
Vendar to ni pomagalo, VACUUM FULL se je nenadoma končalo s podobno napako. Ker sem bil navajen neuspehov, sem začel iskati nasvete na internetu in naletel na kar nekaj zanimivega .
Poskus 3: SELECT, LIMIT, OFFSET
V zgoraj omenjenem članku so predlagali, da pregledam tabelo vrstico po vrstico in odstranite problematične podatke. Najprej je bilo treba pregledati vse vrstice:
for ((i=0; i/dev/null || echo $i; doneV mojem primeru je tabela vsebovala 1 628 991 vrstic! Po pravici je bilo treba poskrbeti za , toda to je tema za posebno razpravo. Bila je sobota, zagnal sem to ukaz v tmux in šel spat:
for ((i=0; i/dev/null || echo $i; doneZjutraj sem se odločil preveriti, kako napreduje. Na moje presenečenje sem ugotovil, da je bilo v 20 urah skeniranih le 2% podatkov! Čakati 50 dni nisem želel. Še en popoln neuspeh.
A se nisem hotel predati. Zanimalo me je, zakaj je skeniranje trajalo tako dolgo. V dokumentaciji (znova na postgrespro) sem izvedel:
OFFSET pomeni, da se izpustijo določeno število vrstic, preden se začnejo izdajati vrstice.
Če sta navedena tako OFFSET kot LIMIT, sistem najprej preskoči OFFSET vrstic, nato začne šteti vrstice za omejitev LIMIT.Pri uporabi LIMIT je pomembno uporabiti tudi klavzulo ORDER BY, da so vrstice rezultata predstavljene v določenem vrstnem redu. V nasprotnem primeru bodo vrnjeni nepredvidljivi podmnožji vrstic.
Očitno je bila zgoraj napisana ukaz napačna: prvič, ni bilo order by, lahko je bil rezultat napačen. Drugič, Postgres je najprej moral skenirati in preskočiti OFFSET vrstic, kar bi s povečevanjem OFFSET učinkovitost še bolj upočasnilo.
Poskus 4: narediti izvoz v besedilni obliki
Nato mi je prišla na pamet, domnevno genijalna ideja: narediti izvoz v besedilni obliki in analizirati zadnjo vpisano vrstico.
Ampak najprej, se seznanimo s strukturo tabele ws_log_smevlog:
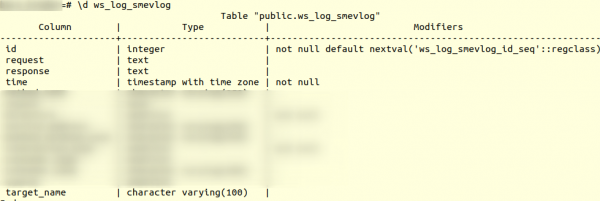
V našem primeru imamo stolpec «id», ki je vseboval edinstveni identifikator (števec) vrstice. Načrt je bil naslednji:
- Začnimo z izvoženjem v besedilni obliki (v obliki sql-ukazov)
- V določenem trenutku je nalaganje podatkovne kopije obstalo zaradi napake, vendar se je besedilna datoteka vseeno shranila na disk.
- Poglejmo konec besedilne datoteke, s čimer najdemo identifikator (id) zadnjega uspešno nalaganega zapisa.
Začel sem nalagati podatke v besedilni obliki:
pg_dump -U my_user -d my_database -F p -t ws_log_smevlog -f ./my_dump.dumpNalaganje podatkovne kopije se je, kot je pričakovano, spet ustavilo z enako napako:
pg_dump: Sporočilo o napaki s strežnika: ERROR: invalid page in block 4123007 of relation base/16490/21396989 Nato sem preko tail pregledal konec podatkovne kopije (tail -5 ./my_dump.dump) in odkril, da se je nalaganje ustavilo pri zapisu z id 186 525. "To pomeni, da je težava pri zapisu z id 186 526, je poškodovan, in ga moram izbrisati!" – sem pomislil. Toda, ko sem izvedel poizvedbo v podatkovni bazi:
«select * from ws_log_smevlog where id=186529se je izkazalo, da je ta zapis v redu... Zapisi z indeksi 186 530 – 186 540 so prav tako delovali brez težav. Nadaljnja "genialna ideja" je spodletela. Kasneje sem razumel, zakaj je to tako: pri brisanju/spremembi podatkov iz tabele se le-ti fizično ne izbrišejo, temveč se označijo za "mrtve tupljene", nato pride autovacuum in označi te zapise za izbrisane in omogoči njihovo ponovno uporabo. Za razumevanje, če se podatki v tabeli spreminjajo in je vklopljen autovacuum, se ti ne shranjujejo zaporedno.
Poskus 5: SELECT, FROM, WHERE id=
Neuspehi nas krepijo. Nikoli ne smemo obupati, treba je iti do konca in verjeti v sebe ter svoje sposobnosti. Zato sem se odločil, da poskusim še eno možnost: preprosto pregledati vse zapise v podatkovni bazi enega za drugim. Glede na strukturo moje tabele (glej zgoraj), imamo polje id, ki je unikaten (prvi ključ). V tabeli imamo 1.628.991 zapisov in id so razporejeni po vrsti, kar pomeni, da jih lahko preprosto obdelamo enega za drugim:
for ((i=1; i/dev/null || echo $i; doneČe kdo ne razume, ukaz deluje na naslednji način: pregleduje tabelo vrstico po vrstici in pošilja stdout v /dev/null, vendar če ukaz SELECT ne uspe, se izpiše besedilo napake (stderr se pošlje v konzolo) in izpiše se vrstica, ki vsebuje napako (zahvaljujoč ||, ki pomeni, da je pri SELECT nastala težava (izhodna koda ukaza ni 0)).
Imel sem srečo, da so bili ustvarjeni indeksi po polju id:
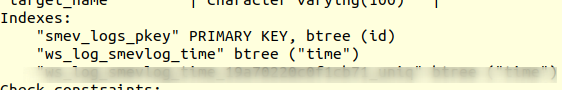
To pomeni, da iskanje zapisa z želenim id ne bi smelo vzeti veliko časa. V teoriji bi moralo delovati. No, zaženimo ukaz v tmux In gremo spat.
Do jutra sem ugotovil, da je bilo pregledanih okoli 90 000 zapisov, kar predstavlja malo več kot 5%. Odličen rezultat, če primerjamo s prejšnjo metodo (2%)! Ampak čakati 20 dni si nisem želel...
Poskus 6: SELECT, FROM, WHERE id >= and id <
Za naročnika je bil dodeljen odličen strežnik: dvojončni Intel Xeon E5-2697 v2, v naši postavitvi je bilo kar 48 niti! Obremenitev na strežniku je bila povprečna, brez težav smo lahko zbrali okoli 20 niti. Tudi pomnilnika je bilo dovolj: kar 384 gigabajtov!
Zato je bilo potrebno razdeliti ekipo:
for ((i=1; i/dev/null || echo $i; doneTukaj bi lahko napisal lep in eleganten skript, vendar sem izbral najhitrejši način paralelizacije: ročno razdeliti obseg 0-1628991 na intervale po 100 000 zapisov in zagnati ločeno 16 ukazov v obliki:
for ((i=N; i/dev/null || echo $i; doneAmpak to še ni vse. Teoretično povezovanje z bazo podatkov prav tako vzame nekaj časa in sistemskih virov. Priključitev 1 628 991 ni bila preveč razumna, se strinjate? Zato poskusimo pri enem povezovanju pridobiti 1000 vrstic namesto ene. Na koncu se je ukaz spremenil v to:
for ((i=N; i=$i and id/dev/null || echo $i; doneOdpremo 16 oken v seji tmux in zaženemo ukaze:
1) for ((i=0; i=$i and id/dev/null || echo $i; done
2) for ((i=100000; i=$i and id/dev/null || echo $i; done
…
15) for ((i=1400000; i=$i and id/dev/null || echo $i; done
16) for ((i=1500000; i=$i and id/dev/null || echo $i; done
Čez dan sem dobil prve rezultate! In sicer (vrednosti XXX in ZZZ niso bile shranjene):
ERROR: missing chunk number 0 for toast value 37837571 in pg_toast_106070
829000
ERROR: missing chunk number 0 for toast value XXX in pg_toast_106070
829000
ERROR: missing chunk number 0 for toast value ZZZ in pg_toast_106070
146000
To pomeni, da imamo tri vrstice, ki vsebujejo napako. ID prve in druge problematične vrstice sta bila med 829 000 in 830 000, ID tretje pa med 146 000 in 147 000. Zdaj nam je preostalo samo najti natančno vrednost ID problematičnih zapisov. Za to bomo pregledali naš obseg s problematičnimi zapisi v koraku 1 in identificirali ID:
for ((i=829000; i/dev/null || echo $i; done
829417
ERROR: unexpected chunk number 2 (expected 0) for toast value 37837843 in pg_toast_106070
829449
for ((i=146000; i/dev/null || echo $i; done
829417
ERROR: unexpected chunk number ZZZ (expected 0) for toast value XXX in pg_toast_106070
146911
Srečen zaključek
Našli smo problematične vrstice. Vstopimo v bazo preko psql in poskusimo jih izbrisati:
my_database=# delete from ws_log_smevlog where id=829417;
DELETE 1
my_database=# delete from ws_log_smevlog where id=829449;
DELETE 1
my_database=# delete from ws_log_smevlog where id=146911;
DELETE 1
Moje presenečenje, zapise so izbrisali brez kakršnih koli težav, celo brez možnosti zero_damaged_pages.
Nato sem se povezal z bazo, naredil VACUUM FULL (mislim, da ni bilo treba), in končno uspešno naredil varnostno kopijo z uporabo pg_dump. Varnostna kopija je bila narejena brez kakršnih koli napak! Problema se je uspelo rešiti na ta preprost način. Radosti ni bilo konec, po tolikih neuspehih sem končno našel rešitev!
Zahvale in zaključek
To je bila moja prva izkušnja obnavljanja prave baze podatkov Postgres. To izkušnjo bom zapomnil dolgo časa.
In na koncu, rad bi se zahvalil podjetju PostgresPro za prevedeno dokumentacijo v ruščino in za , ki so zelo pomagali pri analizi problema.
Izvor: habr.com
