

Članek je sestavljen iz dveh delov:
- Kratak opis nekaterih arhitektur omrežij za odkrivanje objektov na slikah in segmentacijo slik s najbolj razumljivimi povezavami do virov za mene. Poskušal sem izbrati videopojasnila, ki so bila, če je mogoče, v ruščini.
- Drugi del je poskus razumeti razvojno smer arhitektur nevronih mrež in tehnologij, ki temeljijo na njih.
Slika 1 – Razumevanje arhitektur nevronih mrež ni preprosto
Vse se je začelo s tem, da sem naredil dve prikazni aplikaciji za klasifikacijo in odkrivanje objektov na telefonu Android:
- , ko se podatki obdelujejo na strežniku in prenašajo na telefon. Klasifikacija slik (image classification) treh vrst medvedov: rjavi, črni in plišasti.
- , ko se podatki obdelujejo na sami napravi. Odkritje objektov (object detection) treh vrst: lešnik, figa in datelj.
Obstaja razlika med nalogami klasifikacije slik, odkrivanjem objektov na slikah in . Zato se je pojavila potreba po spoznanju, katere arhitekture nevronih mrež odkrivajo objekte na slikah in katere lahko segmentirajo. Našel sem naslednje primere arhitektur z najbolj razumljivimi povezavami do virov:
- Serija arhitektur na osnovi R-CNN (Regions with Convolution Neural Networks features): R-CNN, Fast R-CNN, , . Za odkrivanje objekta na sliki se s pomočjo mehanizma Regional Proposal Network (RPN) izločijo omejeni regij (bounding boxes). Sprva je bil namesto RPN uporabljen počasnejši mehanizem Selective Search. Nato se izločene omejene regije predložijo običajni nevroni mreži za klasifikacijo. V arhitekturi R-CNN so jasno izraženi 'for' cikli za preizkušnjo omejenih regij, skupno do 2000 ponovitev skozi notranjo mrežo AlexNet. Zaradi očitnih 'for' ciklov se zmanjša hitrost obdelovanja slik. Število očitnih ciklov, ponovitev skozi notranjo nevroni mrežo, se z vsako novo različico arhitekture zmanjšuje, prav tako se izvajajo desetine drugih sprememb za povečanje hitrosti in zamenjavo naloge odkrivanja objektov s segmentacijo objektov v Mask R-CNN.
- (You Only Look Once) – prva nevronska mreža koja prepoznaje objekte u stvarnom vremenu na mobilnim uređajima. Odlikuje je sposobnost razlikovanja objekata u jednom prolazu (dovoljno je da pogleda jednom). Drugim rečima, u YOLO arhitekturi nema očiglednih "for" petlji, zbog čega mreža brzo funkcioniše. Na primer, analogija: u NumPy kodu prilikom operacija sa matricama takođe nema očiglednih "for" petlji, što se u NumPy realizuje na nižim nivoima putem jezika C. YOLO koristi mrežu unapred definisanih prozora. Da se isti objekat ne prepoznaje više puta, koristi se koeficijent preklapanja prozora (IoU, Intersection over Union). Ova arhitektura funkcioniše u širokom opsegu i ima visok : model može biti obučen na fotografijama, ali takođe dobro radi na crtežima.
- (Single Shot MultiBox Detector) – koriste se najslađi "hackovi" YOLO arhitekture (na primer, non-maximum suppression) i dodaju se novi, kako bi neuronska mreža brže i tačnije radila. Odlikuje je sposobnost razlikovanja objekata u jednom prolazu pomoću definisanih prozora (default box) na piramidi slika. Piramida slika je kodirana u konvolucionim tenzorima kroz sekvencijalne konvolucijske i pooling operacije (prilikom operacije max-pooling prostorna dimenzija se smanjuje). Na taj način se prepoznaju i veliki i mali objekti u jednom prolazu mreže.
- MobileSSD (MobilniNetV2 + SSD) – kombinacija dve arhitekture neuronskih mreža. Prva mreža runs fast and increases recognition accuracy. MobileNetV2 is used instead of VGG-16, which was originally used in . Druga mreža SSD određuje lokaciju objekata na slici.
- – veoma mala, ali precizna neuronska mreža. Samo po sebi ne rešava zadatak otkrivanja objekata. Međutim, može se koristiti u kombinaciji različitih arhitektura. I upotrebljava se na mobilnim uređajima. Njena posebna karakteristika je to da se prvobitno podaci kompresuju do četiri 1×1 konvolucijska filtera, a zatim šire do četiri 1×1 i četiri 3×3 konvolucijska filtera. Jedna takva iteracija kompresije-širenja podataka naziva se "Fire Module".
- (Semantic Image Segmentation with Deep Convolutional Nets) – segmentacija objektov na sliki. Posebnost arhitekture je razpršena (dilated convolution) konvolucija, ki ohranja prostorsko ločljivost. Sledi faza obdelave rezultatov z uporabo grafičnega verjetnostnega modela (conditional random field), kar omogoča odstranitev manjših šumov v segmentaciji in izboljšanje kakovosti odsegljenega vizualnega materiala. Za groznim imenom «grafični verjetnostni model» se skriva običajen Gaussian filter, ki je aproksimiran na petih točkah.
- Poskušal sem razumeti delovanje (Single-Shot Refinement Neural Network for Object Detection), vendar sem malo razumel.
- Pogledal sem tudi, kako deluje tehnologija «pozornost» (attention): , , . Posebnost arhitekture «pozornost» je avtomatsko izločanje regij povečane pozornosti na sliki (RoI, Regions of Interest) s pomočjo nevronetske mreže z imenom Attention Unit. Regije povečane pozornosti so podobne omejenim regijam (bounding boxes), a za razliko od njih niso zaklenjene na sliki in lahko imajo zamegljene meje. Nato se iz regij povečane pozornosti izločijo značilnosti (features), ki se »predajajo« rekurenčnim nevronetskim mrežam z arhitekturami . Rekurenčne nevronetske mreže znajo analizirati medsebojne odnose značilnosti v zaporedju. Rekurenčne nevronetske mreže so prvotno bile uporabljene za prevajanje besedil v druge jezike, zdaj pa tudi za prevod in .
Med raziskovanjem teh arhitektur sem spoznal, da nič ne razumem. In ne gre za to, da bi imela moja nevronetska mreža težave z mehanizmom pozornosti. Ustvarjanje vseh teh arhitektur se zdi kot nek ogromen hackathon, kjer avtorji tekmujejo v hackih. Hack (hack) je hitro rešitev težkega programskega problema. Torej, med vsemi temi arhitekturami ni vidne in razumljive logične povezave. Vse, kar jih povezuje, je skupek najbolj uspešnih hackov, ki si jih izposojajo drug od drugega, plus skupna za vse (povratno širjenje napake, backpropagation). Ni ! Ni jasno, kaj spremeniti in kako optimizirati obstoječe dosežke.
Kot rezultat pomanjkanja logične povezave med haki je, da si jih je izjemno težko zapomniti in uporabiti v praksi. To so fragmentirana znanja. V najboljšem primeru se zapomnijo nekateri zanimivi in nepričakovani trenutki, a večina razumljenega in nerazumljenega izgine iz spomina že v nekaj dneh. Dobro bi bilo, če bi se vsaj ime arhitekture spomnilo po tednu dni. In to je ob branju člankov in gledanju preglednih videov vzelo več ur in celo dni delovnega časa!
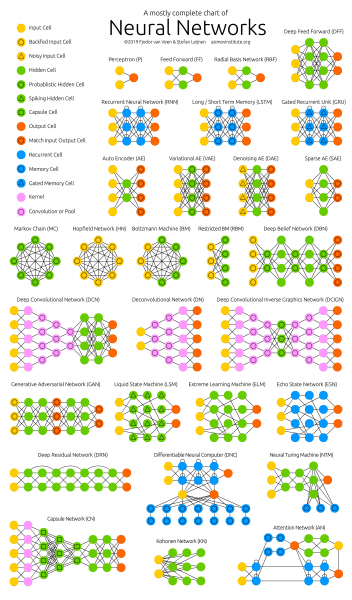
Slika 2 –
Večina avtorjev znanstvenih člankov, po mojem osebnem mnenju, dela vse, kar je v njihovi moči, da tudi to fragmentirano znanje ostane nejasno bralcu. Toda depričastni stavki v desetih vrstnih stavkih s formulami, ki so vzeti 's stropa', so tema za poseben članek (problem ).
Zaradi tega se je pojavila potreba po sistematizaciji informacij o nevronkih mrežah in tako povečanju kakovosti razumevanja in zapomnitve. Zato je glavna tema analize posameznih tehnologij in arhitektur umetnih nevronskih mrež postala naslednja naloga: izvedeti, kam vse to vodi, ne pa o delovanju neke konkretne nevronke posebej.
Kam se to vse giblje. Glavni rezultati:
- Število start-up podjetij na področju strojnega učenja v zadnjih dveh letih . Možen razlog: 'nevronske mreže so prenehale biti nekaj novega.'
- Vsakdo bo lahko ustvaril delujočo nevronko za reševanje preproste naloge. Za to bo vzel že pripravljeni model iz 'zoološkega vrta modelov' (model zoo) in usposobil zadnjo plast nevronke () na pripravljenih podatkih iz ali iz v brezplačnem .
- Veliki proizvajalci nevronk so začeli ustvarjati 'zoološke vrtove modelov' (model zoo). S pomočjo njih lahko hitro naredite komercialno aplikacijo: za TensorFlow, za PyTorch, za Caffe2, za Chainer in .
- Nevronske mreže, ki delujejo v realnem času (real-time) na mobilnih naprava. Od 10 do 50 slik na sekundo.
- Uporaba nevronk na telefonih (TF Lite), v brskalnikih (TF.js) in v (IoT, Iinternet of Tstvari). Še posebej na telefonih, ki že podpirajo nevronke na nivoju 'železa' (nevroakseratorji).
- „Vsaka naprava, oblačila in morda celo hrana bodo imela IP-v6 naslov in se med seboj povezovala“ – .
- Rast števila objav o strojno učenju je začela (podvojitev vsaka dve leti) od leta 2015. Očitno so potrebne nevronske mreže za analizo člankov.
- Naslednje tehnologije postajajo vse bolj priljubljene:
- PyTorch – priljubljenost raste hitro in, zdi se, prehiteva TensorFlow.
- Samodejna izbira hiperpamoč AutoML – priljubljenost raste postopoma.
- Postopno zmanjšanje natančnosti in povečanje hitrosti izračunov: , algoritmi , nedoločeni (približni) izračuni, kvantizacija (ko se teže nevronske mreže pretvorijo v cela števila in kvantizirajo), nevronski pospeševalniki.
- Prevod in .
- Ustvarjanje , zdaj že v realnem času.
- Osnovno v DL – to je veliko podatkov, toda zbrati in označiti jih ni enostavno. Zato se razvija avtomatizacija označevanja () za nevronske mreže s pomočjo nevronskih mrež.
- Z nevronskimi mrežami je računalništvo nenadoma postalo eksperimentalna znanost in nastal je .
- IT-denar in priljubljenost nevronskih mrež sta se pojavila hkrati, ko so postali izračuni tržna vrednost. Ekonomija iz zlato-valutne postane zlato-valutno-računska.. Oglejte si moj članek o in razlogu za pojav IT-denarja.
Počasi se razvija nova (Strojno učenje & Globoko učenje), ki temelji na predstavljanju programa kot zbirke usposobljenih modelov nevronskih mrež.
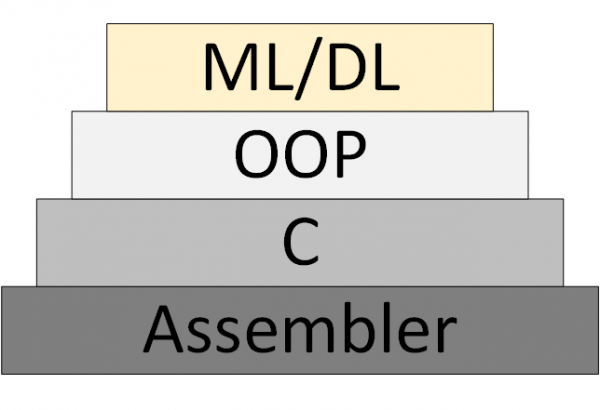
Slika 3 – ML/DL kot nova metodologija programiranja
Vendar pa se ni pojavila „teorija nevronskih mrež“, v okviru katere bi bilo mogoče razmišljati in delati sistematično. To, kar se danes imenuje „teorija“, so v resnici eksperimentalni, heuristični algoritmi.
Povezave do mojih in drugih virov:
- Novice o podatkovni znanosti. V glavnem o predelavi slik. Kdor želi prejemati, naj pošlje e-mail (foobar167<gaff-gaff>gmail<točka>com). Povezave do člankov in videoposnetkov pošiljam, ko naberem material.
- Skupen , ki sem jih opravil in ki bi jih želel opraviti.
- , s katerimi se je vredno začeti učiti o nevronskih mrežah. Poleg tega brošura .
- , kjer bo vsak našel nekaj zanimivega zase.
- Izjemno koristni so bili video kanali za analizo znanstvenih člankov o Data Science. Poiščite jih, naročite se nanje in delite povezave s svojimi kolegi ter z mano. Primeri:
- in s podrobnimi navodili in odprtokodnimi projekti.
Hvala za pozornost!
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish