

9. januarja je izšla različica Pandas 1.0.0rc. Prejšnja različica knjižnice je bila 0.25.
Prva glavno izdana različica vsebuje številne odlične novosti, vključno z izboljšanim samodejnim seštevanjem podatkovnih okvirov, več oblikami izhoda, novimi tipi podatkov in celo novo spletno dokumentacijo.
Vse spremembe si lahko ogledate , v članku pa se bomo omejili na kratek, manj tehnični pregled najpomembnejšega.
Namestite knjižnico lahko kot običajno z pip, vendar ker ob času pisanja članka Pandas 1.0 še vedno release candidate, boste morali jasno navesti različico:
pip install --upgrade pandas==1.0.0rc0Bodite previdni: ker gre za glavno izdajo, lahko posodobitev pokvari staro kodo!
Mimogrede, od te različice popolnoma prenehajo podpirati Python 2 (kar je lahko dober razlog — op. prev.). Pandas 1.0 zahteva vsaj Python 3.6+, zato če niste prepričani, preverite, katero različico imate nameščeno:
$ pip --version
pip 19.3.1 from /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
Najlažje preverite različico Pandas takole:
>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Izboljšano samodejno seštevanje z DataFrame.info
Moja najljubša novost je bila posodobitev metode DataFrame.info. Funkcija je postala mnogo bolj pregledna, kar še dodatno olajša raziskovanje podatkov:
>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["goodbye", "cruel", "world"],
...:   'C': [False, True, False]
...:})
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      object
 2   C       3 non-null      object
dtypes: int64(1), object(2)
memory usage: 200.0+ bytes
Izpis tabel v formatu Markdown
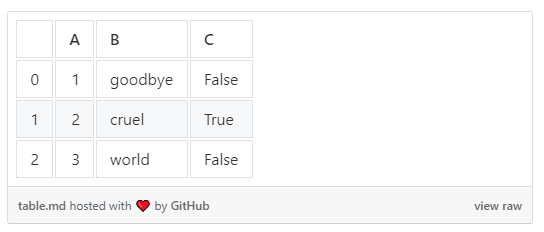
Poleg tega je lepo nova možnost izvoziti podatkovne okvire v Markdown tabele z uporabo DataFrame.to_markdown.
>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | goodbye | False |
|  1 |   2 | cruel   | True  |
|  2 |   3 | world   | False |
To močno poenostavi objavo tabel na spletnih straneh, kot je Medium, z uporabo github gists.
Novi tipi za nize in logične vrednosti
V izdaji Pandas 1.0 so dodali tudi nove eksperimentalne tipi. Njihov API se lahko še spremeni, zato ga uporabljajte previdno. Vendar na splošno Pandas priporoča uporabo novih tipov tam, kjer je to smiselno.
Zaenkrat je treba konverzijo izvesti eksplicitno:
>>> B = pd.Series(["goodbye", "cruel", "world"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      string
 2   C       3 non-null      bool
dtypes: int64(1), object(1), string(1)
memory usage: 200.0+ bytes
Обратите внимание, как колонка Dtype отображает новые типы — string in bool.
Наиболее полезной особенностью нового строкового типа является возможно выбора только колонок строк из датафреймов. Это может значительно упростить анализ текстовых данных:
df.select_dtypes("string")Ранее колонки строк нельзя было выбирать без явного указания имён.
Больше о новых типах можно почитать .
Спасибо, что дочитали! Полный список изменений, как уже упоминалось, можно посмотреть .
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish