

Boli le samo prvi put!
Pozdrav svima! Dragi prijatelji, u ovom članku želim da podelim svoje iskustvo korišćenja TensorRT, RetinaNet na osnovu repozitorijuma (to je fork zvaničnog repa od , koji će omogućiti da počnete da koristite optimizovane modele u produkciji u najkraćem roku). Prelistavajući poruke u kanalima zajednice , nailazim na pitanja o korišćenju TensorRT-a, a uglavnom se ta pitanja ponavljaju, pa sam odlučio da napišem što potpunije uputstvo za korišćenje brzog inferensa zasnovanog na TensorRT-u, RetinaNet-u, Unet-u i dockera.
Opis naloge
Prvo postavljamo zadatak na sledeći način: potrebno je da označimo dataset, obučimo mrežu RetinaNet/Unet na Pytorch1.3+, pretvorimo dobijene težine u ONNX, zatim ih konvertujemo u TensorRT engine i sve to pokrenemo u docker-u, po mogućstvu na Ubuntu 18 i veoma poželjno na ARM(Jetson)* arhitekturi, tako da minimalizujemo ručno postavljanje okruženja. Na kraju dobijamo kontejner spreman ne samo za izvoz i obuku RetinaNet/Unet, već i za kompletnu razvoj i obuku klasifikacije, segmentacije sa svom potrebnom opremom.
Faza 1. Priprema okruženja
Ovde je važno napomenuti da sam u poslednje vreme potpuno prešao na korišćenje i postavljanje bilo kakvih biblioteka na desktop mašini, kao i na devbox-u. Jedino što moram da kreiram i instaliram je python virtual environment i cuda 10.2 (može se ograničiti na jedan nvidia drajver) iz deb-a.
Pretpostavimo da imate svež install Ubuntu 18. Instaliraćemo cuda 10.2(deb), detaljno se neću zadržavati na procesu instalacije, zvanična dokumentacija je sasvim dovoljna.
Sada instaliramo docker, uputstvo za instalaciju dockera lako se može naći, evo jednog primera , već je dostupna verzija 19+ — instaliramo tu. I ne zaboravite da omogućite korišćenje dockera bez sudo, tako će biti lakše. Nakon što sve prođe, uradimo ovako:
distribution=$(. /etc/os-release;echo $ID$VERSION_ID)
curl -s -L https://nvidia.github.io/nvidia-docker/gpgkey | sudo apt-key add -
curl -s -L https://nvidia.github.io/nvidia-docker/$distribution/nvidia-docker.list | sudo tee /etc/apt/sources.list.d/nvidia-docker.list

sudo apt-get update && sudo apt-get install -y nvidia-container-toolkit
sudo systemctl restart docker
I čak ne morate gledati u zvanični repozitorijum .
Sada radimo git clone .
Ostalo je samo malo da bismo počeli koristiti docker sa nvidia slikom, potrebno je da se registrujemo na NGC Cloud i prijavimo. Idemo ovde , registrujemo se i nakon što uđemo u NGC Cloud, kliknemo na SETUP u gornjem levom uglu ekrana ili idemo na ovu vezu . Kliknite „generiši ključ“. Preporučujem da ga sačuvate, inače će prilikom sledeće posete morati da ga generišete ponovo i, shodno tome, prilikom postavljanja na novoj mašini, ponovo izvršiti ovu operaciju.
Izvršavamo:
docker login nvcr.io
Username: $oauthtoken
Password:  - generisani ključ
Username jednostavno kopiramo. Pa eto, smatramo da je okruženje postavljeno!
Faza 2. Izrada docker kontejnera
U drugoj fazi našeg rada izgradićemo docker i upoznati se sa njegovim unutrašnjim radom.
Idemo u korenskom folderu u odnosu na projekat retina-examples i izvršavamo
docker build --build-arg USER=$USER --build-arg UID=$UID --build-arg GID=$GID --build-arg PW=alex -t retinanet:latest retinanet/
Gradimo docker prosleđujući trenutnog korisnika — to je veoma korisno ako planirate nešto da pišete na montiranom VOLUME sa pravima trenutnog korisnika, inače će biti root i to će biti problem.
Dok se docker gradi, hajde da proučimo Dockerfile:
FROM nvcr.io/nvidia/pytorch:19.10-py3

ARG USER=alex
ARG UID=1000
ARG GID=1000
ARG PW=alex
RUN useradd -m ${USER} --uid=${UID} && echo "${USER}:${PW}" | chpasswd

RUN apt-get -y update && apt-get -y upgrade && apt-get -y install curl && apt-get -y install wget && apt-get -y install git && apt-get -y install automake && apt-get install -y sudo && adduser ${USER} sudo
RUN pip install git+https://github.com/bonlime/pytorch-tools.git@master

COPY . retinanet/
RUN pip install --no-cache-dir -e retinanet/
RUN pip install /workspace/retinanet/extras/tensorrt-6.0.1.5-cp36-none-linux_x86_64.whl
RUN pip install tensorboardx
RUN pip install albumentations
RUN pip install setproctitle
RUN pip install paramiko
RUN pip install flask
RUN pip install mem_top
RUN pip install arrow
RUN pip install pycuda
RUN pip install torchvision
RUN pip install pretrainedmodels
RUN pip install efficientnet-pytorch
RUN pip install git+https://github.com/qubvel/segmentation_models.pytorch
RUN pip install pytorch_toolbelt

RUN chown -R ${USER}:${USER} retinanet/

RUN cd /workspace/retinanet/extras/cppapi && mkdir build && cd build && cmake -DCMAKE_CUDA_FLAGS="--expt-extended-lambda -std=c++14" .. && make && cd /workspace

RUN apt-get install -y openssh-server && apt install -y tmux && apt-get -y install bison flex && apt-cache search pcre && apt-get -y install net-tools && apt-get -y install nmap
RUN apt-get -y install libpcre3 libpcre3-dev && apt-get -y install iputils-ping

RUN mkdir /var/run/sshd
RUN echo 'root:pass' | chpasswd
RUN sed -i 's/PermitRootLogin prohibit-password/PermitRootLogin yes/' /etc/ssh/sshd_config
RUN sed 's@sessions*requireds*pam_loginuid.so@session optional pam_loginuid.so@g' -i /etc/pam.d/sshd

ENV NOTVISIBLE "in users profile"
RUN echo "export VISIBLE=now" >> /etc/profile
CMD ["/usr/sbin/sshd", "-D"]
Kot se vidi iz besedila, vzamemo vse naše najljubše knjižnice, sestavimo retinanet, dodamo osnovna orodja za udobno delo z Ubuntu in nastavimo strežnik openssh. Prva vrstica se nanaša na dedovanje slike nvidia, za katero smo se prijavili v NGC Cloud in ki vsebuje Pytorch1.3, TensorRT6.x.x.x in še kup knjižnic, ki omogočajo prevod cpp izvornih kod našega detektorja.
Faza 3. Zagon in odpravljanje hroščev v docker kontejnerju
Preidimo k glavnemu primeru uporabe kontejnerja in razvojnega okolja, najprej zaženimo nvidia docker. Izvedimo:
docker run --gpus all --net=host -v /home/:/workspace/mounted_vol -d -P --rm --ipc=host -it retinanet:latestSedaj je kontejner dostopen preko ssh @localhost. Po uspešnem zagonu odprite projekt v PyCharm. Nato odprite
Nastavitve->Projektni interpreter->Dodaj->Ssh interpreter Korak 1
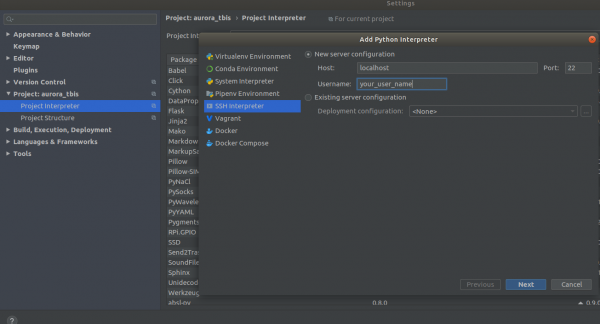
Korak 2
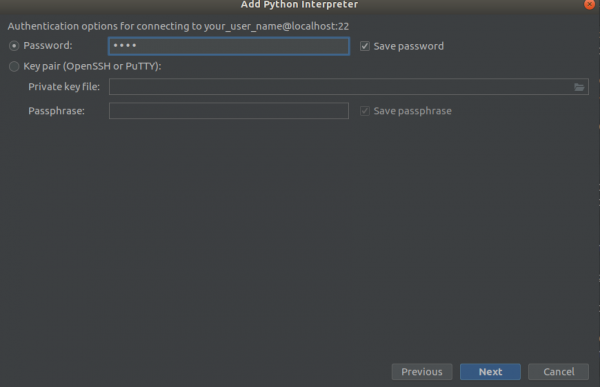
Korak 3
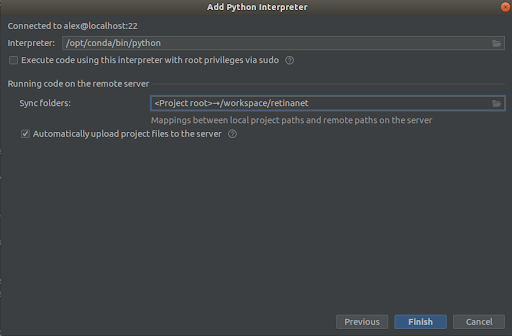
Izberite vse, kot na posnetkih zaslona,
Interpreter -> /opt/conda/bin/python— to bo povezava na Python3.6 in
Sinhronizacijska mapa -> /workspace/retinanetKliknite končaj, počakajte na indeksiranje, in vse, okolje je pripravljeno za uporabo!
POMEMBNO!!! Takoj po indeksiranju izvlecite iz dockerja prevedene datoteke za Retinanet. V kontekstnem meniju v korenu projekta izberite točko
Namestitev->PrenosPojavili se bodo ena datoteka in dve mapa build, retinanet.egg-info in _С.so
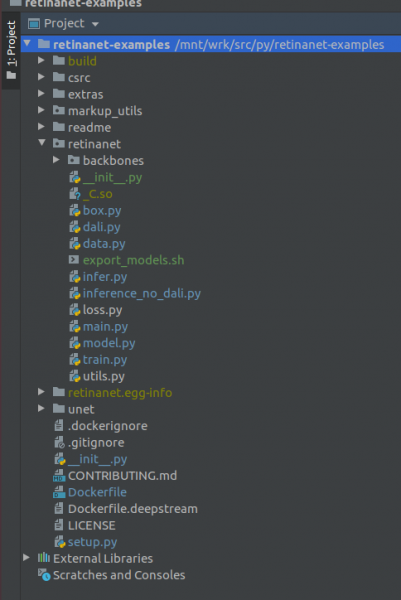
Če vaš projekt izgleda tako, potem okolje vidi vse potrebne datoteke in smo pripravljeni na usposabljanje RetinaNet.
Faza 4. Označujemo podatke in usposabljamo detektor
Za označevanje večinoma uporabljam — prijetna in priročna orodja, v zadnjem času so popravili kup napak in se je bistveno izboljšala.
Predpostavimo, da ste označili podatkovni niz in ga prenesli, vendar ga takoj v naš RetinaNet ni mogoče vstaviti, saj je v lastni obliki in zato ga moramo pretvoriti v COCO. Orodje za pretvorbo se nahaja v:
markup_utils/supervisly_to_coco.pyUpoštevajte, da je kategoria v skriptu zgolj primer in morate vnesti svoje (kategorije background ni treba dodati)
categories = [{'id': 1, 'name': '1'},
                  {'id': 2, 'name': '2'},
                  {'id': 3, 'name': '3'},
                  {'id': 4, 'name': '4'}]
Avtorji izvirnega repozitorija so nekako menili, da ne boste usposabljali nič drugega kot COCO/VOC za detekcijo, zato smo morali nekoliko urediti izvorno datoteko
retinanet/dataset.pyDodali smo tukaj naše priljubljene augmentacije in inhard categories from COCO. There is also the option to crop large detection areas if you are searching for small objects in large images, you have a small dataset =), and nothing works, but that's a topic for another time.
In general, the training loop is also weak; initially, it didn't save checkpoints, used some terrible scheduler, etc. But now you just need to choose the backbone and execute it.
/opt/conda/bin/python retinanet/main.pywith the following parameters:
train retinanet_rn34fpn.pth
--backbone ResNet34FPN
--classes 12
--val-iters 10
--images /workspace/mounted_vol/dataset/train/images
--annotations /workspace/mounted_vol/dataset/train_12_class.json
--val-images /workspace/mounted_vol/dataset/test/images_small
--val-annotations /workspace/mounted_vol/dataset/val_10_class_cropped.json
--jitter 256 512
--max-size 512
--batch 32
You will see in the console:
Inicializacija modela...
     model: RetinaNet
  backbone: ResNet18FPN
   klase: 2, ankari: 9
Izabran nivo optimizacije O0:  Čista FP32 obuka.

Zadane vrednosti za ovaj nivo optimizacije su:
enabled                : True
opt_level              : O0
cast_model_type        : torch.float32
patch_torch_functions  : False
keep_batchnorm_fp32    : None
master_weights         : False
loss_scale             : 1.0
Obrada korisničkih prepravki (dodatni kwargs koji nisu None)...
Nakon obrade prepravki, opcije optimizacije su:
enabled                : True
opt_level              : O0
cast_model_type        : torch.float32
patch_torch_functions  : False
keep_batchnorm_fp32    : None
master_weights         : False
loss_scale             : 128.0
Priprema skupa podataka...
    loader: pytorch
    promena veličine: [1024, 1280], max: 1280
    uređaj: 4 gpu
    batch: 4, preciznost: mešovita
Obučavanje modela kroz 20000 iteracija...
[    1/20000] fokalni gubitak: 0.95619, gubitak kutije: 0.51584, 4.042s/4-batch (fw: 0.698s, bw: 0.459s), 1.0 im/s, lr: 0.0001
[   12/20000] fokalni gubitak: 0.76191, gubitak kutije: 0.31794, 0.187s/4-batch (fw: 0.055s, bw: 0.133s), 21.4 im/s, lr: 0.0001
[   24/20000] fokalni gubitak: 0.65036, gubitak kutije: 0.30269, 0.173s/4-batch (fw: 0.045s, bw: 0.128s), 23.1 im/s, lr: 0.0001
[   36/20000] fokalni gubitak: 0.46425, gubitak kutije: 0.23141, 0.178s/4-batch (fw: 0.047s, bw: 0.131s), 22.4 im/s, lr: 0.0001
[   48/20000] fokalni gubitak: 0.45115, gubitak kutije: 0.23505, 0.180s/4-batch (fw: 0.047s, bw: 0.133s), 22.2 im/s, lr: 0.0001
[   59/20000] fokalni gubitak: 0.38958, gubitak kutije: 0.25373, 0.184s/4-batch (fw: 0.049s, bw: 0.134s), 21.8 im/s, lr: 0.0001
[   71/20000] fokalni gubitak: 0.37733, gubitak kutije: 0.23988, 0.174s/4-batch (fw: 0.049s, bw: 0.125s), 22.9 im/s, lr: 0.0001
[   83/20000] fokalni gubitak: 0.39514, gubitak kutije: 0.23878, 0.181s/4-batch (fw: 0.048s, bw: 0.133s), 22.1 im/s, lr: 0.0001
[   94/20000] fokalni gubitak: 0.39947, gubitak kutije: 0.23817, 0.185s/4-batch (fw: 0.050s, bw: 0.134s), 21.6 im/s, lr: 0.0001
[  105/20000] fokalni gubitak: 0.37343, gubitak kutije: 0.20238, 0.182s/4-batch (fw: 0.048s, bw: 0.134s), 22.0 im/s, lr: 0.0001
[  116/20000] fokalni gubitak: 0.19689, gubitak kutije: 0.17371, 0.183s/4-batch (fw: 0.050s, bw: 0.132s), 21.8 im/s, lr: 0.0001
[  128/20000] fokalni gubitak: 0.20368, gubitak kutije: 0.16538, 0.178s/4-batch (fw: 0.046s, bw: 0.131s), 22.5 im/s, lr: 0.0001
[  140/20000] fokalni gubitak: 0.22763, gubitak kutije: 0.15772, 0.176s/4-batch (fw: 0.050s, bw: 0.126s), 22.7 im/s, lr: 0.0001
[  148/20000] fokalni gubitak: 0.21997, gubitak kutije: 0.18400, 0.585s/4-batch (fw: 0.047s, bw: 0.144s), 6.8 im/s, lr: 0.0001
 Prosečna preciznost  (AP) @[ IoU=0.50:0.95 | oblast=   sve | maxDets=100 ] = 0.52674
 Prosečna preciznost  (AP) @[ IoU=0.50      | oblast=   sve | maxDets=100 ] = 0.91450
 Prosečna preciznost  (AP) @[ IoU=0.75      | oblast=   sve | maxDets=100 ] = 0.35172
 Prosečna preciznost  (AP) @[ IoU=0.50:0.95 | oblast= mala | maxDets=100 ] = 0.61881
 Prosečna preciznost  (AP) @[ IoU=0.50:0.95 | oblast=srednja | maxDets=100 ] = -1.00000
 Prosečna preciznost  (AP) @[ IoU=0.50:0.95 | oblast= velika | maxDets=100 ] = -1.00000
 Prosečan povratak     (AR) @[ IoU=0.50:0.95 | oblast=   sve | maxDets=  1 ] = 0.58824
 Prosečan povratak     (AR) @[ IoU=0.50:0.95 | oblast=   sve | maxDets= 10 ] = 0.61765
 Prosečan povratak     (AR) @[ IoU=0.50:0.95 | oblast=   sve | maxDets=100 ] = 0.61765
 Prosečan povratak     (AR) @[ IoU=0.50:0.95 | oblast= mala | maxDets=100 ] = 0.61765
 Prosečan povratak     (AR) @[ IoU=0.50:0.95 | oblast=srednja | maxDets=100 ] = -1.00000
 Prosečan povratak     (AR) @[ IoU=0.50:0.95 | oblast= velika | maxDets=100 ] = -1.00000
Čuvanje modela: 148
Da biste istražili ceo set parametara, pogledajte
retinanet/main.pyGeneralno, oni su standardni za detekciju i imaju opis. Pokrenite obuku i sačekajte rezultate. Primer inferencije možete pogledati na:
retinanet/infer_example.pyili izvršite komandu:
/opt/conda/bin/python retinanet/main.py infer retinanet_rn34fpn.pth
--images /workspace/mounted_vol/dataset/test/images
--annotations /workspace/mounted_vol/dataset/val.json
--output result.json
--resize 256
--max-size 512
--batch 32
V repozitoriju je že vgrajen Focal Loss in več backbone-ov, prav tako pa je enostavno dodati svoje.
retinanet/backbones/*.pyV tabeli avtorji navajajo nekatere značilnosti:
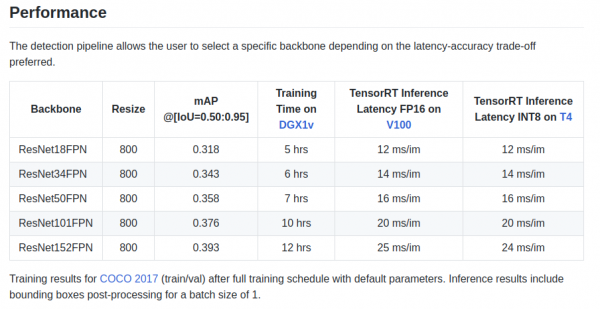
Na voljo je tudi backbone ResNeXt50_32x4dFPN in ResNeXt101_32x8dFPN, prevzeta iz torchvision.
Upam, da smo z detekcijo nekoliko razjasnili, vendar je nujno prebrati uradno dokumentacijo, da razumemo načine izvoza in logiranja..
Korak 5. Izvlečenje in inferenca modelov Unet z encoderjem Resnet.
Kot ste verjetno opazili, so bile v Dockerfile nameščene knjižnice za segmentacijo, zlasti čudovita knjižnica . V paketu unet lahko najdete primere inference in izvoza pytorch checkpointov v engine TensorRT.
Glavna težava pri izvozu Unet-like modelov iz ONNX v TensorRT je potreba po določitvi fiksne velikosti Upsample ali uporabi ConvTranspose2D:
import torch.onnx.symbolic_opset9 as onnx_symbolic
        def upsample_nearest2d(g, input, output_size):
            # Trenutno TRT 5.1/6.0 ONNX parser ne podpira vseh ONNX operacij
            # potrebnih za podporo dinamičnemu upsample-ingu ONNX formulacije
            # Tukaj trdno nastavimo scale=2 kot začasno rešitev
            scales = g.op("Constant", value_t=torch.tensor([1., 1., 2., 2.]))
            return g.op("Upsample", input, scales, mode_s="nearest")

        onnx_symbolic.upsample_nearest2d = upsample_nearest2d
S pomočjo te transformacije je to mogoče avtomatsko pri izvozu v ONNX, vendar je v 7. različici TensorRT ta težava rešena, tako da nam ostane le še malo čakati.
Zaključek
Ko sem začel uporabljati docker, sem imel dvome glede njegove zmogljivosti za moje naloge. V enem od mojih agregatov trenutno ustvarjam precejšen omrežni promet z več kamerami.
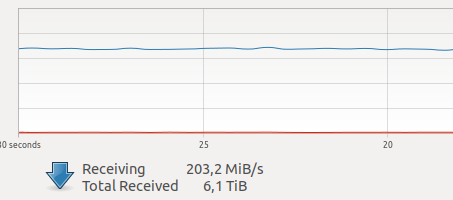
Različni testi na spletu so govorili o relativno visokem overhead-u pri omrežni interakciji in zapisovanju na VOLUME, poleg tega pa skrivnostni in strašni GIL, saj je zajemanje slike, delovanje gonilnika in prenos slike po omrežju atomske operacije v načinu hard real-time, zamude v omrežju so zame zelo kritične.
A vendar je vse uspelo =)
P.S. Ostaja le, da dodate svoj najljubši train loop za segmentacijo in v produkcijo!
Zahvale
Hvala skupnosti , brez nje ne bi bilo mogoče napredovati! Iskrena hvala , ki me je spodbudil k delu z DL, za njegove neprecenljive nasvete in izjemno profesionalnost!
V produkciji uporabljajte optimizirane modele!
 Aurorai, llc
Izvor: habr.com
