

Nadaljujemo s serijo člankov, posvečenih raziskovanju malo znanih načinov za izboljšanje zmogljivosti 'na videz preprostih' poizvedb v PostgreSQL:
Ne mislite, da tako zelo ne maram JOIN… 🙂
A pogosto je poizvedba brez njega opazno bolj zmogljiva, kot z njim. Zato si danes prizadevajmo znebiti se viška zahtevnega JOIN — s pomočjo slovarja.
Začnemo s PostgreSQL 12, kjer se lahko nekatere spodaj opisane situacije obnašajo nekoliko drugače zaradi . To vedenje je mogoče vrniti na prejšnje stanje z določanjem ključne besede
MATERIALIZED.
Veliko 'dejstev' o omejenem slovarju
Poglejmo precej realen praktičen problem — potrebno je prikazati seznam ali aktivnih nalog s pošiljatelji:
25.01 | Ivanov I.I. | Priprava opisa novega algoritma.
22.01 | Ivanov I.I. | Pisanje članka na Habr: življenje brez JOIN.
20.01 | Petrov P.P. | Pomoč pri optimizaciji poizvedbe.
18.01 | Ivanov I.I. | Pisanje članka na Habr: JOIN z upoštevanjem razporeditve podatkov.
16.01 | Petrov P.P. | Pomoč pri optimizaciji poizvedbe.
V abstraktnem svetu bi se avtorji nalog enakomerno porazdelili med vse zaposlene v naši organizaciji, toda v resnici naloge običajno prihajajo od precej omejenega števila ljudi — 'od vodstva' navzgor po hierarhiji ali 'od sodelavcev' iz sosednjih oddelkov (analitiki, oblikovalci, marketing, …).
Sprejmimo, da v naši organizaciji med 1000 ljudmi le 20 avtorjev (ponavadi še manj) postavlja naloge vsakemu konkretnemu izvajalcu in , da pospešimo 'tradicionalno' poizvedbo.
Generatorski skript
-- zaposleni
CREATE TABLE person AS
SELECT
  id
, repeat(chr(ascii('a') + (id % 26)), (id % 32) + 1) "name"
, '2000-01-01'::date - (random() * 1e4)::integer birth_date
FROM
  generate_series(1, 1000) id;

ALTER TABLE person ADD PRIMARY KEY(id);

-- naloge z določenim razporedom
CREATE TABLE task AS
WITH aid AS (
  SELECT
    id
  , array_agg((random() * 999)::integer + 1) aids
  FROM
    generate_series(1, 1000) id
  , generate_series(1, 20)
  GROUP BY
    1
)
SELECT
  *
FROM
  (
    SELECT
      id
    , '2020-01-01'::date - (random() * 1e3)::integer task_date
    , (random() * 999)::integer + 1 owner_id
    FROM
      generate_series(1, 100000) id
  ) T
, LATERAL(
    SELECT
      aids[(random() * (array_length(aids, 1) - 1))::integer + 1] author_id
    FROM
      aid
    WHERE
      id = T.owner_id
    LIMIT 1
  ) a;

ALTER TABLE task ADD PRIMARY KEY(id);
CREATE INDEX ON task(owner_id, task_date);
CREATE INDEX ON task(author_id);
Pokažemo zadnjih 100 nalog za določenega izvajalca:
SELECT
  task.*
, person.name
FROM
  task
LEFT JOIN
  person
    ON person.id = task.author_id
WHERE
  owner_id = 777
ORDER BY
  task_date DESC
LIMIT 100; 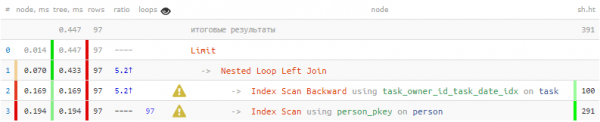
Получается, что 1/3 celotnega časa in 3/4 branj podatkov je bilo ustvarjenih le zato, da bi 100-krat poiskali avtorja — za vsak izpisan nalog. A vemo, da je med tema sto le 20 različnih — ne bi mogli izkoristiti tega znanja?
hstore-slovar
Iskoristimo za generiranje ‘slovarja’ ključ-vrednost:
CREATE EXTENSION hstoreV slovar zadostuje, da damo ID avtorja in njegovo ime, da bomo kasneje lahko po tem ključu izvlekli:
-- oblikujemo ciljno izbiro
WITH T AS (
  SELECT
    *
  FROM
    task
  WHERE
    owner_id = 777
  ORDER BY
    task_date DESC
  LIMIT 100
)
-- ustvarimo slovar za edinstvene vrednosti
, dict AS (
  SELECT
    hstore( -- hstore(keys::text[], values::text[])
      array_agg(id)::text[]
    , array_agg(name)::text[]
    )
  FROM
    person
  WHERE
    id = ANY(ARRAY(
      SELECT DISTINCT
        author_id
      FROM
        T
    ))
)
-- pridobimo povezane vrednosti slovarja
SELECT
  *
, (TABLE dict) -> author_id::text -- hstore -> klju
FROM
T; 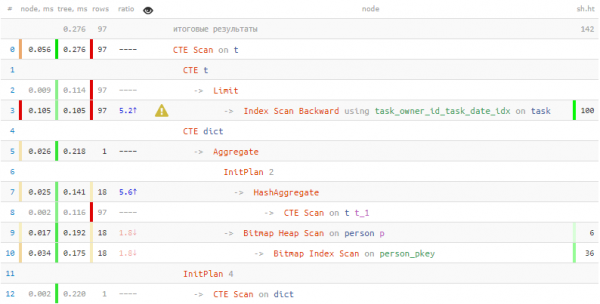
Za pridobitev informacij o osebah je porabljen 2-krat manj časa in 7-krat manj podatkov je bilo prebranih! Poleg ‘slovarjenja’ so nam pri teh rezultatih pomagali še masovni izvoz zapisov iz tabele v enem prehodu s pomočjo = ANY(ARRAY(...)).
Zapiski tabele: serializacija in deserializacija
Ampak kaj storiti, če želimo shraniti v slovar ne eno besedilno polje, ampak celoten zapis? V tem primeru nam pomaga sposobnost PostgreSQL delati z zapisom tabele kot z enotno vrednostjo:
...
, dict AS (
  SELECT
    hstore(
      array_agg(id)::text[]
    , array_agg(p)::text[] -- čarovnija #1
    )
  FROM
    person p
  WHERE
    ...
)
SELECT
  *
, (((TABLE dict) -> author_id::text)::person).* -- čarovnija #2
FROM
  T;
Poglejmo, kaj se je tu sploh dogajalo:
- Vzeli smo p kot alias za celoten zapis tabele person in jih zbirali v seznam.
- To je množica zapisov preoblikovana v niz besedilnih nizov (person[]::text[]), da jih lahko vključimo v hstore-slovar kot množico vrednosti.
- Pri pridobivanju povezanega zapisa ga smo potegnili iz slovarja po ključu kot besedilni niz.
- Besedilo moramo spremeniti v vrednost tipa tabele person (za vsako tabelo se samodejno ustvari ji enakovreden tip).
- »Razvili« smo tipizirani zapis v stolpce s pomočjo
(...).*.
json-slovarja
Toda tak trik, kot smo ga uporabili zgoraj, ne bo deloval, če ne obstaja ustrezen tabelarni tip, da bi naredili »preoblikovanje«. Enaka situacija se bo pojavila, če kot vir podatkov za serializacijo poskusimo uporabiti CTE niz, namesto »prave« tabele.
V tem primeru nam bodo pomagale :
...
, p AS ( -- to je že CTE
  IZBERI
    *
  IZ
    person
  KJER
    ...
)
, dict AS (
  IZBERI
    json_object( -- zdaj je to že json
      array_agg(id)::text[]
    , array_agg(row_to_json(p))::text[] -- in znotraj json za vsak niz
    )
  IZ
    p
)
IZBERI
  *
IZ
  T
, LATERAL(
    IZBERI
      *
    IZ
      json_to_record(
        ((TABLE dict) ->> author_id::text)::json -- izvlekli smo iz slovarja kot json
      ) AS j(name text, birth_date date) -- izpolnili smo potrebno strukturo
  ) j;
Treba je omeniti, da pri opisovanju ciljne strukture lahko naštejemo ne vseh polj izvornega niza, ampak le tiste, ki jih resnično potrebujemo. Če pa imamo »pravo« tabelo, je bolje uporabiti funkcijo json_populate_record.
Dostop do slovarja imamo še vedno enkraten, vendar stroški json-[de]serializacije so dovolj veliki., zato je smiselno uporabiti to metodo le v nekaterih primerih, ko »pošten« CTE Scan pokaže slabše rezultate.
Testiramo zmogljivost
Torej smo dobili dva načina serializacije podatkov v slovar — hstore / json_object. Poleg tega lahko tudi množice ključev in vrednosti pridobimo na dva načina, z notranjim ali zunanjim preoblikovanjem v tekst: array_agg(i::text) / array_agg(i)::text[].
Preverimo učinkovitost različnih vrst serializacije na povsem sintetičnem primeru — serializiramo različno število ključev:
WITH dict AS (
  IZBERI
    hstore(
      array_agg(i::text)
    , array_agg(i::text)
    )
  IZ
    generate_series(1, ...) i
)
TABLE dict;
Ocenski skript: serializacija
S S AS (
  SELECT
    *
  , (
      SELECT
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FROM
        (
          SELECT
            array_agg(el) ea
          FROM
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              WITH dict AS (
                SELECT
                  hstore(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FROM
                  generate_series(1, $$ || (1 << v) || $$) i
              )
              TABLE dict
            $$) T(el text)
        ) T
    ) et
  FROM
    generate_series(0, 19) v
  ,   LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
SELECT
  v
, avg(et)::numeric(32,3)
FROM
  T
GROUP BY
  1
ORDER BY
1; 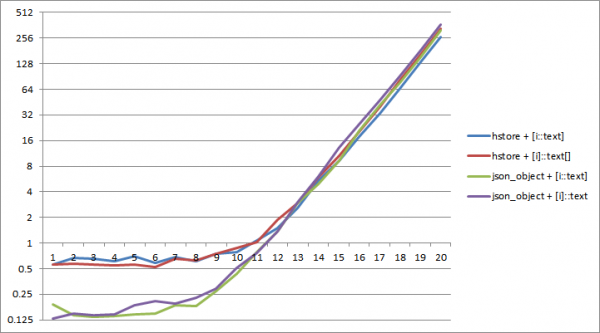
Na PostgreSQL 11 do približno 2^12 ključe. Serijalizacija u json zahteva manje vremena.. Najefikasnija kombinacija je json_object i "unutrašnje" konverzije tipova. array_agg(i::text).
Sada hajde da pokušamo da pročitamo vrednost svakog ključa 8 puta — jer ako se ne obraćamo rečniku, zašto bi nam bio potreban?
Procena skripte: čitanje iz rečnika.
S S AS (
  SELECT
    *
  , (
      SELECT
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      FROM
        (
          SELECT
            array_agg(el) ea
          FROM
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              WITH dict AS (
                SELECT
                  json_object(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                FROM
                  generate_series(1, $$ || (1 < (i % ($$ || (1 << v) || $$) + 1)::text
              FROM
                generate_series(1, $$ || (1 << (v + 3)) || $$) i
            $$) T(el text)
        ) T
    ) et
  FROM
    generate_series(0, 19) v
  , LATERAL generate_series(1, 7) i
  ORDER BY
    1, 2
)
SELECT
  v
, avg(et)::numeric(32,3)
FROM
  T
GROUP BY
  1
ORDER BY
1; 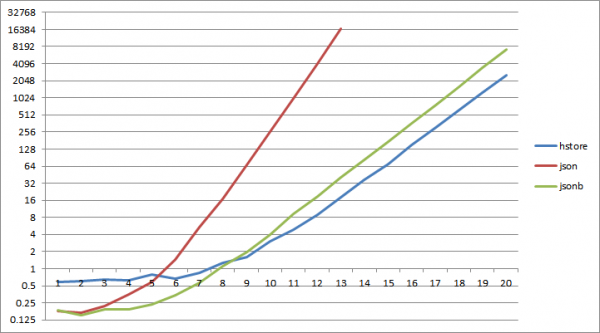
I… već približno prilikom 2^6 ključeva, čitanje iz json rečnika počinje značajno gubiti u odnosu na hstore, isto se dešava za jsonb pri 2^9.
Zaključci:
- ako trebate napraviti JOIN sa višestruko ponavljajućim zapisima — bolje je koristiti "osvežavanje" tabele.
- ako vaš rečnik očekivano mali i čitaćete iz njega malo — možete koristiti json[b].
- u svim ostalim slučajevima, hstore + array_agg(i::text) biće efikasnije.
Izvor: habr.com
