

Standard condition for implementing CI/CD in Kubernetes: the application must be able to stop accepting new client requests before its complete shutdown, and most importantly, successfully finish any existing requests.
Meeting this condition allows achieving zero downtime during deployment. However, even when using very popular stacks (like NGINX and PHP-FPM), one can encounter difficulties that lead to a surge of errors during each deployment...
Theory. How a pod lives
We have already published in detail about the lifecycle of a pod . In the context of the topic being discussed, we are interested in the following: at the moment when the pod transitions to the state Terminating, it stops receiving new requests (the pod is removed from the list of endpoints for the service). Thus, to avoid downtime during deployment, we just need to solve the problem of correctly shutting down the application.
It is also important to remember that the grace period by default is : after this, the pod will be terminated, and the application must manage to process all requests before this period. Napomena: although any request that takes more than 5-10 seconds is already problematic, and graceful shutdown will not help it...
To better understand what happens when a pod shuts down, it is sufficient to study the following scheme:
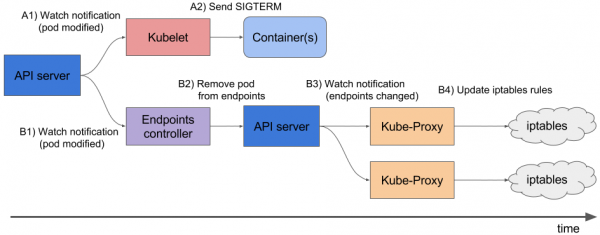
A1, B1 — Receiving changes on the state of the pod
A2 — Sending SIGTERM
B2 — Removing the pod from the endpoints
B3 — Receiving changes (the list of endpoints has changed)
B4 — Updating iptables rules
Note: the removal of the pod endpoint and sending SIGTERM do not happen sequentially, but in parallel. Because the Ingress does not immediately receive the updated list of endpoints, new requests from clients will still be sent to the pod, resulting in 500 errors during the pod's termination. (a more detailed resource on this topic we ). This issue needs to be addressed in the following ways:
- Send Connection: close in the response headers (if this concerns an HTTP application).
- If it's not possible to make changes to the code, the article describes a solution that allows processing requests until the end of the graceful period.
Theory. How NGINX and PHP-FPM terminate their processes
NGINX
Začnimo z NGINX, saj je s tem vse bolj ali manj jasno. Ko se poglobimo v teorijo, izvemo, da ima NGINX en glavni proces in več «delavcev» — to so podrejeni procesi, ki obdelujejo zahteve strank. Predvidena je priročna možnost: z ukazom nginx -s lahko zaključimo procese bodisi v načinu hitrega zaključka bodisi v načinu postopnega zaključka. Očitno nas zanima ravno drugi način.
Nato je vse preprosto: potrebno je dodati v ukaz, ki bo poslal signal za postopni zaključek. To lahko storimo v razdelku Deployment, v bloku kontejnerja:
       lifecycle:
          preStop:
            exec:
              command:
              - /usr/sbin/nginx
              - -s
              - quit
Zdaj bomo v trenutku zaključevanja delovanja pod'a v dnevnikih kontejnerja NGINX videli naslednje:
2018/01/25 13:58:31 [notice] 1#1: signal 3 (SIGQUIT) received, shutting down
2018/01/25 13:58:31 [notice] 11#11: gracefully shutting down
In to bo pomenilo tisto, kar potrebujemo: NGINX čaka na dokončanje obdelave zahtev, po čemer ubije proces. Vendar pa bo spodaj obravnavana pogosta težava, zaradi katere tudi ob prisotnosti ukaza nginx -s quit postopek ne zaključuje pravilno.
Na tej točki smo zaključili z NGINX: najmanj po dnevnikih lahko ugotovimo, da vse deluje tako, kot bi moralo.
Kako pa je s PHP-FPM? Kako obdeluje postopni zaključek? Poglejmo.
PHP-FPM
Pri PHP-FPM je informacij nekoliko manj. Če se opiramo na o PHP-FPM, bo opisano, da se sprejemajo naslednji POSIX signali:
-
SIGINT,SIGTERM— hitri zaključek; -
SIGQUIT— postopni zaključek (to, kar potrebujemo).
Ostali signali v tej nalogi niso potrebni, zato se njihove obravnave ne bomo dotaknili. Za pravilno zaključitev procesa bo potrebno napisati naslednji preStop-hook:
        lifecycle:
          preStop:
            exec:
              command:
              - /bin/kill
              - -SIGQUIT
              - "1"
Na prvi pogled je to vse, kar je potrebno za izvedbo postopnega zaključka v obeh kontejnerjih. Vendar pa je naloga bolj zapletena, kot se zdi. V nadaljevanju so obravnavani dva primera, v katerih postopni zaključek ni deloval in je povzročil kratkotrajno nedostopnost projekta med namestitvijo.
Praksa. Možne težave s postopnim zaključkom
NGINX
Najprej je koristno vedeti: poleg izvajanja ukaza nginx -s quit Obstaja še ena faza, na katero je vredno opozoriti. Soočili smo se s težavo, ko je NGINX namesto signala SIGQUIT vseeno poslal SIGTERM, zaradi česar se zahteve niso zaključile pravilno. Podobni primeri se lahko najdejo, na primer, . Na žalost nismo uspeli ugotoviti konkretnega razloga za takšno vedenje: bili smo v sumu, da gre za različice NGINX, a to se ni potrdilo. Simptomatika pa je bila taka, da so se v logih NGINX kontejnerja pojavljale naslednje sporočila «open socket #10 left in connection 5», po čemer se pod ustavi.
Takšno težavo lahko opazimo, na primer, pri odgovorih na našem Ingressu:
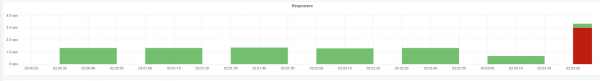
Kazalniki statusnih kod v trenutku pravljenja objave
V tem primeru dobimo prav 503 kod napake od samega Ingressa: ne more se obrniti na kontejner NGINX, saj ta že ni na voljo. Če pogledamo v loge kontejnerja z NGINX, v njih je naslednje:
[alert] 13939#0: *154 open socket #3 left in connection 16
[alert] 13939#0: *168 open socket #6 left in connection 13
Po spremembi stop signala se kontejner začne ustavljati pravilno: to potrjuje dejstvo, da napake 503 več ne opazimo.
Če ste se srečali s podobno težavo, je smiselno raziskati, kateri stop signal se uporablja v kontejnerju in kako točno izgleda preStop-hook. Povsem možno je, da je razlog prav v tem.
PHP-FPM… in ne samo to
Težava s PHP-FPM je opisana preprosto: ne čaka na zaključek otroških procesov, jih terminira, zaradi česar med objavo in drugimi operacijami nastajajo 502 napake. Na bugs.php.net obstaja od leta 2005 več sporočil o napakah (na primer, in ), ki opisujejo to težavo. V logih pa verjetno ne boste opazili ničesar: PHP-FPM bo objavil zaključek svojega procesa brez kakršnih koli napak ali zunanjih obvestil.
Upoštevajte, da je sama težava lahko v manjši ali večji meri odvisna od same aplikacije in se morda ne bo pokazala, na primer, v monitoringu. Če se z njo vseeno srečate, na misel najprej pride preprosta rešitev: dodajte preStop-hook s sleep(30). To bo omogočilo zaključek vseh zahtev, ki so bile do tega trenutka (novih ne sprejemamo, ker je pod treba da postoji stek. Ali "mi praktičari: sve nam funkcioniše, ali niko ne zna zašto…". v stanju Terminating), po preteku 30 sekund pa se sam pod zaključi s signalom SIGTERM.
Получается, что lifecycle za kontejner bo videti takole:
    lifecycle:
      preStop:
        exec:
          command:
          - /bin/sleep
          - "30"
Vendar pa zaradi določene 30-sekundne sleep mi močno pod će se terminirati, pa ćemo povećati vreme implementacije minimum 30 sekundi, što nije dobro. Šta se može učiniti povodom toga?
Obratimo se strani koja je odgovorna za direktno izvršenje aplikacije. U našem slučaju, to je PHP-FPM, ki po defaultu ne prati izvršenje svojih child-procesa: master-proces se odmah terminira. Ovo ponašanje se može promeniti pomoću diksive process_control_timeout, koja postavlja vremenske limite za čekanje signala od mastera od strane child-procesa. Ako postavite vrednost na 20 sekundi, većina zahteva koji se izvršavaju u kontejneru biće pokriveni i nakon njihovog završetka master-proces će biti zaustavljen.
Sa ovim znanjem, vratimo se našem poslednjem problemu. Kao što je već pomenuto, Kubernetes nije monolitna platforma: interakcija između njenih različitih komponenti zahteva određeno vreme. Ovo je posebno važno kada razmatramo rad Ingress-a i drugih povezanih komponenti, jer zbog ove latencije tokom implementacije lako može doći do porasta 500 grešaka. Na primer, greška se može javiti u fazi slanja zahteva upstream-u, ali sama "vremenska razlika" u interakciji između komponenti je prilično kratka — manje od jedne sekunde.
Zato, zajedno sa već pomenutom direktivom process_control_timeout može se koristiti sledeća konstrukcija za lifecycle:
lifecycle:
  preStop:
    exec:
      command: ["/bin/bash","-c","/bin/sleep 1; kill -QUIT 1"]
U tom slučaju kompenzujemo kašnjenje ovom komandom sleep i drastično ne povećavamo vreme implementacije: vidljiva je razlika između 30 sekundi i jedne?.. U suštini „glavni posao“ preuzima process_control_timeout, a lifecycle koristi se samo kao „osiguranje“ u slučaju kašnjenja.
Na splošno opisana ponašanja i odgovarajući workaround ne odnose se samo na PHP-FPM. Slična situacija može se pojaviti na sličan način prilikom korišćenja drugih programskih jezika/framework-ova. Ako ne možete na druge načine ispraviti graceful shutdown — na primer, prepisati kod tako da aplikacija ispravno obrađuje signale za završavanje — možete primeniti opisani pristup. Možda nije najlepši, ali funkcioniše.
Praksa. Opterećujuće testiranje za proveru rada pod-a
Testiranje opterećenja je jedan od načina provere kako kontejner funkcioniše, jer ova procedura simulira realne borbene uslove kada posetioci dolaze na sajt. Za testiranje gore navedenih preporuka možete iskoristiti : on savršeno pokriva sve naše potrebe. U nastavku su navedeni saveti i preporuke za sprovođenje testiranja sa vizualnim primerom — zahvaljujući grafikonima Grafana i samom Yandex.Tank-u — iz našeg iskustva.
Najvažnije ovde je proveravati promene postepeno. Nakon dodavanja novog ispravka, pokrenite testiranje i proverite da li su se rezultati promenili u odnosu na prethodno pokretanje. U suprotnom, biće neprikladno identifikovati neefikasna rešenja, a dugoročno može čak i naštetiti (na primer, povećati vreme implementacije).
Još jedan detalj — proverite logove kontejnera tokom njegove terminacije. Da li se tamo beleži informacija o graceful shutdown? Postoje li u logovima greške prilikom pristupanja drugim resursima (na primer, susednom kontejneru PHP-FPM)? Greške same aplikacije (kao u prethodno pomenutom slučaju sa NGINX)? Nadam se da će uvodne informacije iz ovog članka pomoći da bolje razumete šta se dešava sa kontejnerom prilikom njegove terminacije.
Dakle, prvo pokretanje testiranja se odvijalo bez lifecycle i bez dodatnih direktiva za server aplikacija (process_control_timeout u PHP-FPM). Cilj ovog testa je bio otkrivanje približnog broja grešaka (i da li ih uopšte ima). Takođe, iz dodatnih informacija, srednje vreme implementacije svakog poda iznosilo je oko 5-10 sekundi do stanja potpune spremnosti. Rezultati su sledeći:
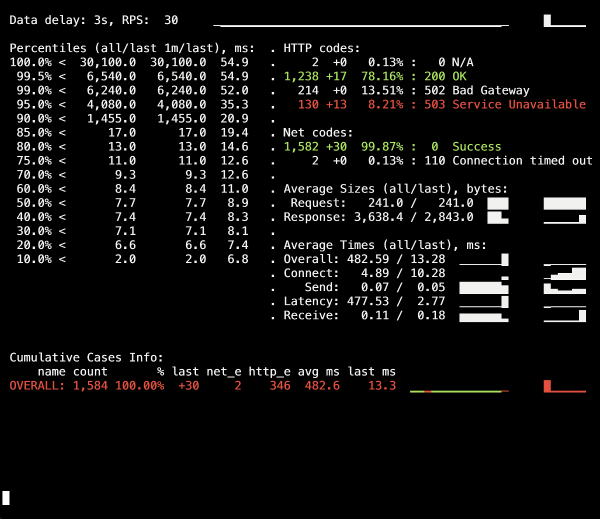
Na informativnoj tabli Yandex.Tank-a vidljiv je porast 502 grešaka, koji se dogodio tokom implementacije i trajao je u proseku do 5 sekundi. Pretpostavlja se da su to bili prekinuti postojeći zahtevi na starom podu dok je terminacija bila u toku. Nakon toga pojavile su se 503 greške, što je rezultat zaustavljenog NGINX kontejnera, koji je takođe prekinuo veze zbog backend-a (zbog čega se Ingress nije mogao povezati).
Pogledajmo kako process_control_timeout u PHP-FPM može da nam pomogne da sačekamo završetak child-procesa, tj. da ispravimo takve greške. Ponovna implementacija već sa ovom direktivom:
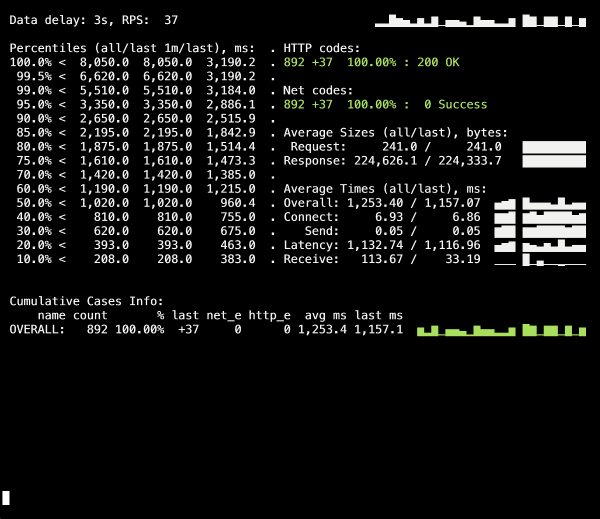
Med izvajanjem ni več 500-ih napak! Izvajanje poteka uspešno, graceful shutdown deluje.
Vendar pa velja opozoriti na trenutek z Ingress-kontejnerji, manjšega odstotka napak, ki jih lahko prejmemo zaradi začasnega zakasnitve. Da bi se temu izognili, je treba dodati konstrukcijo z sleep in ponoviti izvajanje. Vendar pa v našem konkretnem primeru sprememb ni bilo opaziti (napak znova ni).
Zaključek
Za pravilno zaključitev procesa pričakujemo od aplikacije naslednje obnašanje:
- Pričakovati nekaj sekund, po katerih ne sme sprejemati novih povezav.
- Počakati na zaključek vseh zahtev in zapreti vse keepalive povezave, ki ne opravljajo zahtev.
- Zaključiti svoj proces.
Vendar pa ne morejo vse aplikacije ravnati na tak način. Eno od rešitev problema v realnostih Kubernetes je:
- dodajanje pre-stop hooka, ki bo počakal nekaj sekund;
- preučitev konfiguracijske datoteke našega backend-a glede ustreznih parametrov.
Primer z NGINX omogoča razumevanje, da tudi aplikacija, ki bi morala pravilno obdelati signale za zaključek, tega morda ne bo storila, zato je kritično preveriti prisotnost 500 napak med izvajanjem aplikacije. To omogoča tudi širši pogled na problem in ne osredotočanje le na posamezen pod ali kontejner, temveč na celotno infrastrukturo.
Kot orodje za testiranje lahko uporabite Yandex.Tank skupaj z katerim koli sistemom za spremljanje (v našem primeru so bile za test pridobljene podatke iz Grafane z backend-om v obliki Prometheus). Problemi z graceful shutdown so dobro vidni pri velikih obremenitvah, ki jih lahko ustvari benchmark, spremljanje pa pomaga podrobneje razjasniti situacijo med ali po testu.
Odgovarjajoč na povratne informacije o članku: je treba omeniti, da so tukaj opisani problemi in načini njihove rešitve v povezavi z NGINX Ingress. Za druge primere obstajajo drugačne rešitve, ki jih morda obravnavamo v prihodnjih materialih cikla.
P.S.
Još jedan iz serije K8s saveta & trikova:
- «»;
- «»;
- «»;
- «».
Izvor: habr.com
