

Pred nekaj meseci — javno k PostgreSQL.
V preteklem času ste ga že uporabili več kot 6000-krat, toda ena izmed priročnih funkcij je morda ostala neopažena — to so strukturni namigi, ki izgledajo približno tako:
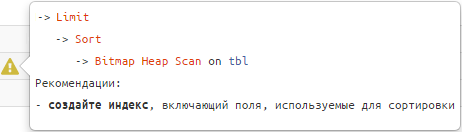
Sledite jim in vaše poizvedbe bodo "gladke in svilnate". 🙂
Če pa govorimo resno, številne situacije, ki poizvedbo upočasnijo in naredijo "umuljne" z vidika virov, so tipične in jih je mogoče prepoznati po strukturi in podatkih načrta.
V tem primeru se ne bo treba vsakemu posameznemu razvijalcu ukvarjati z iskanjem možnosti optimizacije samemu, zanašajoč se zgolj na svoje izkušnje — lahko mu pomagamo, da povemo, kaj se dogaja, kakšen je lahko vzrok, in kako pristopiti k rešitvi. Kar smo tudi storili.
Poglejmo to nekoliko podrobneje — kako jih določamo in do katerih priporočil vodijo.
Za boljše razumevanje tematike lahko najprej poslušate ustrezen del iz , nato pa preidite na podrobno analizo vsakega primera:
#1: индексная «недосортировка»
Ko nastane
Prikaz zadnjega računa za stranko „OOO Kolokolčik“.
Kako prepoznati
-> Limit
   -> Sort
      -> Index [Only] Scan [Backward] | Bitmap Heap Scan
Priporočila
Uporabljeni indeks razširiti z razvrstitvenimi polji.
Primer:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "dejstev"
, (random() * 1000)::integer fk_cli; -- 1K različnih zunanjih ključev

CREATE INDEX ON tbl(fk_cli); -- indeks za tuji ključ

SELECT
  *
FROM
  tbl
WHERE
  fk_cli = 1 -- izbira po posebni povezavi
ORDER BY
  pk DESC -- želimo samo eno "zadnjo" vnos
LIMIT 1; 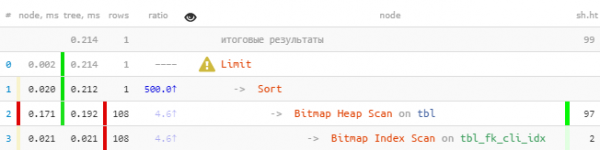
Takoj lahko opazimo, da je bilo iz indeksa prebrano več kot 100 zapisov, ki so nato vsi razvrščeni, in obdržan je bil le en.
Odpravimo:
DROP INDEX tbl_fk_cli_idx;
CREATE INDEX ON tbl(fk_cli, pk DESC); -- dodali smo ključ za razvrščanje
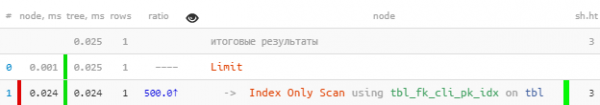
Tudi na taki preprosti izbiri — 8,5-krat hitreje in 33-krat manj branj. Učinek bo toliko bolj očiten, čim več imate "dejstev" za vsako vrednost fk.
Opažam, da bo tak indeks deloval kot "prefiksni" vsaj tako dobro kot prejšnji in pri drugih poizvedbah z fk, kjer razvrščanja po pk ni bilo in ni (več o tem si lahko preberete ). Vključno s tem bo zagotovil tudi normalno podporo za jasne tuje ključe po tem polju.
#2: пересечение индексов (BitmapAnd)
Ko nastane
Показати всі договори по клієнту «ТОВ Дзвоник», укладені від імені «НАО Лютик».
Kako prepoznati
-> BitmapAnd
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Priporočila
Kreirati композитний індекс по полям з обох вихідних або розширити один із існуючих полями з другого.
Primer:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk      -- 100K "фактів"
, (random() *  100)::integer fk_org  -- 100 різних зовнішніх ключів
, (random() * 1000)::integer fk_cli; -- 1K різних зовнішніх ключів

CREATE INDEX ON tbl(fk_org); -- індекс для foreign key
CREATE INDEX ON tbl(fk_cli); -- індекс для foreign key

SELECT
  *
FROM
  tbl
WHERE
(fk_org, fk_cli) = (1, 999); -- відбір по конкретній парі 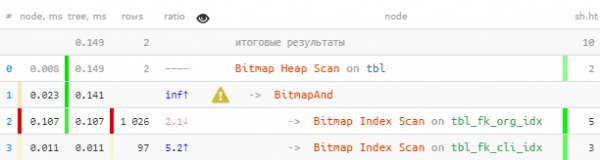
Odpravimo:
DROP INDEX tbl_fk_org_idx;
CREATE INDEX ON tbl(fk_org, fk_cli);
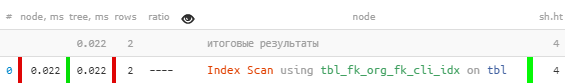
Тут виграш менший, оскільки Bitmap Heap Scan знайшов час для ефективної роботи. Але все ж в 7 разів швидше і в 2.5 рази менше зчитувань.
#3: объединение индексов (BitmapOr)
Ko nastane
Показати перші 20 найстаріших «своїх» або неназначених заявок для обробки, причому свої в пріоритеті.
Kako prepoznati
-> BitmapOr
   -> Bitmap Index Scan
   -> Bitmap Index Scan
Priporočila
Uporabite UNION [ALL] для об’єднання підзапитів за кожним із блоків OR умов.
Primer:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk  -- 100K "фактів"
, CASE
    WHEN random() < 1::real/16 THEN NULL -- з ймовірністю 1:16 запис "нічиї"
    ELSE (random() * 100)::integer -- 100 різних зовнішніх ключів
  END fk_own;

CREATE INDEX ON tbl(fk_own, pk); -- індекс з "схожою" сортировкою

SELECT
  *
FROM
  tbl
WHERE
  fk_own = 1 OR -- свої
  fk_own IS NULL -- ... або "нічиї"
ORDER BY
  pk
, (fk_own = 1) DESC -- спочатку "свої"
LIMIT 20;
Odpravimo:
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own = 1 -- спочатку "свої" 20
  ORDER BY
    pk
  LIMIT 20
)
UNION ALL
(
  SELECT
    *
  FROM
    tbl
  WHERE
    fk_own IS NULL -- потім "нічиї" 20
  ORDER BY
    pk
  LIMIT 20
)
LIMIT 20; -- але всього - 20, більше й не потрібно 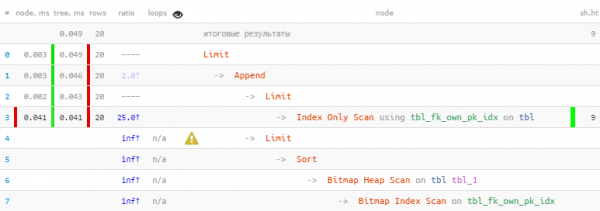
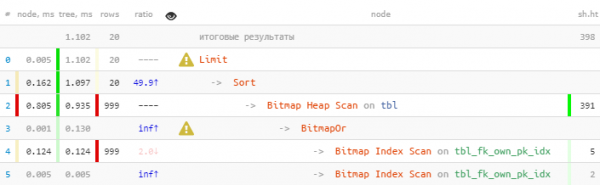
Ми скористалися тим, що всі 20 потрібних записів були одразу отримані вже в першому блоці, тому другий, з більш «дорожчим» Bitmap Heap Scan, навіть не виконувався — в підсумку в 22 рази швидше, в 44 рази менше зчитувань!
Більш детальна розповідь про цей спосіб оптимізації на конкретних прикладах можна прочитати в статтях in .
Узагальнений варіант упорядкованого відбору за кількома ключами (а не тільки за парою const/NULL) розглянуто в статті .
#4: читаем много лишнего
Ko nastane
Як правило, виникає при бажанні «додати ще один фільтр» до вже існуючого запиту.
«А у вас немає такого ж, але з перламутровими гудзиками?» х/ф «Брильянтова рука»
Наприклад, модифікуючи задачу вище, показати перші 20 найстаріших «критичних» заявок для обробки, незалежно від їх призначення.
Kako prepoznati
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && 5 × rows 80% прочитанного
   && loops × RRbF > 100 -- и при этом больше 100 записей суммарно
Priporočila
Создать [более] специализированный индекс s WHERE-условием или включить в индекс дополнительные поля.
Если условие фильтрации является «статичным» для ваших задач — то есть не предполагает расширения перечня значений в будущем — лучше использовать WHERE-индекс. В эту категорию хорошо укладываются разные boolean/enum-статусы.
Если же условие фильтрации может принимать разные значения, то лучше расширить индекс этими полями — как в ситуации с BitmapAnd выше.
Primer:
CREATE TABLE tbl AS
SELECT
  generate_series(1, 100000) pk -- 100K "фактов"
, CASE
    WHEN random() < 1::real/16 THEN NULL
    ELSE (random() * 100)::integer -- 100 разных внешних ключей
  END fk_own
, (random() < 1::real/50) critical; -- 1:50, что заявка "критичная"

CREATE INDEX ON tbl(pk);
CREATE INDEX ON tbl(fk_own, pk);

SELECT
  *
FROM
  tbl
WHERE
  critical
ORDER BY
  pk
LIMIT 20; 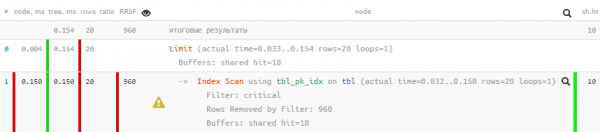
Odpravimo:
CREATE INDEX ON tbl(pk)
  WHERE critical; -- добавили "статичное" условие фильтрации
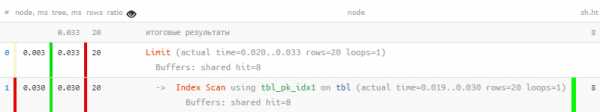
Как видим, фильтрация из плана полностью ушла, а запрос стал в 5 раз быстрее.
#5: разреженная таблица
Ko nastane
Разнообразные попытки сделать собственную очередь обработки задач, когда большое количество обновлений/удалений записей на таблице приводят к ситуации большого количества «мертвых» записей.
Kako prepoznati
-> Seq Scan | Bitmap Heap Scan | Index [Only] Scan [Backward]
   && loops × (rows + RRbF)  64
Priporočila
Регулярно вручную проводить VACUUM [FULL] или добиться адекватно частой отработки с помощью тонкой настройки его параметров, в том числе .
В большинстве случаев подобные проблемы оказываются вызваны плохой компоновкой запросов при вызовах с бизнес-логики вроде тех, которые были рассмотрены в .
Но надо понимать, что даже VACUUM FULL может помочь не всегда. Для таких случаев стоит ознакомиться с алгоритмом из статьи .
#6: чтение с «середины» индекса
Ko nastane
Вроде и прочитали немного, и все по индексу, и никого лишнего не фильтровали — а все равно прочитано существенно больше страниц, чем хотелось бы.
Kako prepoznati
-> Index [Only] Scan [Backward]
   && loops × (rows + RRbF)  64
Priporočila
Pozorno preglejte strukturo uporabljenega indeksa in ključna polja, določena v poizvedbi — verjetno, del indeksa ni določen. Verjetno boste morali ustvariti podoben indeks, vendar brez predpona polj ali .
Primer:
USTVARI TABELO tbl AS
IZBERI
  generate_series(1, 100000) pk      -- 100K "dejstev"
, (random() *  100)::integer fk_org  -- 100 različnih zunanjih ključev
, (random() * 1000)::integer fk_cli; -- 1K različnih zunanjih ključev

USTVARI INDeks NA tbl(fk_org, fk_cli); -- vse skoraj kot v #2
-- le ta ločen indeks po fk_cli smo že ocenili za odvečen in ga odstranili

IZBERI
  *
IZ
  tbl
KJER
  fk_cli = 999 -- fk_org pa ni določen, čeprav je prej v indeksu
LIMIT 20; 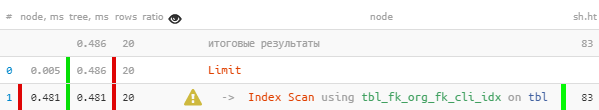
Zdi se, da je vse v redu, celo po indeksu, vendar je nekako sumljivo — za vsako od 20 prebranih zapisov je bilo treba prebrati 4 strani podatkov, 32KB na zapis — ali ni preveč? Tudi ime indeksa tbl_fk_org_fk_cli_idx spodbuja razmišljanje.
Odpravimo:
USTVARI INDeks NA tbl(fk_cli); 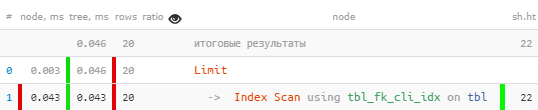
Nenadoma — 10-krat hitreje in 4-krat manj brati.!
Druge primere neučinkovite rabe indeksov lahko vidite v članku .
#7: CTE × CTE
Ko nastane
V poizvedbi smo sestavili "debela" CTE iz različnih tabel, nato pa smo se odločili, da jih povežemo JOIN.
Primer je relevanten za različice pod v12 ali poizvedbe z S MATERIALIZIRANO.
Kako prepoznati
-> CTE Scan
   && zanke > 10
   && zanke × (vrstice + RRbF) > 10000
      -- prevelik kartesian izdelek CTE
Priporočila
Temeljito analizira poizvedbo — ali ? Если все-таки да, то uporabi "slovarstvo" v hstore/json po modelu, opisanem v .
#8: swap на диск (temp written)
Ko nastane
Enkratna obdelava (sortiranje ali unikatizacija) velikega števila zapisov ne vstopa v dodeljeno pomnilnik za to.
Kako prepoznati
-> *
   && začasno zapisano > 0
Priporočila
Če uporabljena količina pomnilnika operaciji ne presega nastavljene vrednosti parametra , je smiselno, da jo prilagodite. Lahko takoj v konfiguraciji za vse, ali pa prek SET [LOCAL] za določeno poizvedbo/transakcijo.
Primer:
PREDSTAVITE work_mem;
-- "16MB"

IZBERI
  random()
IZ
  generate_series(1, 1000000)
NAROČILNO
1; 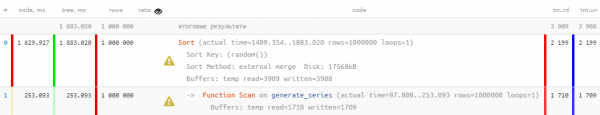
Odpravimo:
SET work_mem = '128MB'; -- pred izvedbo poizvedbe 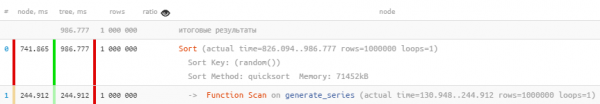
Iz jasnih razlogov, če se uporablja samo pomnilnik, ne pa disk, se bo poizvedba izvajala veliko hitreje. Pri tem se tudi del obremenitve s HDD odstrani.
Vendar je treba razumeti, da dodelitev preveč pomnilnika nikoli ne bo možna — preprosto ga ne bo dovolj za vse.
#9: неактуальная статистика
Ko nastane
V zbirko podatkov so vnesli kar precej, vendar niso uspeli opraviti ANALYZE.
Kako prepoznati
-> Sec Scan | Bitmap Heap Scan | Indeks [Samo] Scan [Nazaj]
   && razmerje >> 10
Priporočila
Opraviti. ANALYZE.
Več informacij o tem je zapisano v .
#10: «что-то пошло не так»
Ko nastane
Prišlo je do čakanja na zaklep, ki ga je nalagal konkurenčni poizvedbi, ali pa so primanjkovali strojnih virov CPU/hypervisorja.
Kako prepoznati
-> *
   && (shared hit / 8K) + (shared read / 1K) < time / 1000
      -- RAM hit = 64MB/s, HDD read = 8MB/s
   && time > 100ms -- brali smo malo, vendar predolgo
Priporočila
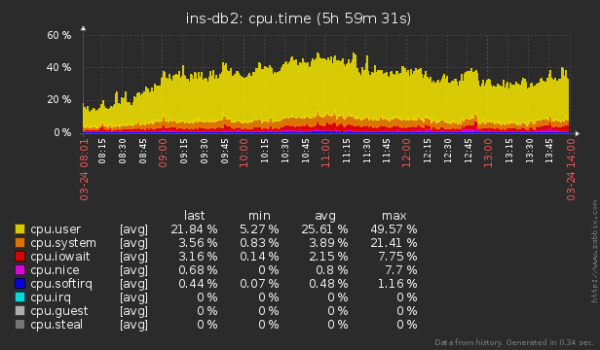
Uporabite zunanji sistem za spremljanje strežnikov glede na prisotnost zaklepov ali nenormalne porabe virov. O našem načrtu organizacije tega procesa za stotine strežnikov smo že poročali in .
Izvor: habr.com
