

S številnimi se srečuje Elasticsearch. Kaj se zgodi, ko želiš z njegovo pomočjo shranjevati dnevniške datoteke „v izredno velikem obsegu“? In kako brez težav prestati odpoved kateregakoli od več podatkovnih centrov? Kakšna arhitektura bi morala biti, in na katere pasti lahko naletiš?
V Odnoklassniki smo se odločili, da bomo s pomočjo Elasticsearch rešili vprašanje upravljanja dnevnikov, zdaj pa delimo izkušnje s Habr: tako o arhitekturi kot o pastih.
Jaz sem Pjotr Zajevcev, delam kot sistemski administrator v Odnoklassniki. Pred tem sem bil tudi administrator, delal sem z Manticore Search, Sphinx Search, Elasticsearch. Morda, če se pojavi še kakšen …search, bom verjetno delal tudi z njim. Prav tako sodelujem v več odprtokodnih projektih prostovoljno.
Ko sem prišel v Odnoklassniki, sem nepreudarno dejal na razgovoru, da znam delati z Elasticsearch. Ko sem se ustalil in opravil nekaj preprostih nalog, so mi dali veliko nalogo o reformi sistema upravljanja dnevnikov, ki je obstoja takrat.
Zahteve
Zahteve glede sistema so bile formulirane na naslednji način:
- Kot frontend je moral biti uporabljen Graylog. Zato, ker je podjetje že imelo izkušnje z uporabo tega izdelka, so ga programerji in testni inženirji poznali, bil jim je znan in udoben.
- Količina podatkov: povprečno 50-80 tisoč sporočil na sekundo, vendar pa, če pride do napake, ni nobenih omejitev prometa, lahko je to 2-3 milijone vrstic na sekundo.
- Ko smo razpravljali o zahtevah naročnikov glede hitrosti obdelave iskalnih poizvedb, smo ugotovili, da je tipičen vzorec uporabe takega sistema takšen: ljudje iščejo dnevnike svojih aplikacij za zadnja dva dni in ne želijo čakati na rezultat formulirane poizvedbe več kot eno sekundo.
- Administratori so vztrajali pri tem, da se mora sistem po potrebi enostavno razširiti, ne da bi od njih zahteval globoko razumevanje, kako deluje.
- Da je edina naloga vzdrževanja, ki so jo ti sistemi občasno potrebovali, zamenjati kakšno strojno opremo.
- Poleg tega v Odnoklassniki obstaja čudovita tehnična tradicija: katerikoli servis, ki ga zaženemo, mora prenesti odpoved podatkovnega centra (nenadno, nepričakovano in kadarkoli).
Zadnji zahtjev za implementaciju ovog projekta bio je najteži za nas, o čemu ću još pričati detaljnije.
Okruženje
Radimo na četiri data centra, pri čemu se data čvorovi Elasticsearch mogu nalaziti samo u tri (iz niza netehničkih razloga).
U ovim četiri data centra se nalazi otprilike 18.000 različitih izvora logova — hardver, kontejneri, virtualne mašine.
Važna karakteristika: pokretanje klastera odvija se u kontejnerima ne na fizičkim mašinama, već na . Kontejnerima se garantiraju 2 jezgra, slična 2.0Ghz v4, s mogućnošću korišćenja ostalih jezgara u slučaju da su neaktivna.
Drugim rečima:
Topologija
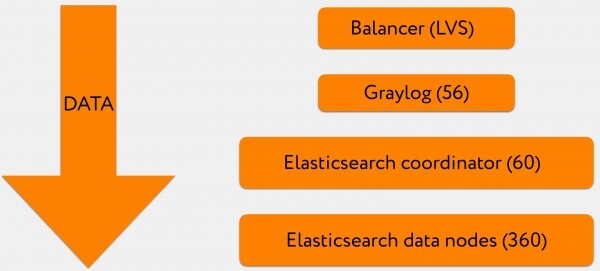
Opšti izgled rešenja mi se isprva video ovako:
- 3-4 VIP adrese su iza A-recorda domena Graylog, to je adresa na koju se šalju logovi.
- svaki VIP predstavlja balansirnik LVS.
- Nakon njega, logovi dolaze do baterije Graylog, deo podataka ide u GELF formatu, deo u syslog formatu.
- Dalje se sve ovo u velikim serijama zapisuje u bateriju koordinatorskih čvorova Elasticsearch.
- Oni, s druge strane, šalju zahteve za upis i čitanje relevantnim data čvorovima.
Terminologija
Možda svi nisu detaljno upoznati sa terminologijom, pa bih se želeo malo zadržati na tome.
U Elasticsearch-u postoji nekoliko tipova čvorova — master, coordinator, data node. Postoje i dva druga tipa za različite transformacije logova i povezivanje različitih klastera, ali smo koristili samo one navedene.
Master
Pinguje sve prisutne čvorove u klasteru, održava ažuriranu mapu klastera i širi je između čvorova, obrađuje event logiku, bavi se različitim vrstama cluster wide posla.
Coordinator
Obavlja jednu jedinu zadatak: prihvata zahteve klijenata za čitanje ili upis i usmerava ovaj promet. U slučaju da je zahtev za upis, verovatno će pitati master u koji shard relevantnog indeksa da ga smesti i preusmeriti zahtev dalje.
Data node
Čuva podatke, izvršava pretraživačke zahteve koji dolaze spolja i operacije nad shardovima koji se na njoj nalaze.
Graylog
To je nekakšna mešanica Kibane in Logstasha v ELK-steku. Graylog združuje tako uporabniški vmesnik kot tudi obdelovalni sistem za vrste dnevniških zapisov. V ozadju Grayloga delujeta Kafka in Zookeeper, ki zagotavljata povezljivost Grayloga kot klasterja. Graylog lahko predpomni dnevniške zapise (Kafka) v primeru, da Elasticsearch ni na voljo, in ponavlja neuspele poizvedbe za branje in pisanje ter grupira in označuje dnevniške zapise po določenih pravilih. Kot Logstash ima Graylog funkcionalnost za spreminjanje nizov pred zapisovanjem v Elasticsearch.
Poleg tega Graylog vključuje vgrajeno odkrivanje storitev, ki na podlagi ene dostopne vozlišča Elasticsearch pridobi celotno karto klasterja in jo filtrira po določenem označevalcu, kar omogoča usmerjanje poizvedb na določene kontejnere.
Vizualno to izgleda nekako tako:

To je posnetek zaslona iz določene instance. Tukaj gradimo histogram na podlagi iskalnega poizvedovanja in prikazujemo relevantne nize.
Indeksi
Ko se vračamo k arhitekturi sistema, bi rad podrobneje opisal, kako smo zgradili model indeksov, da je vse delovalo pravilno.
Na prej prikazani shemi je to najnižja raven: Elasticsearch podatkovni vozli.
Indeks je velika virtualna entiteta, sestavljena iz shardov Elasticsearch. Vsak od shardov je v resnici nič drugega kot Lucene indeks. Vsak Lucene indeks pa je sestavljen iz enega ali več segmentov.
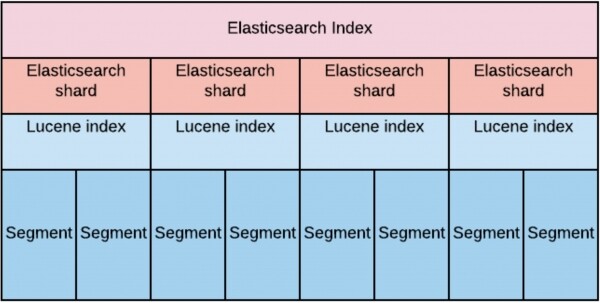
Pri načrtovanju smo upoštevali, da moramo za zagotavljanje zahtev po hitrosti branja na velikih količinah podatkov enakomerno 'razporediti' te podatke po podatkovnih vozli.
To se je izkazalo tako, da mora biti število shardov na indeks (s podvoji) strogo enako številu podatkovnih vozli. Prvič, da se zagotovi faktor replikacije, ki je enak dvema (to pomeni, da lahko izgubimo polovico klasterja). In drugič, da se poizvedbe za branje in pisanje obdelujejo vsaj na polovici klasterja.
Čas shranjevanja smo najprej določili na 30 dni.
Porazdelitev shardov lahko grafično prikažemo takole:
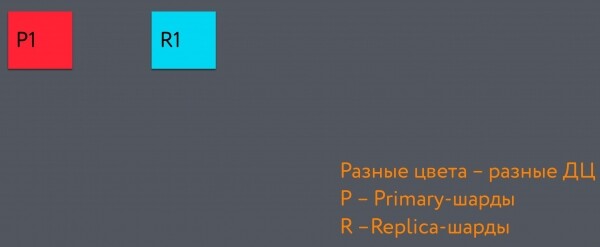
Celoten temno sivi pravokotnik predstavlja indeks. Levi rdeč kvadrat v njem je primarni shard, prvi v indeksu. Svetlo moder kvadrat pa je replika shard. Nahajata se v različnih podatkovnih centrih.
Ko我们添加另一个分片时,它进入第三个数据中心。最终,我们得到了这样的结构,可以在不损失数据一致性的情况下失去数据中心:
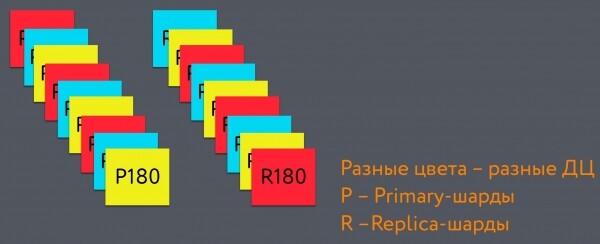
我们将索引的轮换,即创建新索引和删除最旧索引的周期设定为48小时(根据索引的使用模式:在过去48小时内被搜索的频率最高)。
这种索引轮换的时间间隔与以下原因有关:
当特定数据节点接收到搜索请求时,从性能的角度来看,查询一个分片更有利,前提是它的大小与节点的堆内存大小相当。这使得可以将索引的“热”部分保存在堆中,并迅速访问它。当“热”部分变多时,索引搜索的速度将下降。
当节点开始在一个分片上执行搜索请求时,它会分配与物理机器的超线程核数量相等的线程数量。如果搜索请求涉及大量分片,则线程数量将成比例增加。这对搜索速度有不利影响,并会对新数据的索引产生负面影响。
为了确保所需的搜索延迟,我们决定使用SSD。为了快速处理请求,放置这些容器的机器必须至少具有56个核心。56这个数字被选为足够条件,决定了Elasticsearch在运行过程中将产生的线程数量。在Elasticsearch中,许多线程池参数直接依赖于可用的核心数量,这反过来也直接影响集群中所需节点的数量,原则是“核心越少,节点越多”。
最终我们得出了一个结论,平均每个分片的大小大约为20GB,每个索引有360个分片。因此,如果我们每48小时进行一次轮换,那么我们将有15个分片。每个索引保存了过去两天的数据。
数据的写入和读取模式
让我们来看看这个系统中数据是如何被写入的。
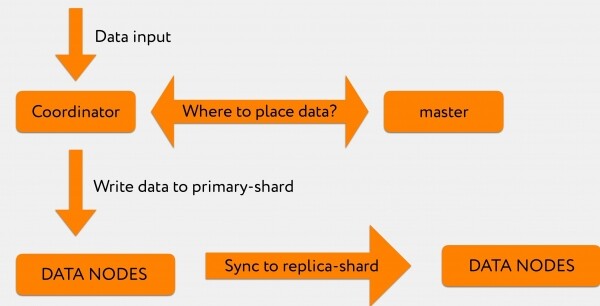
假设我们从Graylog接收到某个请求到协调器。例如,我们想索引2000-3000行。
Koordinator, ki je prejel prošnjo od Graylog, povpraša mojstra: „V prošnji za indeksacijo je bil konkretno naveden indeks, toda v katero shardo to zapisati — ni navedeno.“
Mojster odgovori: „Zapiši te informacije v shard številka 71“, nato se usmeri neposredno na ustrezno podatkovno vozlišče, kjer se nahaja primary-shard številka 71.
Nato se dnevnik transakcij replicira na replica-shard, ki se že nahaja v drugem podatkovnem centru.
Iz Grayloga v koordinator pride iskalna poizvedba. Koordinator jo preusmeri po indeksu, pri čemer Elasticsearch na principu round-robin porazdeli poizvedbe med primary-shard in replica-shard.
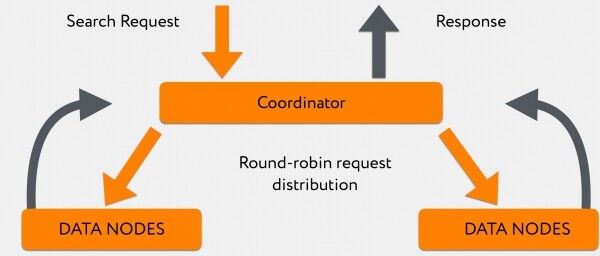
Vozlišča v številu 180 odgovarjajo neenakomerno, in medtem ko odgovarjajo, koordinator zbira informacije, ki so jih že 'izpljunili' hitrejši podatkovni vozli. Šele ko pride vsa informacija ali ko je dosežen časovni iztek poizvedbe, vse posreduje neposredno stranki.
Celotna ta sistem v povprečju obdeluje iskalne poizvedbe za zadnjih 48 ur za 300-400 ms, razen tistih poizvedb, ki vsebujejo leading wildcard.
„Cvetički“ z Elasticsearch: nastavitev Java
Da bi vse to delovalo tako, kot smo prvotno želeli, smo zelo dolgo nastavljali najbolj različne zadeve v grozdu.
Prvi del odkritih težav je bil povezan s tem, kako je v Elasticsearch privzeto nastavljena Java.
Težava prva
Opazili smo zelo veliko število sporočil o tem, da imamo na ravni Lucene, ko so zagnane background job'e, združevanje Lucene segmentov končano z napako. Pri tem je bilo v dnevnikih vidno, da gre za napako OutOfMemoryError. V telemetriji smo videli, da je hip prost, in ni bilo jasno, zakaj ta operacija odpade.
Ugotovili smo, da se združevanje Lucene indeksov dogaja zunaj hipa. Posode so precej strogo omejene glede porabe virov. V te vire je vstopal samo hip (vrednost heap.size je bila približno enaka RAM-u), medtem ko so nekateri off-heap postopki padali z napako pri dodeljevanju pomnilnika, če niso zaradi kakršnega koli razloga ustrezali tistim ~500MB, ki so ostali do omejitve.
Rešitev je bila precej trivialna: dostopni obseg RAM za posodo smo povečali, nato pa smo pozabili, da smo imeli takšne težave.
Težava druga
Čez 4-5 dni po zagonu grozda smo opazili, da se podatkovna vozlišča občasno izklapljajo iz grozda in ponovno vstopajo v njem po 10-20 sekundah.
Ko smo se počeli baviti problemom, otkrilo se da se off-heap memorija u Elasticsearch-u praktično nikako ne kontrolira. Kada smo kontejneru dodali više memorije, dobili smo mogućnost da punimo direktne bafer pule različitim informacijama, a ona se čištila samo kada je eksplicitni GC pokrenut sa strane Elasticsearch-a.
U nekim slučajevima ova operacija je trajala prilično dugo, a tokom tog vremena klaster je uspeo da označi ovu nodu kao već napustilu klaster. Ovaj problem je dobro opisan. .
Rešenje je bilo sledeće: ograničili smo Java mogućnost da koristi većinu memorije van heapa za te operacije. Ograničili smo je na 16 gigabajta (-XX:MaxDirectMemorySize=16g), postigavši da se eksplicitni GC poziva znatno češće, a da se brže izvršava, čime se klaster više nije destabilizovao.
Problem tri
Ako mislite da su problemi sa "nodama koje napuštaju klaster u najnepredvidivijim momentima" ovde završeni, varate se.
Kada smo konfigurisali rad sa indeksima, odlučili smo se za mmapfs, kako bismo po svežim shard-ovima sa velikom segmentacijom. To je bila prilično gruba greška, jer se prilikom korišćenja mmapfs datoteka mapi u radnu memoriju, a dalje radimo sa mapiranom datotekom. Zbog toga, prilikom pokušaja GC-a da zaustavi niti u aplikaciji, jako dugo idemo do safepoint-a, a putem do njega aplikacija prestaje da odgovara na zahteve master-a o tome da li je još uvek živa. Samim tim, master smatra da nod više nije prisutan u klasteru. Nakon toga, za 5-10 sekundi pokreće se sakupljač smeća, noda oživljava, ponovo ulazi u klaster i započinje inicijalizaciju shard-ova. Sve to je veoma podsećalo na "proizvodnju koju smo zaslužili" i nije bilo prikladno za bilo šta ozbiljno.
Da bismo se oslobodili takvog ponašanja, prvo smo prešli na standardni niofs, a zatim, kada smo se sa petih verzija Elastic migrirali na šeste, probali smo hybridfs, gde se ovaj problem nije ponavljao. Više o tipovima skladišta možete pročitati. .
Problem četiri
Kasnije je došlo do još jednog veoma fascinantnog problema koji smo lečili rekordno dugo. Uhvatili smo ga 2-3 meseca, jer njegov obrazac apsolutno nije bio jasan.
Včasih so naši koordinatorji šli v Full GC, običajno nekje po kosilu, in se od tam niso več vrnili. Pri tem je zaklepanju zamud GC to izgledalo tako: vse poteka dobro, dobro, dobro, nato pa kar naenkrat postane vse slabo.
Sprva smo mislili, da imamo zle uporabnike, ki izvajajo neko poizvedbo, ki vrže koordinatorja iz delovnega načina. Dolgo smo beležili poizvedbe, da bi ugotovili, kaj se dogaja.
Na koncu se je izkazalo, da ob trenutku, ko kateri koli uporabnik sproži zelo veliko poizvedbo, in ta pride na določen koordinator Elasticsearch, nekatere vozlišča odgovarjajo dlje kot druga.
In tisto vreme, ki ga koordinator čaka na odgovore vseh vozlišč, zbira rezultate, ki jih pošiljajo že odgovorjena vozlišča. Za GC to pomeni, da se naš vzorec uporabe heapa zelo hitro spremeni. In tisti GC, ki smo ga uporabljali, se s to nalogo ni spopadel.
Edina rešitev, ki smo jo našli za spremembo vedenja klasterja v takšni situaciji — migracija na JDK13 in uporaba zbiralnika odpadkov Shenandoah. To je rešilo težavo, naši koordinatorji so prenehali padati.
S tem so se težave z Javo končale in začele so se težave s prepustnostjo.
„Jagode“ z Elasticsearch: prepustnost
Težave s prepustnostjo pomenijo, da naš klaster deluje stabilno, vendar pri vrhuncih števila indeksiranih dokumentov in med manevri zmogljivost ni zadostna.
Prvi opaženi simptom: pri nekaterih „eksplozijah“ na produkciji, ko se nenadoma generira zelo veliko količino logov, se v Graylogu pogosto pojavlja napaka indeksiranja es_rejected_execution.
To se je dogajalo, ker thread_pool.write.queue na eni podatkovni vozlišču, preden je Elasticsearch uspel obdelati poizvedbo za indeksiranje in poslati informacije na shard na disk, po privzetku zna shraniti le 200 poizvedb. In o tej vrednosti je zelo malo povedanega. Omenjeno je le največje število niti in privzeta velikost.
Seveda smo šli prilagajati to vrednost in ugotovili naslednje: konkretno v naši nastavitvi se do 300 poizvedb zelo dobro shranjuje, večja vrednost pa ogroža, da bomo ponovno zašli v Full GC.
Poleg tega, ker gre za pakete sporočil, ki prispevajo znotraj enega zahtevka, je bilo treba še prilagoditi Graylog, da naj ne zapisuje pogosto in v majhnih paketih, temveč v velikih paketih ali enkrat na 3 sekunde, če paket še ni poln. V tem primeru torej informacije, ki jih v Elasticsearch zapisujemo, postanejo dostopne ne v dveh sekundah, temveč v petih (kar nas povsem zadostuje), a se zmanjša število ponovitev, ki jih je treba opraviti, da potisnemo velik paket informacij.
To je še posebej pomembno v trenutkih, ko nam kaj odpove nekje in to močno sporoča, da ne bi dobili popolnoma zasičenega Elastica, in po določenem času — neoperativnih vozlišč Grayloga zaradi zamašenih porabnikov.
Poleg tega, ko so se te eksplozije dogajale v produkciji, smo prejemali pritožbe programerjev in testerjev: v trenutku, ko so nujno potrebovali te dnevniške zapise, so bili dostavljeni zelo počasi.
Začeli smo raziskovati. Na eni strani je bilo jasno, da tako iskalni zahtevki kot tudi zahtevki za indeksacijo dejansko delujejo na istih fizičnih strojih, zato bo na tak ali drugačen način prišlo do določenih upadov zmogljivosti.
Toda temu se je bilo delno mogoče izogniti, saj je v šesti različici Elasticsearch prišel algoritem, ki omogoča razporejanje zahtevkov med relevantnimi podatkovnimi vozlišči, ne po naključnem principu round-robin (konteiner, ki se ukvarja z indeksacijo in drži primary-shard, je lahko zelo obremenjen, tam ne bo možnosti za hitro odgovoriti), temveč usmeriti ta zahtevek na manj obremenjen konteiner z replica-shard, ki bo odgovoril precej hitreje. Z drugimi besedami, prišli smo do use_adaptive_replica_selection: true.
Slika branja začne izgledati tako:
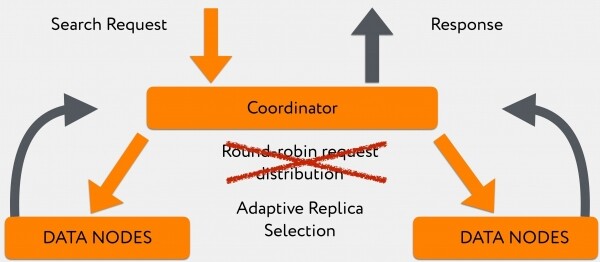
Prehod na ta algoritem je omogočil znatno izboljšanje časa poizvedbe v tistih trenutkih, ko je bil naš veliki tok dnevnikov za zapis.
Nazadnje, glavna težava je bila brez bolečega izklopa podatkovnega centra.
Kaj smo želeli od klustra takoj po izgubi povezave z enim DC:
- Če je v odpadlem podatkovnem centru trenutni master, bo ponovno izbran in prestavljen kot vloga na drugo vozlišče v drugem DC.
- Master bo hitro izključil iz klustra vsa nedostopna vozlišča.
- Na podlagi preostalih bo razumel: v izgubljenem podatkovnem centru smo imeli takšne primary sharde, hitro bo promoviral komplementarne replica sharde v preostalih podatkovnih centrih in indeksacija podatkov se bo nadaljevala.
- Kot rezultat tega bo prepustnost klasterja za pisanje in branje postopoma degradirala, vendar bo na splošno vse delovalo, čeprav počasi, a stabilno.
Kot se je izkazalo, smo želeli nekaj takega:
In dobili smo tole:
Kako je to mogoče?
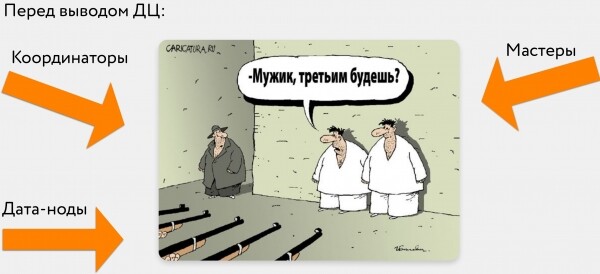
V trenutku padca podatkovnega centra je bila našo ozko grlo master.
Zakaj?
Gre za to, da v masterju obstaja TaskBatcher, ki je odgovoren za širjenje nekaterih nalog in dogodkov v klasterju. Vsak izlet vozlišča, vsako napredovanje sharda iz replica v primary, vsaka naloga za ustvarjanje kje kakšnega sharda — vse to najprej pride v TaskBatcher, kjer se obravnava zaporedno in v enem toku.
V trenutku izpada enega podatkovnega centra je bilo tako, da so v preživelih podatkovnih centrih vse podatkovne vozlišča menila, da morajo obvestiti masterja „izgubili smo take in take sharde ter take in take podatkovne vozlišča“.
Pri tem so preživela podatkovna vozlišča pošiljala vse te informacije trenutnemu masterju in poskušala čakati na potrditev, da jo je sprejel. Te potrditve niso čakali, saj je master prejel naloge hitreje, kot je lahko odgovarjal. Vozlišča so po časovnem limitu ponavljala zahtevke, master pa je v tem času že samo poskušal razporediti zahtevke po prioritetah.
Na koncu je izgledalo, da so podatkovna vozlišča spamala masterja do te mere, da je prešel v full GC. Po tem je vlogo masterja prevzelo kakšno naslednje vozlišče, pri čemer se je zgodilo enako, in na koncu se je klaster popolnoma razpadel.
Izvajali smo meritve in do različice 6.4.0, kjer je bila ta težava odpravljena, je bilo dovolj, da je hkrati izpademo le 10 podatkovnih vozlišč od 360, da bi popolnoma ustavili klaster.
Izgledalo je nekako tako:
Po različici 6.4.0, kjer so popravili to grozno napako, podatkovna vozlišča niso več ubijala masterja. A „bolj pametnejši“ od tega ni postal. Namreč: ko izklopimo 2, 3 ali 10 (katerokoli število, različno od enega) podatkovnih vozlišč, master prejme neko prvo sporočilo, ki pravi, da je vozlišče A izklopljeno, in poskuša obvestiti vozlišče B, vozlišče C, vozlišče D.
Trenutno se s tim možemo boriti samo postavljanjem vremenskog ograničenja na pokušaje nekome nešto reći, koje iznosi otprilike 20-30 sekundi, a time upravljamo brzinom izlaska data centra iz klastera.
U principu, ovo se uklapa u zahteve koji su prvobitno postavljeni za konačni proizvod u okviru projekta, ali sa stanovišta 'čiste nauke', ovo je greška. Koja je, inače, uspešno ispravljena od strane developera u verziji 7.2.
Naime, kada određena data-noda izlazi, ispostavlja se da je širenje informacija o njenom izlasku važnije nego obaveštavanje celog klastera da su na njoj bili takvi primarni šardovi (kako bi se promovisali replikacijski šardovi u drugom data centru u primarni, i mogla se pisati informacija).
Zato, kada se sve ‘slegne’, izlazne data-node se ne označavaju odmah kao zastarele. Shodno tome, prisiljeni smo da čekamo da svi pingovi odstoje prema izlaznim data-nodama i tek nakon toga naš klaster počinje obaveštavati o tome gde je potrebno nastaviti pisanje informacija. O ovome možete pročitati više .
Na kraju, operacija izlaska data centra nam danas traje oko 5 minuta u špicu. Za ovako veliku i sporu mašinu, to je prilično dobar rezultat.
Na kraju smo došli do sledećeg rešenja:
- Imamo 360 data-noda sa diskovima od 700 gigabajta.
- 60 koordinatora za usmeravanje saobraćaja po ovim data-nodama.
- 40 mastera, koji su nam ostali kao neka vrsta nasleđa iz vremena pre verzije 6.4.0 — da bismo preživeli izlaz data centra, morali smo da budemo psihički spremni da izgubimo nekoliko mašina, kako bismo garantirali kvorum mastera čak i u najgorem scenariju.
- Sve pokušaje kombinovanja uloga na jednoj kontejnere zapravo su se suočavale s tim da pre ili kasnije noda nije izdržavala opterećenje.
- U celom klasteru koristi se heap.size koji iznosi 31 gigabajt: svi pokušaji smanjenja veličine doveli su do toga da su teški pretraživački upiti sa leading wildcard ili ubijali neke nodove, ili bi se circuit breaker aktivirao unutar samog Elasticsearch-a.
- Pored toga, za obezbeđivanje performansi pretrage nastojali smo da održimo broj objekata u klasteru na minimum kako bismo obradili što manje događaja na najuskom mestu, koje smo imali na masteru.
Na kraju o monitoringu
Da bi vse to delovalo, kot je bilo namenjeno, spremljamo naslednje:
- Vsaka podatkovna vozlišča poroča našem oblaku, da obstaja, in da so tam določeni shardi. Ko nekje kaj ugasnemo, skupina po 2-3 sekundah poroča, da smo v centru A ugasnili vozlišča 2, 3 in 4 — to pomeni, da v drugih podatkovnih centrih ne smemo ugasiti tistih vozlišč, na katerih so shardi v edinstvenem izvodu.
- Vedoci značaja delovanja glavne enote, zelo pozorno spremljamo število čakajočih nalog. Zelo en sam visoko obteženi nalog, če se pravočasno ne izklopi, teoretično lahko v izredni situaciji postane vzrok, da ne bomo mogli izvesti, recimo, promocije replica-sharda v primarni, zaradi česar pride do zaustavitve indeksacije.
- Poleg tega zelo natančno spremljamo zamude garbage collectorja, ker smo se s tem že spopadli z resnimi težavami pri optimizaciji.
- Zavrnitve po niti, da bi vnaprej razumeli, kje se nahaja "ozko grlo".
- In tudi standardne metrike, kot so heap, RAM in I/O.
Pri postavljanju monitoringa je nujno upoštevati posebnosti Thread Pool v Elasticsearchu. opisuje možnosti nastavitve in privzete vrednosti za iskanje, indeksiranje, vendar popolnoma molči o thread_pool.management. Ti niti obravnavajo, med drugim, poizvedbe tipa _cat/shards in druge podobne, ki jih je priročno uporabiti pri pisanju monitoringa. Tem večji je klaster, tem več takšnih poizvedb se izvede na enoto časa, medtem ko tisti thread_pool.management ni le, da ni predstavljen v uradni dokumentaciji, temveč je tudi privzeto omejen na 5 niti, kar se zelo hitro izkoristi, po čemer monitoring preneha delovati pravilno.
Kar bi želeli povedati na koncu: uspelo nam je! Uspeli smo našim programerjem in razvijalcem zagotoviti orodje, ki je skoraj v vsaki situaciji sposobno hitro in zanesljivo zagotoviti informacije o dogajanju v produkciji.
Da, to se je izkazalo za precej zapleteno, vendar so se naše želje uspešno vklapljale v že obstoječe izdelke, ki jih ni bilo treba popraviti in predelati.
Izvor: habr.com
