

Nedavno sem povedal, kako z uporabo standardnih receptov iz PostgreSQL baze. Danes pa bomo govorili o tem, kako možno narediti učinkovitejše zapisovanje v BDP, brez uporabe kakršnih koli "vzvodov" v konfiguraciji — preprosto z organizacijo podatkovnih tokov.
#1. Секционирование
Članek o tem, kako in zakaj je smiselno organizirati je že bil, tukaj pa se bomo osredotočili na praktično uporabo nekaterih pristopov v okviru našega .
"Dela davno minule dni…"
Sprva, kot vsak MVP, je naš projekt začel z relativno majhnim obremenitvijo — spremljanje je potekalo le za deset najkritičnejših strežnikov, vse tabele so bile razmeroma kompaktne… A čas je mineval, število spremljanih gostiteljev se je povečevalo, in ko smo poizkušali enkrat več narediti nekaj z eno od tabelami velikosti 1.5TB, smo spoznali, da se da živeti tako, a je vseeno zelo neprijetno.
Časi so bili skorajda junaški, aktualni so bili različni različici PostgreSQL 9.x, zato je bilo vse sekcioniranje treba izvajati "ročno" — preko podedovanja tabel in sprožilcev usmerjanja s dinamičnim EXECUTE.
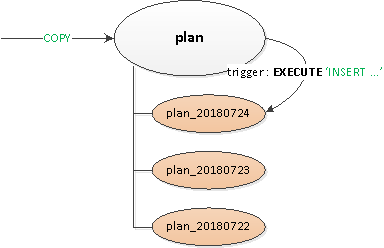
Rešitev se je izkazala za dovolj univerzalno, da jo je bilo mogoče prenesti na vse tabele:
- Razglašena je bila prazna "glavna" nadtabela, na kateri so bile opisane vse potrebne indekse in sprožilce.
- Zapis z vidika odjemalca se je izvajal v "koreninsko" tabelo, znotraj pa s pomočjo sprožilca usmerjanja
BEFORE INSERTse je zapis "fizično" vstaviti v potreben odsek. Če takšen še ni obstajal — smo ujeli izjemo in … - … s pomočjo po predlogi glavne tabele je bila ustvarjena sekcija z omejitvijo na potrebno datum, da se pri pridobivanju podatkov branje izvaja samo v njej.
PG10: prva vaja
A vendar je bilo sekcioniranje preko podedovanja zgodovinsko slabo prilagodljivo za delo z aktivnim tokom zapisovanja ali velikim številom sekcij-podedkov. Na primer, lahko se spomnimo, da je imel algoritem izbire potrebne sekcije kvadratno kompleksnost, kar pri 100+ sekcijah deluje, kot si lahko predstavljate …
V PG10 so to situacijo močno optimizirali, saj so uvedli podporo Zato smo takoj poskusili uporabiti takoj po selitvi shrambe, ampak...
Kot se je izkazalo po pregledovanju priročnika, nativno sekcionirana tabela v tej različici:
- ne podpira opisa indeksov
- ne podpira sprožilcev
- ne more biti sama ničji 'potomec'
- ne podpira
INSERT ... ON CONFLICT - ne zna samodejno ustvariti sekcijo
Pošteno smo se udarili po čelu z grabljami in spoznali, da brez spremembe aplikacije ne bo šlo, ter smo nadaljnje raziskave odložili za pol leta.
PG10: druga priložnost
Torej, začeli smo reševati nastale težave eno za drugo:
- Ker so sprožilci in
ON CONFLICTbili nekje vseeno potrebni, smo za njihovo delovanje naredili vmesno proxy tabelo. - Opravičili smo se od 'usmerjanja' v sprožilcih — torej od
EXECUTE. - Ločili smo posebej predlogo z vsemi indeksi, da ne bi niti bili prisotni na proxy tabeli.
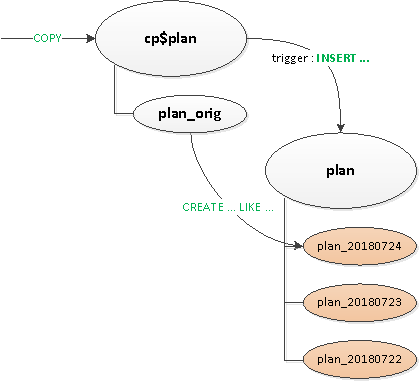
Nazadnje, po vsem tem, smo že nativno sekcionirali glavno tabelo. Ustvarjanje nove sekcije je ostalo še vedno na vest aplikacije.
Delamo na slovarjih
Kot v vsakem analitičnem sistemu, smo imeli tudi mi 'fakte' in 'razreze' (slovarji). V našem primeru so to predstavljali na primer homogenih počasnih poizvedb ali besedilo same poizvedbe.
'Fakti' so bili že dolgo sekcionirani po dnevih, tako da smo mirno odstranjevali zastarele sekcije, in niso nam motile (saj so logi!). Ustvarila pa se je težava s slovarji...
Ni mogoče reči, da jih je bilo zelo veliko, ampak približno na 100TB 'faktov' smo dobili slovar na 2.5TB.Iz takšne tabele ni enostavno ničesar izbrisati, niti stisniti v razumljivem času, poleg tega je pisanje vanjo postopoma postajalo vse počasnejše.
Tako da je slovar... v njem mora biti vsak zapis predstavljen natančno enkrat... in to je pravilno, ampak!.. Nihče nam ne preprečuje, da imamo po posameznem slovarju za vsak dan! Ja, to prinaša določeno odvečnost, vendar omogoča:
- hitrejše pisanje/branje z manjšo velikostjo sekcije
- manjšo porabo pomnilnika z delom s bolj kompaktnimi indeksi
- manj podatkov z možnostjo hitrega odstranjevanja zastarelih
Kot rezultat celotnega kompleksa ukrepov se je obremenitev CPU zmanjšala za ~30%, obremenitev diska pa za ~50%:
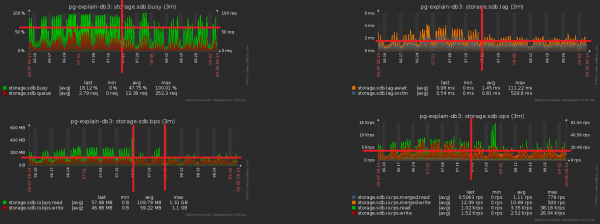
Pri tem smo nadaljevali s pisanjem v bazo ravno to, le z manjšo obremenitvijo.
#2. Эволюция и рефакторинг БД
Torej, ustavili smo se pri tem, da imamo za vsak dan svojo sekcijo z podatki. Dejansko, CHECK (dt = '2018-10-12'::date) — in to je ključ sekcioniranja ter pogoj za uvrstitev zapisa v določeno sekcijo.
Ker so vsi poročila v naši storitvi zgrajena glede na določene datume, so tudi indeksi že iz "nesectioniranih časov" vsi tipi (Strežnik, Datum, Predloga načrta), (Strežnik, Datum, Vozlišče načrta), (Datum, Razred napake, Strežnik),…
Ampak zdaj v vsaki sekciji živijo svoja instanca vsakega takšnega indeksa… In v okviru vsake sekcije datum — konstanta… Izkazalo se je, da zdaj v vsak tak indeks preprosto vpišemo konstanto kot eno od polj, kar povečuje tako njegovo velikost kot tudi čas iskanja po njem, ne prinaša pa nobenih rezultatov. Sami smo si postavili pasti, ups…
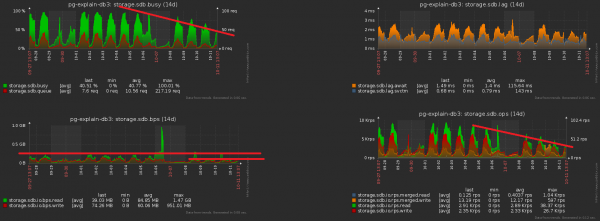
Usmeritev optimizacije je očitna — enostavno odstranimo polje z datumom iz vseh indeksov na sekcioniranih tabelah. Pri naših volumenih je prihranek — približno 1TB/teden!
In zdaj opazimo, da je bilo ta terabajt še treba nekako zabeležiti. Torej moramo tudi disk zdaj obremenjevati manj! Na tej sliki je dobro vidna dosežena učinkovitost po izvedeni čiščenju, ki smo ji posvetili en teden:
#3. «Размазываем» пиковую нагрузку
Ena od velikih težav obremenjenih sistemov je odvečno sinhroniziranje neke operacije, ki tega ne zahtevajo. Včasih "ker nismo opazili", včasih "tako je bilo lažje", a prej ali slej se moramo tega znebiti.
Povezujemo s prejšnjo sliko — in vidimo, da naš disk "nosi" obremenitev z dvakratno amplitudo med sosednjimi meritvami, kar očitno "statistično" ne bi smelo biti pri takšnem številu operacij:
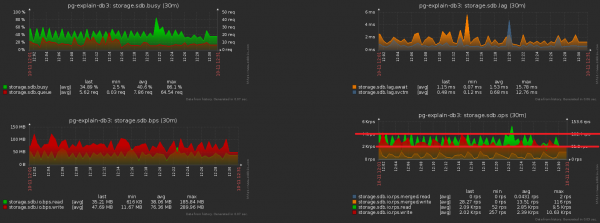
Doseči to je dovolj preprosto. Naša monitoring je že obsegala skoraj 1000 strežnikov, vsak obdelan z ločenim logičnim tokom, vsak tok pa odda akumulirane informacije za pošiljanje v bazo s določenim časovnim intervalom, približno takole:
setInterval(sendToDB, interval)Težava je v tem, da vsi tokovi začenjajo približno ob istem času, zato se trenutki pošiljanja skoraj vedno ujemajo "do točke". Ups številka 2…
Na srečo se to da precej enostavno popraviti, z dodajanjem "naključnega" zamika po času:
setInterval(sendToDB, interval * (1 + 0.1 * (Math.random() - 0.5)))#4. Кэшируем, что нужно можно
Tretja tradicionalna težava highload — pomanjkanje predpomnilnika tja, kjer bi moral lahko biti.
Na primjer, omogućili smo analizu prema čvorovima plana (svi ti Seq Scan na korisnicima), ali odmah pomisliti da su oni, u masi, isti - zaboravili su.
Ne, naravno, ništa se ne piše ponovo u bazu, to isključuje okidač s INSERT ... ON CONFLICT DO NOTHING. Ali podaci ipak stižu do baze, a još i dodatno čitati za provjeru sukoba mora se raditi. Ups br. 3…
Razlika u broju unosa u bazu prije/nakon uključivanja keširanja - očita:
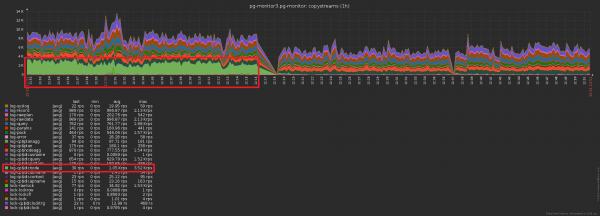
A ovo je - prateći pad opterećenja na skladištu:
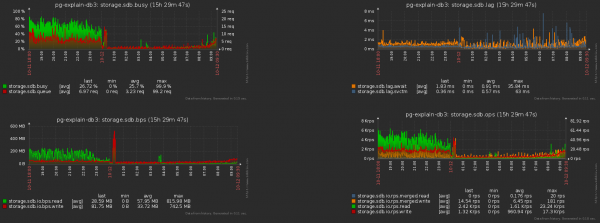
Ukupno
«Terabajt-na-dan» samo zvuči zastrašujuće. Ako sve radite ispravno, to je samo 2^40 bajtova / 86400 sekundi = ~12.5MB/s, što su i desktop IDE tvrdnji mogli držati. 🙂
A ako ozbiljno, čak i pri desetostrukom «iskretanju» opterećenja tokom dana, možete se lako uklopiti u mogućnosti modernih SSD-ova.
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish