

Hello, Habr!
Ali imate radi leteti z letali? Obožujem to, vendar sem v času samoizolacije začel tudi analizirati podatke o letalskih vozovnicah enega znanega vira - Aviasales.
Danes bomo preučili delovanje Amazon Kinesis, zgradili sistem za pretakanje z analitiko v realnem času, postavili NoSQL bazo podatkov Amazon DynamoDB kot glavno skladišče podatkov in omogočili obveščanje preko SMS o zanimivih vozovnicah.
Vse podrobnosti so spodaj! Pojdimo!
Uvod
Za primer bomo potrebovali dostop do . Dostop do njega je brezplačen in brez omejitev, potrebna je le registracija v razdelku 'Razvijalcem', da dobite svoj API žeton za dostop do podatkov.
Glavni cilj tega članka je dati splošno razumevanje uporabe pretakanja podatkov v AWS, pri čemer ne upoštevamo, da podatki, ki jih vrača uporabljen API, niso nujno aktualni in se prenašajo iz predpomnilnika, ki se oblikuje na podlagi iskanj uporabnikov spletnih strani Aviasales.ru in Jetradar.com v zadnjih 48 urah.
Podatki o letalskih vozovnicah, pridobljeni preko API, bo Kinesis-agent, nameščen na proizvajalni napravi, avtomatsko pospravil in poslal v ustrezen tok preko Kinesis Data Analytics. Neobdelana različica tega toka bo neposredno zapisana v skladišče. Razvito skladišče v DynamoDB za 'surove' podatke bo omogočilo globnjo analizo vozovnic preko BI orodij, kot je AWS Quick Sight.
Pregledali bomo dve možnosti za implementacijo celotne infrastrukture:
- Ročno - preko AWS Management Console;
- Infrastruktura iz kode Terraform - za lene avtomatizatorje;
Arhitektura razvijanega sistema
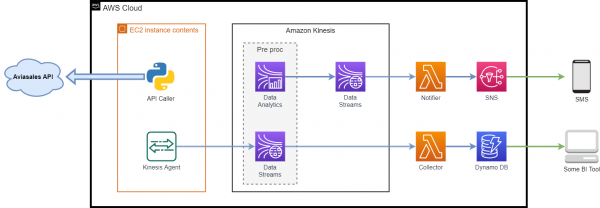
Uporabljenimi komponentami:
- — podatki, ki jih vrača ta API, bodo uporabljeni za vse nadaljnje delo;
- — običajen virtualni stroj v oblaku, kjer bo generiran vhodni tok podatkov:
- — to je Java-aplikacija, ki se lokalno namesti na napravo, ki omogoča enostavno zbiranje in pošiljanje podatkov v Kinesis (Kinesis Data Streams ali Kinesis Firehose). Agent nenehno spremlja zbirko datotek v določenih imenikih in pošilja nove podatke v Kinesis;
- — Python skripta, ki pošilja poizvedbe na API in shranjuje odgovor v mapo, ki jo spremlja Kinesis Agent;
- — storitev pretakanja podatkov v realnem času z obsežnimi možnostmi skaliranja;
- — brezstrežna storitev, ki poenostavi analizo podatkov v realnem času. Amazon Kinesis Data Analytics nastavi vire za delovanje aplikacij in se samodejno prilagaja za obdelavo katerikoli količine vhodnih podatkov;
- — storitev, ki omogoča izvajanje kode brez rezervacije in nastavitve strežnikov. Vsi računalniški viri se samodejno prilagajajo za vsak klic;
- — baza podatkov tipa „ključ-vrednost“ in dokumentov, ki zagotavlja zakasnitve manj kot 10 milisekund pri delu v katerikoli meri. Uporaba DynamoDB ne zahteva razporeditve strežnikov, nameščanja popravkov ali upravljanja z njimi. DynamoDB samodejno prilagodi tabele, prilagaja količino razpoložljivih virov in ohranja visoko zmogljivost. Nobenega ukrepanja za upravljanje sistema ni potrebno;
- — popolnoma upravljana storitev pošiljanja sporočil po modelu „izdajatelj — prejemnik“ (Pub/Sub), ki omogoča izolacijo mikroservisov, razporejenih sistemov in brezstrežnih aplikacij. SNS se lahko uporablja za pošiljanje informacij končnim uporabnikom prek mobilnih push obvestil, SMS sporočil in elektronskih sporočil.
Začetna priprava
Za simulacijo podatkovnega toka sem se odločil uporabiti informacije o letalskih vozovnicah, ki jih vrne API Aviasales. V kar precej obsežen seznam različnih metod, vzeli bomo eno od njih — „Koledar cen za mesec“, ki vrne cene za vsak dan v mesecu, razvrščene po številu prestopov. Če v zahtevo ne posredujete meseca iskanja, bo vrnjen podatek za mesec, ki sledi trenutnemu.
Torej, registriramo se, pridobimo svoj žeton.
Primer zahteve je spodaj:
http://api.travelpayouts.com/v2/prices/month-matrix?currency=rub&origin=LED&destination=HKT&show_to_affiliates=true&token=TOKEN_APIZgornji način pridobivanja podatkov iz API-ja z navedbo žetona v zahtevi bo deloval, vendar raje prepuščam prenos dostopnega žetona prek glave, zato v skripti api_caller.py uporabljamo prav to metodo.
Primer odgovora:
{{
   "success":true,
   "data":[{
      "show_to_affiliates":true,
      "trip_class":0,
      "origin":"LED",
      "destination":"HKT",
      "depart_date":"2015-10-01",
      "return_date":"",
      "number_of_changes":1,
      "value":29127,
      "found_at":"2015-09-24T00:06:12+04:00",
      "distance":8015,
      "actual":true
   }]
}
V zgornjem primeru odgovora API-ja je prikazan letalski prevoz iz Sankt Peterburga v Phuket... Eh, zakaj sanjati...
Ker sem iz Kazana in je Phuket zdaj "le v naših sanjah", poiščimo letalske karte iz Sankt Peterburga v Kazan.
Predvideva se, da imate že račun v AWS. Takoj želim opozoriti, da Kinesis in pošiljanje obvestil preko SMS ne spadata v letno . A kljub tomu, če si v mislih rezervirate nekaj dolarjev, je povsem mogoče postaviti predlagani sistem in se z njim igrati. Seveda ne smete pozabiti, da izbrišete vse vire, ko jih ne potrebujete več.
Na srečo bo DynamoDb in lambda funkcije za nas pogojno brezplačne, če se bomo držali mesečnih brezplačnih omejitev. Na primer, za DynamoDB: 25 GB shranjevanja, 25 WCU/RCU in 100 milijonov poizvedb. In milijon klicev lambda funkcij na mesec.
Ročni deploy sistema
Nastavitev Kinesis Data Streams
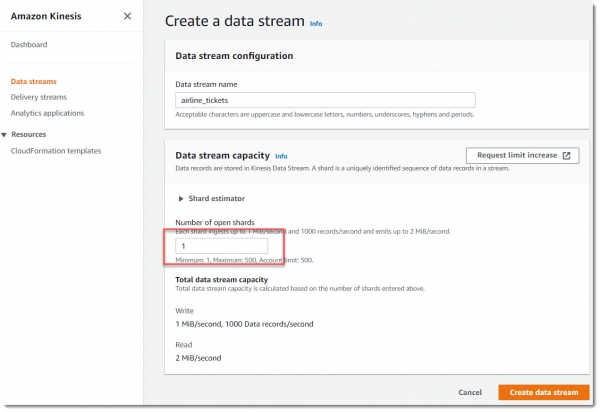
Pojdimo v storitev Kinesis Data Streams in ustvarimo dva nova toka z enim shardom za vsakega.
Kaj je shard?
Shard je osnovna enota prenosa podatkov v Amazon Kinesis. Eden segment zagotavlja prenos vhodnih podatkov s hitrostjo 1 MB/s in prenos izhodnih podatkov s hitrostjo 2 MB/s. Eden segment podpira do 1000 zapisov PUT na sekundo. Pri ustvarjanju toka podatkov je potrebno navesti potrebno število segmentov. Na primer, lahko ustvarite tok podatkov z dvema segmentoma. Ta tok podatkov bo zagotavljal prenos vhodnih podatkov s hitrostjo 2 MB/s in prenos izhodnih podatkov s hitrostjo 4 MB/s ter podporo do 2000 zapisov PUT na sekundo.
Več shardov imate v svojem toku, večjo ima pretočnost. Na splošno se tokovi skalirajo z dodajanjem shardov. A več shardov kot imate, višja bo cena. Vsak shard stane 1,5 centa na uro in dodatno 1,4 centa za vsak milijon operacij dodajanja v tok (PUT payload units).
Ustvarimo nov tok z imenom airline_tickets, zadostoval bo en shard:
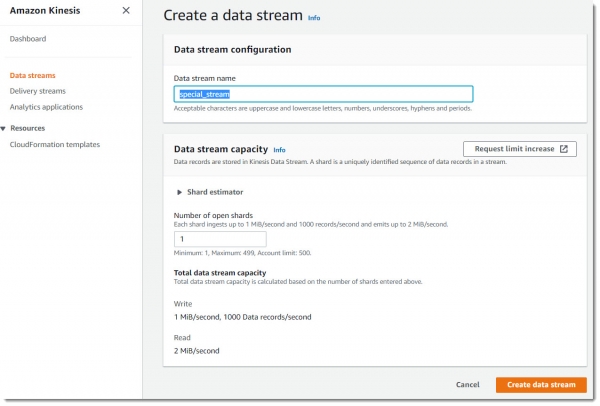
Sedaj ustvarimo še en tok z imenom special_stream:
Nastavitev producerja
Kot producer podatkov za obravnavo naloge zadostuje običajen EC2 instance. To ne sme biti močna draga virtualna naprava, povsem ustreza spotov t2.micro.
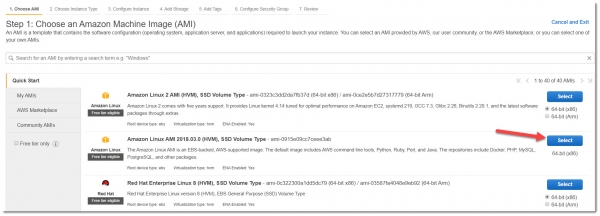
Pomembna opomba: za ta primer je priporočljivo uporabiti image — Amazon Linux AMI 2018.03.0, s katerim je manj nastavitev za hitro zagon Kinesis Agent.
Prehajamo na storitev EC2, ustvarimo nov virtualni strežnik, izbiramo ustrezen AMI tipa t2.micro, ki je v okviru Free Tier:
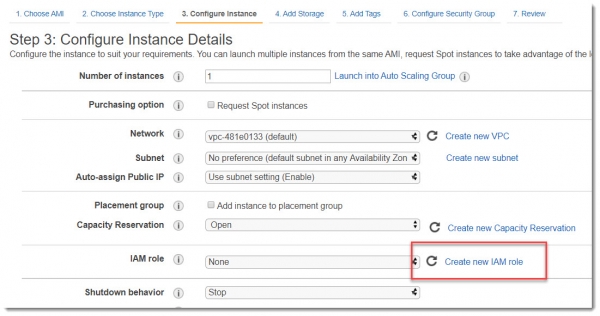
Da nova virtualna naprava lahko deluje s storitvijo Kinesis, ji moramo dodeliti pravice. Najboljši način za to je dodelitev IAM vloge. Zato na zaslonu Step 3: Configure Instance Details izberite Ustvari novo IAM vlogo:
Ustvarjanje IAM vloge za EC2
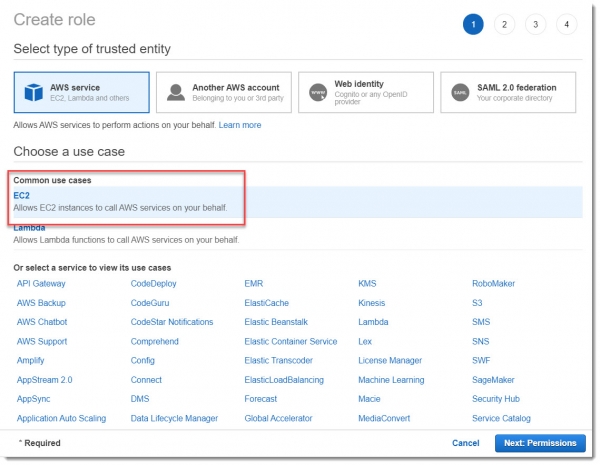
V odprtem oknu izberemo, da novo vlogo ustvarjamo za EC2 in preidemo na razdelek Permissions:
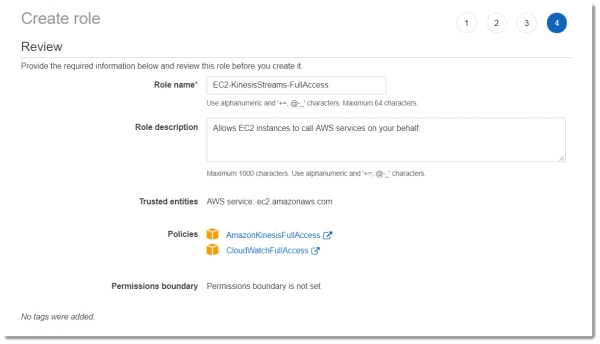
V učnem primeru se ni treba spuščati v vse podrobnosti granularne nastavitve pravic za vire, zato izberimo vnaprej nastavljene politike, ki jih ponuja Amazon: AmazonKinesisFullAccess in CloudWatchFullAccess.
Dajmo to vlogo razumljivo ime, na primer: EC2-KinesisStreams-FullAccess. Na koncu bi moralo biti tako, kot je prikazano na spodnji sliki:
Po ustvarjanju te nove vloge ne pozabite pritrditi je na ustvarjeni inštanco virtualnega stroja:
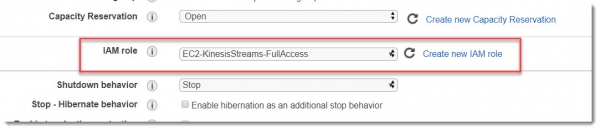
Na tej strani več ne spreminjamo in preidemo na naslednje zaslone.
Parametre trdega diska lahko pustimo privzete, oznake prav tako (čeprav je dobra praksa uporabljati oznake, vsaj za poimenovanje inštance in označevanje okolja).
Zdaj smo na zavihku Step 6: Configure Security Group, kjer je potrebno ustvariti novo ali navesti obstoječo varnostno skupino, ki omogoča povezovanje preko ssh (port 22) z inštanco. Tam izberite Source —> My IP in lahko zaženete inštanco.
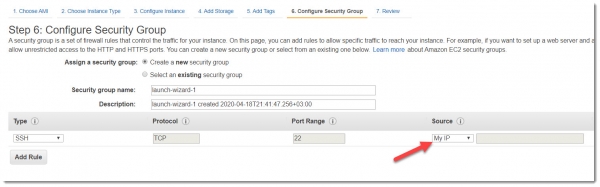
Ko preide v status running, lahko poskusite povezati prek ssh.
Da bi lahko delali s Kinesis Agentom, po uspešni povezavi z napravo vnesite naslednje ukaze v terminal:
sudo yum -y update
sudo yum install -y python36 python36-pip
sudo /usr/bin/pip-3.6 install --upgrade pip
sudo yum install -y aws-kinesis-agent
Ustvarimo mapo za shranjevanje odgovorov API:
sudo mkdir /var/log/airline_ticketsPred zagonom agenta je treba nastaviti njegov konfiguracijski file:
sudo vim /etc/aws-kinesis/agent.jsonVsebina datoteke agent.json mora imeti naslednjo obliko:
{
  "cloudwatch.emitMetrics": true,
  "kinesis.endpoint": "",
  "firehose.endpoint": "",

  "flows": [
    {
      "filePattern": "/var/log/airline_tickets/*log",
      "kinesisStream": "airline_tickets",
      "partitionKeyOption": "RANDOM",
      "dataProcessingOptions": [
         {
            "optionName": "CSVTOJSON",
            "customFieldNames": ["cost","trip_class","show_to_affiliates",
                "return_date","origin","number_of_changes","gate","found_at",
                "duration","distance","destination","depart_date","actual","record_id"]
         }
      ]
    }
  ]
}
Kot je razvidno iz konfiguracijske datoteke, bo agent spremljal datoteke s končnico .log v mapi /var/log/airline_tickets/, jih analiziral in poslal v tok airline_tickets.
Ponovno zaženemo storitev in preverimo, ali se je zagnala in deluje:
sudo service aws-kinesis-agent restartZdaj bomo prenesli Python skripto, ki bo pridobila podatke iz API-ja:
REPO_PATH=https://raw.githubusercontent.com/igorgorbenko/aviasales_kinesis/master/producer

wget $REPO_PATH/api_caller.py -P /home/ec2-user/
wget $REPO_PATH/requirements.txt -P /home/ec2-user/
sudo chmod a+x /home/ec2-user/api_caller.py
sudo /usr/local/bin/pip3 install -r /home/ec2-user/requirements.txt
Skripta api_caller.py pridobiva podatke iz Aviasales in shranjuje prejet odgovor v mapo, ki jo skenira Kinesis agent. Izvedba te skripte je dovolj standardna, obstaja razred TicketsApi, ki omogoča asinhrono dostopanje do API-ja. V ta razred posredujemo glavo s tokenom in parametre poizvedbe:
class TicketsApi:
    """Razred za klicanje API-ja."""

    def __init__(self, headers):
        """Init metoda."""
        self.base_url = BASE_URL
        self.headers = headers

    async def get_data(self, data):
        """Pridobite podatke iz API poizvedbe."""
        response_json = {}
        async with ClientSession(headers=self.headers) as session:
            try:
                response = await session.get(self.base_url, data=data)
                response.raise_for_status()
                LOGGER.info('Status odgovora %s: %s',
                            self.base_url, response.status)
                response_json = await response.json()
            except HTTPError as http_err:
                LOGGER.error('Ups! Nastala je napaka HTTP: %s', str(http_err))
            except Exception as err:
                LOGGER.error('Ups! Nastala je napaka: %s', str(err))
            return response_json


def prepare_request(api_token):
    """Vrni glave in poizvedbe za API zahtevo."""
    headers = {'X-Access-Token': api_token,
               'Accept-Encoding': 'gzip'}

    data = FormData()
    data.add_field('currency', CURRENCY)
    data.add_field('origin', ORIGIN)
    data.add_field('destination', DESTINATION)
    data.add_field('show_to_affiliates', SHOW_TO_AFFILIATES)
    data.add_field('trip_duration', TRIP_DURATION)
    return headers, data


async def main():
    """Zaženi kodo."""
    if len(sys.argv) != 2:
        print('Uporaba: api_caller.py ')
        sys.exit(1)
        return
    api_token = sys.argv[1]
    headers, data = prepare_request(api_token)

    api = TicketsApi(headers)
    response = await api.get_data(data)
    if response.get('success', None):
        LOGGER.info('API je vrnil %s elementov', len(response['data']))
        try:
            count_rows = log_maker(response)
            LOGGER.info('%s vrstic je bilo shranjenih v %s',
                        count_rows,
                        TARGET_FILE)
        except Exception as e:
            LOGGER.error('Ups! Rezultat zahteve ni bil shranjen v datoteko. %s',
                         str(e))
    else:
        LOGGER.error('Ups! Zahteva API je bila neuspešna %s!', response)
Za testiranje pravilnosti nastavitev in delovanja agenta bomo izvedli testno zahtevo skripte api_caller.py:
sudo ./api_caller.py TOKEN 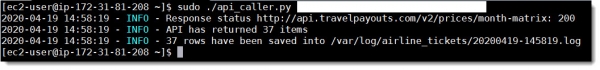
In si ogledamo rezultat delovanja v dnevnikih agenta ter na zavihku Monitoring v toku podatkov airline_tickets:
tail -f /var/log/aws-kinesis-agent/aws-kinesis-agent.log 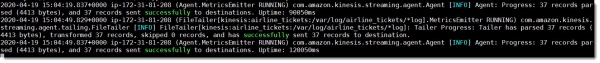
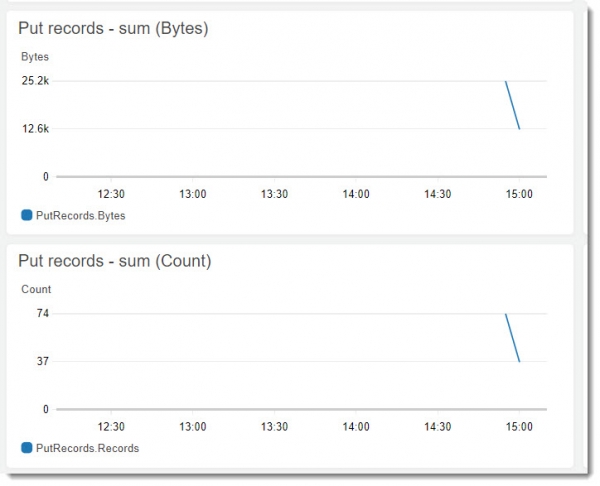
Kot želi, vse deluje in Kinesis Agent uspešno pošilja podatke v tok. Sedaj nastavimo consumer.
Nastavitev Kinesis Data Analytics
Preidimo na osrednji komponent celotnega sistema — ustvarili bomo novo aplikacijo v Kinesis Data Analytics z imenom kinesis_analytics_airlines_app:
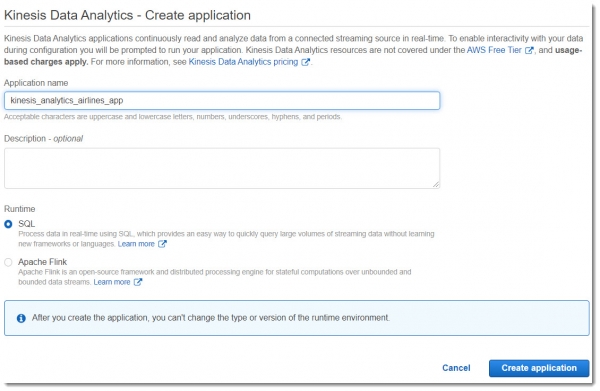
Kinesis Data Analytics omogoča analitiko podatkov v realnem času iz Kinesis Streams z uporabo SQL. To je povsem avtomatsko skalabilna storitev (za razliko od Kinesis Streams), ki:
- omogoča ustvarjanje novih tokov (Output Stream) na podlagi poizvedb do izvornih podatkov;
- ponuja tok z napakami, ki so se pojavile med delovanjem aplikacij (Error Stream);
- zmore samodejno določati shemo vhodnih podatkov (to je mogoče ročno prepisati po potrebi).
To ni poceni storitev — 0,11 USD na uro delovanja, zato jo je treba uporabljati previdno in jo odstraniti ob zaključku dela.
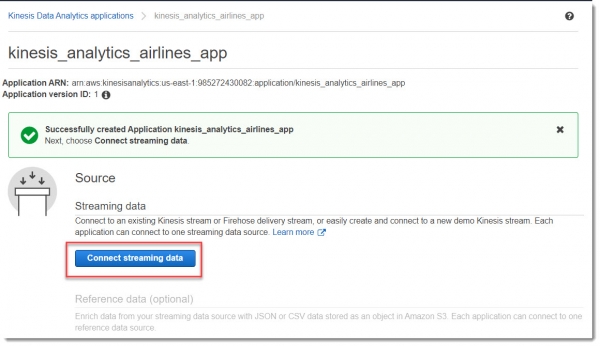
Povezali bomo aplikacijo na vir podatkov:
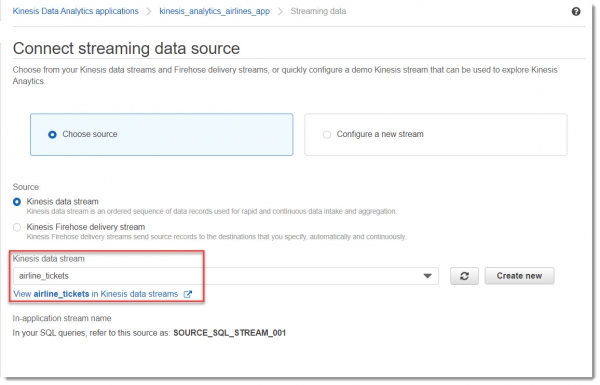
Izberemo tok, na katerega se nameravamo povezati (airline_tickets):
Nato je treba pritrditi novo IAM vlogo, da lahko aplikacija bere iz toka in piše v tok. Za to ni potrebno nič spremeniti v bloku Access permissions:
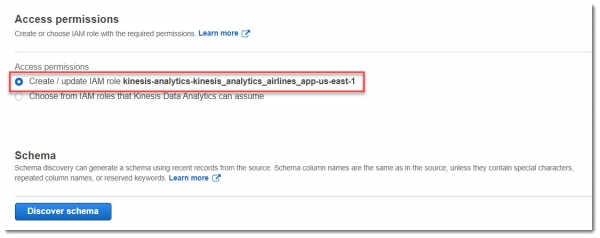
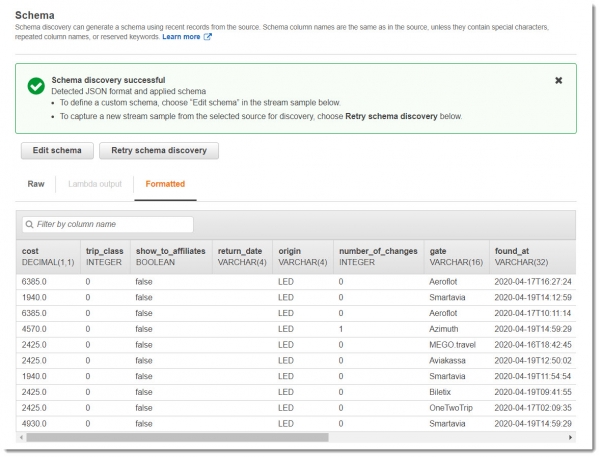
Sedaj zahtevamo odkrivanje sheme podatkov v toku, za to kliknemo na gumb »Discover schema«. Kot rezultat se bo posodobila (ustvarila nova) IAM vloga in se bo začelo odkrivanje sheme iz podatkov, ki so že prišli v tok:
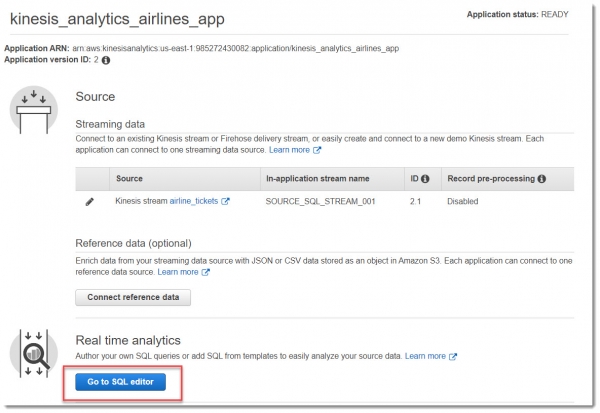
Sedaj moramo preiti v SQL urejevalnik. Ob kliknjeni na ta gumb se bo odprlo okno z vprašanjem o zagonu aplikacije — izberemo, kaj želimo zagnati:
V okno SQL urejevalnika prilepimo tak preprost poizvedbo in pritisnemo Save and Run SQL:
CREATE OR REPLACE STREAM "DESTINATION_SQL_STREAM" ("cost" DOUBLE, "gate" VARCHAR(16));

CREATE OR REPLACE PUMP "STREAM_PUMP" AS INSERT INTO "DESTINATION_SQL_STREAM"
SELECT STREAM "cost", "gate"
FROM "SOURCE_SQL_STREAM_001"
WHERE "cost" < 5000
    and "gate" = 'Aeroflot';
V relacijskih bazah podatkov delate s tabelami, uporabljate operaterje INSERT za dodajanje zapisov in operater SELECT za poizvedovanje podatkov. V Amazon Kinesis Data Analytics delate s tokom (STREAM) in 'črpalkami' (PUMP) — kontinuiranimi poizvedbami vstavljanja, ki vstavljajo podatke iz enega toka v aplikaciji v drug tok.
V zgoraj prikazanem SQL poizvedbi poteka iskanje za Aéroflotovimi vozovnicami po ceni, ki je nižja od pet tisoč rubljev. Vsi zapisi, ki ustrezajo tem pogojem, bodo vključeni v tok DESTINATION_SQL_STREAM.
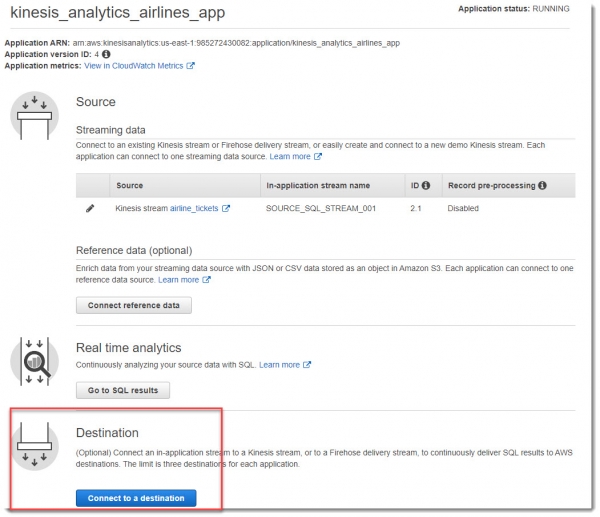
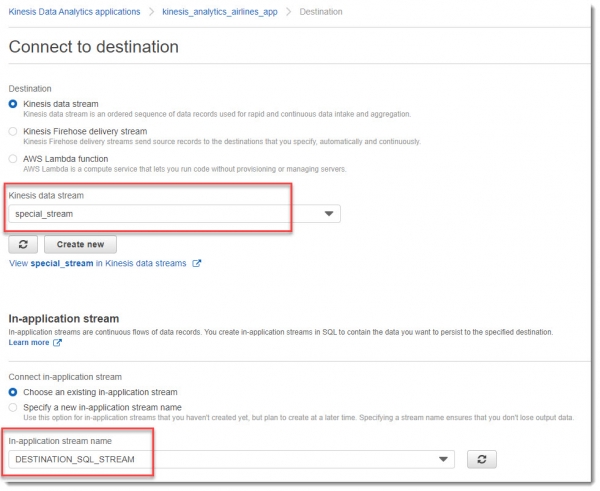
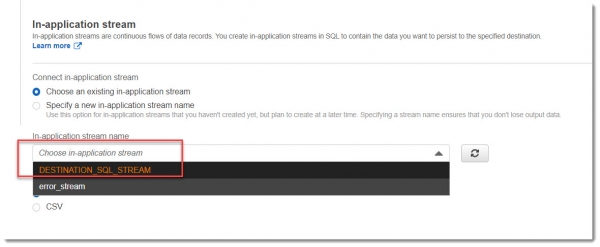
V bloku Destination izberemo tok special_stream, a v razklicnem seznamu In-application stream name DESTINATION_SQL_STREAM:
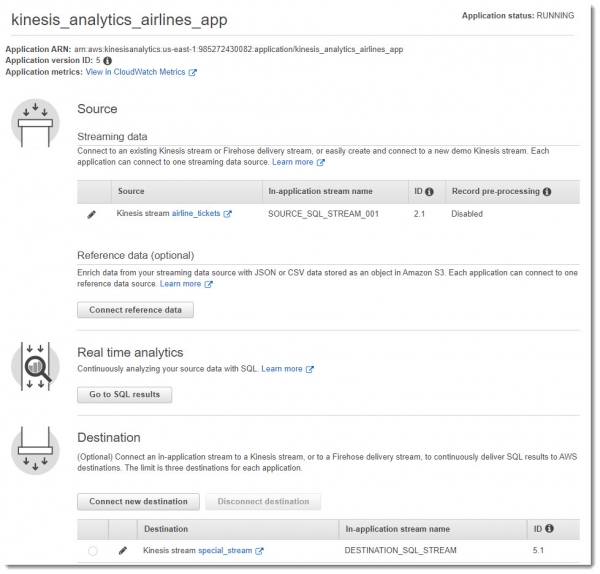
Kot rezultat vseh manipulacij bi moralo nastati nekaj, kar je podobno sliki spodaj:
Ustvarjanje in naročanje na SNS temo
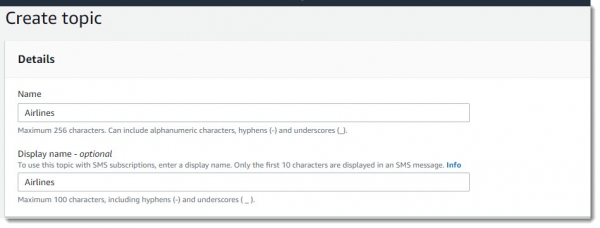
Preidemo v storitev Simple Notification Service in tam ustvarimo novo temo z imenom Airlines:
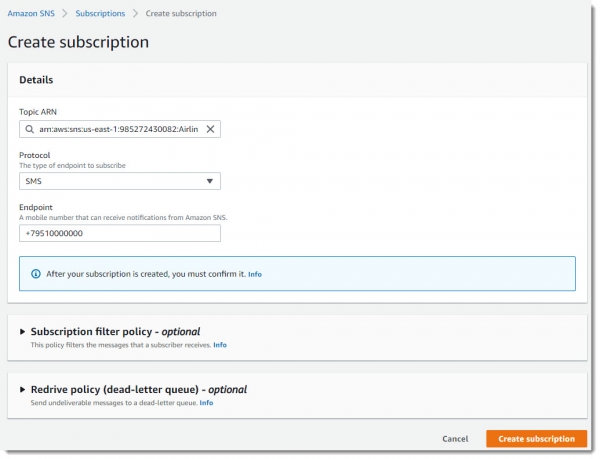
Naročimo se na to temo, pri čemer navedemo številko mobilnega telefona, na katero bodo prihajala SMS-obvestila:
Ustvarjanje tabele v DynamoDB
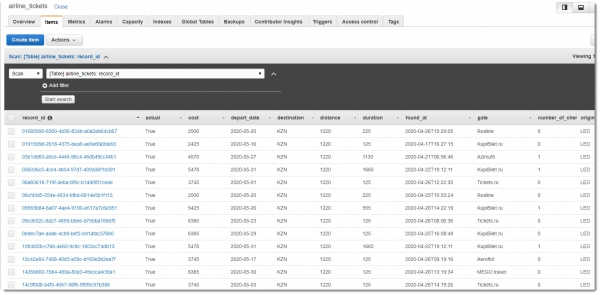
Za shranjevanje neobdelanih podatkov iz toka airline_tickets bomo ustvarili tabelo v DynamoDB z enakim imenom. Kot primarni ključ bomo uporabili record_id:
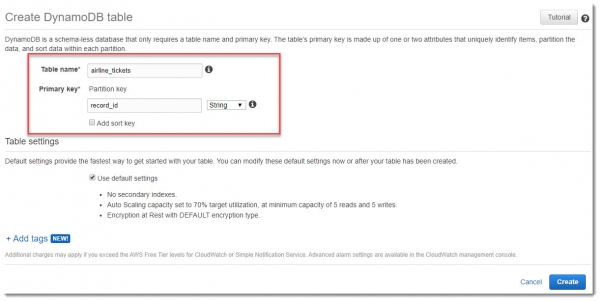
Ustvarjanje lambda funkcije collector
Ustvarili bomo lambda funkcijo z imenom Collector, katere naloga bo spremljanje toka airline_tickets in, v primeru najdbe novih zapisov, vstavljanje teh zapisov v tabelo DynamoDB. Očitno je, da mora ta lambda imeti poleg privzetih pravic dostop do branja toka podatkov Kinesis in pisanja v DynamoDB.
Ustvarjanje IAM vloge za lambda funkcijo collector
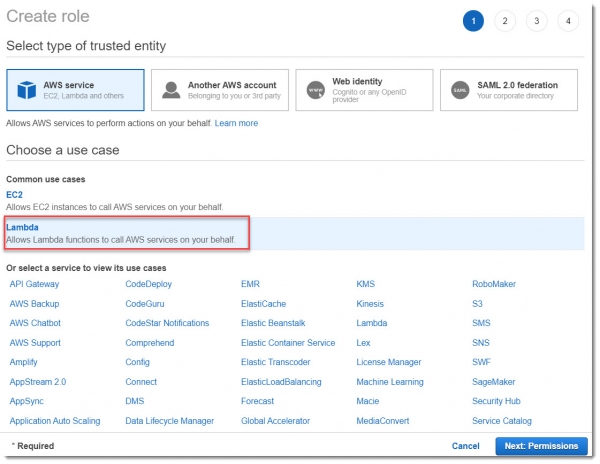
Najprej bomo ustvarili novo IAM vlogo za lambdo z imenom Lambda-TicketsProcessingRole:
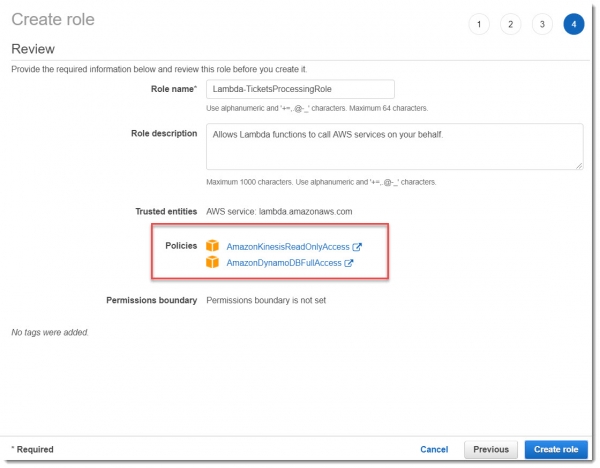
Za testni primer so povsem primerne prednastavljene politike AmazonKinesisReadOnlyAccess in AmazonDynamoDBFullAccess, kot je prikazano na sliki spodaj:
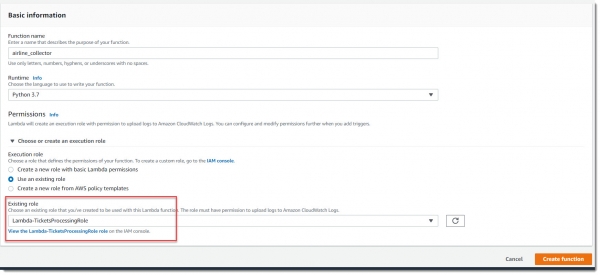
Ta lambda naj se sproži ob sprožilcu Kinesis, ko v tok airline_stream pridejo novi zapisi, zato je potrebno dodati nov sprožilec:
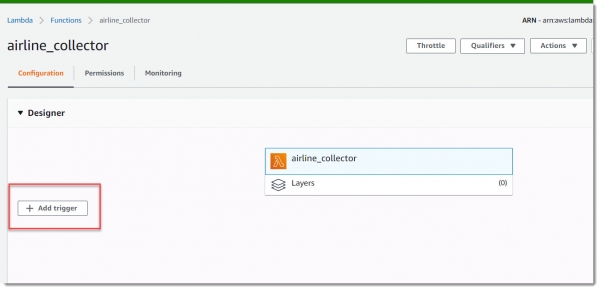
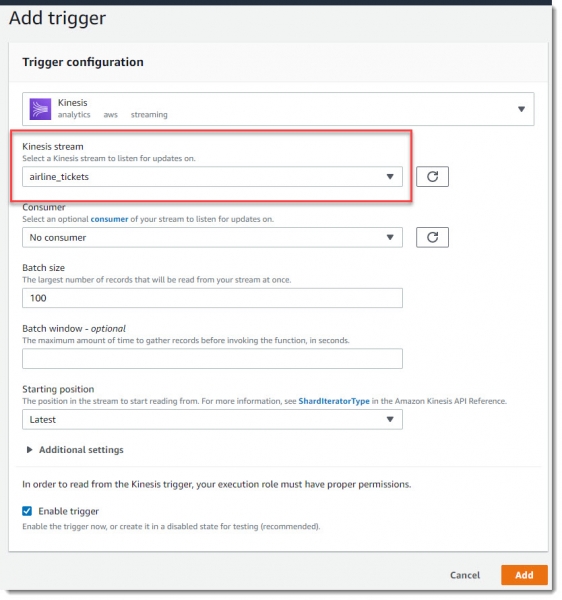
Preostane le še vstaviti kodo in shraniti lambdo.
"""Parsing the stream and inserting into the DynamoDB table."""
import base64
import json
import boto3
from decimal import Decimal

DYNAMO_DB = boto3.resource('dynamodb')
TABLE_NAME = 'airline_tickets'

class TicketsParser:
    """Parsing info from the Stream."""

    def __init__(self, table_name, records):
        """Init method."""
        self.table = DYNAMO_DB.Table(table_name)
        self.json_data = TicketsParser.get_json_data(records)

    @staticmethod
    def get_json_data(records):
        """Return deserialized data from the stream."""
        decoded_record_data = ([base64.b64decode(record['kinesis']['data'])
                                for record in records])
        json_data = ([json.loads(decoded_record)
                      for decoded_record in decoded_record_data])
        return json_data

    @staticmethod
    def get_item_from_json(json_item):
        """Pre-process the json data."""
        new_item = {
            'record_id': json_item.get('record_id'),
            'cost': Decimal(json_item.get('cost')),
            'trip_class': json_item.get('trip_class'),
            'show_to_affiliates': json_item.get('show_to_affiliates'),
            'origin': json_item.get('origin'),
            'number_of_changes': int(json_item.get('number_of_changes')),
            'gate': json_item.get('gate'),
            'found_at': json_item.get('found_at'),
            'duration': int(json_item.get('duration')),
            'distance': int(json_item.get('distance')),
            'destination': json_item.get('destination'),
            'depart_date': json_item.get('depart_date'),
            'actual': json_item.get('actual')
        }
        return new_item

    def run(self):
        """Batch insert into the table."""
        with self.table.batch_writer() as batch_writer:
            for item in self.json_data:
                dynamodb_item = TicketsParser.get_item_from_json(item)
                batch_writer.put_item(dynamodb_item)

        print('Has been added ', len(self.json_data), 'items')

def lambda_handler(event, context):
    """Parse the stream and insert into the DynamoDB table."""
    print('Got event:', event)
    parser = TicketsParser(TABLE_NAME, event['Records'])
    parser.run()
Ustvarjanje lambda funkcije notifier
Druga lambda funkcija, ki bo spremljala drugi tok (special_stream) in poslala obvestilo v SNS, se ustvari na podoben način. Ta lambda mora imeti dostop za branje iz Kinesis in pošiljanje sporočil v določen SNS kanal, ki ga bo nato storitev SNS poslala vsem naročnikom tega kanala (e-pošta, SMS itd.).
Ustvarjanje IAM vloge
Najprej ustvarimo IAM vlogo Lambda-KinesisAlarm za to lambda funkcijo, nato pa to vlogo dodelimo ustvarjeni lambda funkciji alarm_notifier:
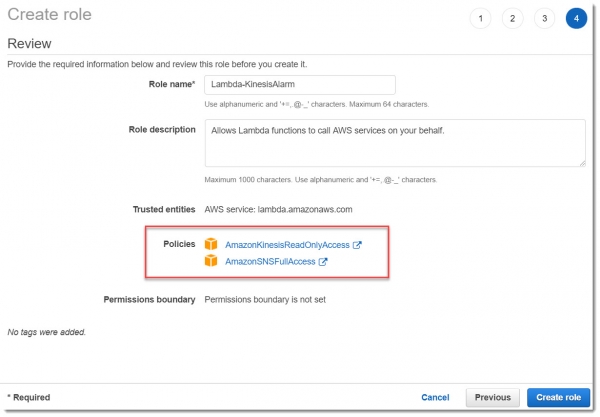
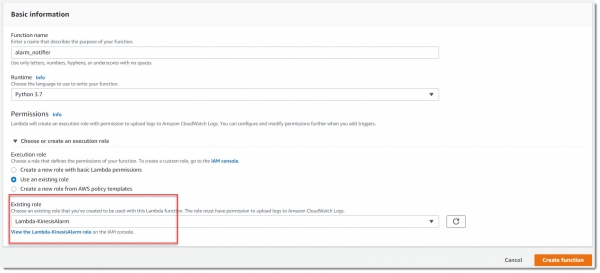
Ta lambda funkcija mora delovati na podlagi sprožilca za nove zapise v toku special_stream, zato je treba sprožilec nastaviti na podoben način, kot smo to storili za lambda funkcijo Collector.
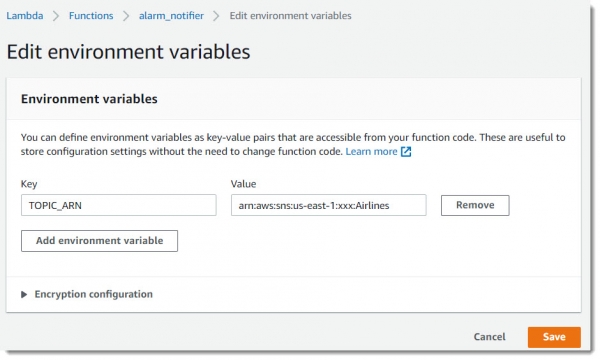
Za enostavnejšo nastavitev te lambda funkcije uvedimo novo spremenljivko okolja — TOPIC_ARN, kjer shranimo ARN (Amazon Recourse Names) kanala Airlines:
In prilepimo kodo lambda funkcije, ki ni zapletena:
import boto3
import base64
import os

SNS_CLIENT = boto3.client('sns')
TOPIC_ARN = os.environ['TOPIC_ARN']


def lambda_handler(event, context):
    try:
        SNS_CLIENT.publish(TopicArn=TOPIC_ARN,
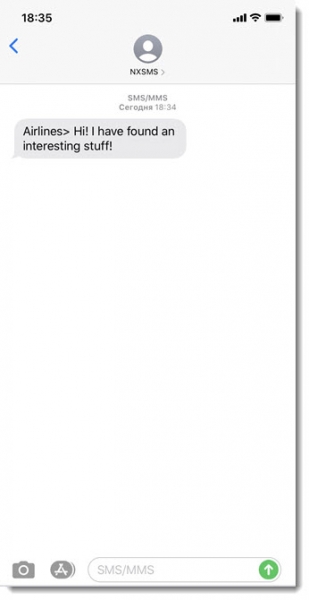
                           Message='Hi! I have found an interesting stuff!',
                           Subject='Airline tickets alarm')
        print('Alarm message has been successfully delivered')
    except Exception as err:
        print('Delivery failure', str(err))
Zdi se, da je ročno nastavitev sistema zaključena. Preostane le še, da vse preizkusimo in se prepričamo, da smo vse nastavili pravilno.
Implementacija iz Terraform kode
Potrebna priprava
— zelo priročno orodje z odprto kodo za uvajanje infrastrukture iz kode. Ima svojo sintakso, ki se jo je enostavno naučiti, ter veliko primerov, kako in kaj uvesti. V urejevalnikih Atom ali Visual Studio Code je na voljo mnogo priročnih vtičnikov, ki olajšajo delo s Terraform.
Distribucijo lahko prenesete . Podroben opis vseh funkcionalnosti Terraform presega obseg tega članka, zato se omejimo le na osnovne točke.
Kako zagnati
Celotna koda projekta se nahaja . Kloniramo repozitorij k sebi. Pred zagonom se je potrebno prepričati, da imate nameščen in nastavljen AWS CLI, saj bo Terraform iskal poverilnice v datoteki ~\/ .aws\/credentials.
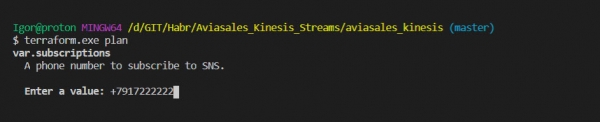
Dobra praksa je, da pred uvajanjem celotne infrastrukture zaženete ukaz plan, da vidite, kaj bo Terraform trenutno ustvaril v oblaku:
terraform.exe planPredlagano bo vnesti telefonsko številko, na katero bodo poslane obvestila. V tej fazi njen vnos ni obvezen.
Po analizi delovnega načrta programa lahko začnemo z ustvarjanjem virov:
terraform.exe applyPo pošiljanju tega ukaza se bo spet pojavilo vprašanje za vnos telefonske številke, vpišite 'yes', ko se prikaže vprašanje o dejanskem izvajanju dejanj. To bo omogočilo postavitev celotne infrastrukture, izvedbo potrebne nastavitve EC2, uvajanje Lambda funkcij itd.
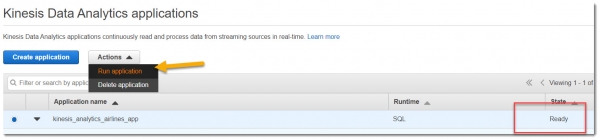
Ko so vsi viri uspešno ustvarjeni preko Terraform kode, morate dostopiti do podrobnosti aplikacije Kinesis Analytics (žal nisem našel, kako to storiti neposredno iz kode).
Zagnati moramo aplikacijo:
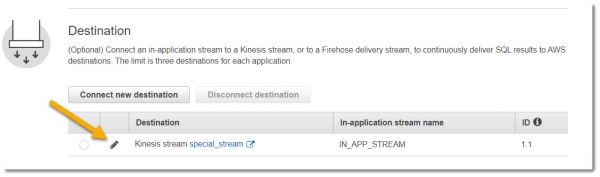
Nato je potrebno izrecno določiti ime pretoka znotraj aplikacije, izbira pa se iz spustnega seznama:
Sedaj je vse pripravljeno za delo.
Testiranje delovanja aplikacije
Ne glede na to, kako ste uvedli sistem, ročno ali preko Terraform kode, delovala bo enako.
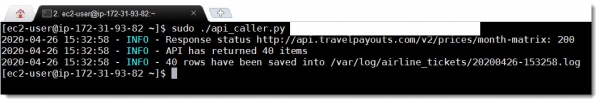
Prijavite se preko SSH na virtualni stroj EC2, na kojem je instaliran Kinesis Agent, i pokrenite skriptu api_caller.py
sudo ./api_caller.py TOKENSada je potrebno pričekati SMS na vaš broj:
SMS — poruka dolazi na telefon gotovo za 1 minut:
Preostaje provjeriti jesu li zapisi sačuvani u bazi podataka DynamoDB za daljnju, detaljniju analizu. Tablica airline_tickets sadrži okvirno ovakve podatke:
Zaključek
Tijekom ovog rada izgrađen je sustav online obrade podataka na bazi Amazon Kinesis. Razmatrane su mogućnosti korištenja Kinesis Agenta u kombinaciji s Kinesis Data Streams i analitikom u realnom vremenu putem SQL komandi, kao i interakcija Amazon Kinesis s drugim AWS uslugama.
Gore opisani sustav postavili smo na dva načina: sporim ručnim putem i brzim putem putem Terraform koda.
Sav izvorni kod projekta dostupan je , predlažem da ga pregledate.
Rado bih razgovarao o članku, čekam vaše komentare. Nadam se konstruktivnoj kritici.
Želim vam uspeh!
Izvor: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish