

Prevod članka je pripravljen posebej za študente tečaja .
— разработчик программного обеспечения, фанат Go и любитель решать сложные задачи. Также он мэйнтейнер Prometheus и соучредитель Kubernetes SIG instrumentation. В прошлом он был production-инженером в SoundCloud и возглавлял группу мониторинга в CoreOS. В настоящее время работает в Google.
— инфраструктурный инженер в Improbable. Увлекается новыми технологиями и проблемами распределенных систем. Имеет опыт низкоуровневого программирования в Intel, опыт контрибьютора в Mesos и production-опыт SRE мирового масштаба в Improbable. Занимается улучшением мира микросервисов. Три его любви: Golang, open source и волейбол.
Глядя на наш флагманский продукт SpatialOS, вы можете догадаться, что для Improbable нужна высокодинамичная облачная инфраструктура глобального масштаба с десятками кластеров Kubernetes. Мы были одними из первых, кто начал использовать систему мониторинга . Prometheus способен отслеживать миллионы метрик в реальном времени и поставляется с мощным языком запросов, позволяющим извлекать необходимую информацию.
Простота и надежность Prometheus является одним из основных его преимуществ. Однако, пройдя определенный масштаб, мы столкнулись с несколькими недостатками. Для решения этих проблем мы разработали — проект с открытым исходным кодом, созданный компанией Improbable, для бесшовной трансформации существующих кластеров Prometheus в единую систему мониторинга с неограниченным хранилищем исторических данных. Thanos доступен на Github .
Наши цели с Thanos
При определенном масштабе возникают проблемы, выходящие за рамки возможностей ванильного Prometheus. Как надежно и экономно хранить петабайты исторических данных? Можно ли это сделать без ущерба времени ответа на запрос? Можно ли получить доступ ко всем метрикам, расположенных на разных серверах Prometheus, с помощью одного API-запроса? Можно ли каким-то образом объединить реплицированные данные, собранные с помощью Prometheus HA?
Для решения этих вопросов мы создали Thanos. В следующих разделах описывается как мы подошли к решению этих вопросов и объясняются цели, которые мы преследовали.
Запрос данных с нескольких экземпляров Prometheus (global query)
Prometheus ponuja funkcionalen pristop k delitvi podatkov. Tudi en sam Prometheus strežnik zagotavlja potrebno skalabilnost, da uporabnike osvobodi zapletenosti horizontalne delitve v skoraj vseh primerih uporabe.
Čeprav je to odlična razporeditev, pogosto potrebujemo dostop do podatkov na različnih Prometheus strežnikih preko enotnega API-jev ali uporabniškega vmesnika — globalnega pregleda. Seveda obstaja možnost prikaza več poizvedb na eni Grafana plošči, vendar se lahko vsaka poizvedba izvede le na enem Prometheus strežniku. Po drugi strani pa z uporabo Thanos lahko zahtevaš in aggreagiraš podatke z več Prometheus strežnikov, saj so vsi dostopni z ene končne točke.
Prej, za pridobitev globalnega pregleda v Improbable, smo organizirali naše Prometheus instance v večstopenjsko . To je pomenilo ustvariti en meta-strežnik Prometheus, ki zbira del metrik z vsakega “listnega" strežnika.
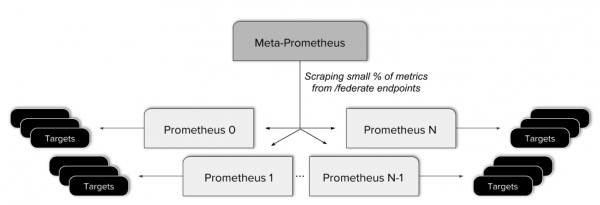
Ta pristop se je izkazal za problematičnega. Privedel je do zapletenosti konfiguracije, dodal dodatno potencialno točko okvare in uporabil zapletena pravila za zagotavljanje federirane končne točke samo potrebnih podatkov. Poleg tega ta vrsta federacije ne omogoča pravega globalnega pregleda, saj vsi podatki niso dostopni z enega API klica.
S tem je povezano enotno prikazovanje podatkov, zbranih na visoko razpoložljivih (high-availability, HA) Prometheus strežnikih. HA model Prometheus neodvisno zbira podatke dvakrat, kar je tako enostavno, da ne more biti enostavnejše. Vendar bi bilo veliko bolj udobno uporabljati združeno in deduplicirano predstavitev obeh tokov.
Seveda obstaja potreba po visoko razpoložljivih Prometheus strežnikih. V Improbable resno obravnavamo enourno spremljanje podatkov, vendar ima en sam instance Prometheus v klasterju enotno točko okvare. Kakršna koli napaka v konfiguraciji ali okvara strojne opreme lahko potencialno privede do izgube pomembnih podatkov. Tudi preprost razporeditev lahko povzroči manjše napake pri zbiranju metrik, saj se lahko ponovno zagon znatno podaljša v primerjavi s časom zajema.
Zanesljivo shranjevanje zgodovinskih podatkov
Cene dostopno, hitro in dolgotrajno shranjevanje metrik je naš sanjski cilj (ki ga deli večina uporabnikov Prometheusa). V podjetju Improbable smo bili prisiljeni nastaviti čas shranjevanja metrik na devet dni (za Prometheus 1.8). To očitno omejuje, kako daleč nazaj se lahko poglobimo.
Prometheus 2.0 je na tem področju boljši, saj število časovnih serij več ne vpliva na skupno zmogljivost strežnika (glej ). Kljub temu Prometheus hrani podatke na lokalnem disku. Čeprav lahko visoko učinkovito stiskanje podatkov znatno zmanjša uporabo lokalnega SSD, še vedno obstaja omejitev glede količine shranjenih zgodovinskih podatkov.
Poleg tega v podjetju Improbable skrbimo za zanesljivost, enostavnost in stroške. Veliki lokalni diski so težji za upravljanje in varnostno kopiranje. So dražji in zahtevajo več orodij za varnostno kopiranje, kar prinaša nepotrebno kompleksnost.
Zmanjševanje
Ko smo začeli delati z zgodovinskimi podatki, smo ugotovili, da obstajajo temeljne težave z O-velikostjo, ki povzročajo, da so poizvedbe vse počasnejše, če delamo s podatki, ki segajo tedne, mesece in leta nazaj.
Standardna rešitev za to težavo je — zmanjšanje frekvence vzorčenja signala. S pomočjo zmanjšanja vzorčenja lahko "zmanjšamo obseg" na daljše časovno obdobje in ohranimo enako število vzorcev, kar omogoča, da poizvedbe ostanejo hitre.
Zmanjševanje starih podatkov je neizbežen zahtevek katere koli rešitve za dolgoročno shranjevanje in presega osnovni Prometheus.
Dodatni cilji
Eden od prvotnih ciljev projekta Thanos je bila brezšivna integracija z obstoječimi namestitvami Prometheusa. Drugi cilj je bil enostavna uporaba z minimalnimi vstopnimi ovirami. Vse odvisnosti morajo biti enostavno zadovoljive tako za majhne kot velike uporabnike, kar pomeni tudi majhne osnovne stroške.
Arhitektura Thanos
Potem ko so bili v prejšnjem razdelku navedeni naši cilji, se osredotočimo na to, kako Thanos rešuje te izzive.
Globalni pogled
Da bi dobili globalni pogled preko postojećih instanci Prometheusa, potrebno je povezati jedinstvenu tačku ulaza za zahteve sa svim serverima. Ovo je ono što radi komponenta Thanos. . On se raspoređuje pored svakog Prometheus servera i funkcioniše kao proxy, pružajući lokalne podatke Prometheusa preko gRPC interfejsa Store API, omogućavajući izbor time series podataka po oznakama i vremenskom opsegu.
S druge strane je horizontalno skalabilna komponenta Querier bez stanja, koja radi nešto više od prostog odgovaranja na PromQL zahteve preko standardnog Prometheus HTTP API. Komponente Querier, Sidecar i drugi Thanos međusobno komuniciraju putem .
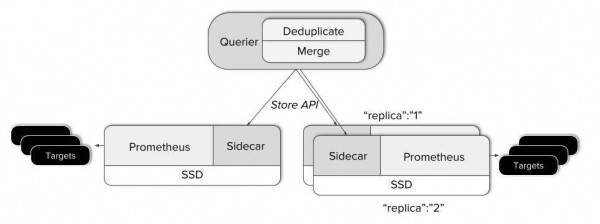
- Querier, kada primi zahtev, povezuje se sa odgovarajućim serverom Store API, odnosno sa našim Sidecar-ima i dobija time series podatke sa odgovarajućih Prometheus servera.
- Nakon toga, on kombinuje odgovore i izvršava PromQL zahtev. Querier može kombinovati kako nepreklapajuće podatke, tako i duplicirane podatke sa HA servera Prometheus.
Ovo rešava većinu naše glavobolje — kombinovanje podataka sa izolovanih Prometheus servera u jedinstven prikaz. U suštini, Thanos se može koristiti samo zbog ove mogućnosti. Nema potrebe za promenom postojećih Prometheus servera!
Neograničeno vreme zadržavanja!
Međutim, pre ili kasnije želećemo da sačuvamo podatke koji prevazilaze uobičajeno vreme zadržavanja Prometheusa. Za čuvanje istorijskih podataka odabrali smo objektno skladište. Ono je široko dostupno u bilo kom oblaku, kao i u lokalnim DC-ima i veoma je ekonomično. Osim toga, praktično svako objektno skladište je dostupno preko dobro poznatog S3 API.
Prometheus snima podatke iz RAM-a na disk otprilike svaka dva sata. Blok sačuvanih podataka sadrži sve podatke za fiksni vremenski interval i ne može se menjati. Ovo je veoma praktično, jer Thanos Sidecar može jednostavno da pregleda katalog podataka Prometheusa i, kako se pojave novi blokovi, učitava ih u kante objektno skladište.
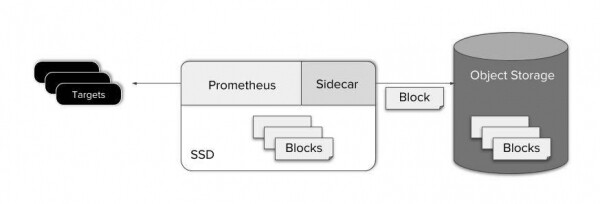
Učitavanje u objektno skladište neposredno nakon snimanja na disk takođe pomaže u održavanju jednostavnosti „scraper-a“ (Prometheus i Thanos Sidecar). Što olakšava podršku, troškove i dizajn sistema.
Kot vidite, varovanje podatkov je zelo preprosto. Kaj pa zahteva za podatke v objektni shrambi?
Komponenta Thanos Store deluje kot proxy za pridobivanje podatkov iz objektne shrambe. Tako kot Thanos Sidecar sodeluje v gossip grozdu in implementira Store API. Tako lahko obstoječi Querierji to obravnavajo kot Sidecar, kot dodaten vir podatkov časovnih serij — posebna nastavitev ni potrebna.
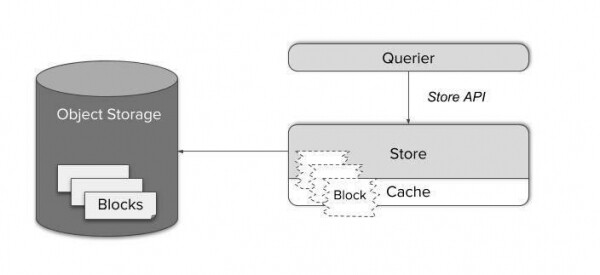
Bloki podatkov časovnih serij so sestavljeni iz več velikih datotek. Nalaganje le-teh po potrebi bi bilo precej neučinkovito, lokalno predpomnjenje pa bi zahtevalo ogromno pomnilnika in diskovnega prostora.
Namesto tega Store Gateway ve, kako ravnati s formatom shranjevanja Prometheus. Z pametnim načrtovalnikom poizvedb in predpomnjenjem le potrebnih indeksnih delov blokov je mogoče zmanjšati zapletene poizvedbe na minimalno število HTTP zahtevkov do datotek v objektni shrambi. Tako je možno zmanjšati število zahtevkov za štiri do šest vrstic in doseči čas odziva, ki ga je v celoti težko ločiti od zahtevkov za podatke na lokalnem SSD.
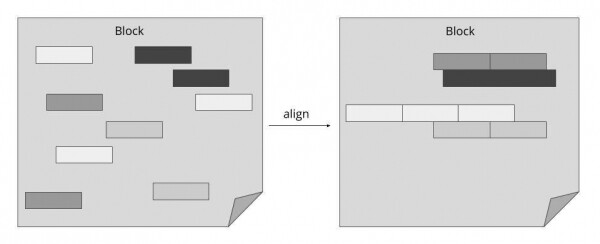
Kot je prikazano na zgornjem diagramu, Thanos Querier znatno znižuje stroške za en zahtevek po podatkih v objektni shrambi s pomočjo formata shranjevanja Prometheus in s postavitvijo povezanih podatkov blizu skupaj. S to metodo lahko združimo številne posamezne zahteve v minimalno število obsežnih operacij.
Stisnjenje in downsampling
Ko je nov blok podatkov časovne serije uspešno naložen v objektno shrambo, ga obravnavamo kot 'zgodovinske' podatke, ki so takoj na voljo preko Store Gateway.
Kmalu se blokadi iz enega vira (Prometheus s Sidecar) kopičijo in ne izkoriščajo več celotnega potenciala indeksiranja. Za reševanje tega problema smo uvedli še eno komponento z imenom Compactor. Ta preprosto uporablja lokalni mehanizem stiskanja Prometheus za zgodovinske podatke v objektni shrambi in se lahko izvaja kot preprosto periodicno paketno delo.
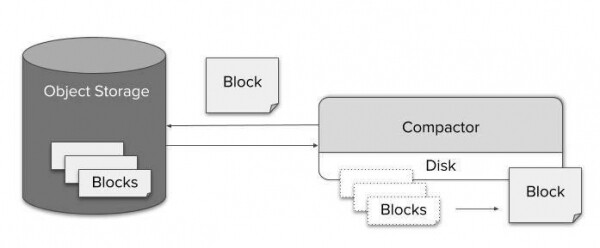
Zaradi učinkovitega stiskanja dolgoročni dostop do shrambe ne predstavlja težav z vidika velikosti podatkov. Vendar pa lahko potencialni stroški razpakiranja milijarde vrednosti in njihovo obdelovanje prek procesa povpraševanja neizogibno privedejo do drastičnega povečanja časa izvajanja poizvedbe. Po drugi strani pa, ker na vsak pičel ekrana pride na stotine podatkovnih točk, postane skoraj nemogoče vizualizirati podatke v polni ločljivosti. Tako da je daunsampling ne samo mogoč, ampak tudi ne bo privedel do opazne izgube natančnosti.
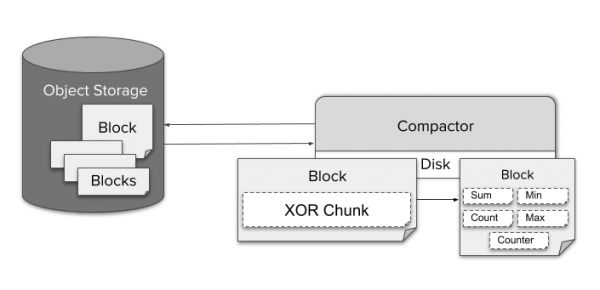
Za daunsampling podatkov Compactor neprekinjeno agregira podatke z ločljivostjo petih minut in ene ure. Za vsak neobdelan fragment, kodiran z uporabo TSDB XOR-stiskanja, se hranijo različne vrste agregiranih podatkov, kot so min, max ali sum za en blok. To omogoča Querierju samodejno izbiro agrega, ki ustreza danemu PromQL vprašanju.
Za uporabo podatkov z nižjo natančnostjo uporabnik ne potrebuje nobene posebne konfiguracije. Querier samodejno preklaplja med različnimi ločljivostmi in neobdelanimi podatki, ko uporabnik povečuje ali zmanjšuje obseg. Po želji lahko uporabnik to neposredno upravlja s pomočjo parametra 'step' v poizvedbi.
Ker je strošek shranjevanja enega GB majhen, Thanos po privzetku hrani izvorne podatke, podatke z ločljivostjo petih minut in ene ure. Ni potrebe po brisanju izvornih podatkov.
Pravila za snemanje
Tudi s Thanosom so pravila za snemanje bistven del monitoringa. Zmanjšujejo kompleksnost, zakasnitev in stroške poizvedb. Prav tako so uporabnikom priročna za pridobitev agregiranih podatkov o metrikah. Thanos temelji na vanilijevih izvodih Prometheusa, zato je povsem sprejemljivo hraniti pravila za snemanje in pravila za opozarjanje na obstoječem strežniku Prometheus. Vendar pa v nekaterih primerih to morda ni dovolj:
- Globalni alerti in pravila (na primer, opozorilo, ko storitev ne deluje na več kot dveh od treh grozdov).
- Pravila za podatke zunaj lokalne shrambe.
- Težnja po shranjevanju vseh pravil in opozoril na enem mestu.
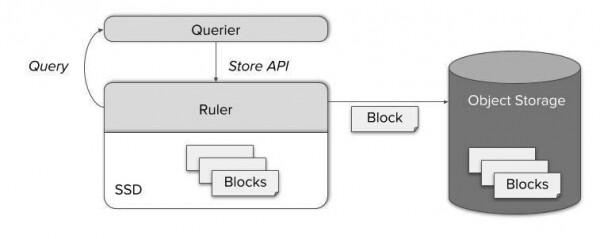
Za vse te primere Thanos vključuje ločen komponent, imenovan Ruler, ki izračuna pravila in opozorila preko Thanos Queries. S ponudbo dobro poznane StoreAPI, lahko vozlišče Query dostopa do svežo izračunane metrike. Kasneje jih shranimo v objektno skladišče, kjer so dostopne preko Store Gateway.
Moč Thanosa
Thanos je dovolj prilagodljiv, da ga je mogoče nastaviti po vaših zahtevah. To je še posebej koristno pri migraciji iz preprostega Prometheusa. Poglejmo hitro na majhnem primeru, kar smo se naučili o komponentah Thanosa. Tako lahko preselite vaš osnovni Prometheus v svet 'neomejenega shranjevanja metrik':
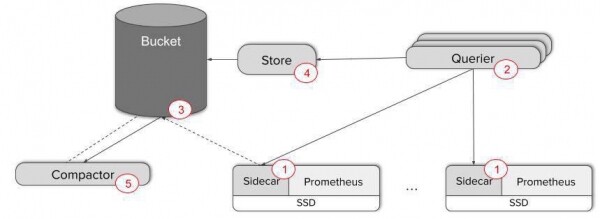
- Dodajte Thanos Sidecar vašim Prometheus strežnikom - na primer, sosednji kontejner v Kubernetes pod.
- Nadgradite več replik Thanos Querier za ogled podatkov. V tej fazi je enostavno nastaviti gossip med Scraper in Querier. Za preverjanje delovanja komponent uporabite metriko ‘thanos_cluster_members’.
Samo ti dve korak sta dovolj, da zagotovita globalni pogled in brezšivno deduplikacijo podatkov od potencialnih HA replik Prometheus! Preprosto povežite svoje nadzorne plošče z HTTP konektivno točko Querier ali pa uporabite Thanos UI neposredno.
Vendar, če potrebujete varnostno kopiranje metrik in dolgoročno shranjevanje, boste morali opraviti še tri korake:
- Ustvarite AWS S3 ali GCS košarico. Nastavite Sidecar za kopiranje podatkov v te košarice. Zdaj lahko zmanjšate lokalno shranjevanje podatkov.
- Namestite Store Gateway in ga povežite z obstoječim gossip grozdom. Zdaj lahko pošiljate poizvedbe za podatke v varnostnih kopijah!
- Nadgradite Compactor, da izboljšate učinkovitost poizvedb za daljše časovne intervale, z uporabo zgoščanja in downsampling-a.
Če se želite naučiti več, nas ne oklevajte, poglejte naše in !
V samo petih korakih smo Spremenili Prometheus v zanesljiv sistem za spremljanje z globalnim pogledom, neomejenim časom shranjevanja in potencialno visoko razpoložljivostjo metrik.
Pull request: potrebujemo vas!
Že od samega začetka je bil projekt z odprto kodo. Brezšivna integracija s Prometheusom in možnost uporabe le dela Thanosa ga naredi odlično izbiro za širitev sistema spremljanja brez odvečnega truda.
Vedno smo veseli GitHub Pull Request in Issues. V tem času se ne obotavljajte, da nam pišete prek Github Issues ali slack., če imate vprašanja ali povratne informacije, ali želite deliti svoje izkušnje z nami! Če vam je všeč, kar počnemo v Improbable, se ne obotavljajte, da se obrnete na nas — !
Izvor: habr.com
