

SQL, kaj bi lahko bilo lažje? Vsak od nas lahko napiše preprost poizvedbo — vnesemo select, našteli potrebne stolpce, nato from, ime tabele, nekaj pogojev v kjer in to je to — koristni podatki so v naših rokah, skoraj ne glede na to, katera DBMS trenutno deluje v ozadju (ali pa morda ). Posledično lahko delo z vsakim virom podatkov (relacijskim in drugim) obravnavamo iz vidika običajnega kode (s vsemi iz tega izhajajočimi — nadzor verzij, pregled kode, statična analiza, avtomatski testi in vse to). In to se nanaša ne samo na same podatke, sheme in migracije, temveč na celotno delovanje skladišča. V tem članku se bomo pogovarjali o vsakdanjih nalogah in izzivih pri delu z različnimi bazami podatkov z vidika "baze podatkov kot kode".
In začeli bomo naravnost z . Prvi boji tipa "SQL proti ORM" so bili opazni že v .
Objektno-relacijsko mapiranje
Podporniki ORM tradicionalno cenijo hitrost in enostavnost razvoja, neodvisnost od DBMS in čistost kode. Za mnoge od nas koda za delo z bazami podatkov (in pogosto tudi sama baza podatkov)
ponavadi izgleda približno tako…
@Entity
@Table(name = "stock", catalog = "maindb", uniqueConstraints = {
        @UniqueConstraint(columnNames = "STOCK_NAME"),
        @UniqueConstraint(columnNames = "STOCK_CODE") })
public class Stock implements java.io.Serializable {

    @Id
    @GeneratedValue(strategy = IDENTITY)
    @Column(name = "STOCK_ID", unique = true, nullable = false)
    public Integer getStockId() {
        return this.stockId;
    }
  ...
Model je obdarjen z pametnimi anotacijami, nekje v ozadju pa častitljivi ORM generira in izvaja tone nekega SQL-kode. Mimogrede, razvijalci si z vsemi močmi prizadevajo, da bi se od svoje baze podatkov zaščitili s kilometri abstrakcij, kar kaže na določeno .
Na drugi strani barikade podporniki čistega "handmade"-SQL opozarjajo na možnost iztisniti vse sokove iz svoje DBMS brez dodatnih plasti in abstrakcij. Rezultat je, da nastajajo "data-centric" projekti, kjer se s podatkovnimi bazami ukvarjajo posebej usposobljeni ljudje (ti so tudi "bazisti", "bazoviki", "bazedničarji" itd.), razvijalcem pa ostane le, da "potegnejo" pripravljene poglede in shranjene procedure, ne da bi se preveč poglabljali v podrobnosti.
Kaj pa, če bi vzeli najboljše iz obeh svetov? Kako je to izvedeno v čudovitem orodju z življenjskim imenom . Navedel bom nekaj vrstic iz splošne koncepcije v mojem svobodnem prevodu, podrobneje pa se z njo lahko seznanite .
Clojure je odličan jezik za kreiranje DSL-ova, ali SQL je već sam po sebi odličan DSL i ne treba nam još jedan. S-expression su divni, ali ovde ne dodaju ništa novo. Na kraju dobijamo zagrade radi zagrada. Ne slažete se? Onda čekajte trenutak kada apstrakcija iznad Baze Podataka počne da propisuje, i započećete borbu s funkcijom (raw-sql)
Šta raditi? Ostavimo SQL običnim SQL-om — jedna datoteka za jedan upit:
-- name: users-by-country
select *
  from users
 where country_code = :country_code
… i zatim pročitajte ovu datoteku, pretvarajući je u običnu Clojure funkciju:
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; Funkcija sa imenom `users-by-country` je kreirana.
;;; Iskoristimo je:
(users-by-country {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
Pridržavajući se principa "SQL odvojeno, Clojure odvojeno", dobijate:
- Nema sintaktičkih iznenađenja. Vaša baza podataka (kao i svaka druga) ne odgovara SQL standardu 100% — ali za Yesql to nije važno. Nikada nećete trošiti vreme na lov na funkcije čija je sintaksa ekvivalentna SQL-u. Nikada se nećete vraćati funkciji (raw-sql "some (‘funky’ :: SYNTAX)")).
- Najbolja podrška uredniku. Vaš urednik već ima odličnu podršku za SQL. Održavajući SQL kao SQL, jednostavno ga možete koristiti.
- Kompatibilnost za timsku saradnju. Vaši DBA mogu čitati i pisati SQL koji koristite u svom Clojure projektu.
- Jednostavnija optimizacija performansi. Treba da izradite plan za problematičan upit? Nema problema kada je vaš upit običan SQL.
- Ponovna upotreba upita. Premestite te iste SQL datoteke u druge projekte, zato što je to jednostavni stari dobri SQL — samo podelite.
Po mom mišljenju, ideja je veoma cool i istovremeno vrlo jednostavna, što je projektu donelo mnogo na različitim jezicima. A mi ćemo dalje pokušati primeniti sličnu filozofiju razdvajanja SQL koda od svega ostalog daleko van ORM-a.
IDE & DB-upravitelji
Začnimo z enostavno vsakodnevno nalogo. Pogosto moramo iskati določene objekte v bazi podatkov, na primer najti tabelo v shemi in raziskati njeno strukturo (katere stolpce, ključe, indekse, omejitve in drugo uporablja). Od vsake grafične IDE ali vsaj dostojnega upravljalnika baz podatkov pričakujemo predvsem te sposobnosti. Želimo, da bi bilo hitro in da nam ne bi bilo treba čakati pol ure, da se prikaže okno z željenimi informacijami (še posebej pri počasni povezavi z oddaljeno bazo podatkov), in da so pridobljene informacije sveže in aktualne, ne pa zastarele in predpomnjene. In bolj ko je baza kompleksna in večje je število baz, težje je to doseči.
A običajno miška odložim in preprosto pišem kodo. Recimo, da je treba ugotoviti, katere tabele (in kakšne lastnosti) se nahajajo v shemi "HR". V večini sistemov za upravljanje baz podatkov lahko želene rezultate dosežemo s takšno enostavno poizvedbo iz information_schema:
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
V različnih bazah se vsebina takšnih tabel-imenikov razlikuje glede na zmožnosti posameznih sistemov za upravljanje baz podatkov. Na primer, za MySQL je iz tega istega imenika mogoče pridobiti specifične za ta sistem parametre tabele:
select table_name
     , storage_engine -- Uporabljen "motor" ("MyISAM", "InnoDB" itd.)
     , row_format     -- Oblika vrstice ("Fixed", "Dynamic" itd.)
     , ...
  from information_schema.tables
 where schema = 'HR'
Oracle ne podpira information_schema, a ima , in ni večjih težav:
select table_name
     , pct_free       -- Minimalen delež prostega prostora v podatkovnem bloku (%)
     , pct_used       -- Minimalen delež uporabljenega prostora v podatkovnem bloku (%)
     , last_analyzed  -- Datum zadnjega zbiranja statistike
     , ...
  from all_tables
 where owner = 'HR'
Tudi ClickHouse ni izjema:
select name
     , engine -- Uporabljen "motor" ("MergeTree", "Dictionary" itd.)
     , ...
  from system.tables
 where database = 'HR'
Nekaj podobnega je mogoče narediti tudi v Cassandri (kjer so columnfamilies namesto tabel in keyspacei namesto shem):
select columnfamily_name
     , compaction_strategy_class  -- Strategija zbiranja odpadkov
     , gc_grace_seconds           -- Čas življenja odpadkov
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
Za večino drugih baz podatkov je prav tako mogoče oblikovati podobne poizvedbe (tudi v Mongu obstaja , ki vsebuje informacije o vseh zbirkah v sistemu).
Seveda, na ta način lahko pridobimo informacije ne samo o tabelah, ampak sploh o katerem koli objektu. Občasno dobri ljudje delijo takšno kodo za različne DB, kot na primer v seriji člankov na Habrju "Funkcije za dokumentacijo podatkovnih baz PostgreSQL" (, , ). Seveda, obdržati vse te zahtevke v spominu in jih nenehno vnašati je "kar tako" doživetje, zato imam v svojem priljubljenem IDE/u uredniku vnaprej pripravljen sklop fragmentov za pogosto uporabljene zahtevke, ostane le še, da vpišem imena objektov v predlogo.
Na koncu je tak način navigacije in iskanja objektov veliko bolj fleksibilen, prihrani veliko časa in omogoča pridobivanje točno tistih informacij in v tisti obliki, kot je trenutno potrebno (kot je opisano v objavi ).
Operacije z objekti
Potem ko smo našli in proučili potrebne objekte, je pravi čas, da z njimi storimo nekaj koristnega. Seveda, brez pretrganja prstov s tipkovnice.
Ni skrivnost, da bo preprosto brisanje tabele izgledalo enako skoraj v vseh DB:
drop table hr.personsPri ustvarjanju tabele pa je že bolj zanimivo. Praktčno vsak DBMS (vključno z mnogimi NoSQL) ima na tako ali drugačen način možnost "create table", in njen osnovni del se bo zelo malo razlikoval (ime, seznam stolpcev, tipi podatkov), vendar se lahko druge podrobnosti drastično razlikujejo in so odvisne od notranje strukture ter zmožnosti konkretnega DBMS. Moj najljubši primer — v dokumentaciji Oracle so samo "gole" BNF za sintakso "create table" . Drugi DBMS-i imajo bolj skromne možnosti, toda vsak od njih ima tudi številne zanimive in edinstvene funkcionalnosti za ustvarjanje tabel (, , , ). Malo verjetno je, da bo kakšen grafični "čarovnik" iz novejšega IDE (še posebej univerzalnega) lahko popolnoma pokril vse te zmogljivosti, če pa lahko, bo to predstava, ki ni za tiste s šibkimi živci. Hkrati pa pravilno in pravočasno napisan operator create table vam bo omogočil, da brez težav izkoristite vse te možnosti, kar bo vašim podatkom omogočilo zanesljivo, optimalno in maksimalno udobno shranjevanje in dostop.
Prav tako imajo mnoge DBMS svoje specifične tipe objektov, ki manjkajo v drugih DBMS. Uporabimo lahko operacije ne le nad objekti podatkovne baze, ampak tudi nad samo DBMS, na primer "ubijemo" proces, sprostimo določeno območje pomnilnika, vključimo sledenje, preklopimo v način "samo za branje" in še veliko več.
Zdaj pa malo narišimo
Ena od najpogostejših nalog je zgraditi diagram z objekti podatkovne baze, videti objekte in povezave med njimi na lepi sliki. To zna praktično vsaka grafična IDE, posamezne "command line" pripomočke, specializirana grafična orodja in modelirniki. Ki vam narišejo "kar znajo", nekoliko pa lahko vplivate na ta proces le s pomočjo nekaterih parametrov v konfiguracijski datoteki ali kljukic v vmesniku.
Toda to težavo lahko rešimo mnogo preprosteje, bolj fleksibilno in elegantno, seveda pa s pomočjo kode. Za gradnjo diagramov katerekoli zapletenosti imamo na voljo več specializiranih označevalnih jezikov (DOT, GraphML itd.), za njih pa cela vrsta aplikacij (GraphViz, PlantUML, Mermaid), ki znajo brati takšne navodila in vizualizirati v najrazličnejših formatih. Informacije o objektih in povezavah med njimi pa že vemo, kako pridobiti.
Poglejmo si majhen primer, kako bi to lahko izgledalo, z uporabo PlantUML in (levo SQL poizvedba, ki bo generirala potrebno navodilo za PlantUML, desno pa rezultat):
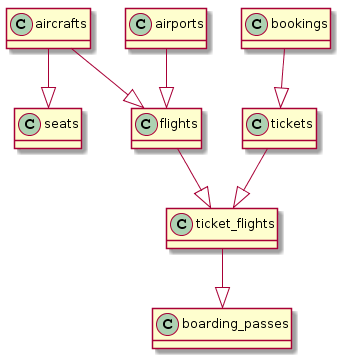
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
In če se nekoliko potrudimo, lahko na podlagi dobimo nekaj močno podobnega pravi ER diagramu:
SQL poizvedbo je nekoliko bolj zapletena
-- Glava
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
hide methods
hide stereotypes'
union all
-- Tabele
select format('Table(%s, "%s n informacije o %s") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Veze između tabela
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "A %s može imati mnogo %s"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Podnožje
select '@enduml' 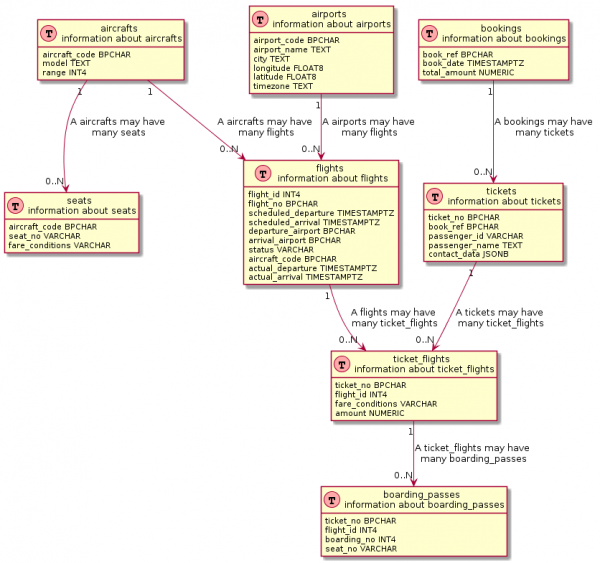
Če se natančno pogledamo, mnoge vizualizacijske orodja pod pokrovom uporabljajo podobne poizvedbe. Res je, da so te poizvedbe običajno globoko , kaj šele da bi jih modificirali.
Metrične in nadzor
Pojdimo k tradicionalno kompleksni temi – spremljanje zmogljivosti DB. Spomnim se majhne resnične zgodbe, ki mi jo je povedal "eden od mojih prijateljev". Na enem od projektov je živel mogočen DBA, in malo kdo od razvijalcev ga je poznal osebno, prav tako pa ga ni nihče nikoli videl (kljub temu da je po govoricah delal nekje v sosednji zgradbi). Ob "X" uri, ko je proizvodni sistem velikega trgovca spet začenjal "slabo delovati", je tiho pošiljal posnetke zaslona grafikonov iz Oracle Enterprise Managerja, na katerih je skrbno označil kritična mesta z rdečim flomastrom za "jasnost" (kar je, milo rečeno, malo pomagalo). In tako je bilo po tej "fotografiji" potrebno zdraviti. Pri tem dostopa do dragocenega (v obeh pomenih te besede) Enterprise Managerja nihče ni imel, saj je bila sistem zapleten in drag, kdo ve, "če se razvijalci slučajno ne zaletijo in vse pokvarijo". Zato so razvijalci "empirično" ugotovili mesto in vzrok upočasnitev ter izdali popravek. Če strašljivo pismo od DBA ni prišlo ponovno v bližnjem času, so si vsi oddahnili in se vrnili k svojim trenutnim nalogam (do novega pisma).
A proces spremljanja je lahko videti bolj veselo in prijazno, kar je najpomembnejše – dostopno in pregledno za vse. Vsaj osnovni del bi moral biti dopolnitev glavnim sistemom spremljanja (ki so nedvomno koristni in v mnogih primerih nezamenljivi). vsaka SDB z veseljem in popolnoma brezplačno deli informacije o svojem trenutnem stanju in zmogljivosti. V isti "krvavi" Oracle DB lahko skoraj vse informacije o zmogljivosti pridobimo iz sistemskih pogledov, začenši s procesi in seansami, pa vse do stanja predpomnilnika (na primer, , oddelek "Spremljanje"). V Postgresql obstaja tudi cela vrsta sistemskih pogledov za , vključno z nekaterimi nadvse pomembnimi v vsakdanjem življenju vsakega DBA, kot so , , . V MySQL je za to namenjena celo posebna shema . V Mongo pa je vgrajen ki agregira podatke o zmogljivosti v sistemsko zbirko .
Torej, opremljeni z nekim zbiralnikom metrik (Telegraf, Metricbeat, Collectd), ki zna izvajati prilagojene sql-poizvedbe, shrambo teh metrik (InfluxDB, Elasticsearch, Timescaledb) in vizualizatorjem (Grafana, Kibana), lahko ustvarimo dovolj preprost in prilagodljiv sistem za spremljanje, ki bo tesno integriran z drugimi splošnimi sistemi metrikami (ki jih pridobivamo, na primer, iz aplikacijskega strežnika, iz operacijskega sistema itd.). Kot je to primer v pgwatch2, kjer se uporablja kombinacija InfluxDB + Grafana in niz poizvedb do sistemskih prikazov, ki jim lahko dodamo tudi prilagojene poizvedbe. .
Ukupno
In to je le približen seznam tistega, kar lahko storimo z našo bazo podatkov s pomočjo običajnega SQL-koda. Sem prepričan, da lahko najdemo še številne druge uporabe, pišite v komentarjih. O tem, kako (in kar je najpomembnejše zakaj) to vse avtomatizirati in vključiti v svoj CI/CD pipeline, bomo govorili naslednjič.
Izvor: habr.com
