

Prezentacija iz 2015. godine Ilje Kosmodemjanskog "Tuning Linux za poboljšanje performansi PostgreSQL-a"
Izjava o odricanju: Napominjem da je ova prezentacija datirana novembrom 2015. godine — prošlo je više od 4 godine i vreme je učinilo svoje. Verzija 9.4 koja se razmatra u ovom izlaganju više nije podržana. Tokom protekle 4 godine, objavljeno je 5 novih verzija PostgreSQL-a i 15 verzija Linux jezgra. Ako bismo prepisivali ova mesta, na kraju bismo dobili potpuno drugačiju prezentaciju. No, ovde se razmatra osnovno podešavanje Linux-a za PostgreSQL, što je relevantno i danas.
Zovem se Ilja Kosmodemjanski. Radim u firmi PostgreSQL-Consulting. Sada ću malo govoriti o tome šta raditi sa Linux-om kada je reč o bazama podataka generalno, a posebno o PostgreSQL-u, jer su principi vrlo slični.
O čemu će se govoriti? Ako komunicirate sa PostgreSQL-om, do određene mere morate biti UNIX administrator. Šta to znači? Ako uporedimo Oracle i PostgreSQL, u Oracle-u morate biti 80% DBA administrator baze podataka i 20% Linux administrator.
Sa PostgreSQL-om je malo složenije. Sa PostgreSQL-om morate mnogo bolje razumeti kako Linux funkcioniše. I pri tome moramo malo trčati za vozom, jer se u poslednje vreme sve značajno ažurira. I nova jezgra izlaze, i nove funkcije se pojavljuju, performanse se poboljšavaju itd.
Zašto govorimo o Linux-u? Ne zato što smo na konferenciji Linux Piter, već zato što je u savremenim uslovima jedan od najosnovanijih operativnih sistema za rad sa bazama podataka generalno i sa PostgreSQL-om posebno – Linux. Nažalost, FreeBSD se razvija u veoma čudnom pravcu. I imaće problema, kako sa performansama, tako i sa mnogim drugim stvarima. Performanse PostgreSQL-a na Windows-u – to je uopšte posebna teška tema, koja se suočava sa time što Windows nema zajedničku memoriju kao UNIX, a PostgreSQL se oslanja na to, jer je višepostupkovni sistem.
I egzotika poput Solaris-a, mislim da manje interesuje sve, tako da da krenemo.
Savremeni Linux distribucije imaju više od 1.000 sysctl parametara, u zavisnosti od toga kako je jezgro sastavljeno. U ovom smislu, ako pogledamo različite podavake, možemo na mnogo načina nešto dodatno prilagoditi. Postoje parametri za datotečne sisteme, načine montaže. Ako imate pitanja o pokretanju: šta uključiti u BIOS-u, kako podesiti hardver itd.
To je zelo obsežna tema, o kateri lahko govorimo dneve, ne pa v enem kratkem predavanju, vendar se bom osredotočil na pomembne stvari, kako se izogniti tistim napakam, ki vam zagotovo ne bodo omogočile dobrega delovanja podatkovne baze na Linuxu, če jih ne odpravite. Pomembno je tudi, da so mnogi privzeti parametri vključeni v nastavitve, ki niso primerne za podatkovno bazo. To pomeni, da bo privzeto delovalo slabo ali pa ne bo delovalo sploh.
Katere tradicionalne cilje optimizacije imamo v Linuxu? Menim, da za vas, ki se ukvarjate z upravljanjem Linuxa, ni treba posebej razlagati, kaj so cilji.
Tuning je mogoče opraviti na:
- CPU.
- Pomnilnik.
- Shramba.
- Ostalo. O tem bomo govorili na koncu za zakusko. Tudi na primer, takšni parametri, kot je politika varčevanja z energijo, lahko na zelo nepričakovan in neprijeten način vplivajo na zmogljivost.
Kakšne so posebnosti PostgreSQL in podatkovnih baz na splošno? Težava je v tem, da ne morete optimizirati neke posamezne male stvari in videti, da se je naša zmogljivost bistveno izboljšala.
Da, takšne male stvari obstajajo, vendar je podatkovna baza kompleksna zadeva. Interagira z vsemi viri, ki jih strežnik ima, in raje deluje s celotno močjo. Če si ogledate sodobna priporočila Oracla o tem, kako uporabljati gostiteljsko OS, bo to kot v anekdotah o mongolskem kozmonavtu – nahranite psa in ne dotikajte se ničesar. Dajmo bazi vse vire, podatkovna baza bo vse sama uredila.
Na splošno je situacija pri PostgreSQL podobna. Razlika je v tem, da baza sama ne more vedno pridobiti vseh virov, torej je nekje treba to samo poenostaviti na ravni Linuxa.
Glavna ideja je, da ne izberete nekega enega cilja in začnete optimizirati, na primer, pomnilnik, CPU ali kaj podobnega, temveč analizirati delovno obremenitev in poskusiti maksimalno izboljšati pretočnost, da skozi našo podatkovno bazo čim bolj učinkovito preide obremenitev, ki so jo dobri programerji ustvarili za nas, vključno z našimi uporabniki.
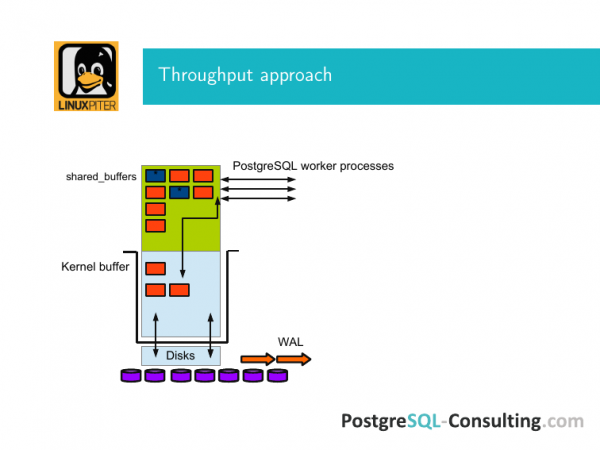
Tukaj je slika, ki pojasnjuje, kaj je to. Obstaja pomnilnik operacijskega sistema Linux ter deljena in deljena pomnilnika PostgreSQL. PostgreSQL v nasprotju z Oracle deluje neposredno samo preko pomnilnika jedra, torej da pride stran s diska v njegovo deljeno pomnilnik, mora najprej iti skozi pomnilnik jedra in se vrniti nazaj, je situacija prav tako.
Pod tem sistemom so diski. Narisan sem jih kot diske. V resnici tam lahko obstaja RAID kontroler itd.
In ta vhod-izhod se na ta ali oni način dogaja preko tega sistema.
PostgreSQL je klasična podatkovna baza. Znotraj nje so strani. Vse vhodno-izhodne operacije potekajo z uporabo strani. Z njo nalagamo bloke v pomnilnik. In če se nič ne zgodi, pač preberemo te bloke, se postopoma iz tega predpomnilnika, iz deljenih pomnilnikov, potopijo nazaj na disk.
Če kje nekaj zamenjamo, se cela stran označi kot umazana. Tukaj sem jih označil z modro barvo. To pomeni, da mora biti ta stran usklajena z blokovnim skladiščem. Torej, ko jo naredimo umazano, zapišemo vanjo v WAL. In v nekem čudovitem trenutku se zgodi pojav, imenovan checkpoint. In v ta dnevnik se zabeleži informacija o tem, da je prišel. To pomeni, da so vseh umazanih strani, ki so bile v tem trenutku v teh deljenih pomnilnikih, usklajene z diskom skladišča s pomočjo fsync preko pomnilnika jedra.
Zakaj se to izvaja? Če nam izgine elektrika, ne dobimo situacije, da so vsi podatki izginili. Trajna pomnilnika, o kateri so nam vsi govorili, je zaenkrat v teoriji podatkovnih baz – to je svetla prihodnost, ki ji seveda stremimo in nam je všeč, a zaenkrat še živimo 20 let v preteklosti. In seveda, vse to je treba nadzorovati.
Cilj povečanja pretoka je optimizirati na vseh teh stopnjah, da vse hitro deluje. Deljena pomnilnika je večinoma predpomnilnik strani. V PostgreSQL smo poslali zahtevo select nekaj tam, dobil je te podatke iz diska. Ti so prišli v deljene pomnilnike. Da bi to delovalo bolje, mora biti veliko pomnilnika.
Da bi sve ovo radilo dobro i brzo, potrebno je pravilno konfigurisati operativni sistem na svim nivoima. Takođe je važno odabrati uravnoteženu hardversku opremu, jer ako dođe do neravnoteže na nekom mestu, možete imati veoma puno memorije, ali će njen rad biti spor.
Hajde da prođemo kroz svaku od ovih tačaka.
Da bi ove stranice putovale brže, potrebno je postići sledeće:
- Prvo, potrebno je efikasnije raditi sa memorijom.
- Drugo, tranzicija kada stranice prelaze iz memorije na disk mora biti efikasnija.
- I treće, potrebno je imati dobre diskove.
Ako imate 512 GB RAM-a u strežnikom i sve to na kraju ide na SATA hard disk bez bilo kakvog keša, ceo server baze podataka ne postaje samo slabo, već postaje slabo sa SATA interfejsom. Onda ćete se direktno suočiti sa tim problemom i ništa vas neće spasiti.
Što se tiče prvog dela o memoriji, postoje tri stvari koje mogu uveliko otežati situaciju.
Prva od njih jeste NUMA. NUMA je sistem napravljen radi poboljšanja performansi. U zavisnosti od opterećenja, različite stvari se mogu optimizovati. U svom trenutnom obliku nije baš najbolja za aplikacije kao što su baze podataka, koje intenzivno koriste page cache i deljene baferne resurse.
U nekoliko reči. Kako znati da nešto nije u redu sa NUMA-om? Možda imate neki neprijatan zvuk, iznenada jedan CPU postane preopterećen. Pri tome analizirate zahteve u PostgreSQL-u i ne vidite ništa sličnog. Ti zahtevi ne bi trebali da konzumiraju CPU toliko intenzivno. Može potrajati dugo da to uhvatite. Lakše je odmah poštovati ispravnu preporuku kako konfigurisati NUMA za PostgreSQL.
Šta se zapravo dešava? NUMA je Non-Uniform Memory Access. U čemu je stvar? Imate CPU, pored njega je njegova lokalna memorija. Ta memorija može pristupiti memoriji drugih CPU-a putem interkonekcija.
Ako pokrenete numactl --hardware, dobićete veliku stanicu. Među ostalim, tu će biti polje razdaljina. Biće cifara – 10-20, nešto u tom smislu. Te cifre su ništa drugo do broj hopova potrebnih da bi se ta udaljena memorija povezala i koristila lokalno. U osnovi, dobra ideja. To pomaže u ubrzavanju performansi pod određenim opterećenjima.
Zdaj si predstavljajte, da imaš en CPU, ki najprej poskuša uporabiti svojo lokalno pomnilnik, nato pa poskuša po interconnectu pritegniti drugo pomnilnik za kaj. In na ta CPU pride celoten vaš page cache PostgreSQL – vse, kar ima nekaj gigabajtov. Vedno dobite najslabši scenarij, ker na CPU-ju v tem modulu pomnilnika običajno ni veliko. In vsa pomnilnika, ki se upravlja, prehaja skozi te interconnects. To je počasi in žalostno. In imate procesor, ki nenehno obremenjuje ta vozel. In čas dostopa do tega pomnilnika je slab, počasen. To je situacija, ki je ne želite, če to uporabljate za bazo podatkov.
Zato je bolj pravilna izbira za bazo podatkov, da operacijski sistem Linux sploh ne ve, kaj se dogaja. Da se obravnava pomnilnik, kot se obravnava.
Zakaj tako? Zdi se, da bi moralo biti obratno. Do tega prihaja iz enostavnega razloga, da potrebujemo veliko pomnilnika za page cache – desetine, sto gigabajtov.
In če smo to vse dodelili in zakasnili naše podatke tam, bo pridobitev od uporabe cache-a bistveno večja kot pridobitev od takega pametnega dostopa do pomnilnika. Tako bomo na ta način pridobili nesorazmerno v primerjavi s tem, da bomo učinkoviteje dostopali do pomnilnika z uporabo NUMA.
Zato sta do sedaj dva pristopa, dokler ne pride svetla prihodnost, ko baza podatkov ne more sama ugotoviti, na katerih CPU-jih deluje in od kje naj potegne.
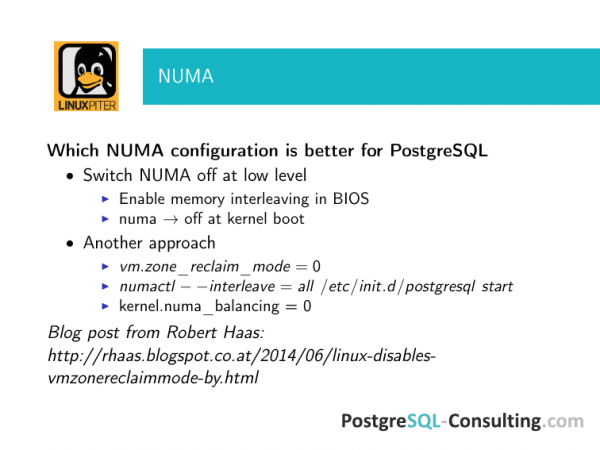
Zato je pravi pristop popolnoma onemogočiti NUMA, na primer, ob ponovnem zagonu. V večini primerov so prihranki tako veliki, da vprašanje, kaj je bolje, sploh ne nastane.
Obstaja še en način. Pogosteje ga uporabljamo kot prvega, ker ko nam stranka pride na podporo, je ponovno zagon strežnika za njih velik dogodek. Imajo tam razpeto poslovanje. In težave zaradi NUMA doživljajo. Zato se trudimo onemogočiti na manj invazivne načine kot ponovno zagon, vendar tukaj previdno preverite, da je onemogočeno. Ker, kot kaže izkušnja, onemogočimo NUMA starševskega procesa PostgreSQL, kar je dobro, vendar ni nujno, da deluje. Potrebno je preveriti in videti, da se dejansko onemogočilo.
Obstaja dober članek Roberta Haasa. Je eden od razvijalcev PostgreSQL, eden od ključnih razvijalcev vseh nizkoročnih komponent. In če sledite povezavam iz tega članka, boste našli več barvitih zgodb o tem, kako je ljudem NUMA otežila življenje. Oglejte si in preučite seznam nastavitev za skrbnike, ki jih je treba konfigurirati na strežniku, da bo naša baza podatkov delovala dobro. Te nastavitve je treba zapisati in preverjati, sicer ne bo dobro.
Opažam, da to velja za vse nastavitve, o katerih bom govoril. Običajno se baze podatkov postavijo v način master-slave za odpornost na napake. Ne pozabite uvesti teh nastavitev na slave, ker se bo v določenem trenutku zgodila napaka, vi pa se boste preklopili na slave, ki bo postal master.
V izredni situaciji, ko je vse zelo slabo, bo vaš telefon nenehno zvonil, direktor bo prihitel s palico, in takrat ne boste imeli časa razmišljati o preverjanju. Rezultati so lahko zelo obžalovanja vredni.
Naslednja točka so huge pages. Huge pages je težko testirati ločeno, niti ni pretiranega smisla za to, čeprav obstajajo benchmarki, ki to znajo storiti. Ti so enostavno dostopni preko iskalnika.
Kakšen je smisel? Imate server, ki ni zelo drag, vendar ima veliko RAM-a, na primer več kot 30 GB. Huge pages niso uporabljene. To pomeni, da zagotovo imate overhead pri uporabi pomnilnika. In ta overhead ni ravno prijeten.
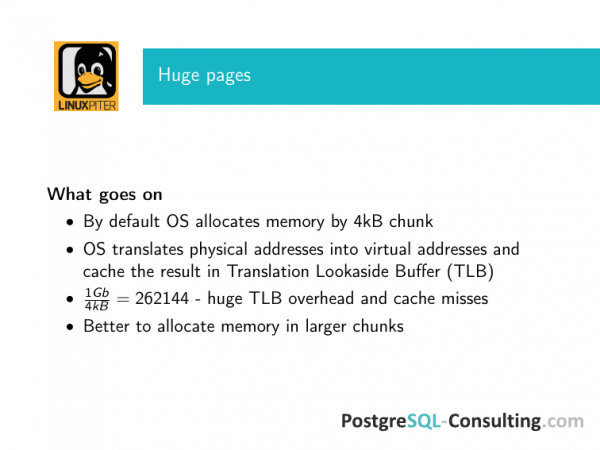
Zakaj tako? Kaj se dogaja? Operacijski sistem dodeljuje pomnilnik v majhnih kosih. To je priročno, tako je zgodovinsko postalo. Če se poglobimo, mora OS pretvoriti virtualne naslove v fizične. Ta proces ni najpreprostejši, zato OS rezultat te operacije predpomni v Translation Lookaside Buffer (TLB).
In ker je TLB predpomnilnik, se v tej situaciji pojavljajo vsi problemi, ki jih povzročajo predpomnilniki. Prvič, če imate zelo veliko operativne pomnilnika in je ta dodeljena v majhnih kosih, potem ta predpomnilnik postane zelo velik. In če je predpomnilnik velik, je iskanje po njem počasnejše. Overhead je zdrav in sam zavzema prostor, tj. operativna pomnilnik porabi nekaj, kar ni pravilno. To je ena stvar.
Dva – čim se keš u ovoj situaciji više širi, veća je verovatnoća da će vam se desiti cache misses. Efikasnost ovog keša naglo opada sa povećanjem njegove veličine. Stoga su u operativnim sistemima smislili jednostavan pristup. U Linuxu se već dugo koristi. U FreeBSD-ju je nedavno uveden. No, govorimo o Linuxu. To su huge pages.
Ovde treba napomenuti da su huge pages, kao ideja, prvobitno podržali zajednice koje su obuhvatale Oracle i IBM, tj. proizvođači baza podataka su ozbiljno razmišljali o tome kako će to biti korisno, uključujući i baze podataka.
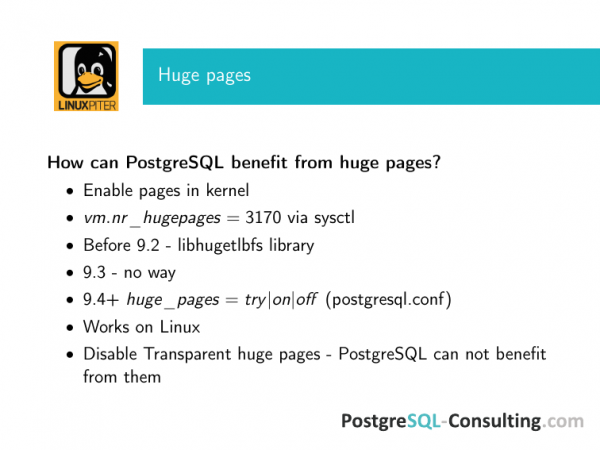
Kako to povezati sa PostgreSQL-om? Prvo, u Linux jezgru moraju biti uključene huge pages.
Drugo, moraju biti eksplicitno navedene putem sysctl parametra – koliko ih ima. Brojevi ovde potiču sa nekog starog servera. Možete izračunati koliko otprilike imate shared buffers, da bi huge pages stali u njih.
Ako je ceo server dodeljen PostgreSQL-u, onda je dobra polazna tačka ili 25 % RAM-a odvojiti za shared buffers, ili 75 %, ako ste sigurni da vaša baza podataka sigurno staje u tih 75 %. To je prva polazna tačka. I izračunajte, ako imate 256 GB RAM-a, tada ćete imati 64 GB shared buffers. Izračunajte otprilike sa nekim rezervama – kolika bi ta cifra trebala da bude.
Do verzije 9.2 (ako se ne varam, od verzije 8.2) moglo je da se pomoću eksternih biblioteka povežu PostgreSQL i huge pages. To uvek treba učiniti. Prvo, potrebno je da jezgro ume pravilno da alocira huge pages. A, drugo, aplikacija koja s njima radi mora moći da ih iskoristi. Neće to uraditi samo od sebe. Pošto je PostgreSQL alocirao memoriju na način system 5, to se moglo uraditi pomoću libhugetlbfs – to je puno ime biblioteke.
V različici 9.3 smo izboljšali zmogljivost PostgreSQL pri delu z pomnilnikom in opustili metodo dodeljevanja pomnilnika system 5. Vsi smo bili zelo veseli, saj sicer, ko poskušate zagnati dva primerka PostgreSQL na eni napravi, reče, da mi zmanjkuje deljenega pomnilnika. In pove, da je treba popraviti sysctl. In tam je tak sysctl, da je treba še ponovno zagnati itd. Na splošno smo bili vsi veseli. Vendar pa je dodeljevanje pomnilnika mmap pokvarilo uporabo ogromnih strani. Večina naših strank uporablja velike deljene buferje. Zelo priporočamo, da ne prehajate na 9.3, saj se je tam overhead začel meriti v več odstotkih.
Toda skupnost se je osredotočila na ta problem in v 9.4 so zelo dobro prenovili to zadevo. V 9.4 se je pojavil parameter v postgresql.conf, s katerim lahko omogočite možnost try, on ali off.
Try je najbolj varna možnost. Ob zagonu PostgreSQL, ko dodeljuje deljen pomnilnik, poskuša pobrati ta pomnilnik iz ogromnih strani. In če mu ne uspe, se preklopi na običajno dodelitev. Če imate FreeBSD ali Solaris, lahko nastavite try, to je vedno varno.
Če je nastavitev on, se preprosto ne zažene, če mu ne uspe pridobiti iz ogromnih strani. Tu je odvisno od vaših preferenc. Toda če imate try, preverite, da se je res dodelil tisto, kar potrebujete, ker je tam veliko prostora za napake. Ta funkcionalnost trenutno deluje samo na Linuxu.
Še ena majhna opomba, preden gremo naprej. Transparent huge pages trenutno niso povezane s PostgreSQL. Na normalno uporabo le-teh ne more. In pri Transparent huge pages za tak workload, ko potrebujete velik kos deljenega pomnilnika, so prednosti prisotne le pri zelo velikih količinah. Če imate terabajne pomnilnika, potem to lahko igra vlogo. Če govorimo o bolj običajnih uporabah, ko imate 32, 64, 128, 256 GB pomnilnika na napravi, so običajne ogromne strani v redu, transparentne pa preprosto izklopimo.
In zadnja stvar, ki se nanaša na pomnilnik in ni neposredno povezana s prepustnostjo, lahko močno pokvari življenje. Vsa prepustnost lahko močno trpi, če se strežnik nenehno swap-a.
In this case, it can be quite unpleasant for various reasons. The main inconvenience lies in the fact that modern kernels behave slightly differently than older Linux kernels. This is a situation we want to avoid, because when we talk about working with swap, it often leads to an untimely arrival of the OOM-killer. An OOM-killer that comes too late and terminates PostgreSQL is certainly an inconvenience. Everyone will notice this, including end users.
What is happening? You have a large amount of RAM, everything is functioning well. But for some reason, the server hangs in swap and slows down because of this. It seems like there is plenty of memory, but that doesn’t help.
Previously, we recommended setting vm.swappiness to zero, meaning to disable swap. We once thought that having 32 GB of RAM and corresponding shared buffers was substantial. The main purpose of swap is to have a space where we can put pages when we run out of memory. And that purpose was no longer effectively fulfilled. And what do you do with those pages after? It becomes a task where it’s not entirely clear why swap is needed, especially of such a large size.
However, in more modern, i.e., third versions of the kernel, the behavior has changed. If you set swap to zero, or disable it, sooner or later, even with some RAM left, the OOM-killer will arrive to terminate the most intensive consumers. Because it will assume that with this workload, we have just a bit left and we're going to run out of memory. The OOM-killer won’t terminate system processes but will eliminate something less critical. This less critical process will usually be the intensive consumer of shared memory, namely postmaster. After this, we can only hope that the database won’t need recovery.
Therefore, currently, by default, as far as I remember, most distributions set it around 6, which indicates when to start using swap depending on the remaining memory. We now recommend setting vm.swappiness to 1 because it practically disables swap but prevents the issues associated with an unexpectedly arriving OOM-killer that terminates processes.
Kaj je naslednje? Ko govorimo o zmogljivosti podatkovnih baz in postopoma prehajamo k diskovom, se vsi začnejo prijemati za glavo. Kajti resnica, da so diski počasni in spomin hiter, je vsem znana že od otroštva. Vsi vedo, da se bodo v podatkovni bazi pojavili problemi z diskovno zmogljivostjo.
Glavni problem zmogljivosti PostgreSQL, povezan s sunkovom checkpoints, ne izhaja iz tega, da je disk počasen. Gre bolj zato, da propustnost spomina in diska nista uravnoteženi. Hkrati sta lahko neuravnoteženi na različnih mestih. PostgreSQL ni nastavljena, operacijski sistem ni nastavljen, strojna oprema ni nastavljena in strojna oprema ni pravilna. Te težave se ne pojavijo le takrat, ko vse poteka, kot je treba, torej bodisi da ni obremenitve bodisi da so nastavitve in strojna oprema dobro izbrane.
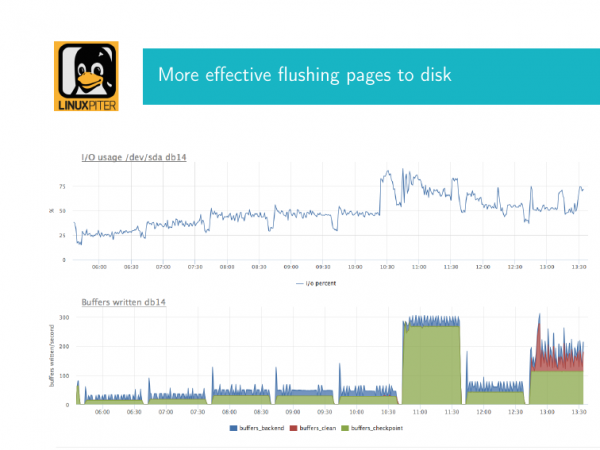
Kaj to je in kako izgleda? Običajno ljudje, ki delajo s PostgreSQL, v to zadevo vstopajo večkrat. Pojasnil bom. Kot sem rekel, PostgreSQL občasno izvaja checkpoints, da 'umazane' strani iz deljenega spomina shranjuje na disk. Če imamo velik obseg deljenega spomina, checkpoint začne intenzivno vplivati na disk, ker shranjuje te strani z fsync. Prihaja v jedrni pomnilnik in se zapisuje na diske z uporabo fsync. In če je obseg tega velikega, lahko opazujemo neprijeten učinek, in sicer zelo veliko obremenitev diskov.
Tukaj imam dve sliki. Zdaj bom pojasnil, kaj to je. To sta dva s časovno koreliranimi grafi. Prvi graf je obremenitev diska. Tu doseže skoraj 90 % v tem trenutku. Če imate podatkovno bazo s fizičnimi diski, z RAID kontrolerjem in obremenitev skoraj doseže 90 %, so to slabe novice. To pomeni, da še malo in bo dosegla 100 ter vhod-izhod se bo ustavil.
Če imate diskovni niz, je tu nekoliko drugačna zgodba. Odvisno je od tega, kako je nastavljen, kakšen niz je itd.
In parallel, there is a graph configured here from the internal Postgres view, which shows how the checkpoint occurs. The green color indicates the amount of buffers, those dirty pages that arrived at this checkpoint for synchronization at that moment. This is the main thing to know here. We see that a lot of pages have arrived, and at some point, we hit a bottleneck, i.e., we were writing and clearly the disk system is very busy. The checkpoint has a significant impact on the disk. Ideally, the situation should look more like this, meaning we had less writing here. We can fix this with settings to ensure it remains so. That is, utilization is low, but we are still writing something here.
What needs to be done to overcome this problem? If your IO has stopped under the database, it means that all users who came to execute their queries will be waiting.
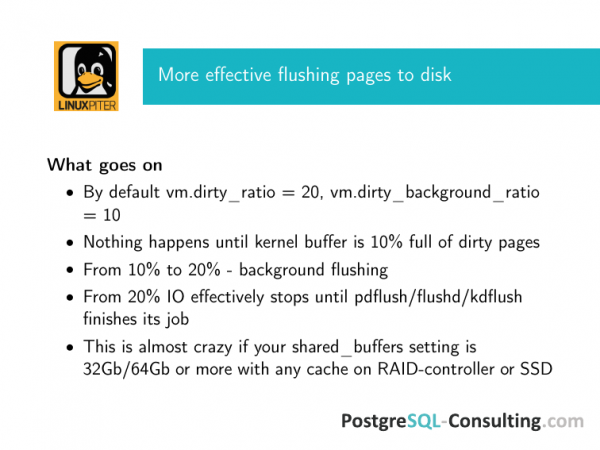
From a Linux perspective, if you have good hardware, set it up correctly, and configured PostgreSQL properly to perform these checkpoints less frequently, spreading them out over time, then you are complying with the default parameters of Debian. For most Linux distributions, the picture looks like this: vm.dirty_ratio=20, vm.dirty_background_ratio=10.
What does this mean? Since version 2.6, there has been a demon for flushing. Pgflush, depending on what is used, is responsible for background flushing of dirty pages from the kernel buffer and for forcibly flushing dirty pages when background flushing is no longer effective.
When does background occur? When 10% of the total RAM available on the server is occupied by dirty pages in the kernel buffer, a special background write function is triggered. Why is it called background? It takes as a parameter how many pages to flush. For example, it flushes N pages. For some time, this process sleeps and then comes back to flush another amount of pages.
This is a very simple story. It's like a pool where water flows in one pipe and out another. We have a checkpoint that arrived, and if it sent few dirty pages for flushing, then gradually, the pgflush will carefully disperse everything from the kernel buffer.
Če se te umazane strani še naprej kopičijo, se naberejo do 20 %, nato pa operacijski sistem prednostno zapiše vse to na disk, ker se lahko izklopi napajanje, in imeli bomo težave. Tako bomo izgubili te podatke, na primer.
Kaj je trik? Trik je v tem, da so ti parametri v sodobnem svetu 20 in 10 % celotne operativne pomnilnosti, ki jo ima naprava, povsem obupni z vidika prepustnosti katere koli diskovne sisteme, ki jo imate.
Predstavljajte si, da imate 128 GB operativne pomnilnosti. 12,8 GB pride v vaš diskovni sistem. In kakršna koli predpomnilniška enota ali niz, ki ga imate tam, ne bo prenesla toliko.
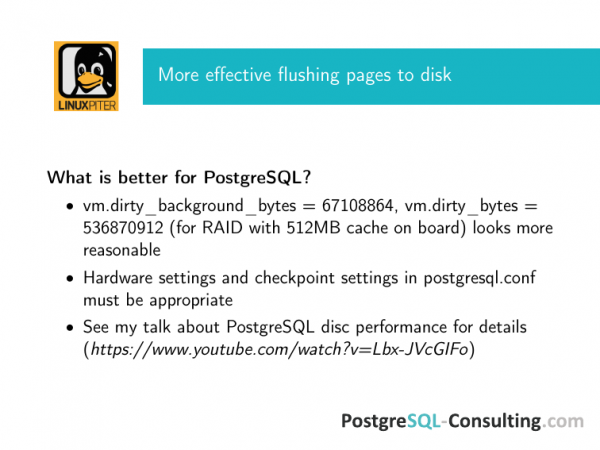
Zato priporočamo, da te številke takoj nastavite glede na možnosti vašega RAID nadzornika. Tukaj imam takoj priporočilo za nadzornik, ki ima 512 MB predpomnilnika.
Vse to se šteje zelo enostavno. Lahko nastavite vm.dirty_background v bajtih. Te nastavitve prekličejo prejšnji dve. Ali je razmerje privzeto, ali so aktivirane tiste, ki so z bajti, delovale bodo tiste, ki so z bajti. Ampak ker sem DBA svetovalec in delam z različnimi strankami, se trudim biti previden, zato, če so v bajtih, potem v bajtih. Nihče ni dal nobenih jamstev, da dober administrator ne bo dodal pomnilnika strežniku, ga znova zagnal in da bo številka ostala enaka. Preprosto izračunajte te številke, da se bo vse zanesljivo prilegalo.
Kaj se zgodi, če se ne prilegate? Zapisano imam, da se učinkovito ustavi vsak flushing, ampak v resnici je to figura govora. Operacijski sistem ima velik problem – ima veliko umazanih strani, zato se učinkovito ustavi tisti IO, ki ga generirajo vaši odjemalci, tj. aplikacija pošlje sql poizvedbo bazi, ona čaka. Vsak vhod-izhod v to – ima najnižjo prioriteto, ker je baza zasedena z checkpointom. In kdaj jo bo končala, sploh ni jasno. In ko dosežete ne ozadnjo, ne dokončno flushing, to pomeni, da je vse vaše IO zasedeno z njim. In dokler se ne konča, ne morete ničesar narediti.
Tu sta še dva pomembna vidika, ki presegata ta poročilo. Te nastavitve morajo ustrezati nastavitvam v postgresql.conf, tj. nastavitvam checkpointov. In vaš diskovni sistem mora biti ustrezno nastavljen. Če imate predpomnilnik na RAID-u, mora imeti baterijo. Ljudje kupujejo RAID z dobrim predpomnilnikom brez baterije. Če imate SSD v RAID-u, morajo biti strežniški, tam morajo biti kondenzatorji. Tukaj je obsežen kontrolni seznam. Na tej povezavi je moja predstavitev o tem, kako nastaviti zmogljivost diskov v PostgreSQL. Tam so vsi ti kontrolni seznami.
Kaj še lahko zelo oteži življenje? To sta dva parametra. Oba sta razmeroma nova. Po privzetku sta lahko vključena v različne aplikacije. In lahko zapleteta življenje prav tako, če sta vključena nepravilno.
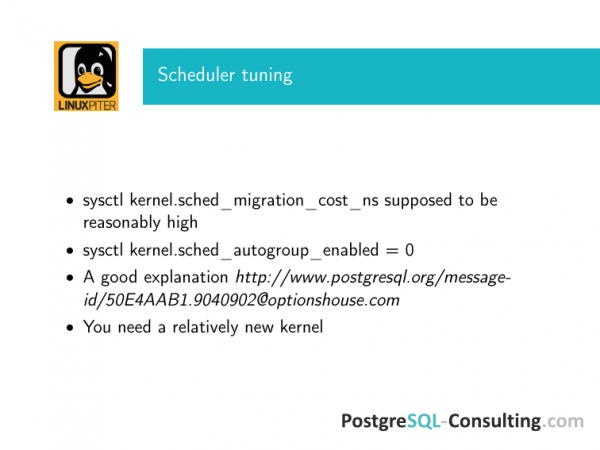
Obstajata dve razmeroma novi stvari. Že v tretjih jedrih sta se pojavili. To sta sched_migration_cost v nanosekundah in sched_autogroup_enabled, ki je po privzetku en.
In kako vplivata na kakovost življenja? Kaj je sched_migration_cost? Linuxov načrtovalnik lahko migrira proces z enega CPU na drugega. In za PostgreSQL, ki izvaja poizvedbe, migracija na drugi CPU ni povsem jasna. Za bazo podatkov je to zelo slabo. Zato je smiselna politika nastaviti migration_cost na neko veliko vrednost, vsaj nekaj tisoč nanosekund.
Kaj to pomeni za načrtovalnik? Štel bo, da je ta proces še vedno aktiven v tem času. To pomeni, da če imate dolgo transakcijo, ki se ukvarja s čim dolgotrajnim, bo načrtovalnik to razumel. Menil bo, da dokler ne mine ta čas, migracija tega procesa ni potrebna. Če proces kaj dela, ne bo nikamor migriran, temveč bo mirno končal na tistem CPU, ki mu je bil dodeljen. In rezultat je odličen.
Druga stvar je autogroup. To je dobra ideja za specifične delovne obremenitve, ki nimajo zveze z modernimi bazami podatkov – skupina procesov po tistem virtualnem terminalu, iz katerega so zagnani. To je priročno za nekatere naloge. V praksi je PostgreSQL večprocesni sistem s preforkom, ki se zažene iz enega terminala. Imate lock writer, checkpoint in vse vaše odjemalske poizvedbe se združijo na en scheduler, na en CPU. Tam bodo mirno čakali, da se osvobodi, da si lahko medsebojno preprečijo in ga zasedejo dlje. To je zgodba, ki ni potrebna pri takem obremenitvi in zato jo je treba izklopiti.
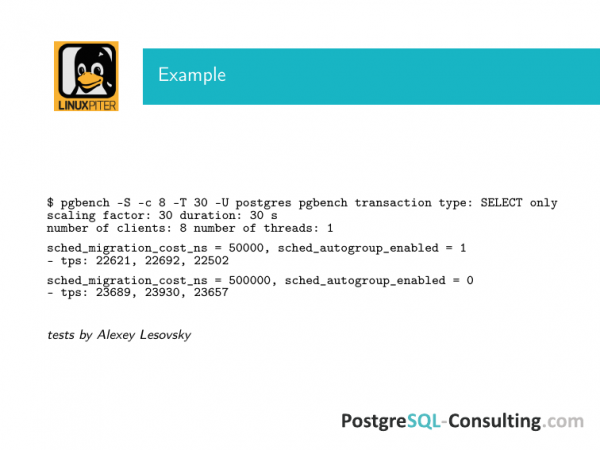
Moj kolega Aleksej Lesovski je izvajal teste s preprostim pgbenchom, kjer je povečeval na reda migration_cost in izklapljal autogroup. Razlika na slabem strojni opremi je bila skoraj 10%.. Na postgresovi mailing listi poteka razprava, kjer ljudje poročajo o rezultatih, kako so tovrstne spremembe vplivale na hitrost poizvedb. na 50%.. Takšnih zgodb je kar nekaj.
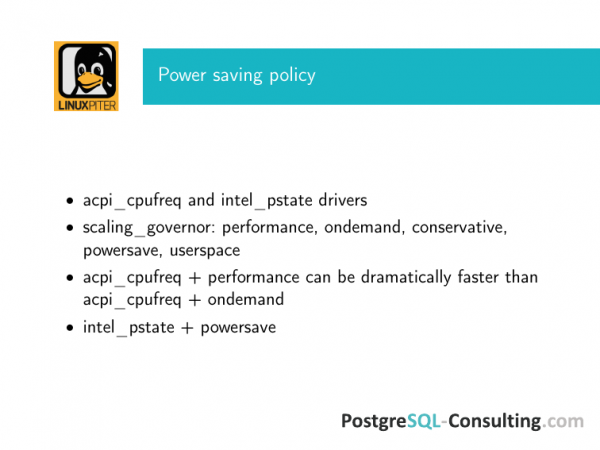
In na koncu o politiki zmanjšanja porabe energije. Dobro je, da lahko zdaj Linux uporabljamo na prenosniku. In naj bi prav tako dobro varčeval z baterijo. A nenadoma se izkaže, da je to lahko tudi na strežniku.
Poleg tega, če najemate strežnike pri kakšnem gostitelju, potem "prijazni" gostitelji ne skrbijo, da bi imeli boljšo zmogljivost. Njihova naloga je, da optimizirajo izkoriščenost strojne opreme. Zato lahko privzeto omogočijo način varčevanja z energijo operacijskega sistema.
Če na strežniku z bazo podatkov pod intenzivno obremenitvijo uporabljate to, potem je vaš izbor acpi_cpufreq + performance. Že z ondemandom se lahko pojavijo težave.
Intel_pstate je že nekoliko drugačen gonilnik. In trenutno se daje prednost temu, saj je novejši in bolje deluje.
In seveda, governor samo performance. Ondemand, powersave in vse ostalo niso za vas.
Rezultati po explain analyze PostgreSQL se lahko razlikujejo za več reda, če omogočite powersave, saj bo vaš CPU pod bazo deloval na povsem nepredictabilen način.
Te stvari so lahko privzeto vključene. Pazljivo si oglejte – ali jih niso vključili privzeto. To je lahko resna težava.
Na koncu bi se rad zahvaliti ekipi iz naše DBA tima PosgreSQL-Consulting, posebno Maksu Boguku i Alekseju Lesovskom, koji se svakodnevno suočavaju s izazovima ovog posla. Trudimo se da za naše klijente napravimo sve kako treba, da sve funkcioniše bez problema. Ovo je kao kod uputstava za avijacijsku sigurnost. Sve je ovde zapisano krvlju. Svaka od ovih matica je otkrivena tokom određene problema. Rado ih delimo s vama.
Vprašanja:
Hvala! Ako, na primer, kompanija želi da uštedi i postavi bazu podataka i aplikacionu logiku na istom serveru, ili ako kompanija prati modernu tendenciju mikroservisnih arhitektura u kojima se PostgreSQL pokreće u kontejneru. U čemu je caka? Sysctl globalno utiče na celo jezgro. Nisam čuo da se sysctl kao nekako virtualizuje, da rade odvojeno u kontejneru. Ima samo cgroup i tu postoji kontrola samo za deo. Kako se može živeti s tim? Ili, ako želite performanse, pokrenite PostgreSQL na posebnom fizičkom serveru i optimizujte ga.
Odgovorili smo na vaše pitanje na otprilike tri načina. Ako ne govorimo o fizičkom serveru koji se može optimizovati itd., onda se opustite, sve će raditi dobro bez tih podešavanja. Ako dobijete takvo opterećenje da treba da uradite ta podešavanja, brže ćete doći do fizičkog servera nego do ovih podešavanja.
U čemu je problem? Ako je to virtuelna mašina, verovatno ćete imati mnogo problema, na primer, zbog dosta neusklađenosti latencije diska na većini virtuelnih mašina. Čak i ako je propusnost diskova dobra, jedna neuspela transakcija operacija ulaza-izlaza, koja ne utiče značajno na prosečnu propusnost, a koja se dogodila tokom checkpoint-a ili tokom pisanja u WAL, može značajno da naškodi bazi. To ćete primetiti pre nego što se suočite s ovim problemima.
Ako imate NGINX na istom serveru, i dalje će biti isti problem. Borit će se za deljenu memoriju. Nećete stići do problema koji su ovde opisani.
Vendar pa so nekateri od teh parametrov še vedno pomembni za vas. Na primer, z uporabo sysctl nastavite dirty_ratio, da ne bo tako ekstremno – v vsakem primeru bo to pomagalo. Tako ali tako bo vaše zanimanje za disk. In to bo potekalo po napačni shemi. To so dejansko privzete nastavitve, ki sem jih prikazal. In v vsakem primeru jih je bolje spremeniti.
Z NUMA se lahko pojavijo težave. VmWare, na primer, dobro deluje z NUMA pri natančno nasprotnih nastavitvah. In tukaj je treba izbrati – fizični strežnik ali ne.
Imam vprašanje v zvezi z Amazon AWS. Imajo vnaprej nastavljene slike. Ena izmed njih se imenuje Amazon RDS. Ali obstajajo kakšne prilagojene nastavitve za njihovo operacijski sistem?
Obstajajo nastavitve, vendar so to druge nastavitve. Tu nastavljamo operacijski sistem z vidika tega, kako bo baza podatkov to uporabljala. Obstajajo parametri, ki določajo, kam gremo sedaj, torej takšno oblikovanje. To pomeni, da potrebujemo toliko virov, ki jih bomo zdaj uporabili. Po tem Amazon RDS te vire povezuje, in takrat se zmogljivost zmanjša. Imajo ločene zgodbe, kako se ljudje na to lotijo uporabiti. Včasih celo precej uspešno. Vendar to nima zveze z nastavitvami operacijskega sistema. To je nekakšno hekanje oblakov. To je druga zgodba.
Zakaj Transparent huge pages ne dajejo učinka v primerjavi z Huge TLB?
Ne dajejo. To lahko pojasnimo na mnoge načine. Vendar dejansko ne dajejo učinka. Katera zgodba je s PostgreSQL? Ob zagonu dodeli velik kos deljene pomnilnika. Ne glede na to, ali so Transparent ali niso - to nima pomena. Dejstvo, da se dodelijo ob zagonu, pojasnjuje vse. In če je pomnilnika zelo veliko in ga je treba prestrukturirati v segment deljenega pomnilnika, potem bo Transparent huge pages pomemben. Pri PostgreSQL je enostavno dodeljen velik kos ob zagonu in to je to, nadalje tam ne poteka nič posebnega. Seveda ga je mogoče uporabljati, vendar obstaja možnost, da pride do poškodbe deljenega pomnilnika, ko bo ponovno dodeljeval kaj. PostgreSQL tega ne ve.
Izvor: habr.com
