

Aloha, ljudje! Moje ime je Oleg Anastasyev, delam v Odnoklassnikih v ekipi Platforme. Poleg mene pa v Odnoklassnikih dela še kup strojne opreme. Imamo štiri podatkovne centre, v njih približno 500 omar, kjer se nahaja več kot 8 tisoč strežnikov. V določenem trenutku smo spoznali, da nam uvedba novega sistema upravljanja omogoča učinkovitejšo obremenitev opreme, poenostavitev upravljanja dostopov, avtomatizacijo (ponovne) dodelitve računalniških virov, pospeševanje zagonov novih storitev in hitrejše odzive na obsežne okvare.
Kaj smo torej dosegli?
Poleg mene in kupa strojne opreme so tukaj tudi ljudje, ki delajo s to opremo: inženirji, ki so neposredno v podatkovnih centrih; omrežni inženirji, ki nastavljajo omrežno infrastrukturo; administratorji ali SRE, ki zagotavljajo odpornost infrastrukture; ter ekipe razvijalcev, od katerih vsaka odgovarja za del funkcij portala. Programska oprema, ki jo ustvarjajo, deluje nekako tako:
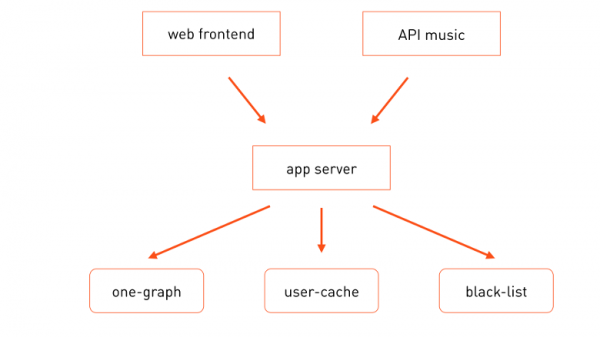
Zahteve uporabnikov prihajajo tako na fronte glavnega portala , kot tudi na druge, na primer na fronte API za glasbo. Te za obdelavo poslovne logike kličejo aplikacijski strežnik, ki ob obdelavi zahteve kliče potrebne specializirane mikroservise — one-graph (graf socialnih povezav), user-cache (predpomnilnik uporabniških profilov) in tako naprej.
Vsaka od teh storitev je nameščena na več strojih, vsaka ima odgovorne razvijalce, ki so odgovorni za delovanje modulov, njihovo delovanje in tehnološki razvoj. Vse te storitve delujejo na fizičnih strežnikih, do nedavnega pa smo izvajali natančno eno nalogo na en strežnik, torej je bil specializiran za določeno nalogo.
Zakaj tako? Ta pristop je imel več prednosti:
- Poenostavi masovno upravljanje. Recimo, da naloga potrebuje določene knjižnice, določene nastavitve. Potem je strežnik dodeljen točno eni določeni skupini, opisuje se politika cfengine za to skupino (ali je že opisana), in ta konfiguracija se centralno in samodejno razširi na vse strežnike te skupine.
- Poenostavi diagnozo. Predpostavimo, da opazite povečano obremenitev centralnega procesorja in se zavedate, da je to obremenitev lahko povzročila le naloga, ki teče na tem fizičnem procesorju. Iskanje krivca se konča zelo hitro.
- Poenostavi nadzor. Če je s strežnikom kaj narobe, monitor o tem obvešča in točno veste, kdo je kriv.
Storitvi, ki se sestavlja iz več replik, je dodeljenih več strežnikov — po enem za vsak. Tako je dodelitev računalniških virov za storitev zelo preprosta: kolikor ima storitev strežnikov, toliko virov lahko maksimalno porabi. 'Preprosta' ni v smislu, da je enostavno uporabiti, temveč da se dodelitev virov dogaja ročno.
Tak pristop nam je tudi omogočil, da smo izdelali specializirane strojne konfiguracije za nalogo, ki se izvaja na tem strežniku. Če naloga hrani velike količine podatkov, uporabljamo 4U strežnik s šasijo za 38 diskov. Če gre za čisto računalniško nalogo, lahko kupimo cenejši 1U strežnik. To je učinkovito z vidika računalniških virov. Ta pristop nam tudi omogoča, da pri obremenitvi, ki je primerljiva z eno prijateljsko družabno mrežo, uporabljamo štirikrat manj naprav.
Takšna učinkovitost uporabe računalniških virov bi morala zagotoviti tudi ekonomsko učinkovitost, če izhajamo iz predpostavke, da so strežniki najdražji. Dolgo časa je bilo najdražje prav železo, in vložili smo veliko truda v zniževanje cen železa, razvijajući algoritme za zagotavljanje odpornosti, da bi zmanjšali zahteve po zanesljivosti opreme. Danes smo prišli do faze, v kateri cena strežnika že ni več odločilna. Če ne upoštevamo najnovejše eksotike, konkretna konfiguracija strežnikov v omari ni pomembna. Zdaj imamo drug problem — cena prostora, ki ga strežnik zaseda v podatkovnem centru, tj. prostora v omari.
Ko smo to spoznali, smo se odločili izračunati, kako učinkovito uporabljamo omare.
Vzeli smo ceno najmočnejšega strežnika, ki je ekonomsko upravičen, izračunali, koliko takih strežnikov lahko postavimo v omarice, koliko nalog bi za njih zagnali na podlagi starega modela »en strežnik = ena naloga«, in koliko nalog bi bilo sposobnih učinkovito uporabiti opremo. Izračunali smo — jokali smo. Izkazalo se je, da je učinkovitost uporabe omaric pri nas okoli 11 %. Očitna ugotovitev: potrebno je povečati učinkovitost uporabe podatkovnih centrov. Zdi se, da je rešitev očitna: na enem strežniku je treba zagnati več nalog. Toda tu se pojavljajo težave.
Masovna konfiguracija se drastično zaplete — zdaj ni mogoče dodeliti strežniku določene ene skupine. Saj lahko na enem strežniku poteka več nalog različnih ekip. Poleg tega je lahko konfiguracija konfliktna za različne aplikacije. Diagnostika je tudi otežena: če opazite povečano porabo procesorjev ali diskov na strežniku, ne veste, katera naloga povzroča težave.
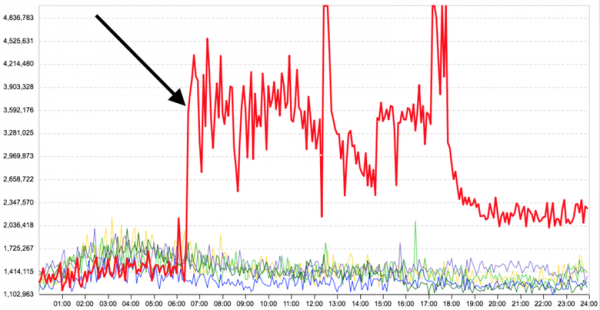
Toda najpomembnejše je to, da med nalogami, ki potekajo na isti napravi, ni izolacije. Na primer, graf povprečnega časa odgovora strežniške naloge pred in po tem, ko smo na istem strežniku zagnali še eno, s prvim nepovezano izračunsko aplikacijo — čas odziva glavne naloge se je močno podaljšal.
Očitno je, da je potrebno naloge zagnati bodisi v kontejnerjih bodisi v virtualnih napravah. Ker se praktično vse naloge izvajajo pod eno operacijskim sistemom (Linux) ali so prilagojene zanj, ni potrebno vzdrževati številnih različnih operacijskih sistemov. Posledično virtualizacija ni potrebna, zaradi dodatnih stroškov bo manj učinkovita od kontejnerizacije.
Kot sveženje vsebnika za zagon nalog neposredno na strežnikih Docker, hitro pride v poštev: slike datotečnih sistemov dobro rešujejo težave s konflikti v konfiguracijah. Možnost, da slike sestavimo iz več plasti, nam omogoča, da znatno zmanjšamo obseg podatkov, potrebnih za njihovo uvajanje v infrastrukturo, tako da ločimo skupne dele v ločene osnovne plasti. Tako bodo osnovne (in največje) plasti razmeroma hitro predpomnjene po celotni infrastrukturi, in za prenos številnih različnih tipov aplikacij in različic bo treba prenašati le majhne plasti.
Poleg tega nam že pripravljen registrir in označevanje slik v Dockerju daje pripravljene osnovne gradnike za različice in dostavo kode v produkcijo.
Docker, tako kot katera koli druga podobna tehnologija, nam omogoča določeno raven izolacije vsebnikov kar iz škatle. Na primer, izolacija po pomnilniku — vsakemu vsebniku je dodeljena omejitev za uporabo pomnilnika naprave, ki je ne more prekoračiti. Prav tako lahko izoliramo vsebnike po uporabi CPU. Pri nas pa je bila standardna izolacija premalo. O tem pa kasneje.
Neposredni zagon vsebnikov na strežnikih je le del težav. Druga težava je povezava vsebnikov na strežnike. Treba je razumeti, kateri vsebnik lahko postavimo na kateri strežnik. To ni tako enostavna naloga, saj je treba vsebnike na strežnike postaviti čim bolj gosto, ne da bi pri tem zmanjšali hitrost njihovega delovanja. Takšno postavljanje je lahko zapleteno tudi z vidika odpornosti. Pogosto želimo postaviti replike iste storitve v različnih omarah ali celo v različnih dvoranah podatkovnega centra, da ob okvari omare ali dvorane ne izgubimo vseh replik storitve.
Ročno razporejanje vsebnikov ni rešitev, ko imate 8.000 strežnikov in 8–16.000 vsebnikov.
Poleg tega smo želeli razvijalcem omogočiti večjo samostojnost pri razporejanju virov, da bi lahko sami postavili svoje storitve v produkcijo, brez pomoči skrbnika. Pri tem smo želeli ohraniti nadzor, da kakšna nepomembna storitev ne bi porabila vseh virov naših podatkovnih centrov.
Očitno je potreben upravljalski sloj, ki bi se s tem avtomatično ukvarjal.
Tukaj smo prišli do preproste in jasne slike, ki jo obožujejo vsi arhitekti: tri kvadratki.
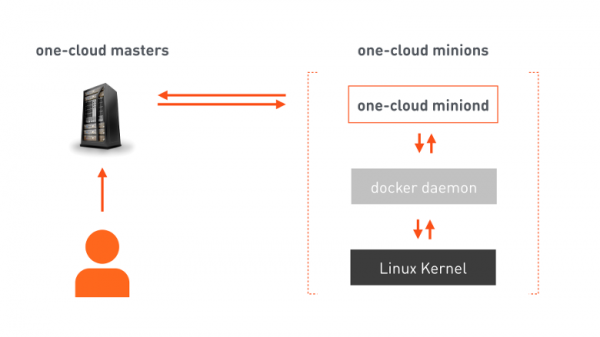
one-cloud masters — toleranten klaster, ki je odgovoren za orkestracijo oblaka. Razvijalec pošlje v master manifest, ki vsebuje vse podatke potrebne za postavitev storitve. Master na njeni osnovi daje ukaze izbranim minionom (strojem, namenjenim za zagon kontejnerjev). Na minionih je naš agent, ki prejme ukaz, poda svoje ukaze Dockru, Dockr pa konfigurira linux kernel za zagon ustreznega kontejnerja. Poleg izvrševanja ukazov agent nenehno obvešča masterja o spremembah stanja tako miniona kot zagnanih kontejnerjev.
Razporeditev virov
Zdaj pa se lotimo težje naloge razporeditve virov za več minionov.
Računalniški vir v one-cloud — to je:
- Računalniška moč procesorja, ki jo porablja določena naloga.
- Obseg pomnilnika, dostopnega nalogi.
- Mrežni promet. Vsak od minionov ima določen omrežni vmesnik z omejeno prepustnostjo, zato nalog ne moremo razporejati, ne da bi upoštevali obseg podatkov, ki jih prenašajo po omrežju.
- Trdi diski. Poleg seveda prostora za podatke naloge, tudi določamo vrsto diska: HDD ali SSD. Trdi diski lahko obravnavajo končno število zahtevkov na sekundo — IOPS. Zato za naloge, ki ustvarjajo več IOPS, kot jih lahko obravnava en disk, tudi dodelimo 'spindle' — torej diske, ki jih je treba izključno rezervirati za nalogo.
Tako za neko storitev, na primer user-cache, lahko zapišemo porabljene vire na naslednji način: 400 procesorskih jeder, 2,5 TB pomnilnika, 50 Gbit/s prometa v obe smeri, 6 TB prostora na HDD, razporejenega na 100 'spindlih'. Ali v bolj poznani obliki tako:
alloc:
    cpu: 400
    mem: 2500
    lan_in: 50g
    lan_out: 50g
    hdd:100x6T
Viri storitve user-cache porabijo le del vseh razpoložljivih virov v produkcijski infrastrukturi. Zato si želimo, da user-cache nenadoma, zaradi napake operaterja ali ne, ne bi porabil več virov, kot mu je dodeljeno. To pomeni, da moramo omejiti vire. A na kaj bi lahko vezali kvoto?
Vrnimo se na našu vrlo pojednostavljenu shemu interakcije komponenti i ponovno je nacrtajmo s više detalja—ovako:
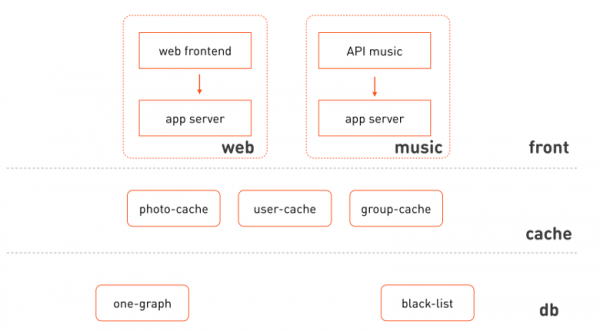
Što se odmah uočava:
- Web frontend i muzika koriste izolirane klastere istog aplikacijskog servera.
- Možemo izdvojiti logičke slojeve kojima pripadaju ti klasteri: frontovi, keševi, sloj za pohranu i upravljanje podacima.
- Frontend nije homogena celina, to su različiti funkcionalni podsistemi.
- Keševi se takođe mogu rasporediti po podsistemu čije podatke keširaju.
Još jednom ćemo nacrtati sliku:
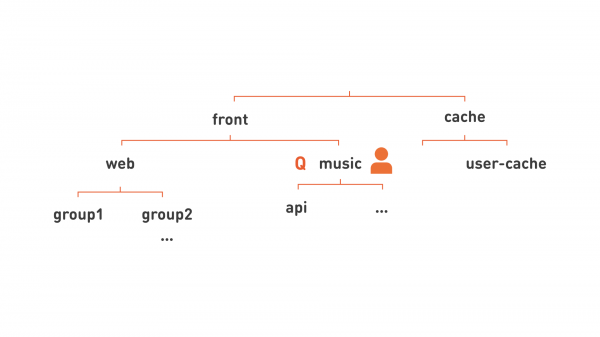
Ha! Vidimo hijerarhiju! To znači da možemo rasporediti resurse u većim delovima: imenovati odgovornog programera za čvor te hijerarhije, koji odgovara funkcionalnom podsistemu (kao što je "music" na slici), i ovoj hijerarhiji vezati kvotu. Takva hijerarhija nam takođe omogućava da fleksibilnije organizujemo servise radi lakšeg upravljanja. Na primer, svi web, budući da je to vrlo velika grupacija servera, delimo na nekoliko manjih grupa, prikazanih na slici kao group1, group2.
Uklanjanjem suvišnih linija, možemo zapisati svaki čvor naše slike u ravnijem obliku: group1.web.front, api.music.front, user-cache.cache.
Tako dolazimo do pojma "hijerarhijska queue". Ona ima ime, kao što je "group1.web.front". Na nju se dodeljuje kvota resursa i prava korisnika. Osobi iz DevOps-a ćemo dati prava za slanje servisa u queue, i takva osoba može pokrenuti nešto u queue, dok osobi iz OpsDev dodeljujemo admins права, i sada ona može upravljati queue, dodeliti ljude u nju, davati tim ljudima prava i sl. Servisi pokrenuti u ovoj queue će se izvršavati u okviru kvote queue. Ako računska kvota queue nije dovoljna za simultano izvršenje svih servisa, oni će se izvršavati jedan za drugim, čime se formira pravopisna queue.
Hajde da pogledamo servise detaljnije. Svaki servis ima potpuno ime, koje uvek uključuje ime queue. Tako će servis web fronta imati ime ok-web.group1.web.front. A servis aplikacijskog servera kojem se obraća, biće poznat kao ok-app.group1.web.front. Vsak storitev ima manifest, ki vsebuje vse potrebne informacije za gostovanje na določenih strojih: koliko virov potrebuje ta naloga, kakšna konfiguracija je potrebna, koliko replik mora biti, lastnosti za obvladovanje napak te storitve. In po gostovanju storitve na strojih se pojavijo njeni primerki. Ti so prav tako nedvoumno poimenovani - kot številka primerka in ime storitve: 1.ok-web.group1.web.front, 2.ok-web.group1.web.front, …
To je zelo priročno: samo z imenom zagnanega kontejnerja lahko takoj ugotovimo veliko.
Zdaj se podrobneje spoznamo s tem, kaj ti primerki dejansko počnejo: z nalogami.
Razredi izolacije nalog
Vse naloge v OK (verjetno pa povsod) lahko razdelimo v skupine:
- Naloge z kratko latenco — prod. Za takšne naloge in storitve je zelo pomembna latenca odgovora (latency), kako hitro bo vsak od zahtevkov obdelan s sistemom. Primeri nalog: spletni vmesniki, predpomnilniki, strežniki aplikacij, OLTP skladišča itd.
- Računske naloge — batch. Tu hitrost obdelave vsakega posameznega zahtevka ni pomembna. Pomembno je, koliko skupnih izračunov bo ta naloga opravila v določenem (velikem) časovnem obdobju (throughput). Sem spadajo katerikoli nalogi MapReduce, Hadoop, strojno učenje, statistika.
- Ozadnje naloge — idle. Za takšne naloge niti latenca niti throughput nista posebej pomembna. Sem spadajo različni testi, migracije, ponovni izračuni, pretvorbe podatkov iz enega formata v drugega. Po eni strani so podobne računski nalogam, po drugi strani pa nam ni toliko pomembno, kako hitro se bodo zaključile.
Oglejmo si, kako takšne naloge porabljajo vire, na primer, centralni procesor.
Naloge z kratko latenco. Pattern porabe CPU za takšno nalogo bo podoben temu:
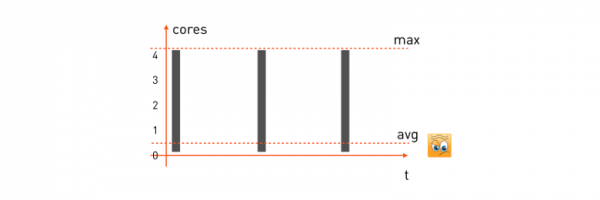
Prejeli smo zahtevo uporabnika, naloga začne uporabljati vse razpoložljive jedrne enote CPU, obdela, vrne odgovor, čaka na naslednjo zahtevo in miruje. Pritožena je nova zahteva — spet je izbrala vse, kar je bilo, naredila izračun, čakamo na naslednjo.
Da bi zagotovili minimalno latenco za takšno nalogo, moramo vzeti maksimum porabljenih virov in rezervirati potrebno število jeder na minionu (stroju, ki bo izvajal nalogo). Tako bo formula za rezervacijo za našo nalogo takšna:
alloc: cpu = 4 (max)Če imamo stroj-minion s 16 jedri, lahko na njem natančno namestimo štiri takšne naloge. Omeniti je treba, da je povprečna poraba procesorja pri takšnih nalogah pogosto zelo nizka — kar je očitno, saj je velika večina časa naloga v čakanju na zahtevo in nič ne počne.
Izračunane naloge. Njihov vzorec bo nekoliko drugačen:
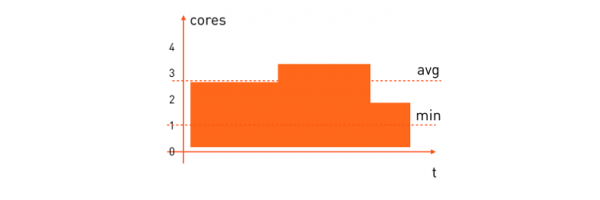
Povprečna poraba procesorskih virov pri takšnih nalogah je dovolj visoka. Pogosto želimo, da se izračunana naloga izvrši v določenem času, zato je treba rezervirati minimalno število procesorjev, ki jih potrebuje, da se celoten izračun konča v sprejemljivem času. Njena formula rezervacije bo videti takole:
alloc: cpu = [1,*)„Prosim, namesti me na minionu, kjer je vsaj en prost jedro, ostalo pa kar koli je — vse bo porabljeno.“
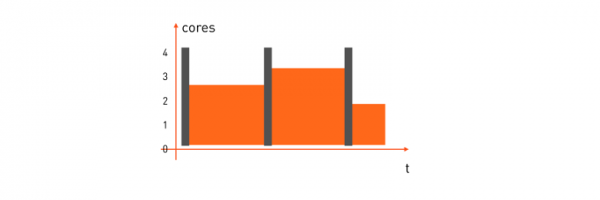
Tu je učinkovitost uporabe že znatno boljša kot pri nalogah s kratko zakasnitvijo. A dobiček bo še večji, če združimo oba tipa nalog na enem minionu in sproti razdelimo njegove vire. Ko naloga s kratko zakasnitvijo potrebuje procesor — ga takoj dobi, ko pa viri niso več potrebni — se prenesejo na izračunano nalogo, torej nekako takole:
Kako to narediti?
Najprej se pogovorimo o prod in njegovem alloc: cpu = 4. Potrebujemo rezervirati štiri jedra. V Docker run to lahko storimo na dva načina:
- Z opcijo
--cpuset=1-4, tj. dodeliti štiri določena jedra nalogi na napravi. - Uporabite
--cpuquota=400_000 --cpuperiod=100_000, določite kvoto za procesorski čas, tj. navedite, da naloga v 100 ms dejanskega časa ne porabi več kot 400 ms procesorskega časa. Rezultat so ista štiri jedra.
Katero od teh načinov bi bilo primerno?
Cpuset izgleda prilično privlačno. Zadatak ima četiri dodijeljene jezgre, što znači da će procesorski kešovi raditi maksimalno efikasno. Međutim, to ima i svoju negativnu stranu: bili bismo primorani preuzeti zadaću raspodjele izračuna po nezasićenim jezgrama mašine umjesto operativnog sistema, što je prilično neobičan zadatak, posebno ako pokušamo smjestiti batch-zadatke na ovakvu mašinu. Testovi su pokazali da ovdje bolje odgovara opcija sa kvotom: tako operativni sistem ima veću slobodu u izboru jezgre za izvršavanje zadatka u tom trenutku i procesorsko vreme se raspoređuje efikasnije.
Hajde da vidimo kako u dockeru napraviti rezervaciju po minimalnom broju jezgri. Kvota za batch-zadatke više nije primjenjiva, jer nije potrebno ograničiti maksimum, dovoljno je samo garantirati minimum. A ovdje dobro odgovara opcija docker run --cpushares.
Dogovorili smo se da ako batch zahtijeva garanciju minimum na jednoj jezgri, onda navodimo --cpushares=1024, a ako minimum na dvije jezgre, onda navodimo --cpushares=2048. Cpu shares ne ometaju raspodjelu procesorskog vremena sve dok ga ima dovoljno. Tako, ako prod trenutno ne koristi sve svoje četiri jezgre — ništa ne ograničava batch-zadatke, i oni mogu koristiti dodatno procesorsko vreme. Međutim, u situaciji nedostatka procesora, ako prod iskoristi svih svojih četiri jezgre i naiđe na kvotu — preostalo procesorsko vreme će biti podeljeno proporcionalno cpushares, tj. u situaciji tri slobodne jezgre, jedna će dobiti zadatak sa 1024 cpushares, a ostale dve — zadatak sa 2048 cpushares.
Ali korišćenje kvote i shares nije dovoljno. Trebamo učiniti tako da zadatak sa kratkom latencijom ima prioritet pred batch-zadatkom prilikom raspodjele procesorskog vremena. Bez takve priorizacije, batch-zadatak će uzimati sve procesorsko vreme u trenutku kada je to potrebno prod. U Docker run nema opcija za priorizaciju kontejnera, ali politika planiranja centralnog procesora u Linuxu dolazi u pomoć. Detaljno o njima se može pročitati , a u okviru ovog članka ćemo ih proći ukratko:
- SCHED_OTHER
Podrazumevano dobijaju svi obični korisnički procesi na Linux mašini. - SCHED_BATCH
Določena je za obremenjujoče procese. Pri prenosu naloge v procesor se uvede tako imenovana kazen za aktivacijo: takšna naloga ima manjšo verjetnost, da pridobi vire procesorja, če ga v tem trenutku uporablja naloga s SCHED_OTHER. - SCHED_IDLE
Ozadjski proces z zelo nizko prednostjo, celo pod nice –19. Uporabljamo našo knjižnico z odprto kodo. , da bi določili potrebno politiko ob zagonu kontejnerja s klicem.
one.nio.os.Proc.sched_setscheduler( pid, Proc.SCHED_IDLE )Toda tudi če ne programirate v Javi, lahko isto dosežete s pomočjo ukaza chrt:
chrt -i 0 $pidZbirajmo vse naše ravni izolacije v eno tabelo za večjo preglednost:
Razred izolacije
Primer alloc
Možnosti Docker run
sched_setscheduler chrt*
Prod
cpu = 4
--cpuquota=400000 --cpuperiod=100000
SCHED_OTHER
Batch
Cpu = [1, *)
--cpushares=1024
SCHED_BATCH
Idle
Cpu= [2, *)
--cpushares=2048
SCHED_IDLE
*Če izvajate chrt znotraj kontejnerja, je morda potrebna zmožnost sys_nice, saj ta zmožnost privzeto odvzame Docker ob zagonu kontejnerja.
Toda naloge porabljajo ne le procesor, ampak tudi promet, ki vpliva na zakasnitev omrežne naloge še bolj kot napačna dodelitev virov procesorja. Zato si seveda želimo doseči enako sliko tudi za promet. To pomeni, ko prod-naloga pošilja pakete v omrežje, kvotiramo maksimalno hitrost (formula alloc: lan=[*,500mbps) ), s katero lahko prod to počne. Za batch pa jamčimo le minimalno prepustnost, ne omejujemo pa maksimalne (formula alloc: lan=[10Mbps,*) ) Pri tem mora promet prod imeti prednost pred batch-nalogami.
Tukaj Docker nima nobenih primitívov, ki bi jih lahko uporabili. Ampak na pomoč nam pride . Uspešno smo dosegli želen rezultat s pomočjo discipline . S tem določamo dve classi prometa: visoko prioriteto prod in nizko prioriteto batch/idle. Na koncu konfiguracija za odhodni promet izgleda takole:
tukaj 1:0 — „koreninski qdisc“ discipline hsfc; 1:1 — podrazred hsfc s skupno hitrostjo pasovne širine 8 Gbit/s, pod katero spadajo podrazredi vseh kontejnerjev; 1:2 — podrazred hsfc, skupen za vse batch in idle naloge s „dinamično“ mejo, o kateri bo govora spodaj. Preostali podrazredi hsfc so dodeljeni razredi za aktivne prod-kontejnerje z omejitvami, ki ustrezajo njihovim manifestom — 450 in 400 Mbit/s. Vsakemu razredu hsfc je dodeljena qdisc vrsta fq ali fq_codel, odvisno od verzije jedra linux, da se preprečijo izgube paketov pri prometnih sunkih.
Običajno discipline tc služijo za prioritizacijo samo odhodnega prometa. Toda mi želimo prioritizirati tudi prihajajoči promet — saj lahko katera koli batch-naloga brez težav izkoristi celoten prihajajoči kanal, na primer, ko prejme velik paket vhodnih podatkov za map&reduce. Zato uporabljamo modul , ki ustvari virtualni vmesnik ifbX za vsak omrežni vmesnik in preusmeri prihajajoči promet z vmesnika v odhodni promet na ifbX. Nato za ifbX delujejo vse iste discipline za nadzor odhodnega prometa, pri čemer bo konfiguracija hsfc zelo podobna:
Med eksperimenti smo ugotovili, da hsfc dosega najboljše rezultate, ko se razred 1:2 neprioritetnega batch/idle prometa omeji na minionih na določeno prostorno pasovno širino. V nasprotnem primeru neprioritetni promet preveč vpliva na zakasnitve prod-nalog. Trenutno vrednost prostorne pasovne širine miniond določa vsako sekundo, ko izračunava povprečno porabo prometa vseh prod-nalog na tem minionu  in jo odšteje od pasovne širine omrežnega vmesnika
 s majhnim varovanjem, tj.

Pasovne širine se določajo za prihajajoči in odhodni promet neodvisno. V skladu z novimi vrednostmi miniond ponovno konfigurira omejitev neprioritetnega razreda 1:2.
Tako smo uresničili vse tri razrede izolacije: prod, batch in idle. Ti razredi močno vplivajo na zmogljivosti nalog. Zato smo se odločili, da to lastnost postavimo na vrh hierarhije, da bo ob pogledu na ime hierarhične vrste takoj jasno, s čim imamo opraviti:
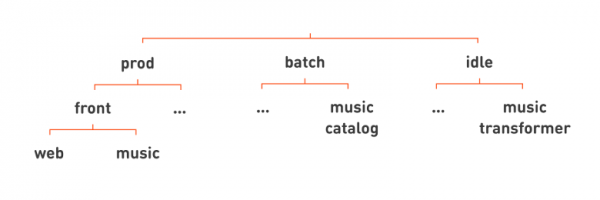
Vsi naši znani web in music fronji so nato v hierarhiji pod prod. Na primer, pod batch postavimo storitev music catalog, ki občas sestavi katalog skladb iz nabora naloženih mp3-datotek v „Odnoklassniki“. Primer storitve za idle je lahko transformator glasbe, ki normalizira raven glasnosti glasbe.
Znova, ko odstranimo odvečne vrstice, lahko imena naših storitev zapišemo bolj plosko, tako da dodamo razred izolacije naloge na konec polnega imena storitve: web.front.prod, catalog.music.batch, transformer.music.idle.
In zdaj, ko gledamo na ime storitve, razumemo ne le to, katero funkcijo opravlja, ampak tudi njen razred izolacije, kar pomeni njeno kritičnost itd.
Vse je super, a obstaja ena grenka resnica. Popolnoma izolirati naloge, ki delujejo na eni napravi, ni mogoče.
Česar smo dosegli: če batch intenzivno porablja le procesorske vire, vgrajeni načrtovalnik CPU Linux zelo dobro opravlja svoje naloge, vpliv na prod-nalogo pa je skoraj zanemarljiv. Toda če ta batch-naloga začne aktivno delati z pomnilnikom, se že začnejo kažejo medsebojni vplivi. To se zgodi, ker pri prod-nalogi „izpuhti“ procesorske predpomnilnike pomnilnika — na koncu se v predpomnilniku povečajo zgrešeni dostopi, procesor pa obdeluje prod-nalogo počasneje. Takšna batch-naloga lahko za 10 % poveča zakasnitev naše tipične prod-konfiguracije.
Izolirati promet je še bolj zahtevno, ker sodobne mrežne kartice vsebujejo notranjo vrsto paketov. Če paket iz batch-naloge pride tja prvi, bo tudi prvi prenesen po kablu, in tu ni nič za narediti.
Poleg tega nam je za zdaj uspelo rešiti le nalogo prioritetizacije TCP-prometa: za UDP pristop s hsfc ne deluje. In celo v primeru TCP-prometa, če batch-naloga generira veliko prometa, to povzroča tudi okoli 10 % povečanje zakasnitve prod-naloge.
Odporna zasnova
Eden od ciljev pri razvoju one-cloud je bil izboljšanje odpornosti Odnoklassnikov. Zato bi rad podrobneje obravnaval možne scenarije napak in nesreč. Začnimo s preprostim scenarijem — z izpadom kontejnerja.
Kontejner lahko odpove na več načinov. To je lahko eksperiment, napaka ali napaka v manifestu, zaradi katere začne produktna naloga porabljati več virov, kot je navedeno v manifestu. Imeli smo primer: razvijalec je implementiral kompleksen algoritem, ga večkrat predeloval, se zapletel tako, da se je na koncu naloga precej zapletla. Ker je bila produktna naloga prioriteta pred vsemi drugimi na istih minionih, je začela porabljati vse razpoložljive procesorske vire. V tej situaciji je izolacija rešila stvar, natančneje kvota na procesorsko čas. Če je nalogi dodeljena kvota, naloga ne bo porabila več. Zato batch in druge produktne naloge, ki so delale na isti napravi, niso opazile ničesar.
Druga možna težava – zrušitev kontejnerja. In tu nam pomagajo politike ponovnega zagona, vsi jih poznajo, Docker se s tem odlično odreže. Skoraj vse produktne naloge imajo politiko ponovnega zagona always. Včasih uporabljamo on_failure za batch naloge ali za odpravljanje napak pri produktnih kontejnerjih.
Kaj pa storiti, ko celoten minion ni dostopen?
Očitno je potrebno zagnati kontejner na drugem strežniku. Najbolj zanimivo pri tem je, kaj se zgodi z IP naslovom (naslovi), dodeljenimi kontejnerju.
Lahko dodelimo kontejnerjem iste IP naslove kot imamo pri minion napravah, na katerih se ti kontejnerji izvajajo. Takrat, ko se kontejner zažene na drugem strežniku, se njegov IP naslov spremeni in vsi odjemalci morajo razumeti, da se je kontejner preselil, zdaj se morajo povezati na drugo določen naslov, kar zahteva ločeno storitev za odkrivanje storitev.
Odkritje storitev je priročno. Na trgu je veliko rešitev raznolike stopnje odpornosti za organizacijo registra storitev. Pogosto so v takih rešitvah vključene logike uravnavača obremenitve, shranjevanje dodatne konfiguracije v obliki KV shrambe itd.
Vendar pa bi si želeli izogniti potrebi po uvedbi ločenega registra, saj bi to pomenilo uvedbo kritičnega sistema, ki ga uporabljajo vse storitve v produkciji. To pomeni, da je to potencialna točka odpovedi, in treba je izbrati ali razviti zelo odporn rešitev, kar je očitno zelo težko, dolgotrajno in drago.
In addition, another major drawback is that for our old infrastructure to integrate with the new one, we would have to rewrite all tasks to use some form of Service Discovery system. The work involved is ENORMOUS, and in some cases, it borders on impossible, especially when it comes to low-level devices operating at the OS kernel level or directly with hardware. Implementing this functionality using established solution patterns, like for instance would mean occasionally adding extra load, complicating operations in some instances, and introducing additional failure scenarios. We didn't want to complicate things, so we decided to make the use of Service Discovery optional.
In one-cloud, the IP follows the container, meaning each task instance has its own unique IP address. This address is 'static': it is assigned to each instance at the moment of its first deployment into the cloud. If during its lifetime the service has multiple instances, it will end up having as many IP addresses as there were maximum instances.
Subsequently, these addresses do not change: they are assigned once and remain throughout the entire lifespan of the service in production. The IP addresses follow the containers across the network. If a container is moved to another minion, the address will also move with it.
Thus, the mapping of the service name to its list of IP addresses changes very rarely. If we look again at the service instance names mentioned at the beginning of the article (1.ok-web.group1.web.front.prod, 2.ok-web.group1.web.front.prod, …), bomo opazili, da spominjajo na FQDN, ki se uporablja v DNS. In res je, za prikazovanje imen primerkov storitev v njihovih IP-naslovih uporabljamo DNS protokol. Pri tem ta DNS vrne vse rezervirane IP-naslove vseh kontejnerjev — tako delujočih kot ustavljenih (recimo, da so aktivne tri replikacije, a imamo pet rezerviranih naslovov — vseh pet se bo vrnilo). Stranke, ki prejemajo te informacije, bodo poskušale vzpostaviti povezavo z vsemi petimi replikami — in tako bodo ugotovile, katere od njih so aktivne. Tak način ugotavljanja dostopnosti je bistveno bolj zanesljiv, saj ne vključuje niti DNS niti odkrivanja storitev, kar pomeni, da ni težav z zagotavljanjem ažurnosti informacij in odpornosti teh sistemov. Poleg tega lahko v kritičnih storitvah, od katerih je odvisno delovanje celotnega portala, sploh ne uporabljamo DNS, temveč preprosto vnesemo IP-naslove v konfiguracijo.
Izvedba take premestitve IP za kontejnerji je lahko zapletena — in osredotočili se bomo na to, kako to deluje, na naslednjem primeru:
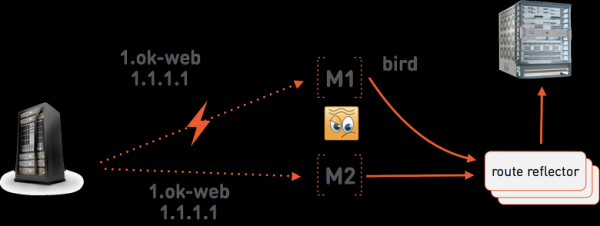
Recimo, da glavni one-cloud da ukaz minionu M1, da zažene 1.ok-web.group1.web.front.prod z naslovom 1.1.1.1. Na minionu deluje , ki oglašuje ta naslov na posebne strežnike . Ti imajo BGP sejo s strojno opremo omrežja, na katero se prenaša pot do naslova 1.1.1.1 na M1. M1 usmerja pakete v notranjost kontejnerja že z uporabo Linuxa. Imamo tri strežnike route reflector, saj je to zelo kritičen del infrastrukture one-cloud — brez njih omrežje v one-cloud ne bo delovalo. Postavili smo jih v različne omare, kolikor je mogoče, v različne dvorane podatkovnega centra, da zmanjšamo verjetnost hkratnega odpovedi vseh treh.
Zdaj predpostavimo, da je povezava med glavnim one-cloud in minionom M1 izginila. Glavni one-cloud bo zdaj deloval na podlagi predpostavke, da je M1 popolnoma odpovedal. To pomeni, da bo dal ukaz minionu M2, da zažene web.group1.web.front.prod z istojnim naslovom 1.1.1.1. Zdaj imamo dve nasprotujoči si poti v omrežju za 1.1.1.1: na M1 in na M2. Za reševanje takšnih konfliktov uporabljamo Multi Exit Discriminator, ki je naveden v BGP napovedi. To je številka, ki označuje težo napovedane poti. Iz nasprotujočih si se bo izbrala pot z manjšim vrednostjo MED. Master one-cloud podpira MED kot integralni del IP naslovov kontejnerjev. Prvič se naslov izda z dovolj velikim MED = 1.000.000. V primeru takega nujnega prenosa kontejnerja master zmanjša MED, in M2 bo prejel ukaz, da napove naslov 1.1.1.1 z MED = 999.999. Instanca, ki deluje na M1, bo ob tem ostala brez povezave, njena nadaljnja usoda nas malo zanima do trenutka, ko bo povezava z masterjem ponovno vzpostavljena, takrat pa bo ustavljena kot stara kopija.
Kršitve
Vse sisteme za upravljanje podatkovnih centrov je vedno sprejemljivo obvladati manjše okvare. Izpad kontejnerja je norma skoraj povsod.
Poglejmo, kako obvladujemo kršitev, na primer izpad električne energije v eni ali več dvoranah podatkovnega centra.
Kaj pomeni kršitev za sistem upravljanja podatkovnega centra? Najprej je to množična enkratna okvara mnogih strojev, in sistem upravljanja mora hkrati migrirati zelo veliko kontejnerjev. A če je kršitev zelo obsežna, se lahko zgodi, da vseh nalog ni mogoče prenesti na druge vozliščne naprave, ker zmogljivost podatkovnega centra pade pod 100 % obremenitve.
Pogosto so kršitve povezane z okvaro upravljalskega sloja. To se lahko zgodi zaradi okvare njegove opreme, vendar pogosteje zaradi tega, ker kršitve niso testirane in upravljalski sloj sam pade pod povečano obremenitvijo.
Kaj lahko storimo v zvezi s tem?
Množne migracije pomenijo, da se v infrastrukturi pojavi velika količina dejanj, migracij in nastanitev. Vsaka od migracij lahko traja nek čas potreben za dostavo in razpakiranje slik kontejnerjev do vozlišč, zagon in inicializacijo kontejnerjev itd. Zato je priporočljivo, da se pomembnejše naloge zaženejo pred manj pomembnimi.
Poglejmo ponovno znano hierarhijo storitev in poskusimo rešiti, katere naloge želimo zagnati najprej.
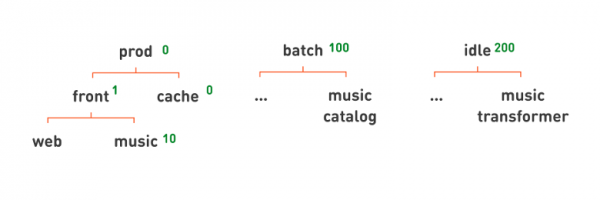
Seveda, to so tisti procesi, ki neposredno sodelujejo pri obdelavi uporabniških zahtev, tj. prod. To označimo z prednostjo postavitve — številom, ki ga lahko dodelimo vrsti. Če ima neka vrsta višjo prednost, se njeni storitvi postavijo na prvo mesto.
Na prod dodelimo višje prednosti, 0; na batch pa malo nižje, 100; na idle pa še nižje, 200. Prednosti se uporabljajo hierarhično. Vse naloge, ki so nižje v hierarhiji, bodo imele ustrezno prednost. Če želimo, da se v prod znotraj predpomnilnikov izvajajo najprej, jih dodelimo prednost = 0, za front podvrste pa = 1. Če pa želimo, da se z frontov najprej izvaja glavni portal, kasneje pa music front, lahko temu zadnjemu dodelimo nižjo prednost — 10.
Naslednji problem je pomanjkanje virov. Tako smo imeli odpoved velikega števila opreme, celih dvoran podatkovnih centrov, mi pa smo zagnali toliko storitev, da zdaj ni dovolj virov za vse. Moramo se odločiti, katerim nalogam se odpovedati, da bodo delovale glavne kritične storitve.
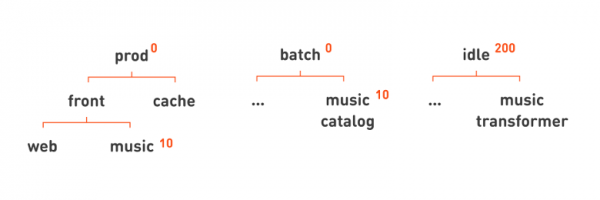
V nasprotju s prednostjo postavitve ne moremo kar tako odpovedati vsem batch-naloga, nekatere od njih so pomembne za delovanje portala. Zato smo posebej izpostavili prednost izrivanja naloge. Pri postavitvi lahko naloga z višjo prednostjo izrine, tj. ustavi nalogo z nižjo prednostjo, če ni več prostih minionov. Pri tem naloga z nižjo prednostjo verjetno ostane nepostavljena, tj. zanj ni več primernega miniona z dovolj prostimi viri.
V naši hierarhiji je zelo enostavno nastaviti takšno prednost izrivanja, da prod- in batch-naloge izrinjajo ali ustavljajo idle-naloge, vendar ne med seboj, tako da idle dodelimo prednost 200. Tako kot pri prednosti postavitve lahko izkoristimo našo hierarhijo za opisovanje bolj zapletenih pravil. Na primer, navedemo, da bomo funkcijo glasbe žrtvovali, če nam ne bodo zadostovali viri za glavni spletni portal, s čimer nastavimo odgovarjajočim vozliščem nižjo prednost: 10.
Popolne okvare DCA
Zakaj lahko odpove celoten podatkovni center? Naravna nesreča. Bilo je dober prispevek, kako . Element osebnosti lahko štejemo brezdomce, ki so nekega dne v kolektorju zažgali optiko, zaradi česar je celoten podatkovni center izgubil povezavo z ostalimi lokacijami. Razlog za okvaro je lahko tudi človeški faktor: operater lahko izda ukaz, zaradi katerega celoten podatkovni center pade. Do tega lahko pride zaradi velike napake. Na splošno padci podatkovnih centrov niso redki. Pri nas se to zgodi vsakih nekaj mesecev.
In to je, kar počnemo, da nihče #okživin ne objavlja na Twitterju.
Prva strategija je izolacija. Vsak inštanc one-cloud je izoliran in lahko upravlja samo naprave enega podatkovnega centra. Torej izguba oblaka zaradi napak ali napačnega ukaza operaterja pomeni izgubo le enega podatkovnega centra. Na to smo pripravljeni: obstaja politika rezerviranja, pri kateri so kopije aplikacij in podatkov razporejene v vseh podatkovnih centrih. Uporabljamo odpornosti baze podatkov in redno testiramo odpovedi.
Ker imamo danes štiri podatkovne centre, imamo tudi štiri popolnoma izolirane in ločene primere one-cloud.
Tak pristop ne le da ščiti pred fizično okvaro, temveč lahko zaščiti tudi pred napakami operaterja.
Kaj še lahko storimo glede človeškega faktorja? Ko operater da oblaku nek nenavaden ali potencialno nevaren ukaz, od njega lahko nenadoma zahtevajo, da reši majhno nalogo, da preveri, koliko dobro je razmislil. Na primer, če gre za množično ustavitev številnih kopij ali preprosto nenavadno ukaz — zmanjšanje števila kopij ali sprememba imena slike, ne le številke različice v novem manifestu.
Zaključki
Posebnosti one-cloud:
- Hierarhična in pregledna shema poimenovanja storitev in vsebnika, ki omogoča zelo hitro ugotovitev, kaj je naloga, na kaj se nanaša, kako deluje in kdo je za to odgovoren.
- Uveljavili smo svojo tehniko združevanja prod- in batch-nalog na minionih, da povečamo učinkovitost skupne rabe naprav. Namesto cpuset uporabljamo kvote CPU, delitve, politike načrtovanja CPU in Linux QoS.
- Popolnoma izolirati kontejnerjev, ki delujejo na eni napravi, ni uspelo, a njihov medsebojni vpliv ostaja v okviru do 20%.
- Organizacija storitev v hierarhijo pomaga pri samodejnem odpravljanju napak s pomočjo prednostnih nalog in izločitve.
ČFAQ
Zakaj nismo sprejeli že pripravljenih rešitev.
- Različni razredi izolacije nalog zahtevajo različno logiko pri namestitvi na minione. Medtem ko lahko prod-naloge namestimo preprosto z rezervacijo virov, je treba batch in idle naloge namestiti ob upoštevanju dejanske izrabe virov na minionih.
- Potrebno je upoštevati vire, ki jih naloge porabljajo, kot so:
- pasovna širina omrežja;
- tipi in 'spindli' diskov.
- Potrebno je določiti prioritete storitev pri odpravljanju izpadov, pravice in kvote ekip na vire, kar se reši z uporabo hierarhičnih vrst v one-cloud.
- Potrebno je imeti človeška imena kontejnerjev za zmanjšanje časa odziva na izpade in incidente.
- Nemogoče je hkrati in povsod vpeljati Service Discovery; potrebno je dolgo časa soobstajati z nalogami, nameščenimi na fizičnih strežnikih — kar se reši s "statičnimi" IP naslovi, povezanimi s kontejnerji, in posledično potrebo po edinstveni integraciji z obsežno omrežno infrastrukturo.
Vse te funkcije bi terjale obsežne predelave obstoječih rešitev, in ob oceni količine dela smo spoznali, da lahko razvijemo lastno rešitev približno z enakimi delovnimi napori. Toda lastna rešitev bo še veliko lažja za obvladovanje in razvoj — v njej ni nepotrebnih abstrakcij, ki podpirajo nam nepotrebne funkcionalnosti.
Hvala tistim, ki ste prebrali zadnje vrstice, za vašo potrpežljivost in pozornost!
Izvor: habr.com
