

Pred pol leta — javno k PostgreSQL.
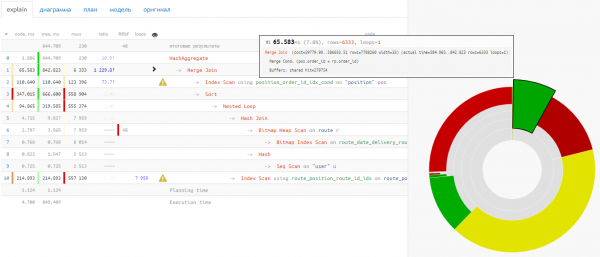
V preteklih mesecih smo opravili poročilo o njem , pripravili splošni na podlagi priporočil, ki jih daje... najpomembneje pa smo zbirali vaše povratne informacije in spremljali dejanske primere uporabe.
In zdaj smo pripravljeni govoriti o novih možnostih, ki jih lahko uporabljate.
Podpora različnim formatom načrtov
Načrt iz dnevnika, skupaj z poizvedbo
Kar iz konzole označimo celotno polje, začenši s vrstico z Query Text, skupaj z vsemi vodilnimi presledki:
        Query Text: INSERT INTO  dicquery_20200604  VALUES ($1.*) ON CONFLICT (query)
                           DO NOTHING;
        Insert on dicquery_20200604  (cost=0.00..0.05 rows=1 width=52) (actual time=40.376..40.376 rows=0 loops=1)
          Conflict Resolution: NOTHING
          Conflict Arbiter Indexes: dicquery_20200604_pkey
          Tuples Inserted: 1
          Conflicting Tuples: 0
          Buffers: shared hit=9 read=1 dirtied=1
          ->  Result  (cost=0.00..0.05 rows=1 width=52) (actual time=0.001..0.001 rows=1 loops=1)
… in vse kopirano preprosto vržemo v polje za načrt, brez kakršnegakoli ločevanja:
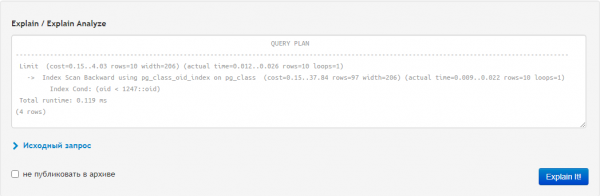
Na izhodu dobimo bonus k razčlenjenemu načrtu še zavihek „kontekst“, kjer je naša poizvedba predstavljena v vsej svoji lepoti:
JSON in YAML
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT * FROM pg_class;
"[
{
"Plan": {
"Node Type": "Seq Scan",
"Parallel Aware": false,
"Relation Name": "pg_class",
"Alias": "pg_class",
"Startup Cost": 0.00,
"Total Cost": 1336.20,
"Plan Rows": 13804,
"Plan Width": 539,
"Actual Startup Time": 0.006,
"Actual Total Time": 1.838,
"Actual Rows": 10266,
"Actual Loops": 1,
"Shared Hit Blocks": 646,
"Shared Read Blocks": 0,
"Shared Dirtied Blocks": 0,
"Shared Written Blocks": 0,
"Local Hit Blocks": 0,
"Local Read Blocks": 0,
"Local Dirtied Blocks": 0,
"Local Written Blocks": 0,
"Temp Read Blocks": 0,
"Temp Written Blocks": 0
},
"Planning Time": 5.135,
"Triggers": [
],
"Execution Time": 2.389
}
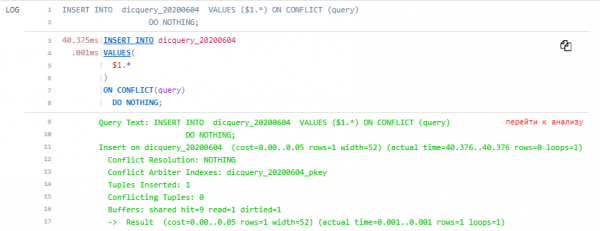
]"Naj bo z zunanjimi narekovaji, kot jih kopira pgAdmin, ali brez — vržemo v isto polje, in na izhodu — lepota:
Podrobna vizualizacija
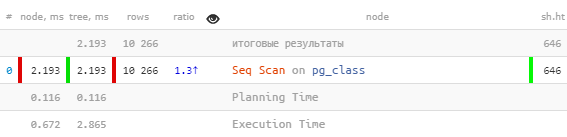
Planning Time / Execution Time
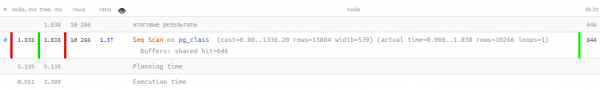
Zdaj je bolje vidno, kam je odšlo dodatno čas pri izvršitvi poizvedbe:
I/O Timing
Včasih se srečamo s situacijo, ko v načrtu zares ni bilo preveč branja-pisanja virov, a se zdi, da je bil čas izvajanja nerazumljivo dolgo.
Tu moramo reči: "O, verjetno je bil takrat disk na strežniku preobremenjen, zato se je dolgotrajno branje!" Ampak to ni preveč natančno…
A to lahko določimo zanesljivo. Gre namreč za to, da med možnostmi konfiguracije PG strežnika obstaja :
Vključuje merjenje časa operacij vhoda/izhod. Ta parameter je privzeto izklopljen, saj za to natančno merjenje osveževanj sistema zahteva neprekinjeno pridobitev trenutnega časa, kar lahko močno upočasni delovanje na nekaterih platformah. Za oceno stroškov merjenja časa na vaši platformi lahko uporabite orodje pg_test_timing. Statistika vhod/izhod je dostopna skozi prikaz pg_stat_database, v izhodu EXPLAIN (ko je uporabljen parameter BUFFERS) in skozi prikaz pg_stat_statements.
Ta parameter je mogoče vključiti tudi v okviru lokalne seje:
SET track_io_timing = TRUE;Sedaj pa najbolj zanimivo — naučili smo se razumeti in prikazovati te podatke ob upoštevanju vseh transformacij izvršilnega drevesa:
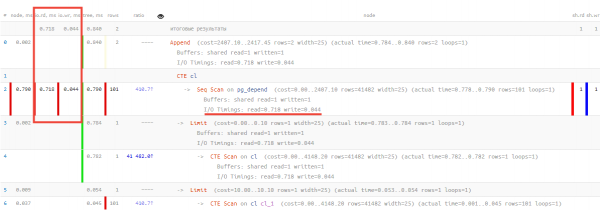
Tukaj lahko opazimo, da je od 0.790 ms celotnega časa izvrševanja 0.718 ms trajala branje ene strani podatkov, 0.044 ms — zapis iste strani, medtem ko je preostala uporabna aktivnost vzela le 0.028 ms!
Prihodnost s PostgreSQL 13
Obsežno preučitev novosti lahko najdete , mi pa se bomo osredotočili na spremembe v načrtih.
Načrtovanje pomnilnika
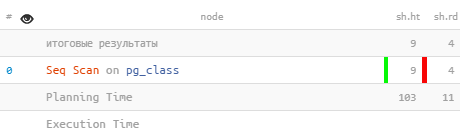
Upoštevanje virov, dodeljenih načrtovalniku, je našlo odraz še v enem popravku, ki se ne nanaša na pg_stat_statements. EXPLAIN z možnostjo BUFFERS bo poročal o številu pomnilnikov, uporabljenih v fazi načrtovanja:
 Seq Scan on pg_class (actual rows=386 loops=1)
   Buffers: shared hit=9 read=4
 Planning Time: 0.782 ms
   Buffers: shared hit=103 read=11
 Execution Time: 0.219 ms
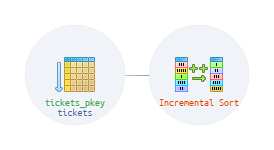
Inkrementalno razvrščanje
V primerih, ko je potrebna razvrstitev po več ključih (k1, k2, k3…), lahko načrtovalnik sedaj izkoristi znanje o tem, da so podatki že razvrščeni po nekaterih od prvih ključev (na primer, k1 in k2). V tem primeru ni potrebno, da bi znova razvrstili vse podatke, ampak jih lahko razdelimo na zaporedne skupine s istimi vrednostmi k1 in k2 ter jih še „dovrstimo“ po ključu k3.
Tako se vse razvrščanje razdeli na več zaporednih razvrščanj manjših velikosti. To znižuje obseg potrebnega pomnilnika in omogoča, da se prvi podatki vrnejo hitreje, preden je vse razvrščanje popolnoma zaključeno.
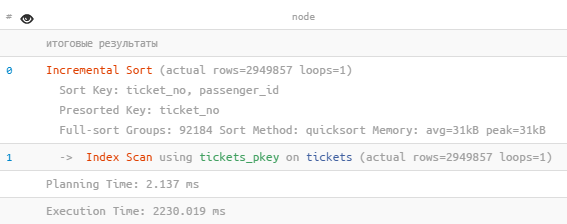
 Inkrementalna razvrstitev (actual rows=2949857 loops=1)
   Sort Key: ticket_no, passenger_id
   Presorted Key: ticket_no
   Full-sort Groups: 92184 Sort Method: quicksort Memory: avg=31kB peak=31kB
   ->  Index Scan using tickets_pkey on tickets (actual rows=2949857 loops=1)
 Planning Time: 2.137 ms
 Execution Time: 2230.019 ms
Izboljšave UI/UX
Zasloni so povsod!
Sedaj je na vsakem zavihku mogoče hitro screenshot tablice v schranju čez celo širino in globino tablice — »teleskop« desno zgoraj:
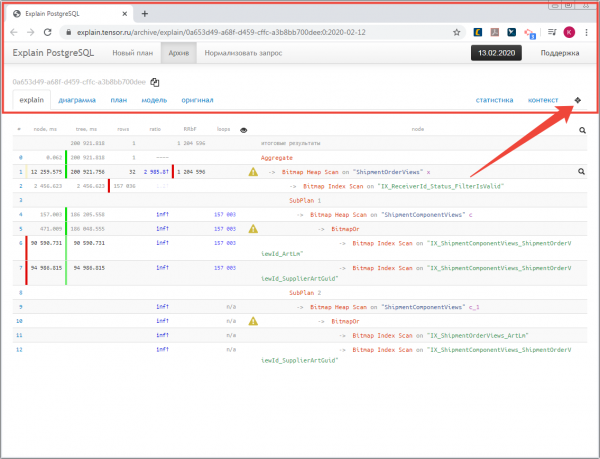
Večina slik za to objavo je bila pridobljena na ta način.
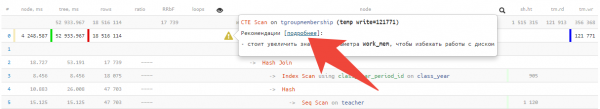
Priporočila na vozliščih
Ni le več, temveč o vsakem lahko , tako da kliknete na povezavo:
Odstranitev iz arhiva
Nekateri so zelo prosili za dodajanje možnosti »popolnoma« odstranjevati tudi neobjavljene načrte v arhivu — prosim, dovolj je, da kliknete ustrezno ikono:
No, in ne pozabimo, da imamo , kamor lahko pišete svoje pripombe in predloge.
Izvor: habr.com
