

V letu 2018 se je v profesionalnih krogih in na tematskih konferencah o AI uveljavila terminologija MLOps, ki je hitro pridobila priljubljenost v industriji in se zdaj razvija kot samostojno področje. V prihodnosti bi MLOps lahko postalo eno najbolj iskanih področij v IT. Kaj to sploh je in kako ga uporabiti, razjasnimo v nadaljevanju.
Kaj je MLOps
MLOps (povezovanje tehnologij in procesov strojnega učenja ter pristopov k implementaciji izdelanih modelov v poslovne procese) je nov način sodelovanja med predstavniki poslovanja, znanstveniki, matematičnimi strokovnjaki, strokovnjaki za strojno učenje in IT-inženirji pri ustvarjanju sistemov umetne inteligence.
Z drugimi besedami, to je način preoblikovanja metod in tehnologij strojnega učenja v koristne instrumente za reševanje poslovnih nalog.
Pomembno je razumeti, da se veriga produktivizacije začne dolgo pred razvojem modela. Njena prva stopnja je opredelitev poslovne naloge, hipotez o vrednosti, ki jo je mogoče pridobiti iz podatkov, ter poslovne ideje za njeno uporabo.
Pojem MLOps se je razvil kot analogija pojmu DevOps glede na modele in tehnologije strojnega učenja. DevOps je pristop k razvoju programske opreme, ki omogoča povečanje hitrosti uvajanja posameznih sprememb ob ohranjanju prilagodljivosti in zanesljivosti s pomočjo različnih metod, med katerimi so stalni razvoj, delitev funkcij na neodvisne mikrostoritve, avtomatizirano testiranje in implementacija posameznih sprememb, globalno spremljanje delovanja in sistem za hitro ukrepanje pri odkritih napakah itd.
DevOps je opredelil življenjski cikel programske opreme in v skupnosti strokovnjakov se je pojavila ideja, da bi to metodo uporabili tudi za velike podatke. DataOps je poskus prilagajanja in širjenja metodologije ob upoštevanju značilnosti shranjevanja, prenosa in obdelave velikih količin podatkov na raznolikih in medsebojno povezanih platformah.
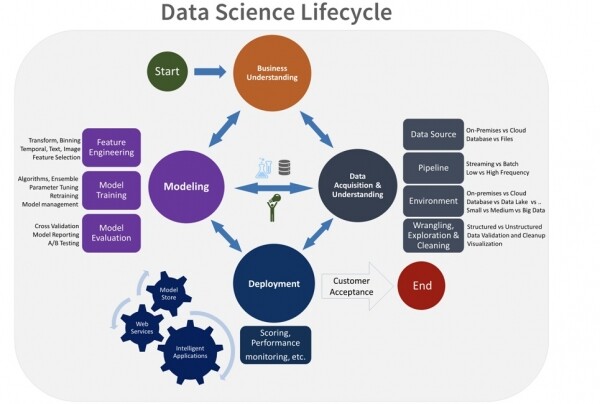
S prihodom določene kritične mase modelov strojnega učenja, vgrajenih v poslovne procese podjetij, je bilo opaziti močno podobnost življenjskega cikla matematičnih modelov strojnega učenja in življenjskega cikla programske opreme. Razlika je le v tem, da so algoritmi modelov ustvarjeni s pomočjo orodij in metod strojnega učenja. Zato se je naravno pojavila ideja, da se že znani pristopi k razvoju programske opreme uporabijo in prilagodijo za modele strojnega učenja. Tako lahko v življenjskem ciklu modelov strojnega učenja izpostavimo naslednje ključne faze:
- opredelitev poslovne ideje;
- usposabljanje modela;
- testiranje in uvajanje modela v poslovni proces;
- uporaba modela.
Ko se v procesu uporabe pojavi potreba po spremembi ali dodatnem usposabljanju modela na novih podatkih, se cikel ponovno zažene - model se izboljša, testira in nalaga nova različica.
Odstotek. Zakaj dodatno usposabljati, ne pa ponovno usposabljati? Termin „ponovno usposabljanje modela“ ima dva pomena: med strokovnjaki pomeni napako modela, ko model dobro napoveduje, dejansko ponavlja napovedani parameter na učni množici, vendar deluje veliko slabše na zunanjih podatkih. Seveda je tak model okvara, saj ta napaka ne omogoča njegove uporabe.
V tem življenjskem ciklu se zdi smiselno uporabljati orodja DevOps: avtomatizirano testiranje, nameščanje in spremljanje, oblikovanje izračuna modelov v obliki posameznih mikroservisov. Vendar pa obstaja tudi vrsta posebnosti, ki preprečujejo neposredno uporabo teh orodij brez dodatnega ML-vmesnika.
Kako prisiliti modele, da delujejo in prinašajo dobiček
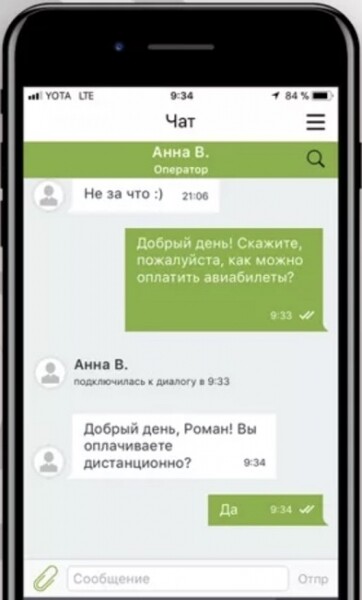
Kot primer, s katerim bomo prikazali uporabo pristopa MLOps, bomo vzeli klasično nalogo robotizacije klepeta pri podpori bančnega (ali katerega koli drugega) produkta. Običajno poslovni proces podpore s pomočjo klepeta izgleda tako: stranka vnese v klepet sporočilo z vprašanjem in prejme odgovor strokovnjaka v okviru vnaprej določenega drevesa dialogov. Naloga avtomatizacije takšnega klepeta se običajno rešuje s pomočjo strokovno določenih nizov pravil, ki so zelo delovno intenzivni za razvoj in vzdrževanje. Učinkovitost takšne avtomatizacije, odvisno od ravni kompleksnosti naloge, lahko doseže 20–30%. Naravno se pojavi ideja, da bi bilo bolj donosno uvesti modul umetne inteligence — model, razvit s pomočjo strojnega učenja, ki:
- je sposoben obdelati brez udeležbe operaterja večje število zahtevkov (odvisno od teme, v nekaterih primerih lahko učinkovitost doseže 70–80%);
- se bolje prilagaja nenavadnim formulacijam v dialogu — zna določiti namen, resnično željo uporabnika ob nejasno formuliranem zahtevku;
- zna ugotoviti, kdaj je odgovor modela ustrezen, in kdaj so ob odgovoru dvomi o njegovi 'zavednosti', kar zahteva postavitev dodatnega pojasnjevalnega vprašanja ali preklop na operaterja;
- se lahko dodatno učijo avtomatizirano (namesto skupine razvijalcev, ki nenehno prilagajajo in popravljajo scenarije odgovorov, model dodatno uči strokovnjak za podatkovne vede, ki uporablja ustrezne knjižnice strojnega učenja).
Kako spraviti tako napreden model v delovanje?
Tako kot pri reševanju katere koli druge naloge, preden začnemo razvijati tak modul, moramo opredeliti poslovni proces in formalno opisati konkretno nalogo, ki jo bomo reševali s pomočjo metode strojnega učenja. Na tej točki se začne postopek operativizacije, označen z okrajšavo Ops.
Naslednji korak strokovnjaka za podatkovne vede v sodelovanju z inženirjem za podatke je preveriti razpoložljivost in zadostnost podatkov ter poslovne hipoteze o izvedljivosti poslovne ideje, razviti prototip modela in preveriti njegovo dejansko učinkovitost. Šele po potrditvi s strani podjetja se lahko začne prehod od razvoja modela k njegovi integraciji v sisteme, ki izvajajo konkretne poslovne procese. Načrtovanje uvedbe, globoko razumevanje v vsakem koraku, kako bo model uporabljen in kakšen ekonomski učinek bo prinesel, je temeljnega pomena pri uvajanju pristopov MLOps v tehnološko krajino podjetja.
Z razvojem tehnologij umetne inteligence se število in raznolikost nalog, ki jih je mogoče rešiti s pomočjo strojnega učenja, eksponentno povečujeta. Vsak tak poslovni proces predstavlja prihranek za podjetje z avtomatizacijo dela zaposlenih na množičnih mestih (klicni center, preverjanje in razvrščanje dokumentov itd.), širitev baze strank z dodajanjem novih privlačnih in priročnih funkcij, prihranek sredstev z optimalno rabo in prerazporeditvijo virov ter še mnogo več. Na koncu je vsak proces usmerjen v ustvarjanje vrednosti in bi, kot posledica, moral prinašati določen ekonomski učinek. Pri tem je zelo pomembno jasno oblikovati poslovno idejo in izračunati predvideni dobiček od uvedbe modela v splošni strukturi ustvarjanja vrednosti podjetja. Pojavljajo se situacije, ko uvedba modela ne upraviči sama sebe in čas, ki ga porabijo strokovnjaki za strojno učenje, stane precej več kot delovno mesto operaterja, ki to nalogo izvaja. Zato je pomembno, da takšne primere poskušamo prepoznati v zgodnjih fazah ustvarjanja sistemov umetne inteligence.
Tako profit modela začne prinašati šele takrat, ko je bila v procesu MLOps pravilno formulirana poslovna naloga, postavljeni prioriteti in v zgodnjih fazah razvoja oblikovan proces uvajanja modela v sistem.
Nov proces - novi izzivi
Obsežna odgovor na ključno vprašanje podjetništva, kako se ML modeli uporabljajo za reševanje nalog, je splošno vprašanje zaupanja v AI – to je en izmed ključnih izzivov pri razvoju in uvajanju pristopov MLOps. Sprva podjetja skeptično gledajo na uvedbo strojnega učenja v procese – težko se je zanašati na modele na mestih, kjer so doslej običajno delali ljudje. Podjetjem se programi zdijo kot 'črna škatla', katere relevantnost odgovorov jo je še treba dokazati. Poleg tega v bančnem sektorju, na področju telekomunikacij in drugje obstajajo strogi zahtevki državnih regulatorjev. Vse sisteme in algoritemi, ki so implementirani v bančne procese, so predmet revizije. Da bi rešili to nalogo in dokazali podjetjem ter regulatorjem utemeljenost in pravilnost odgovorov umetne inteligence, se skupaj z modelom implementirajo orodja za spremljanje. Poleg tega obstaja postopek neodvisne validacije, ki je obvezen za regulirane modele in izpolnjuje zahteve CB. Neodvisna strokovna skupina izvede revizijo rezultatov, prejetih od modela ob upoštevanju vhodnih podatkov.
Drug izziv je ocena in upoštevanje modelnih tveganj pri uvajanju modela strojnega učenja. Tudi če človek ne more z 100-odstotno gotovostjo odgovoriti na vprašanje, ali je bilo tisto obleko bele ali modre barve, ima tudi umetna inteligenca pravico do napake. Prav tako je treba upoštevati, da se lahko sčasoma podatki spreminjajo in modeli se morajo dodatno učiti, da bi zagotavljali dovolj natančne rezultate. Da bi poslovni proces ostal neokrnjen, je potrebno upravljati modelna tveganja in spremljati delovanje modela ter ga redno izobraževati na novih podatkih.
Toda po prvem obdobju nezaupanja se začne pojavljati nasproten učinek. Kar več modelov se uspešno uvaja v procese, večji je apetit podjetij za uporabo umetne inteligence – odkrivajo se nove in nove naloge, ki jih je mogoče rešiti s metodami strojnega učenja. Vsaka naloga sproži celoten proces, ki zahteva različne kompetence:
- podatni inženirji pripravljajo in obdelujejo podatke;
- podatni znanstveniki uporabljajo orodja strojnega učenja in razvijajo modele;
- IT внедrivat' model' v sistemu;
- ML-inzhener opredelyaet, kak etu model' korrektno vstroyt' v protsess, kakoy IT-instrumentariy ispol'zovat' v zavisimosti ot trebovaniy k rezhimu primeneniya model'i s uchetom potoka obratnykh svyazei, vremeni otvetstva i t.p.
- ML-arkhitektor proektirovat', kak fizicheski mozhno realizovat' programmnij produkt v promyshlennoy sisteme.
Ves' tsikl trebuyet bol'shogo kolichestva vysokokvalifitsirovannykh spetsialistov. V opredelennoy tochke razvitiya i stepeni proniknoveniya ML-modeli v biznes-protsessy okazyvayetsya, chto lineynoe massivirovanie chisla spetsialistov propotsional'no rostu kolichestva zadach stanoet dorogim i neeffektyvnym. Poetomu voznikayet vopros avtomatizatsii protsessa MLOps — opredelenie neskol'kikh standartnykh klassov zadach mashinnogo obucheniya, razrabotka tipovykh payplaynov obrabotki dannykh i doobucheniya modelей. V ideal'noy kartine dlya resheniya takikh zadach trebuyutsya professionaly, odinakovo khorosho vladeushchikh kompetentsiyami na styke BigData, Data Science, DevOps i IT. Poetomu samaya bol'shaya problema v industrii Data Science i samy bol'shoy vyzov pri organizatsii protsessov MLOps — eto otsutstvie takoy kompetentsii na imeyushchaysya rynke podgotovki kadr. Spetsialisty, udovletvoryayushchie takim trebovaniyam, v nastoyashchiy moment yedinichny na rynke truda i tsenitsya na ves zolota.
K voprosu o kompetentsiyakh
V teorii vse zadachi MLOps mozhno reshat' klassicheskimi instrumentami DevOps i ne pribeгать k spetsializirovannomu rasshireniyu rolevoy modeli. Togda, kak my uzhe otmetili vyshe, data-sayentist dolzhen byt' ne tol'ko matematikom i spetsialistom po analitike dannykh, no i guru vsego payplayna — na ego plechy lezhit razrabotka arkhitektury, programmiranie modely na neskol'kikh yazykakh v zavisimosti ot arkhitektury, podgotovka vitriny dannykh i deploy-ment samogo prilozheniya. Odnakov sozdanie tekhnologicheskoy obvyazki, realizuemoy v skvoznom protsesse MLOps, zajmet do 80% trudozatrat, a eto znachit, chto kvalifitsirovannyy matematika, kotoriy yavlyaetsya kachestvennym Data Scientist, budet tol'ko 20% vremeni posvyashchat' svoey spetsial'nosti. Poetomu razgranichenie rol' spetsialistov, osushchestvlyayushchikh protsess vnedreniya modelей mashinnogo obucheniya, stanoet zhiznennoy neobkhodimost'yu.
Kako detaljno treba razdvojiti uloge, zavisi od veličine preduzeća. Jedna je stvar kada u startapu jedan stručnjak, radnik sa rezervom energije, preuzima sve uloge — inženjera, arhitekta i DevOps. Sasvim druga stvar je kada u velikom preduzeću svi procesi razvoja modela budu koncentrisani na nekoliko stručnjaka iz Data Science, dok programer ili stručnjak za baze podataka — što je mnogo češća i manje skupa kompetencija na tržištu rada — može preuzeti većinu rutinskih zadataka.
Dakle, od toga gde prolazi granica u izboru stručnjaka za obezbeđivanje procesa MLOps i kako je organizovan proces operativizacije razvijenih modela, direktno zavisi brzina i kvaliteta razvijenih modela, produktivnost tima i mikroklima u njemu.
Šta je već sada urađeno od strane našeg tima
Nedavno smo počeli da gradimo strukturu kompetencija i procese MLOps. Ali već su u fazi testiranja MVP naši projekti za upravljanje životnim ciklusom modela i za korišćenje modela kao servis.
Takođe smo definisali optimalnu strukturu kompetencija i organizacionu strukturu interakcije među svim učesnicima procesa za veliko preduzeće. Organizovane su Agile ekipe koje rešavaju zadatke za ceo spektar poslovnih klijenata, kao i uspostavljen je proces interakcije s projektnim timovima za izradu platformi i infrastrukture koja je osnova izgrađenog MLOps sistema.
Pitanja za budućnost
MLOps je razvijajući pravac koji oseća nedostatak kompetencija i u budućnosti će dobiti na značaju. A dokle god, najbolje je oslanjati se na postignuća i prakse DevOps. Osnovni cilj MLOps je efikasnije korišćenje ML modela za rešavanje poslovnih zadataka. No, pri tome se postavlja mnogo pitanja:
- Kako skratiti vreme do pokretanja modela u proizvodnji?
- Kako smanjiti birokratske prepreke između timova različitih kompetencija i povećati fokus na saradnju?
- Kako pratiti modele, upravljati verzijama i organizovati efikasan nadzor?
- Kako stvoriti zaista ciklični životni ciklus za savremeni ML model?
- Kako standardizovati proces mašinskog učenja?
Odgovori na ta vprašanja bodo v veliki meri določili, kako hitro bo MLOps razkril svoj polni potencial.
Izvor: habr.com
