

Prevod članka pripremljen je uoči početka kursa .
Kako prihraniti na stroških oblakov pri delu s Kubernetes? Edine pravne rešitve ni, vendar ta članek opisuje več orodij, ki vam bodo pomagala bolj učinkovito upravljati vire in zmanjšati stroške oblačnih izračunov.
Ta članek sem napisal z mislijo na Kubernetes za AWS, vendar bo skoraj enako veljal tudi za druge oblačne ponudnike. Predvidevam, da vaš klaster(ji) že ima nastavljeno samodejno prilagoditev (). Odstranitev virov in zmanjšanje obsega uvajanja bo omogočilo prihranek samo, če bo to tudi zmanjšalo vašo skupino delovnih vozlišč (EC2 instanc).
V tem članku bomo obravnavali:
- čiščenje neuporabljenih virov ()
- zmanjšanje obsega po delovnem času ()
- uporaba horizontalnega avtomatskega prilagajanja (HPA),
- zmanjšanje odvečne rezervacije virov (, VPA)
- uporaba Spot instanc.
Čiščenje neuporabljenih virov
Delo v hitro spreminjajočem se okolju je super. Želimo, da se tehnične organizacije . Hitrejša dostava programske opreme pomeni tudi večje število PR uvajanj, predoglednih okolij, prototipov in analitičnih rešitev. Vse se uvaja na Kubernetes. Kdo ima čas, da ročno očisti testne uvedbe? Enostavno je pozabiti na odstranitev poskusa izpred tedna. Račun za oblak bo na koncu naraščal, ker smo pozabili zapreti:
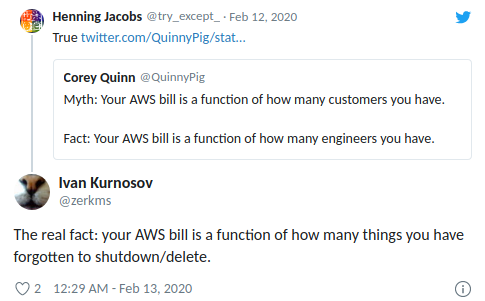
(Henning Jacobs:
Življenje:
(navaja) Corey Quinn:
Mit: Vaš AWS račun je funkcija odvisnosti od števila vaših uporabnikov.
Dejstvo: Vaš AWS račun je funkcija odvisnosti od števila vaših inženirjev.
Ivan Kurnosov (v odgovoru):
Pravo dejstvo: Vaš AWS račun je funkcija odvisnosti od števila stvari, ki ste jih pozabili izklopiti / odstraniti.)
(kube-janitor) pomaga očistiti vaš klaster. Konfiguracija janitorja je prilagodljiva tako za globalno kot lokalno uporabo:
- Splošna pravila za celoten klaster lahko določijo največji čas življenja (TTL - time-to-live) za PR/testne uvedbe.
- Posamezni viri se lahko označijo s janitor/ttl, na primer za samodejno odstranjevanje spike/prototipa po 7 dneh.
Splošna pravila so določena v YAML datoteki. Njena pot se prenese preko parametra --rules-file v kube-janitor. Tukaj je primer pravila za odstranjevanje vseh prostorov imen z -pr- v imenu po dveh dneh:
- id: cleanup-resources-from-pull-requests
  resources:
    - namespaces
  jmespath: "contains(metadata.name, '-pr-')"
  ttl: 2d
Naslednji primer ureja uporabo oznake application na Deployment in StatefulSet podih za vse nove Deployments/StatefulSet v letu 2020, hkrati pa omogoča izvajanje testov brez te oznake v trajanju enega tedna:
- id: require-application-label
  # odstraniti deployments in statefulsets brez oznake "application"
  resources:
    - deployments
    - statefulsets
  # glej http://jmespath.org/specification.html
  jmespath: "!(spec.template.metadata.labels.application) && metadata.creationTimestamp > '2020-01-01'"
  ttl: 7d
Zagon omejenega časovnega demo poskusa v trajanju 30 minut v klastru, kjer deluje kube-janitor:
kubectl run nginx-demo --image=nginx
kubectl annotate deploy nginx-demo janitor/ttl=30m
Še en vir naraščajočih stroškov so trajni volumni (AWS EBS). Pri brisanju Kubernetes StatefulSet se njegovi trajni volumni (PVC — PersistentVolumeClaim) ne izbrišejo. Neuporabljeni EBS volumni lahko enostavno privedejo do stroškov v stotinah dolarjev na mesec. Kubernetes Janitor ima funkcijo za čiščenje neuporabljenih PVC. Na primer, to pravilo bo odstranilo vse PVC, ki niso pritrjeni na modul in na katere ne sklicuje StatefulSet ali CronJob:
# удалить все PVC, которые не смонтированы и на которые не ссылаются StatefulSets
- id: remove-unused-pvcs
  resources:
  - persistentvolumeclaims
  jmespath: "_context.pvc_is_not_mounted && _context.pvc_is_not_referenced"
  ttl: 24h
Kubernetes Janitor vam lahko pomaga ohraniti vaš klaster v "čistem" stanju in preprečiti postopno kopičenje stroškov za oblačne računalne resurse. Za navodila za namestitev in nastavitev sledite v .
Zmanjšanje obsega v neobratovalnem času
Testne in vmesne sisteme običajno potrebujemo le v delovnem času. Nekatere proizvodne aplikacije, kot so back-office / administrativna orodja, prav tako zahtevajo le omejeno razpoložljivost in jih je mogoče izklopiti ponoči.
(kube-downscaler) omogoča uporabnikom in operaterjem, da zmanjšajo obseg sistema med nedelovanjem. Deployments in StatefulSets je mogoče zmanjšati na nič replik. CronJobs lahko začasno ustavimo. Kubernetes Downscaler je mogoče konfigurirati za celoten grozd, eno ali več imenikov ali posamezne vire. Ustvarimo lahko bodisi "čas nedelovanja" bodisi nasprotno "čas delovanja". Na primer, da bi čim bolj zmanjšali obseg ponoči in med vikendi:
image: hjacobs/kube-downscaler:20.4.3
args:
  - --interval=30
  # ne izklopi infrastrukturnih komponent
  - --exclude-namespaces=kube-system,infra
  # ne izklopi kube-downscaler, poleg tega pa ohrani Postgres Operator, da lahko upravljate izključene baze podatkov
  - --exclude-deployments=kube-downscaler,postgres-operator
  - --default-uptime=Mon-Fri 08:00-20:00 Europe/Berlin
  - --include-resources=deployments,statefulsets,stacks,cronjobs
  - --deployment-time-annotation=deployment-time
Tukaj je grafikon zmanjševanja obsega delovnih vozlišč v grozdu ob vikendih:
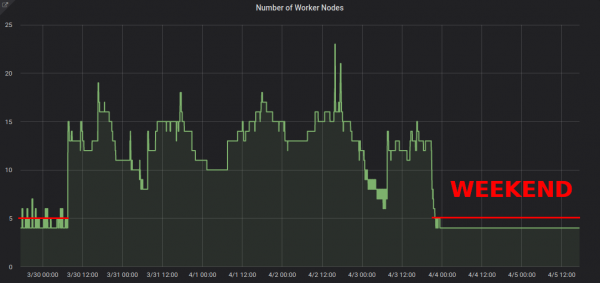
Zmanjšanje obsega s ~13 na 4 delovna vozlišča zagotovo prinaša občutno razliko na računu AWS.
Ampak kaj, če potrebujem delati v "času nedelovanja" grozda? Določena razporeditev se lahko za vedno izključi iz zmanjševanja obsega, če dodate oznako downscaler/exclude: true. Razporeditve se lahko začasno izključijo z oznako downscaler/exclude-until z absolutno časovno žigom v formatu GGGG-MM-DD HH:MM (UTC). Po potrebi se celoten grozd lahko ponovno razširi z izvajanjem poda z oznako downscaler/force-uptime, na primer, z zagonom nginx predloge:
kubectl run scale-up --image=nginx
kubectl annotate deploy scale-up janitor/ttl=1h # izbriši razporeditev čez eno uro
kubectl annotate pod $(kubectl get pod -l run=scale-up -o jsonpath="{.items[0].metadata.name}") downscaler/force-uptime=true
Смотрите , če vas zanima navodila za razporeditev in dodatne možnosti.
Uporabite horizontalno samodejno skaliranje
M mnoge aplikacije/storitve se ukvarjajo z dinamično shemo obremenitve: včasih njihovi moduli mirujejo, včasih pa delujejo s polno močjo. Delo s stalnim parkom podov, da bi se spopadli z največjimi vrhovi obremenitve, ni ekonomično. Kubernetes podpira horizontalno samodejno skaliranje preko vira (HPA). Uporaba CPU-jev je pogosto dober pokazatelj za zmanjševanje obsega:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 3
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        averageUtilization: 100
        type: Utilization
Zalando je razvil komponento za enostavno povezovanje uporabniških metrik za skaliranje: (kube-metrics-adapter) je univerzalni adapter metrik za Kubernetes, ki lahko zbira in obravnava uporabniške ter zunanje metrike za horizontalno avtomatsko skaliranje podov. Podpira skaliranje na podlagi metrik Prometheus, čakalnih vrst SQS in drugih nastavitev. Na primer, za skaliranje razporeditve za uporabniško metriko, ki jo aplikacija predstavi v obliki JSON v /metrics, uporabite:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: myapp-hpa
  annotations:
    # metric-config.../
    metric-config.pods.requests-per-second.json-path/json-key: "$.http_server.rps"
    metric-config.pods.requests-per-second.json-path/path: /metrics
    metric-config.pods.requests-per-second.json-path/port: "9090"
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: myapp
  minReplicas: 1
  maxReplicas: 10
  metrics:
  - type: Pods
    pods:
      metric:
        name: requests-per-second
      target:
        averageValue: 1k
        type: AverageValue
Nastavitev horizontalnega avtomatskega skaliranja s HPA bi morala biti ena od privzetih dejanj za povečanje učinkovitosti pri storitvah, ne glede na stanje. Spotify ima predstavitev o svojih izkušnjah in priporočilih za HPA: .
Zmanjšanje odvečnega rezerviranja virov.
Delovne obremenitve Kubernetes določajo svoje potrebe po CPU/kolokaciji prek 'zahtevkov virov' (resource requests). Viri CPU so merjeni v virtualnih jeder ali pogosteje v 'mili-jeder' (millicores), na primer 500m pomeni 50% vCPU. Viri pomnilnika so merjeni v bajtih in lahko uporabijo običajne pripone, na primer 500Mi, kar pomeni 500 megabajtov. Zahtevki virov 'zaklenejo' obseg na delovnih vozliščih, kar pomeni, da modul z zahtevkom CPU v višini 1000m na vozlišču s 4 virtualnimi CPU pusti le 3 virtualne CPU na voljo za druge module.
Slack (odvečno rezerviranje) — to razlika između zatraženih resursa i stvarne potrošnje. Na primjer, pod koji traži 2 GiB memorije, ali koristi samo 200 MiB, ima ~ 1,8 GiB "viška" memorije. Višak košta novac. Grubo se može procijeniti da 1 GiB viška memorije košta ~ 10 dolara mjesečno.
(kube-resource-report) prikazuje suvišne rezerve i može vam pomoći da odredite potencijalne uštede:
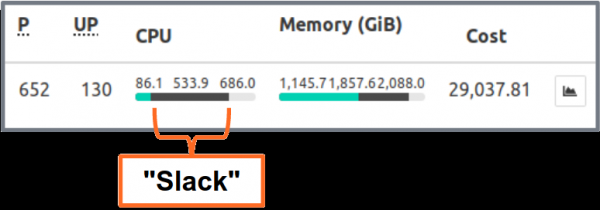
prikazuje višak, agregiran po aplikaciji i timu. To omogućava pronalaženje mesta gde se zatraženi resursi mogu smanjiti. Generisani HTML izveštaj pruža samo snimak korišćenja resursa. Trebalo bi da gledate na korišćenje procesora/memorije tokom vremena, kako biste odredili adekvatne zahteve za resursima. Evo dijagrama Grafane za "tipičnu" službu sa velikim opterećenjem procesora: svi podovi koriste značajno manje od 3 zatražena jezgra procesora:
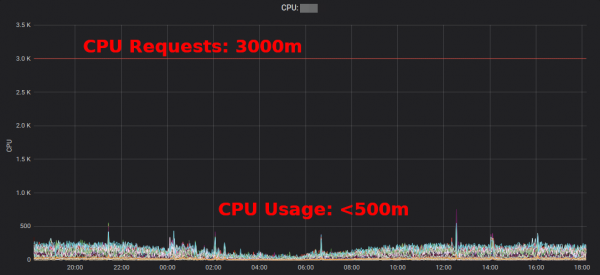
Smanjenje zahteva za CPU sa 3000m na ~400m oslobađa resurse za druge radne opterećenja i omogućava smanjenje klastera.
"Prosečna potrošnja CPU EC2 instanci često se kreće u rasponu od jednocifrenih procenata", - . Dok za EC2 , promena nekih zahteva za resursima Kubernetesa u YAML fajlu se lako vrši i može doneti ogromne uštede.
Ali da li stvarno želimo da ljudi menjaju vrednosti u YAML fajlovima? Ne, mašine to mogu uraditi mnogo bolje! Kubernetes (VPA) baš to radi: prilagođava zahteve za resursima i ograničenja u skladu sa radnim opterećenjem. Evo primera grafika zahteva za CPU Prometheus (tanak plavi linija), prilagođenih VPA tokom vremena:
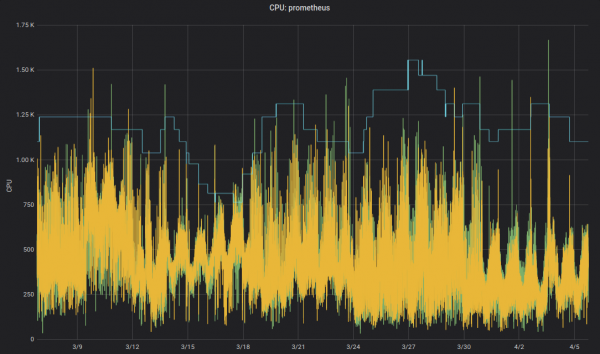
za komponente infrastrukture. Nekritične aplikacije takođe mogu koristiti VPA.
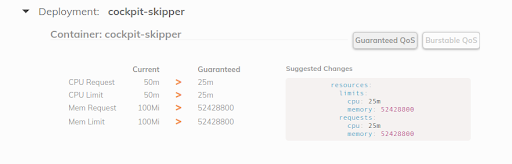
od Fairwind - to je alat koji stvara VPA za svako implementaciju u imenskom prostoru, a zatim prikazuje preporuku VPA na svojoj kontrolnoj tabli. Može pomoći programerima da postave ispravne zahteve za procesor/memoriju za svoje aplikacije:
Napisao sam mali 2019. godine, i nedavno se u .
Korišćenje EC2 Spot instanci
Nazad na število AWS EC2 lahko zmanjšate tako, da za delovne vozlišča Kubernetes uporabite Spot instance. Spot instance so na voljo s popustom do 90 % v primerjavi s cenami po povpraševanju. Začetek delovanja Kubernetes na EC2 Spot je dobra kombinacija: potrebno je navesti več različnih vrst instanc za večjo razpoložljivost, kar pomeni, da lahko dobite večjo enoto po isti ali nižji ceni, povečana zmogljivost pa se lahko uporablja za delovne obremenitve Kubernetes.
Kako zaženete Kubernetes na EC2 Spot? Obstaja več možnosti: uporabite zunanjo storitev, kot je SpotInst (zdaj se imenuje „Spot“, ne sprašujte me zakaj), ali pa preprosto dodate Spot AutoScalingGroup (ASG) v vaš grozd. Na primer, tukaj je del CloudFormation za „kapaciteto optimizirano“ Spot ASG z več različnimi vrstami instanc:
MySpotAutoScalingGroup:
 Properties:
   HealthCheckGracePeriod: 300
   HealthCheckType: EC2
   MixedInstancesPolicy:
     InstancesDistribution:
       OnDemandPercentageAboveBaseCapacity: 0
       SpotAllocationStrategy: capacity-optimized
     LaunchTemplate:
       LaunchTemplateSpecification:
         LaunchTemplateId: !Ref LaunchTemplate
         Version: !GetAtt LaunchTemplate.LatestVersionNumber
       Overrides:
         - InstanceType: "m4.2xlarge"
         - InstanceType: "m4.4xlarge"
         - InstanceType: "m5.2xlarge"
         - InstanceType: "m5.4xlarge"
         - InstanceType: "r4.2xlarge"
         - InstanceType: "r4.4xlarge"
   LaunchTemplate:
     LaunchTemplateId: !Ref LaunchTemplate
     Version: !GetAtt LaunchTemplate.LatestVersionNumber
   MinSize: 0
   MaxSize: 100
   Tags:
   - Key: k8s.io/cluster-autoscaler/node-template/label/aws.amazon.com/spot
     PropagateAtLaunch: true
     Value: "true"
Nekaj opomb za uporabo Spot z Kubernetes:
- Obravnavati morate zaključke Spot, na primer s preusmerjanjem vozlišča ob zaustavitvi instance.
- Zalando uporablja uradno avtomatsko skaliranje grozda s prioritetami skupine vozlišč.
- Spot vozlišča da sprejmejo "registracije" delovnih obremenitev za zagon v Spot.
Резюме
Upam, da boste našli nekatere od predstavljenih orodij koristne za zmanjšanje vaših stroškov oblačnih storitev. Večino vsebine članka lahko najdete tudi v .
Kakšne so vaše najboljše prakse za varčevanje s stroški oblačnih storitev za Kubernetes? Prosimo, sporočite mi na .
V bistvu bosta manj kot 3 virtualna CPU ostala uporabna, saj se pasovna širina vozlišča zmanjšuje zaradi rezerviranih sistemskih virov. Kubernetes razlikuje med fizično kapaciteto vozlišča in 'dodeljenimi' viri ().
Primer izračuna: en primer m5.large s 8 GiB pomnilnika stane ~84 ameriških dolarjev na mesec (eu-central-1, On-Demand), torej blokiranje 1/8 vozlišča stane približno ~10 ameriških dolarjev na mesec.
Obstaja še veliko načinov za zmanjšanje vašega EC2 računa, na primer s rezerviranimi primeri, načrti varčevanja itd. – teh tem tukaj ne bom obravnaval, vendar se morate o njih zagotovo pozanimati!
Izvor: habr.com
