

Monitoring has become a crucial component of growing cloud solutions with the increasing complexity of distributed systems. It is essential for understanding their behavior. Scalable tools are needed to collect data from all services — providing specialists with a unified interface for performance analysis, error demonstration, availability, and logs.
These tools must also be efficient and high-performing. In this article, we will explore two popular technology stacks: EFK (Elasticsearch) and PLG (Loki) and examine their architectures and differences.
EFK stack
You may have heard of the very popular ELK or EFK. The stack consists of several separate components: Elasticsearch (object storage), Logstash or FluentD (log collection and aggregation), and Kibana for visualization.
A typical workflow diagram looks like this:
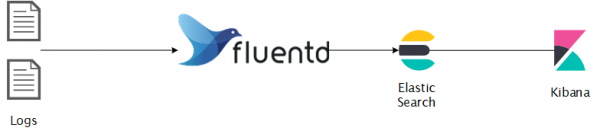
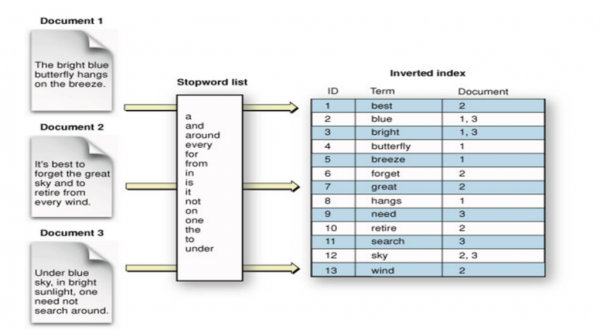
Elasticsearch — a distributed object storage with real-time search and analytics. An excellent solution for semi-structured data, such as logs. Information is stored as JSON documents, indexed in real time, and distributed across the nodes of the cluster. An inverted index is used that contains all unique words and the related documents for full-text search, which in turn is based on the Apache Lucene search engine.
FluentD — is a data collector that performs data unification during collection and consumption. It tries to structure data into JSON as much as possible. Its architecture is extensible, with over , supported by the community, for all occasions.
Kibana — a data visualization tool for Elasticsearch with various additional capabilities, such as time series analysis, graphs, machine learning, and more.
Elasticsearch architecture
Data in the Elasticsearch cluster is stored across all its nodes. The cluster consists of multiple nodes to improve availability and resilience. Any node can take on all cluster roles, but in large scalable deployments, nodes are typically assigned separate tasks.
Types of cluster nodes:
- master node — manages the cluster, with a minimum of three nodes required, one of which is always active;
- data node — stores indexed data and performs various tasks with it;
- ingest node — organizira cevi za transformaciju podataka pre indeksacije;
- coordinating node — usmjeravanje upita, smanjenje faze obrade pretrage, koordinacija masovne indeksacije;
- alerting node — pokretanje zadataka za obavještavanje;
- machine learning node — obrada zadataka mašinskog učenja.
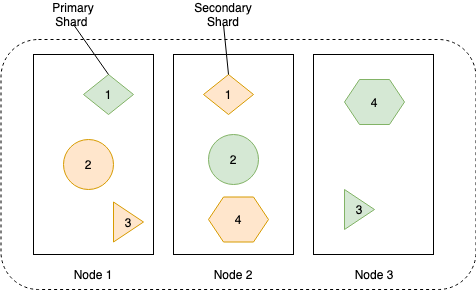
Na dijagramu ispod prikazano je kako se podaci čuvaju i repliciraju između čvorova radi veće dostupnosti podataka.
Podaci svake replike se čuvaju u invertiranom indeksu, a dijagram ispod prikazuje kako to funkcioniše:
Namestitev
Detalje možete pogledati , koristiću helm chart:
$ helm install efk-stack stable/elastic-stack --set logstash.enabled=false --set fluentd.enabled=true --set fluentd-elasticsPLG stack
Ne treba se iznenaditi ako ne možete pronaći ovu akronim, jer je poznatiji kao Grafana Loki. U svakom slučaju, ova pila dobija na popularnosti jer primenjuje proverena tehnička rešenja. Možda ste već čuli za Grafanu, popularni alat za vizualizaciju. Njeni tvorci, inspirisani Prometheusom, razvili su Loki, horizontalno skalabilni visoko-performantni sistem za agregaciju dnevnika. Loki indeksuje samo metapodatke, ali ne i same dnevnike, što mu omogućava da bude jednostavan za korišćenje i ekonomičan.
Promtail — agent za slanje dnevnika iz operativnog sistema u Loki klaster. Grafana — vizualizacijski alat zasnovan na podacima iz Lokija.
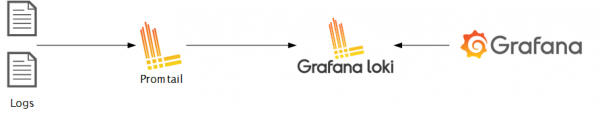
Loki je izgrađen na istim principima kao i Prometheus, tako da je dobro prilagođen za čuvanje i analizu dnevnika Kubernetes-a.
Arhitektura Lokija
Loki se može pokrenuti kako u režimu jednog procesa, tako i u vidu više procesa, što osigurava horizontalno skaliranje.
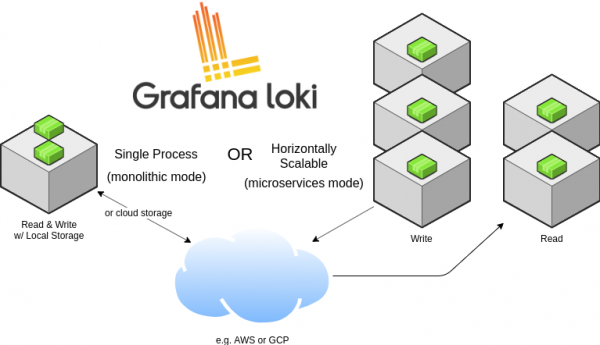
Takođe može raditi kao monolitna aplikacija ili kao mikroservis. Pokretanje u režimu jednog procesa može biti korisno za lokalni razvoj ili sitno praćenje. Za industrijsku implementaciju i skalabilno opterećenje, preporučuje se korišćenje mikroservisnog rešenja. Putanje za upis i čitanje podataka su odvojene, tako da se može dovoljno fino podesiti i skalirati po potrebi.
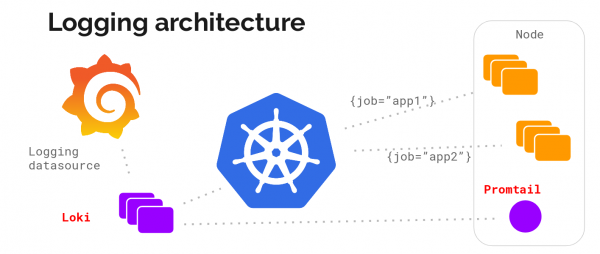
Pogledajmo arhitekturu sistema za prikupljanje dnevnika bez detalja:
A ovde je opis (mikroservisna arhitektura):
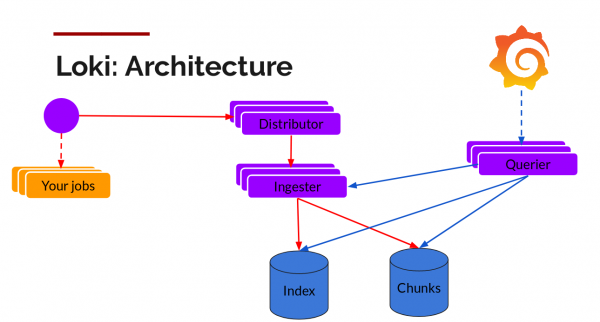
Komponente:
Promtail — agent, installed on nodes (as a set of services), it collects logs from tasks and queries the Kubernetes API for the metadata that will label the logs. Then it sends the log to the main Loki service. The same labeling rules as in Prometheus are supported for matching metadata.
Distributor — a service-distributor that acts as a buffer. To handle millions of records, it packages incoming data, compressing it in blocks as it arrives. Several data receivers work simultaneously, but logs belonging to a single stream of incoming data must reside in only one of them for all its blocks. This is organized as a ring of receivers and sequenced hashing. For fault tolerance and redundancy, this is done n times (3 if not configured).
Ingester — a receiving service. Data blocks arrive compressed with added logs. Once a block reaches a sufficient size, the block is flushed to the database. Metadata goes to the index, while the log data from the block goes to Chunks (usually an object store). After flushing, the receiver creates a new block to which new records will be added.
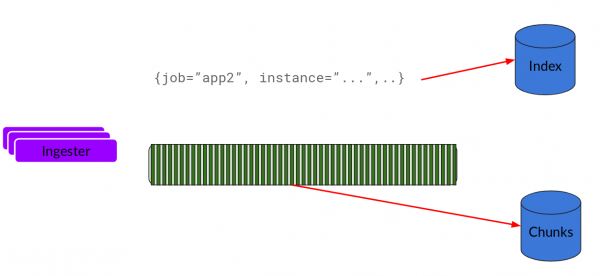
Index — database, DynamoDB, Cassandra, Google BigTable, etc.
Chunks — blocks of logs in compressed form, typically stored in an object store, for example, S3.
Querier — the reading path that does all the heavy lifting. It examines the time range and labels, then looks up the index for matches. It then reads data blocks and filters them to get results.
And now let's see everything in action.
Namestitev
To install in Kubernetes, it is easiest to use helm. We assume you have already installed and configured it ( translator's note)
Add the repository and install the stack.
$ helm repo add loki https://grafana.github.io/loki/charts
$ helm repo update
$ helm upgrade --install loki loki/loki-stack --set grafana.enabled=true,prometheus.enabled=true,prometheus.alertmanager.persistentVolume.enabled=false,prometheus.server.persistentVolume.enabled=false
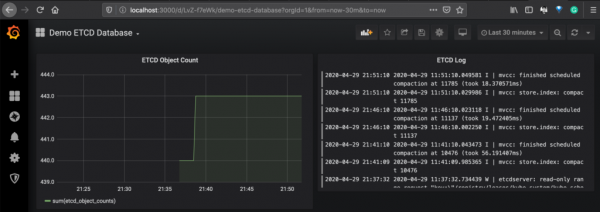
Below is an example dashboard showing data from Prometheus for Etcd metrics and Loki for Etcd pod logs.
And now let's discuss the architecture of both systems and compare their capabilities with each other.
Comparison
Query Language
V Elasticsearch se uporablja Query DSL in jezik poizvedb Lucene, ki omogočata polno besedilno iskanje. To je uveljavljen močan iskalni motor z obsežno podporo za operatorje. Z njegovo pomočjo lahko iščete po kontekstu in razvrščate po relevantnosti.
Na drugi strani ringa je LogQL, uporabljen v Loki, nasledniku PromQL (jezika poizvedb Prometheus). Uporablja oznake dnevnikov za filtriranje in vzorčenje podatkov dnevnikov. Obstaja možnost uporabe nekaterih operatorjev in aritmetike, kot je opisano , vendar glede sposobnosti zaostaja za jezikom Elastic.
Ker so poizvedbe v Loki povezane z oznakami, jih je enostavno uskladiti z metričnimi podatki, kar omogoča enostavnejše organiziranje operativnega monitoringa.
Širljivost
Oba sklopa sta horizontalno skalirna, a je to pri Loki enostavneje, saj imata ločene poti za branje in pisanje podatkov ter mikrostoritev arhitekturo. Loki je mogoče prilagoditi vašim potrebam in ga je mogoče uporabiti za zelo velike količine podatkov dnevnikov.
Večnajčnost
Večnajčnost klasterja je splošna tema za zmanjšanje OPEX, oba sklopa zagotavljata večnajčnost. Za Elasticsearch obstaja več ločevanja strank: ločen indeks za vsako stranko, usmerjanje na podlagi stranke, edinstvena polja stranke, iskalni filtri. V Loki je to oblikovano kot HTTP glava X-Scope-OrgID.
Cena
Loki je zelo učinkovita ekonomična rešitev, saj ne indeksira podatkov, temveč le metapodatke. S tem doseže in pomnilnikom (predpomnilnikom), saj je objektno shranjevanje cenejše od blokovnega, ki se uporablja v klasterjih Elasticsearch.
Zaključek
Sklad EFK se lahko uporablja za različne namene, kar zagotavlja največjo fleksibilnost in večnamenski vmesnik Kibana za analitiko, vizualizacijo in poizvedbe. Dodatno ga je mogoče izboljšati z zmožnostmi strojnega učenja.
Sklad Loki je koristno orodje v ekosistemu Kubernetes zaradi mehanizma za odkrivanje metapodatkov. Enostavno je povezati podatke za monitoring na osnovi časovnih vrst v Grafani in dnevnikih.
Ko gre za stroške in dolgotrajno shranjevanje dnevnikov, je Loki odlična izbira za vstop v oblačne rešitve.
Na trgu je več alternativ - nekatere so lahko boljše za vas. Na primer, za GKE obstaja integracija Stackdriver, ki ponuja odlično rešitev za spremljanje. Teh nismo vključili v našo analizo v tem članku.
Linkovi:
Članek je bil preveden in pripravljen za Habr s strani zaposlenih — intenzivni tečaji, video tečaji in korporativno usposabljanje s praktiki (Kubernetes, DevOps, Docker, Ansible, Ceph, SRE, Agile)
Izvor: habr.com
