

Glavna cilj Patroni je osigurati visoku dostupnost za PostgreSQL. No, Patroni je samo šablon, a ne gotov alat (što je, u suštini, navedeno u dokumentaciji). Na prvi pogled, nakon što konfigurišemo Patroni u testnoj laboratoriji, možemo videti koliko je to divan alat i kako lako obrađuje naše pokušaje da srušimo klaster. Međutim, u praksi, u proizvodnom okruženju, ne dešava se uvek tako lepo i elegantno kao u testnoj laboratoriji.
Pričaću malo o sebi. Počeo sam kao sistemski administrator. Radio sam u web razvoju. Od 2014. godine radim u Data Egret. Kompanija se bavi konsaltingom u oblasti Postgres. I mi se ponekad bavimo samo Postgres-om, i svakodnevno radimo sa Postgres-om, zato imamo raznu stručnost vezanu za eksploataciju.
I na kraju 2018. godine počeli smo polako koristiti Patroni. Načinili smo određeno iskustvo. Na neki način smo ga dijagnostikovali, optimizovali, došli do svojih najboljih praksi. I o njima ću pričati u ovom izlaganju.
Osim Postgres-a, volim Linux. Volim da eksperimentišem i istražujem, volim da sastavljam jezgre. Volim virtualizaciju, kontejnere, Docker, Kubernetes. Sve to me zanima jer se stare adminske navike odražavaju. Volim da se bavim monitoringom. I volim stvari vezane za postgres administraciju, tj. replikaciju, rezervno kopiranje. I u slobodno vreme pišem na Go. Nisam softverski inženjer, samo pišem za sebe na Go. I to mi donosi zadovoljstvo.
- Mislim da mnogi od vas znaju da u Postgres-u nema HA (visoke dostupnosti) iz kutije. Da biste dobili HA, morate nešto postaviti, konfigurirati, uložiti trud i dobiti to.
- Postoji nekoliko alata i Patroni je jedan od njih, koji prilično dobro rešava HA. Ali nakon što sve to postavimo u testnoj laboratoriji i pokrenemo, možemo videti da to sve funkcioniše, možemo reprodukovati neke probleme, da vidimo kako ih Patroni obrađuje. I videćemo da sve to savršeno radi.
- Ali u praksi smo se suočili s raznim problemima. I o tim problemima ću pričati.
- Reći ću kako smo to dijagnostikovali, šta smo podešavali – da li nam je to pomoglo ili nije.
- Ne bom govoril o tem, kako namestiti Patroni, ker se to lahko enostavno najde na spletu, lahko si ogledate konfiguracijske datoteke, da razumete, kako se vse to zažene in kako se nastavi. Lahko se poklicno ukvarite s shemami in arhitekturami, tako da boste našli informacije o tem na internetu.
- Ne bom govoril o izkušnjah drugih. Govoril bom le o težavah, s katerimi smo se srečali prav mi.
- In ne bom govoril o težavah, ki presegajo Patroni in PostgreSQL. Na primer, težave, povezane z uravnoteženjem, ko se je naš klaster razpadel, o tem ne bom govoril.
In majhna izjema, preden začnem našo predstavitev.
Vse te težave, s katerimi smo se srečali, so bile prisotne v prvih 6-7-8 mesecih delovanja. Sčasoma smo prišli do svojih notranjih najboljših praks. In težave so izginile. Zato je bila ta predstavitev načrtovana pred približno šestimi meseci, ko je vse to še bilo sveže v spominu in sem se spomnil vsega.
Med pripravo na predstavitev sem ponovno prebral stare postmortem poročila, pregledal dnevnik. In del podrobnosti se je morda pozabil, ali pa del nekaterih podrobnosti morda ni bil dovolj raziskovan med razreševanjem težav, zato se morda zdi, da težave niso bile obravnavane v celoti, ali da je kakšna pomanjkljivost informacij. In zato se za to opravičujem.
Kaj je Patroni?
- To je predloga za gradnjo HA. Tako piše v dokumentaciji. In z moje točke pogleda je to zelo pravilna opredelitev. Patroni ni srebrna krogla, ki bi rešila vse vaše težave; potrebna so prizadevanja, da začne delovati in prinašati koristi.
- To je agenta služba, ki je nameščena na vsaki storitvi z bazo podatkov, in ki deluje kot svojevrstni init sistem za vaš Postgres. Zažene Postgres, ustavi ga, ponovno zažene, spremeni konfiguracijo in spreminja topologijo vašega klasterja.
- Zato je potrebno, da se stanje klasterja shrani, njegova trenutna predstavitev, kako izgleda; potrebna je nekakšna shramba. In iz te perspektive je Patroni izbral pot shranjevanja stanja v zunanji sistem. To je sistem porazdeljenega shranjevanja konfiguracije. To so lahko Etcd, Consul, ZooKeeper, ali Kubernetes'ki Etcd, torej ena od teh možnosti.
- Ena od značilnosti Patroni je, da avtofajler dobite iz škatle, takoj ko ga nastavite. V primerjavi z Repmgr, kjer je fajler priložen. S Repmgr dobimo switchover, toda če želimo avtofajler, ga moramo dodatno nastaviti. Patroni pa že ima avtofajler iz škatle.
- Obstaja še veliko drugih stvari. Na primer, upravljanje s konfiguracijami, dodajanje novih replik, varnostno kopiranje itd. Toda to presega obseg poročila, o tem ne bom govoril.
Zato lahko sklenemo, da je glavna naloga Patroni to, da učinkovito in zanesljivo izvaja avtofajler, da naš klaster ostane delujoč in aplikacija ne opazi sprememb v topologiji klasterja.
Toda ko začnemo uporabljati Patroni, se naš sistem nekoliko zaplete. Če smo prej imeli Postgres, ob uporabi Patroni dobimo samega Patroni, dobimo DCS, kjer se shranjuje stanje. In vse to mora kako delovati. Zato, kaj se lahko pokvari?
Lahko se pokvari:
- Postgres se lahko pokvari. To je lahko glavni ali replika, eden od njiju lahko odpove.
- Lahko se pokvari tudi sam Patroni.
- Lahko se pokvari DCS, kjer se shranjuje stanje.
- In lahko se pokvari omrežje.
Vse te vidike bom obravnaval v poročilu.
Obravnaval bom primere, kako se zapletajo, ne z vidika, da primer pokriva veliko komponent. Temveč z vidika subjektivnih občutij, da je bil ta primer zame zapleten, težko ga je bilo analizirati… in obratno, nek primer je bil enostaven in ga je bilo lahko analizirati.
Prvi primer je najpreprostejši. To je primer, ko smo vzeli klaster podatkovnih baz in na tem istem klasterju postavili naš DCS. To je najpogostejša napaka. To je napaka pri zasnovi arhitektur, tj. združevanje različnih komponent na enem mestu.
Torej, ko se zgodi fajler, gremo raziskati, kaj se je zgodilo.
In tukaj nas zanima, kdaj se je zgodil fajler. Tj. zanima nas ta časovni trenutek, ko je prišlo do spremembe stanja klasterja.
Toda fajler ni vedno trenutni, tj. ne traja vedno točno določen čas, lahko se zavleče. Lahko traja dalj časa.
Zato ima začetni in končni čas, torej gre za dolg dogodek. Vse dogodke delimo na tri intervale: imamo čas pred failoverjem, med failoverjem in po failoverju. To pomeni, da obravnavamo vse dogodke na tej časovni osi.
In prva reč, ko se zgodi failover, iščemo vzrok, kaj se je zgodilo, kaj je privedlo do failoverja.
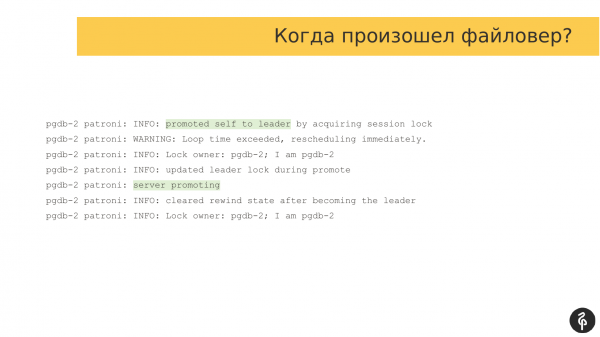
Če pogledamo dnevnike, bodo to klasični dnevniki Patroni. V njih nam sporoča, da je strežnik postal glavni in da je vloga glavnega prešla na to vozlišče. To je označeno.
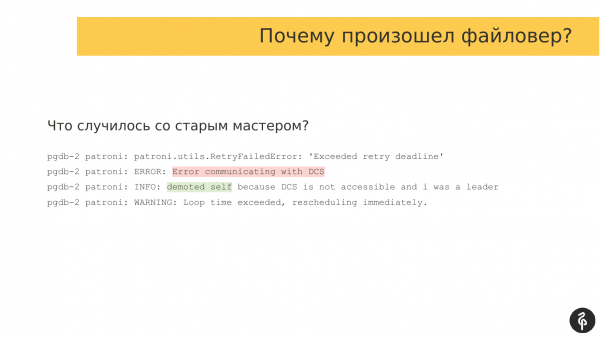
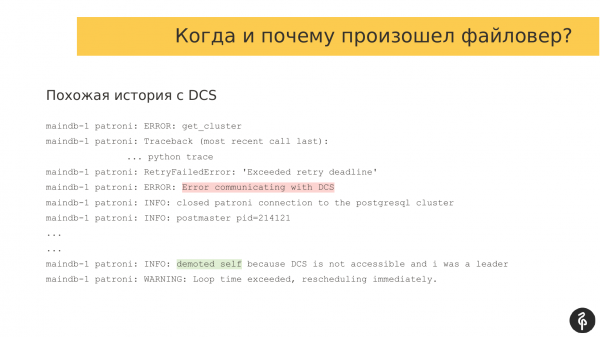
Nato moramo razumeti, zakaj je prišlo do failoverja, torej kakšni dogodki so povzročili, da se je vloga glavnega preselila z enega vozlišča na drugo. In v tem primeru je vse preprosto. Imamo napako pri interakciji s shranjevanjem. Glavni je ugotovil, da ne more delovati z DCS, torej se je pojavila neka težava pri interakciji. In pravi, da ne more biti več glavni in se odpove pooblastilom. Ta vrstica 'demoted self' to natančno opisuje.
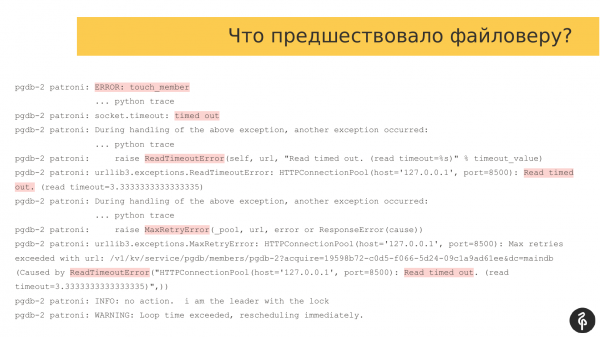
Če pogledamo dogodke, ki so predhodili failoverju, lahko vidimo tiste vzroke, ki so povzročili težave pri nadaljnjem delu glavnega.
Če pogledamo dnevnike Patroni, bomo videli, da nastane množica različnih napak, časovnih zamud, torej agent Patroni ne more delovati z DCS. V tem primeru je to Consul agent, s katerim komuniciramo prek vrata 8500.
In težava je v tem, da sta Patroni in baza podatkov zagnana na istem strežniku. Na tem istem vozlišču so bile zagnane tudi Consul strežniki. Z ustvarjanjem obremenitve na strežniku smo povzročili težave tudi za strežnikov Consul. Niso mogli normalno komunicirati.
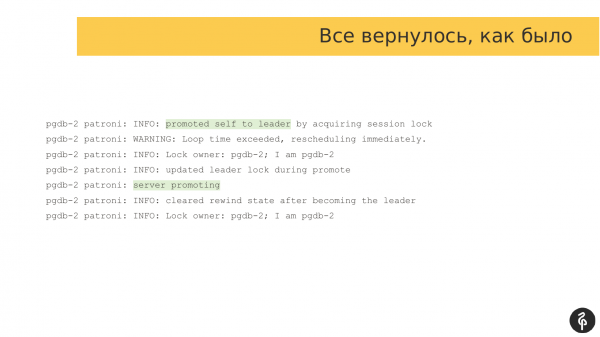
Čez nekaj časa, ko je obremenitev popustila, je naš Patroni znova uspel komunicirati z agenti. Normalno delovanje se je ponovno vzpostavilo. In tisti isti strežnik Pgdb-2 je znova postal glavni. To pomeni, da je prišlo do majhnega preklopa, zaradi katerega je vozlišče odneslo svoje glavne pooblastila, nato pa jih ponovno prevzelo, torej se je vse vrnilo, kot je bilo.
In to lahko obravnavamo kot lažno sprožitev, ali pa lahko obravnavamo, da je Patroni vse naredil pravilno. To pomeni, da je razumel, da ne more vzdrževati stanja grozda in je odnesel svoja pooblastila.
In this case, the problem arose because the Consul servers are on the same hardware as the databases. Accordingly, any load—whether on disks or processors—also affects interaction with the Consul cluster.
We decided that this shouldn't coexist; we allocated a separate cluster for Consul. Patroni then operated with a separate Consul, meaning there was a separate Postgres cluster and a distinct Consul cluster. This is a basic instruction on how to separate these components and manage them to prevent them from interfering with each other.
One option is to adjust the parameters ttl, loop_wait, and retry_timeout, for instance, attempting to withstand these short peaks in load by increasing these parameters. However, this isn't the most suitable approach because these loads might persist. We would eventually exceed the limits of these parameters, which may not help at all.
The first problem, as you might have guessed, is straightforward. We combined DCS with the database and encountered an issue.
The second problem is similar to the first. It resembles it in that we again have communication issues with the DCS system.
If we look at the logs, we will see that there is once again a communication error. Patroni indicates that it cannot communicate with the DCS, which causes the current master to switch to replica mode.
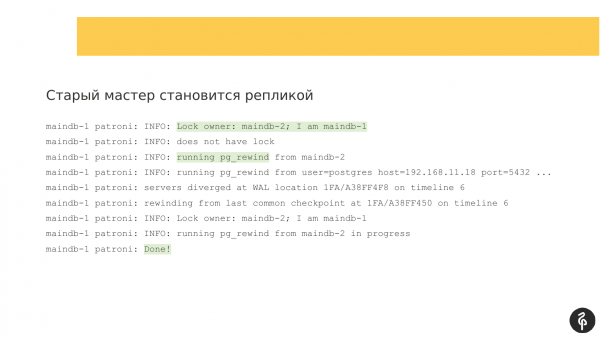
The old master becomes a replica; here, Patroni functions as intended. It runs pg_rewind to rewind the transaction log and then connects to the new master to catch up with it. Patroni operates as it should.
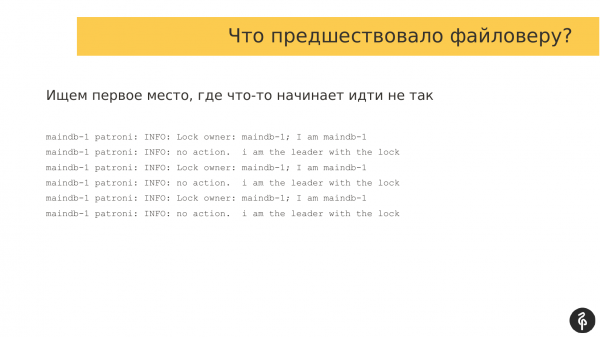
Here, we need to identify the point that preceded the file error, meaning the errors that caused the file error. In this regard, working with Patroni logs is quite convenient. It writes the same messages at specific intervals. If we quickly scroll through the logs, we'll notice changes, indicating that some issues have arisen. We can swiftly return to that point and see what's happening.
In a normal situation, the logs look something like this. The lock owner is checked. If the owner has, say, changed, certain events may occur that Patroni needs to react to. However, in this case, everything is in order. We're looking for the point when the errors began.
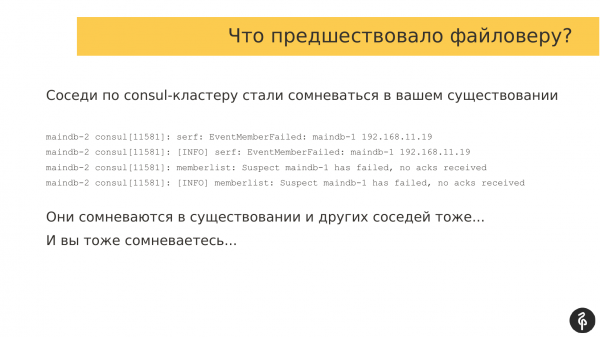
In scrolling to the point when errors began appearing, we see that we had an autofailer. And since our errors were related to the interaction with DCS and in our case we used Consul, we also look at the Consul logs to see what was happening there.
By approximately correlating the failover time with the time in the Consul logs, we see that our neighbors in the Consul cluster started to doubt the existence of other participants in the Consul cluster.
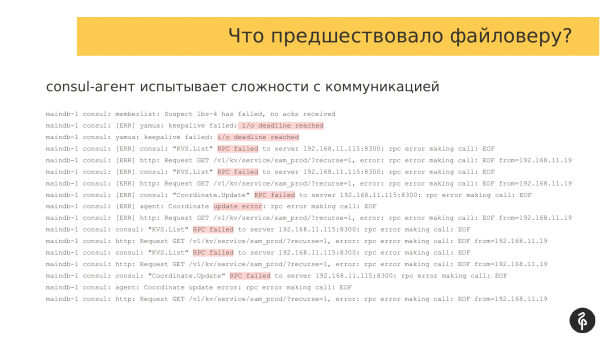
And if we look at the logs of other Consul agents, it is also clear that there is some sort of network collapse occurring. All participants in the Consul cluster doubt each other's existence. This served as a trigger for the failover.
If we look at what was happening before these errors, we can see that there are various errors, for example, deadline, RPC failed, which clearly indicates a problem in the interaction between participants in the Consul cluster.
The simplest answer is to fix the network. But from the podium, it's easy for me to state that. However, circumstances arise that sometimes the client cannot afford to fix the network. They might live in a data center and lack the ability to repair the network or affect the equipment. Therefore, we need some other options.
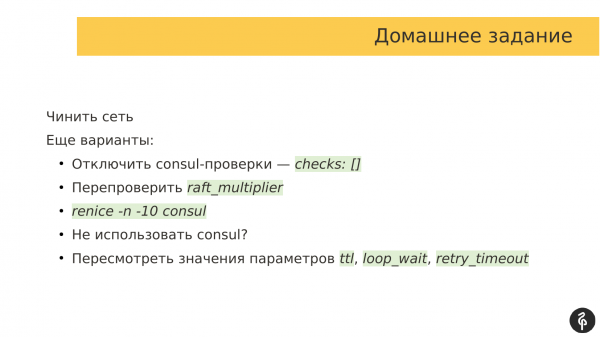
There are options:
- The simplest option, which I think is even mentioned in the documentation, is to disable the Consul checks, that is, simply pass an empty array. We tell the Consul agent not to use any checks. By ignoring these checks, we can avoid these network storms and not initiate a failover.
- Another option is to recheck the raft_multiplier. This is a parameter of the Consul server itself. By default, it is set to a value of 5. This value is recommended in the documentation for staging environments. Essentially, this affects the frequency of message exchange between participants in the Consul network. In essence, this parameter impacts the speed of service communication between participants in the Consul cluster. For production, it is already recommended to reduce it so that nodes exchange messages more frequently.
- Druga možnost, ki smo jo začeli uporabljati, je povečanje prioritet Consul procesov med drugimi procesi za načrtovalnika procesov operacijskega sistema. Obstaja parameter „nice“, ki določa prioritet procesa, kar upošteva načrtovalnik OS pri načrtovanju. Znižali smo vrednost nice za Consul agente, tj. povečali prednost, da je operacijski sistem dal Consul procesom več časa za delo in izvrševanje njihovega kode. V našem primeru je to rešilo našo težavo.
- Druga možnost je, da ne uporabljate Consul. Imam prijatelja, ki je velik zagovornik Etcd. In z njim redno razpravljava, kaj je bolje Etcd ali Consul. Vendar se običajno strinjamo, da ima Consul agenta, ki mora biti zagnan na vsakem vozlišču s podatkovno bazo. Tj. interakcija Patroni s Consul klastra poteka preko tega agenta. In ta agent postane ozko grlo. Če se z agentom kaj zgodi, Patroni ne more več delovati z Consul klastri. To predstavlja problem. Pri Etcd pa agenta ni. Patroni lahko neposredno sodeluje s seznamom Etcd strežnikov in se z njimi pogovarja. V tem smislu, če v vaši družbi uporabljate Etcd, bo verjetno Etcd boljša izbira kot Consul. Vendar smo pri naših strankah vedno omejeni s tem, kar je stranka izbrala in uporablja. In pri večini naših strank je Consul glavni.
- In zadnja točka je pregledati vrednosti parametrov. Te parametre lahko povečamo v upanju, da bodo naši kratkotrajni omrežni problemi kratki in ne bodo presegli intervala teh parametrov. Tako lahko zmanjšamo agresivnost Patroni pri izvajanju samodejnega preklopa, če pride do kakšnih omrežnih težav.
Mislim, da so mnogi, ki uporabljajo Patroni, seznanjeni s to ukazno vrstico.
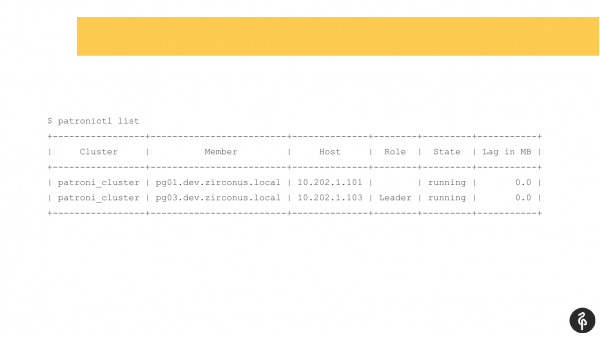
Ta ukaz prikazuje trenutno stanje klasterja. Na prvi pogled se ta slika lahko zdi normalna. Imamo glavnega, imamo replikacijo, med replikacijo ni zakasnitve. Vendar je ta slika normalna le, dokler ne vemo, da bi morali v tem klasterju biti trije vozlišča in ne dve.
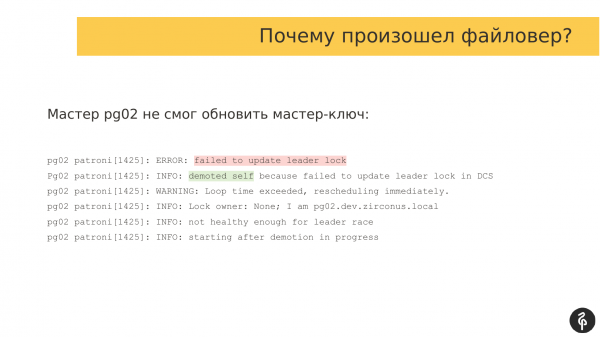
Zato je prišlo do samodejnega preklopa. In po tem samodejnem preklopu nam je izginila replika. Moramo ugotoviti, zakaj je izginila in jo vrniti, obnoviti. Ponovno gremo v dnevnike in pregledujemo, zakaj je prišlo do samodejnega preklopa.
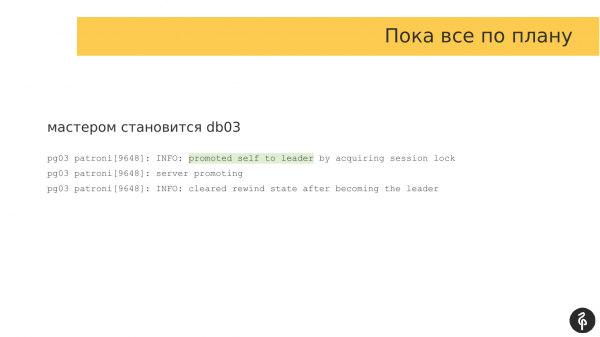
V tem primeru je druga replika postala glavni. Tukaj je vse v redu.
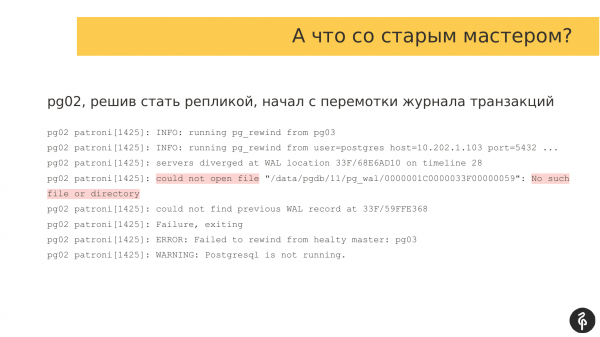
In moramo pogledati na repliko, ki je izpadla in ki ni v klasterju. Odprimo dnevnike Patroni in pogledamo, da smo imeli težave pri povezovanju s klasterjem na stopnji pg_rewind. Da se povežemo s klasterjem, moramo zavrteti dnevnik transakcij nazaj, zahtevati ustrezen dnevnik transakcij od glavnega in se po njem uskladiti z glavnim.
V tem primeru nimamo dnevnika transakcij in replika se ne more zagnati. Zato Postgres ustavimo z napako. In zato je ni v klasterju.
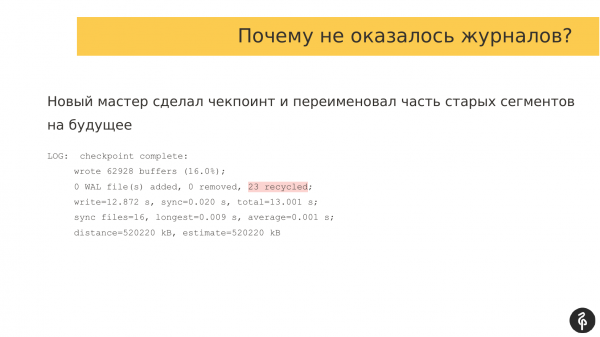
Treba je razumeti, zakaj je ni v klasterju in zakaj ni bilo dnevnikov. Gremo na nov glavni server in pogledamo, kaj ima v dnevnikih. Izkazalo se je, da je prišlo do checkpointa, ko je bil izveden pg_rewind. In del starejših dnevnikov transakcij je bil preimenovan. Ko se je stari glavni poskušal povezati z novim glavnim in zahtevati te dnevnike, so bili že preimenovani in jih preprosto ni bilo.
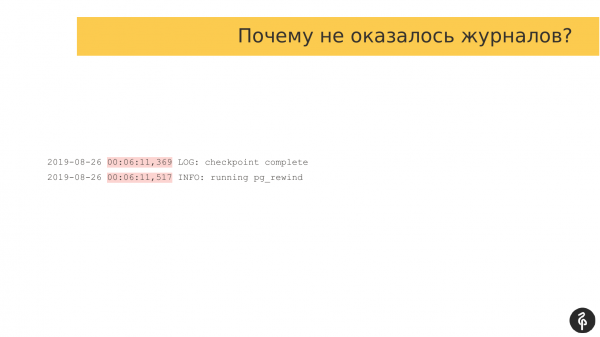
Primerjal sem časovne oznake, ko so se ta dogajanja zgodila. Razlika je bila komaj 150 milisekund, torej je bil checkpoint zaključen v 369 milisekundah, WAL-segmenti so bili preimenovani. In komaj 517 milisekund kasneje, po 150 milisekundah, se je zagnal rewind na stari repliki. To pomeni, da je bilo dobesedno 150 milisekund dovolj, da se replika ni mogla povezati in zagnati.
Kakšne so možnosti?
Sprva smo uporabljali replikacijske bloke. Mislili smo, da je to dobro. Toda na začetku eksploatacije smo bloke izklopili. Mislili smo, da lahko, če bloki naberejo veliko WAL-segmentov, obrnemo glavnega. On bo padel. Naredili smo si nekaj težav brez blokov. In razumeli smo, da jih potrebujemo, zato smo jih vrnili.
Vendar tu je težava, da ko mojster preide na kopijo, izbriše režne lokacije in skupaj z režami izbriše tudi WAL-segmente. Da bi odpravili to težavo, smo se odločili povečati parameter wal_keep_segments. Privzeto je 8 segmentov. Mi smo ga povečali na 1.000 in preverili, koliko prosto prostora imamo. Tako smo 16 gigabajtov namenili za wal_keep_segments. To pomeni, da imamo pri preklopu vedno na vseh vozliščih rezervo 16 gigabajtov transakcijskih dnevnikov.
In poleg tega – to je še posebej pomembno za dolgotrajne vzdrževalne naloge. Recimo, treba je posodobiti eno od kopij. In jo želimo izključiti. Moramo posodobiti programsko opremo, morda operacijski sistem, še kaj. Ko izklopimo kopijo, se za to kopijo tudi izbriše režnja. In če uporabljamo majhne wal_keep_segments, se med dolgotrajno odsotnostjo kopije transakcijski dnevniki predvajajo. Povišali bomo kopijo, ta bo zahtevala tiste transakcijske dnevnike, kjer je ostala, a na glavnem morda ne bo več tam. In kopija se ne bo mogla povezati. Zato ohranjamo veliko zalogo dnevnikov.
Imamo produkcijsko bazo. Tam že delujejo projekti.
Prišlo je do napake datoteke. Vstopili smo in preverili – vse je v redu, kopije so na mestu, zakasnitev replikacije ni. Napak v dnevnikih tudi ni, vse je v redu.
Produktna ekipa pravi, da bi morale biti neke podatke, a jih vidimo v enem viru, v bazi pa jih ne. Treba je razumeti, kaj se je z njimi zgodilo.
Jasno je, da je pg_rewind te podatke izgubil. To smo takoj razumeli, a smo šli preveriti, kaj se je dogajalo.
V dnevnikih vedno lahko najdemo, kdaj se je zgodila napaka datoteke, kdo je postal mojster in lahko določimo, kdo je bil stari mojster in kdaj je želel postati kopija, tj. potrebujemo te dnevnike, da ugotovimo obseg izgubljenih transakcijskih dnevnikov.
Naš stari mojster se je ponovno zagnal. In v avtomatskem zagonu je bil zapisan Patroni. Začel se je Patroni. Takoj je zagnal Postgres. Natančneje, pred zagonom Postgres-a in pred tem, ko ga je naredil za kopijo, je Patroni zagnal proces pg_rewind. Posledično je izbrisal del transakcijskih dnevnikov, prenesel nove in se povezal. Tu je Patroni deloval odlično, tj. kot je treba. Naš klaster se je obnovil. Imeli smo 3 vozlišča, po napaki datoteke 3 vozlišča – vse super.
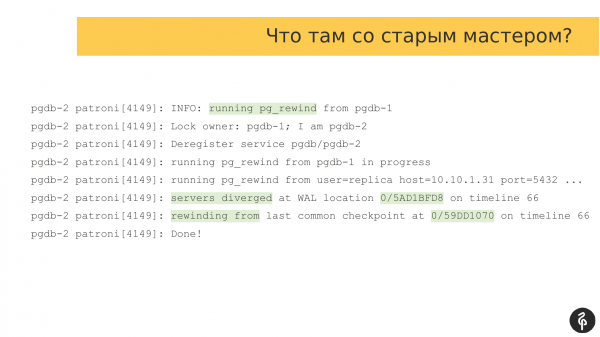
Izgubili smo deo podataka. Moramo da shvatimo koliko smo izgubili. Tražimo trenutak kada se pojavio rewind. To možemo da pronađemo u zapisima u dnevniku. Pokrenut je rewind, nešto se dogodilo i završeno je.
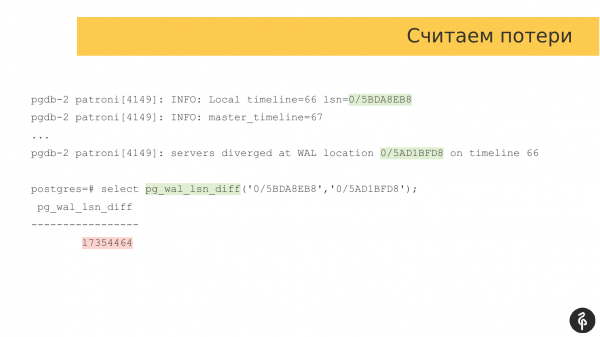
Moramo pronaći tu poziciju u dnevniku transakcija na kojoj se zaustavio stari master. U ovom slučaju – to je ova oznaka. I potrebna nam je druga oznaka, odnosno udaljenost po kojoj se stari master razlikuje od novog.
Uzimamo običan pg_wal_lsn_diff i upoređujemo te dve oznake. U ovom slučaju dobijamo 17 megabajta. Da li je to mnogo ili malo, svako za sebe odlučuje. Jer za nekoga je 17 megabajta malo, a za nekoga mnogo i nedopustivo. Tu svako za sebe individualno određuje u skladu sa potrebama poslovanja.
Ali šta smo saznali za sebe?
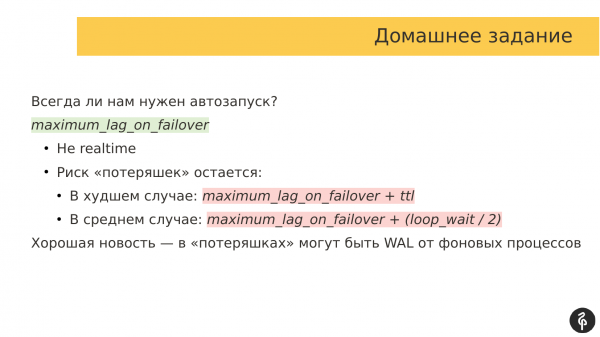
Pre svega, moramo da odlučimo – da li nam je uvek potreban automatski start Patroni nakon restartovanja sistema? Često se dešava da moramo da uđemo na stari master, pogledamo koliko je daleko otišao. Moguće je da inspektujemo segmente dnevnika transakcija, da vidimo šta tu ima. I da shvatimo – da li možemo da izgubimo te podatke ili nam je potrebno da pokrenemo stari master u standalone režimu kako bismo ih izvadili.
I tek nakon toga trebamo da donesemo odluku, da li možemo da odbacimo te podatke ili možemo da ih obnovimo, povezujemo ovu čvor kao repliku u naš klaster.
Pored toga, postoji parametar „maximum_lag_on_failover“. Ako se dobro sećam, podrazumevana vrednost ovog parametra iznosi 1 megabajt.
Kako to funkcioniše? Ako našoj replici nedostaje 1 megabajt podataka zbog zaostatka replikacije, ta replika neće učestvovati u izborima. I ako se dogodi failover, Patroni gleda koje replike zaostaju. Ako zaostaju za velikim brojem dnevnika transakcija, ne mogu postati master. To je veoma dobra zaštitna funkcija koja omogućava da ne izgubimo mnogo podataka.
Ali postoji problem u tome što se zaostatak replikacije u klasteru Patroni i DCS ažurira u određenim intervalima. Čini mi se da je podrazumevani ttl 30 sekundi.
Zato lahko pride do situacije, ko je zamik replikacije za replicirane podatke v DCS eden, v resnici pa je lahko povsem drugačen zamik ali pa zamika sploh ni, torej ta stvar ni v realnem času. In ne odraža vedno dejanske slike. In ne bi smeli zgraditi kompleksne logike na njej.
In tveganje za izgube vedno ostaja. In v najslabšem primeru ena formula, v povprečju pa druga formula. To pomeni, da ko načrtujemo uvedbo Patroni in ocenjujemo, koliko podatkov lahko izgubimo, moramo upoštevati te formule in približno imeti predstavo o tem, koliko podatkov lahko izgubimo.
In dobra novica je. Ko je stari glavni strežnik šel naprej, je lahko šel naprej zaradi nekaterih ozadnih procesov. To pomeni, da je bil avto-vakuum, napisani podatki so bili shranjeni v transakcijski dnevnik. Te podatke lahko brez težav prezremo in izgubimo. V tem ni nobenih težav.
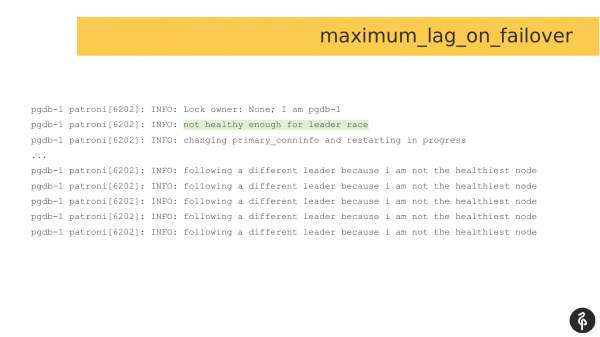
In tako izgledajo dnevniki, če je nastavljena maximum_lag_on_failover in se je zgodil failover, ter je treba izbrati novega glavnega strežnika. Replika se ocenjuje kot nezmožna sodelovati v volitvah. In odklanja sodelovanje v dirki za vodjo. Čaka, da bo izbran nov glavni strežnik, da se nato poveže z njim. To je dodatna zaščita pred izgubo podatkov.
Tukaj imamo produktno ekipo, ki je napisala, da njihov izdelek doživlja težave pri delu s Postgresom. Ob tem pa ni mogoče dostopati do glavnega strežnika, ker ni dostopen preko SSH. In avtomatski failover se prav tako ne zgodi.
Ta strežnik je bil prisilno ponovno zagnan. Zaradi ponovnega zagona se je zgodil avtomatski failover, čeprav bi lahko izvedli tudi ročni failover, kot sedaj razumem. In po ponovnem zagonu gremo že pogledati, kaj se je zgodilo z trenutnim glavnim strežnikom.
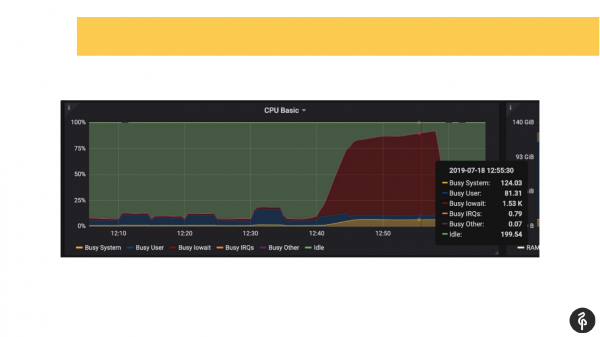
Ob tem smo vnaprej vedeli, da imamo težave z diski, torej smo že po monitoringu vedeli, kje iskati in kaj iskanje.
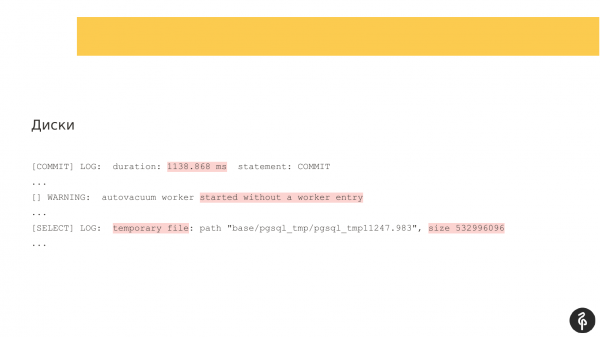
Skočili smo v postgresov dnevnik, začeli gledati, kaj se dogaja. Videli smo commit-e, ki trajajo eno, dve, tri sekunde, kar ni normalno. Videli smo, da se avto-vakuum zelo dolgo in nenavadno zažene. In opazili smo začasne datoteke na disku. To so vse kazalniki težav z diski.
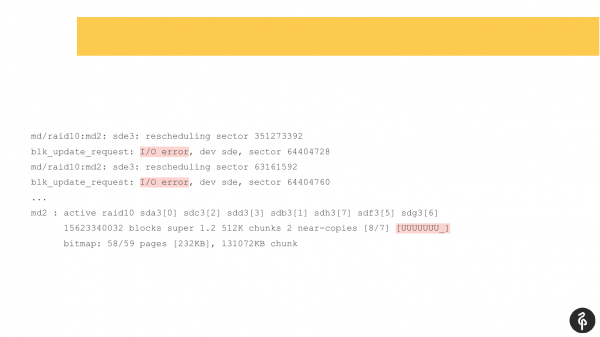
Pogledali smo sistemski dmesg (dnevnik kernalnih poruka). Uočili smo da imamo problema sa jednim od diskova. Diskovni sistem je predstavljao softverski Raid. Pogledali smo /proc/mdstat i uočili da nam nedostaje jedan disk. To jest, ovde je Raid od 8 diskova, a jednom nedostaje. Ako pažljivo pogledate slajd, možete primetiti da nam nedostaje sde. Drugim rečima, jedan disk je ispao. To je izazvalo diskovne probleme, a aplikacije su takođe imale problema pri radu sa Postgres klasterom.
U ovom slučaju, Patroni nam nikako ne bi pomogao, jer Patroni nema zadatak da prati stanje servera ili diskova. Ove situacije moramo pratiti putem spoljnog monitoring sistema. Uveli smo monitoring diskova kroz eksterni monitoring.
Imali smo ideju – da li bi nam mogao pomoći fencing ili softverski watchdog? Pomislili smo da nam verovatno ne bi pomogao u ovom slučaju, jer tokom problema, Patroni je nastavio da komunicira sa DCS klasterom i nije video nikakve probleme. Drugim rečima, sa stanovišta DCS i Patroni, sa klasterom je sve bilo u redu, iako su u stvari postojali problemi sa diskovima i dostupnošću baze podataka.
Po mom mišljenju, ovo je jedan od najčudnijih problema koje sam dugo istraživao, pregledao mnogo dnevnika i nazvao ga klaster-simulantom.
Problem je bio u tome što stari master nije mogao postati normalna replika, tj. Patroni ga je pokretao, a Patroni je pokazivao da je ovaj čvor prisutan kao replika, ali istovremeno nije bio normalna replika. Sada ćete videti zašto. Ovo je sačuvano iz analize tog problema.
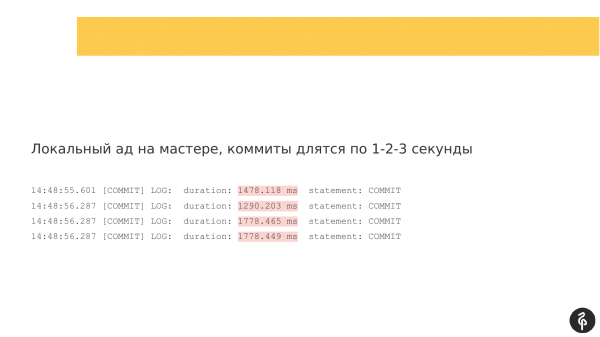
I kako je sve počelo? Počelo je, kao i u prethodnom problemu, sa usporenjem diskova. Imali smo po jedan do dva commit-a u sekundi.
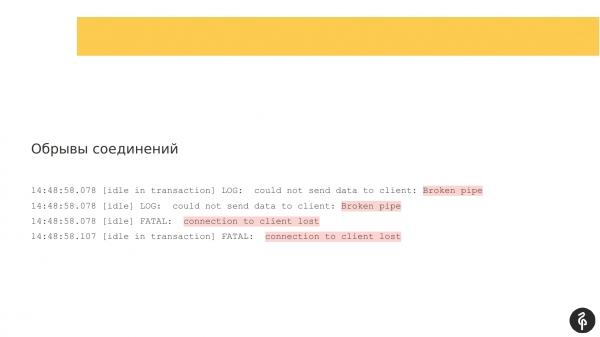
Bilo je prekida konekcija, tj. klijenti su se gubili.
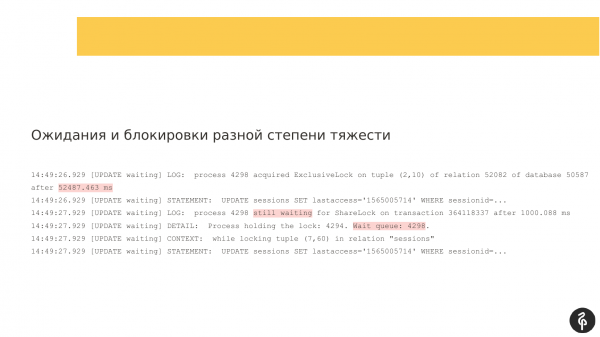
Bile su blokade različitih težina.
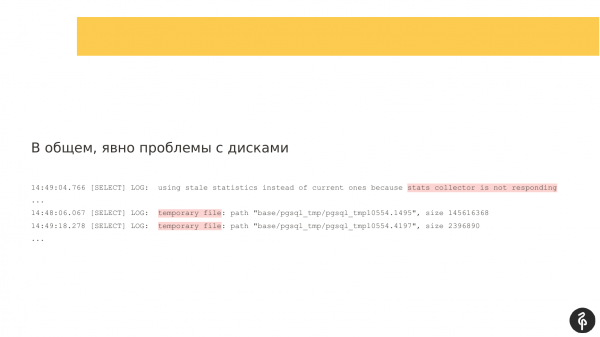
U skladu sa tim, diskovni sistem nije bio previše responzivan.
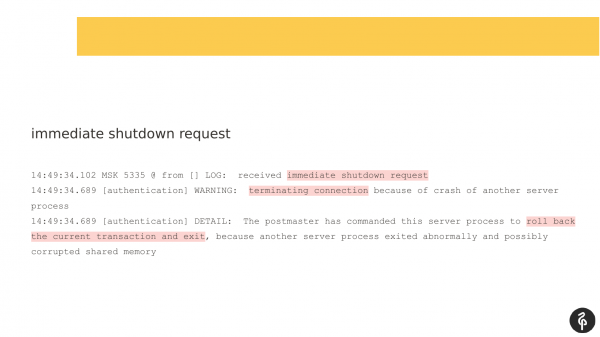
I ono što mi je najsumnjivije – to je bila hitna shutdown zahtev. Postgres ima tri režima gašenja:
- To je graceful, kada čekamo da se svi klijenti isključe sami.
- Postoji fast, kada primoravamo klijente da se isključe jer idemo na gašenje.
- Immediate. In this case, immediate doesn't even inform clients that it needs to shut down; it simply turns off without warning. The operating system sends a RST message (TCP message indicating that the connection has been interrupted and there is nothing left for the client to catch) to all clients.
Who sent this signal? Background Postgres processes do not send such signals to each other, i.e., this is a kill-9. They don't send such things to one another; they only react to it, meaning this is an emergency restart of Postgres. I do not know who sent it.
I checked with the 'last' command and saw one person who also logged into this server with us, but I hesitated to ask. Perhaps it was a kill -9. I would have seen kill -9 in the logs since Postgres writes that it has received kill -9, but I did not find this in the logs.
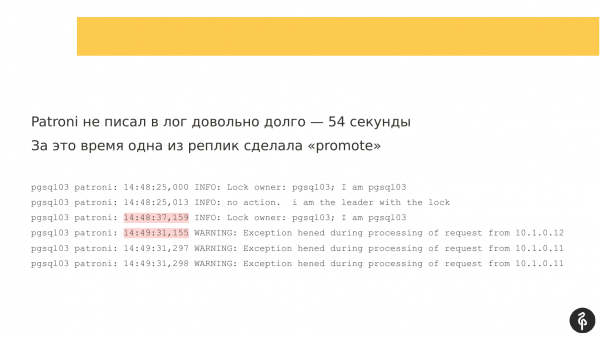
Looking further, I noticed that Patroni hadn't written to the log for quite a while – 54 seconds. And comparing the two timestamps, there were no messages for about 54 seconds.
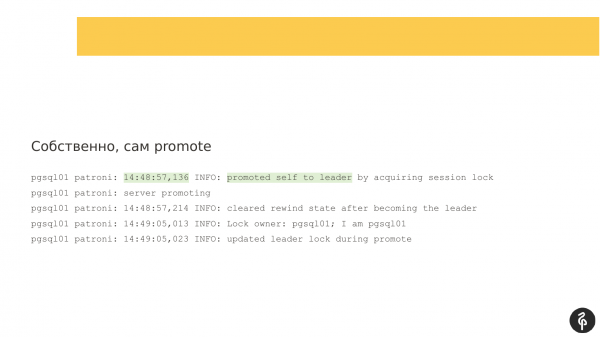
During this time, an auto-failover occurred. Patroni worked perfectly again here. Our old master was unavailable; something was happening with it. Elections for a new master began. Everything worked well here. Our pgsql01 became the new leader.
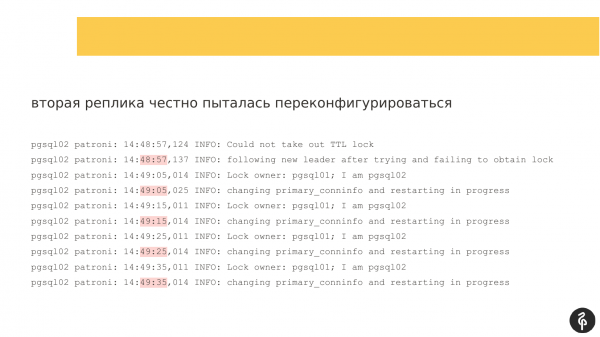
We have a replica that became the master. And there is a second replica. There were problems with the second replica. It was trying to reconfigure. As I understand, it was attempting to change recovery.conf, restart Postgres, and connect to the new master. Every 10 seconds, it wrote messages stating that it was trying, but it couldn't.
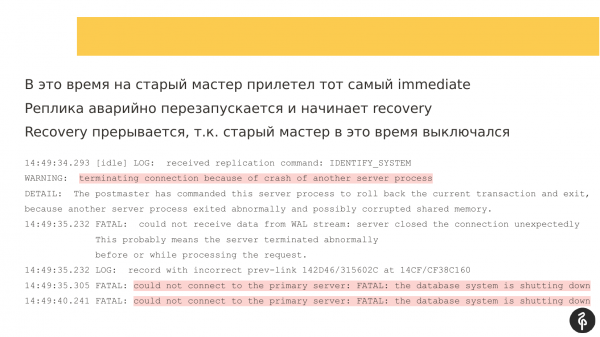
And during these attempts, the old master received an immediate-shutdown signal. The master restarts. And recovery also stops because the old master is rebooting. That is, the replica cannot connect to it because it is in shutdown mode.
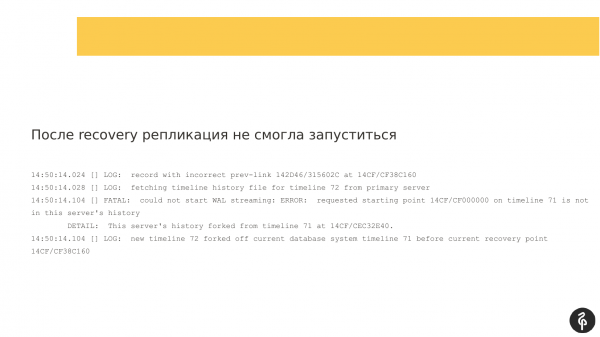
At some point, it started working, but replication did not start.
I have a sole hypothesis that the old master's address was in recovery.conf. And when the new master appeared, the second replica was still trying to connect to the old master.
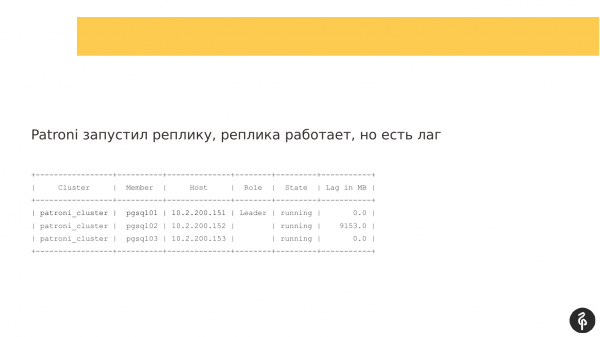
When Patroni started on the second replica, the node started up but could not connect for replication. A replication lag formed, which looked something like this. That is, all three nodes were in place, but the second node was behind.
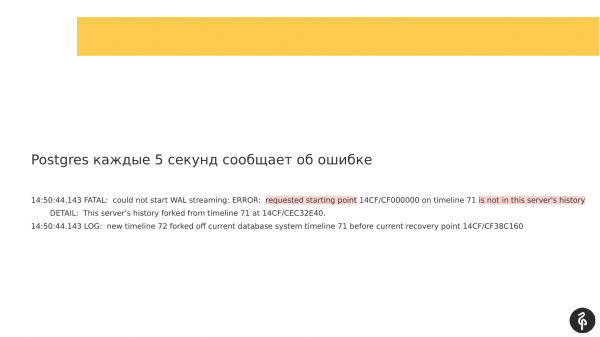
Pri tem, če pogledamo dnevnike, ki so bili pisani, lahko opazimo, da se replikacija ne more zagnati, ker se transakcijski dnevniki razlikujejo. In tisti transakcijski dnevniki, ki jih ponuja master, navedeni v recovery.conf, preprosto ne ustrezajo našemu trenutnemu vozlišču.
In tukaj sem storil napako. Moral sem priti in preveriti, kaj je v recovery.conf, da bi preveril svojo hipotezo, da se ne povezujemo s pravim masterjem. Toda takrat sem se šele začel spoznavati s tem in mi to ni prišlo na pomik, ali pa sem videl, da replikacija zamuja in da jo bo treba znova naliti, t.j. nekako sem to odsvetoval. To je bila moja napaka.
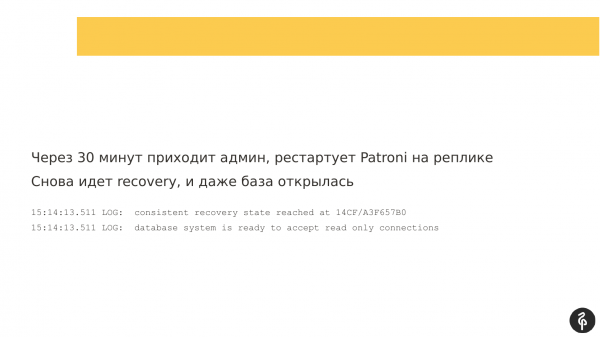
Po 30 minutah je administrátor že prišel, t.j. zopet sem zagnal Patroni na replikaciji. Že sem jo imel za izgubljeno, mislil sem, da jo bo treba ponovno naliti. In sem pomislil – ponovno bom zagnal Patroni, mogoče bo vseeno uspelo. Rešitev se je začela. In baza je bila celo odprta, bila je pripravljena sprejemati povezave.
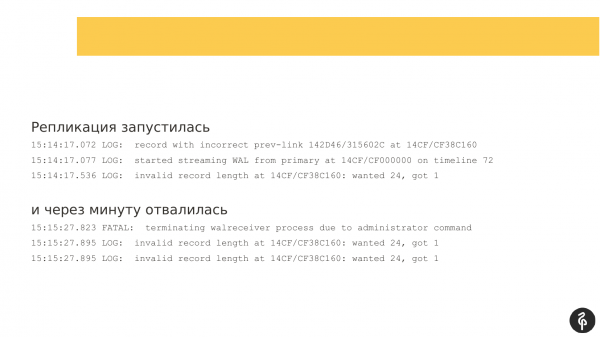
Replikacija se je zagnala. A čez minuto se je ponovno ustavila s sporočilom, da transakcijski dnevniki ne ustrezajo.
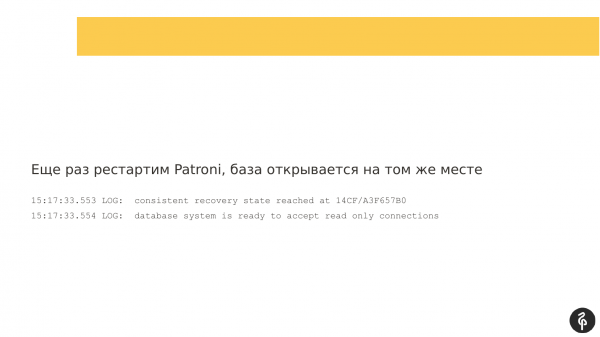
Pomislil sem, da bom še enkrat zagnal. Ponovno sem zagnal Patroni, in sicer nisem ponastavil Postgresa, ampak sem ponovno zagnal prav Patroni v upanju, da bo na čaroben način zagnal bazo.
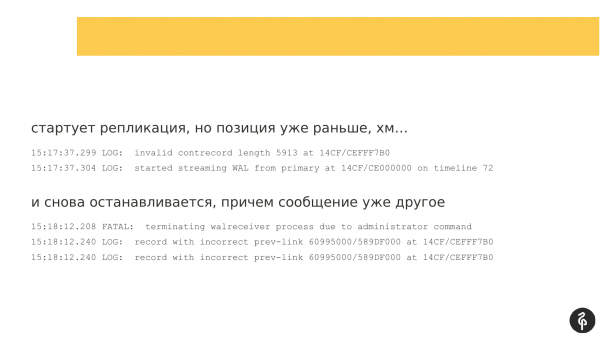
Replikacija se je ponovno zagnala, a oznake v transakcijskem dnevniku so se razlikovale; niso bile tiste, ki so bile ob prejšnjem poskusu zagona. Replikacija se je ponovno ustavila. In sporočilo je bilo nekoliko drugačno. Ni bilo preveč informativno zame.
In takrat mi je prišlo na misel – kaj če ponovno zaženem Postgres, medtem pa na trenutnem masterju naredim checkpoint, da nekoliko premaknem točko v transakcijskem dnevniku naprej, tako da se replikacija začne iz drugega trenutka? Poleg tega so bili pri nas še dodatki WAL.
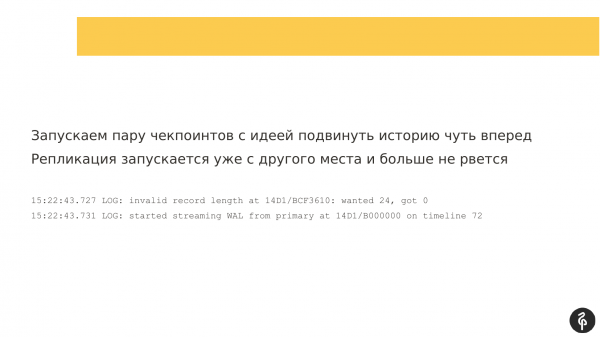
Ponovno sem zagnal Patroni, naredil nekaj checkpointov na masterju in nekaj restart-točk na replikaciji, ko se je odprla. In to je pomagalo. Dolgo sem razmišljal, zakaj je to pomagalo in kako je to delovalo. In replikacija se je zagnala. In replikacija se več ni ustavila.
Takšna težava je zame ena od bolj skrivnostnih, nad katerimi še vedno razmišljam, kaj se je dejansko dogajalo.
Kakšni so zaključki tukaj? Patroni lahko deluje, kot je predvideno, brez napak. Vendar to ni 100 % garancija, da je vse v redu. Replika se lahko zažene, vendar je lahko v pol-aktivnem stanju, in aplikacija ne more delovati z takšno replikacijo, ker bodo tam stari podatki.
In po failoverju je vedno treba preveriti, ali je z našim grozdom vse v redu, t.j. ali je potrebno število replik, ni zamude replikacije.
Med obravnavo teh težav bom oblikoval priporočila. Poskušal sem jih združiti v dva diapozitiva. Verjetno bi bilo mogoče vse zgodbe združiti v dva diapozitiva in le to predstaviti.
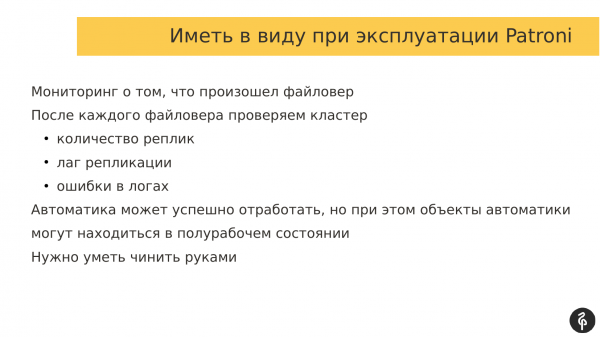
Ko uporabljate Patroni, morate imeti nujno monitoring. Vedno morate vedeti, kdaj je prišlo do avto-failoverja, ker, če ne veste, da je prišel avto-failover, ne nadzorujete grozda. In to je slabo.
Po vsakem failoverju moramo vedno ročno preveriti grozd. Moramo se prepričati, da imamo vedno ustrezno število replik, ni zamude replikacije, v dnevnikih ni napak, povezanih s pretokovno replikacijo, s Patronijem, s sistemom DCS.
Avtomatika lahko uspešno deluje, Patroni je zelo dobro orodje. Lahko deluje, vendar to ne pripelje grozda v želeno stanje. In če tega ne ugotovimo, bomo imeli težave.
In Patroni ni srebrna krogla. Kljub temu se moramo zavedati, kako deluje Postgres, kako deluje replikacija in kako Patroni deluje s Postgresom, ter kako je zagotovljena interakcija med vozlišči. To je potrebno, da bomo znali ročno odpraviti nastale težave.
Kako se lotevam diagnoze? Tako se je zgodilo, da delamo z različnimi strankami in nihče nima ELK sklada, zato se moramo ukvarjati z dnevniki, odpirati 6 konzol in 2 zavihka. V enem zavihku so dnevniki Patroni za vsak vozlišče, v drugem zavihku so dnevniki Consul-a ali Postgres, če je potrebno. Diagnoza je zelo težka.
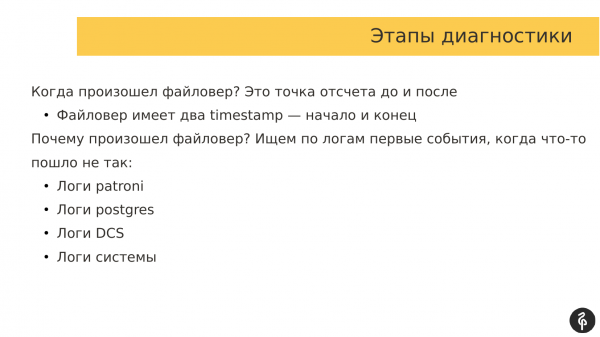
Kakšne pristope sem razvil? Prvič, vedno gledam, kdaj je prišel failover. In zame je to nekakšna prelomnica. Gledam, kaj se je zgodilo pred failoverjem, med failoverjem in po failoverju. Failover ima dve oznaki: to sta čas začetka in konca.
Zdaj preverjam dogodke v dnevnikih pred preklopom, kar je predhodilo preklopu, tj. iščem razloge, zakaj se je zgodil preklop.
In to daje sliko razumevanja, kaj se je dogajalo in kaj lahko storimo v prihodnje, da do takšnih okoliščin ne bi prišlo (in posledično ne do preklopa).
In kam običajno gledamo? Jaz gledam:
- Najprej v dnevnikih Patroni.
- Nato preverim dnevnike Postgres ali dnevnike DCS, odvisno od tega, kar najdem v dnevnikih Patroni.
- In dnevniki sistema tudi včasih ponujajo razumevanje, kaj je povzročilo preklop.
Kako gledam na Patroni? Na Patroni gledam zelo dobro. Po mojem mnenju je to najboljše, kar imamo danes. Poznam veliko drugih proizvodov. To so Stolon, Repmgr, Pg_auto_failover, PAF. 4 orodja. Poskusil sem vsa.
Če me vprašajo: 'Ali priporočam Patroni?'. Bom rekel, da da, ker mi je Patroni všeč. In mislim, da sem se ga naučil pripravljati.
Če vas zanima, katere še druge težave obstajajo s Patroni, poleg tistih, ki sem jih omenil, lahko vedno greste na stran na GitHub. Tam je veliko različnih zgodb in razpravlja se o mnogih zanimivih težavah. In na koncu so bile nekatere napake zabeležene in rešene, tj. to je zanimivo branje.
Tam so zanimive zgodbe o tem, kako si ljudje streljajo v nogo. Zelo poučno. Berete in razumete, da tega ne bi smeli početi. Postavil si bom kodo.
In rad bi se zahvalil podjetju Zalando za to, da razvijajo ta projekt, zlasti Alekseju Kukuškinu in Alekseju Kljukinu. Aleksej Kljukin je eden od soustanoviteljev, že ne dela več v Zalandu, ampak sta to dva človeka, ki sta začela delati s tem izdelkom.
In mislim, da je Patroni zelo kul stvar. Zadovoljen sem, da obstaja, zanimivo je delati z njim. In hvala vsem, ki prispevajo, ki pišejo popravke za Patroni. Upam, da bo Patroni s staranjem postal bolj zrel, bolj kul in delujoč. Že zdaj deluje, a upam, da bo še boljši. Zato, če nameravate uporabljati Patroni, se ne bojte. To je dobra rešitev, lahko jo uvedete in uporabljate.
To je vse. Če imate vprašanja, vprašajte.
Vprašanja
Hvala za predstavitev! Če je po preklopu vseeno treba zelo pozorno gledati, zakaj potrebujemo avtomatski preklop?
Ker vì to je nova stvar. Radimo s njom samo godinu dana. Bolje je previše se osigurati. Želimo ući i pogledati jesu li sve stvarno funkcionirale kako treba. Ovo je nivo odrasle nepovjerenja – bolje provjeriti i pogledati.
Na primjer, ujutro smo ušli i pogledali, zar ne?
Ne ujutro, obično saznamo za auto-failover gotovo odmah. Dolaze nam obavijesti, vidimo da se dogodio auto-failover. Uzimamo i provjeravamo gotovo odmah. No, sve te provjere trebaju biti iznesene na nivo monitorniga. Ako se obratimo Patroniju preko REST API-ja, postoji povijest. Kroz povijest možemo gledati vremenske oznake kada se dogodio failover. Na temelju toga možemo napraviti monitoring. Možemo gledati povijest, koliko je tamo događaja bilo. Ako nam se povećao broj događaja, tada se dogodio auto-failover. Možemo otići i provjeriti. Ili je naša automatizacija u monitoringu provjerila da su sve replike na mjestu, da nema kašnjenja i da je sve u redu.
Hvala!
Puno hvala za sjajnu priču! Ako smo premjestili DCS klaster negdje daleko od Postgres klastera, hoće li taj klaster isto tako trebati povremeno održavanje? Koje su najbolje prakse u vezi s tim da se neki dijelovi DCS klastera isključe, nešto s njima napravi itd.? Kako pri tome živi cijela ova konstrukcija? I kako te stvari raditi?
Za jednu tvrtku trebalo je napraviti matricu problema, što se događa ako neki od komponenti ili više njih zakažu. Kroz tu matricu možemo postupno obraditi sve komponente i izgraditi scenarije u slučaju kvara tih komponenti. Tako da za svaki scenarij kvara možemo imati plan akcije za oporavak. I u slučaju DCS-a to ide kao dio standardne infrastrukture. I admin to administrira, a mi se oslanjamo na admina koji to upravlja i na njegove sposobnosti da to popravi u slučaju nesreće. Ako DCS-a uopće nema, tada ga mi postavljamo, ali pri tome ne pratimo previše, jer nismo odgovorni za infrastrukturu, ali dajemo preporuke kako i što pratiti.
Dakle, je li točno da sam shvatio da trebamo isključiti Patroni, isključiti failover, isključiti sve prije nego što nešto radimo s hostovima?
To je odvisno od tega, koliko vozlišč imamo v DCS-klastru. Če je vozlišč veliko in če odpovemo samo enemu vozlišču (replikaciji), potem v klastru ostane kvorum. In Patroni ostaja funkcionalen. In nič se ne sproži. Če imamo kakšne kompleksne operacije, ki vključujejo več vozlišč, katerih odsotnost lahko povzroči razpad kvoruma, potem – ja, morda ima smisel postaviti Patroni na pavzo. Ima ustrezen ukaz – patronictl pause, patronictl resume. Preprosto postavimo na pavzo in avtofajler v tem času ne deluje. Opravljamo vzdrževanje na DCS-klastru, nato odstranimo pavzo in nadaljujemo s delom.
Hvala lepa!
Najlepša hvala za predstavitev! Kako se produktna ekipa odnasa do možnosti izgube podatkov?
Produktne ekipe je vseeno, tim liderji pa so zaskrbljeni.
Kakšne so tam garancije?
Z garancijami je zelo težko. Imajo poročilo Aleksandra Kukuškina "Kako izračunati RPO in RTO", torej čas obnove in koliko podatkov lahko izgubimo. Mislim, da bi morali najti te diapozitive in jih preučiti. Kolikor se spomnim, so tam konkretni koraki, kako izračunati te stvari. Koliko transakcij lahko izgubimo, koliko podatkov lahko izgubimo. Kot možnost lahko uporabimo sinhrono replikacijo na ravni Patroni, vendar je to dvorezen meč: ali imamo zanesljivost podatkov, ali izgubljamo hitrost. Obstaja sinhrona replikacija, vendar tudi ta ne zagotavlja 100%-ne zaščite pred izgubo podatkov.
Aleksej, hvala za odlično predstavitev! Ali imate izkušnje z uporabo Patroni za zaščito na ničli? T.j. v kombinaciji s sinhronim standby-jem? To je prvo vprašanje. In drugo vprašanje. Uporabljali ste različne rešitve. Mi smo uporabljali Repmgr, vendar brez avtofajlerja in zdaj načrtujemo povezati avtofajler. Razmišljamo o Patroni kot alternativni rešitvi. Kaj lahko poveste kot prednosti v primerjavi z Repmgr?
Prvo vprašanje je bilo o sinhronih replikah. Nihče ne uporablja sinhrone replikacije, ker se vsi bojijo (Že uporablja nekaj strank, težav s zmogljivostjo načeloma niso opazili – Opomba predavatelja). V našem případě jsme si vypracovali pravidlo, že v clusteru synchronní replikace musí být alespoň tři uzly, protože pokud máme dva uzly a dojde k selhání masteru nebo repliky, Patroni převede tento uzel do režimu Standalone, aby aplikace mohla pokračovat v chodu. V takovém případě existují rizika ztráty dat.
Co se týče druhé otázky, používali jsme Repmgr a stále jej používáme u některých klientů z historických důvodů. Co můžeme říci? V Patroni je auto failover k dispozici hned, v Repmgr je auto failover již jako dodatečná funkce, kterou je třeba aktivovat. Je třeba spustit Repmgr daemon na každém uzlu, a pak můžeme nastavit auto failover.
Repmgr kontroluje, zda jsou uzly Postgres živé. Procesy Repmgr kontrolují existenci jeden druhého, což není příliš efektivní přístup, protože mohou nastat složité případy síťové izolace, kdy se velký cluster Repmgr může rozpadnout na několik menších a pokračovat v chodu. Poslední dobou jsem Repmgr nesledoval, možná to opravili... možná ne. Avšak vyčlenění informací o stavu clusteru do DCS, tak jak to dělají Stolon a Patroni, je nejživotaschopnější možnost.
Alexei, mám otázku, možná trošku naivní. V jednom z prvních příkladů DCS jste přesunuli z místního počítače na vzdálený uzel. Chápeme, že síť má své vlastnosti, žije svým vlastním životem. A co se stane, pokud se z nějakého důvodu cluster DCS stane nedostupným? O příčinách teď mluvit nebudu, může jich být spousta: od neobratných rukou síťařů po skutečné problémy.
Nehovořil jsem o tom nahlas, ale cluster DCS by měl být také vysoce dostupný, tj. má být neparní počet uzlů, aby mohlo být dosaženo kvóra. Co se stane, pokud se cluster DCS stane nedostupným, nebo nebude schopen dosáhnout kvóra, tj. nějaký síťový split nebo selhání uzlů? V tomto případě přechází cluster Patroni do režimu pouze pro čtení. Cluster Patroni nemůže určit stav clusteru a co má dělat. Nemůže se spojit s DCS a uložit tam nový stav clusteru, proto celý cluster přechází do režimu pouze pro čtení. A čeká buď na manuální zásah operátora, nebo na obnovení DCS.
Jednoduše řečeno, DCS se pro nás stává službou stejně důležitou, jako je samotná databáze?
Da, da. V mnogih sodobnih podjetjih je Service Discovery nepogrešljiv del infrastrukture. Uvajajo ga celo prej, kot so se pojavile baze podatkov v infrastrukturi. Pogojo je mogoče opisati tako, da smo zagnali infrastrukturo, postavili v DC, in že imamo Service Discovery. Če je to Consul, lahko na njem temelji tudi DNS. Če je to Etcd, je lahko del Kubernetes klasterja, kjer se bo razporedilo vse drugo. Zdi se mi, da je Service Discovery že nepogrešljiv del sodobnih infrastrukturnih sistemov in o njem razmišljajo veliko prej, kot o bazah podatkov.
Hvala!
Izvor: habr.com
