

Kot je znano, podjetje SAP ponuja celoten spekter programske opreme, tako za obveščanje transakcijskih podatkov kot za obdelavo teh podatkov v sistemih analize in poročanja. Natančneje, platforma SAP Business Warehouse (SAP BW) predstavlja orodje za shranjevanje in analizo podatkov, ki nudi široke tehnične možnosti. Kljub svojim objektivnim prednostim pa ima sistem SAP BW eno pomembno pomanjkljivost. To je visoka cena shranjevanja in obdelave podatkov, kar je še posebej opazno pri uporabi oblačnega SAP BW on Hana.
Kaj pa, če za shranjevanje začnemo uporabljati kakšen non-SAP in po možnosti OpenSource izdelek? V X5 Retail Group smo izbrali GreenPlum. To seveda rešuje vprašanje stroškov, vendar pa se hkrati pojavijo vprašanja, ki so se pri uporabi SAP BW reševala praktično samodejno.
Zlasti, kako pridobiti podatke iz sistemov virov, ki so v večini rešitev SAP?
Projekt „HR-metrike“ je bil prvi projekt, v katerem je bilo potrebno rešiti to težavo. Naš cilj je bil ustvariti skladišče HR-podatkov in zgraditi analitična poročila na področju dela s zaposlenimi. Pri tem je glavni vir podatkov transakcijski sistem SAP HCM, v katerem se vodijo vsi kadrovski, organizacijski in plačni procesi.
Ekstrakcija podatkov
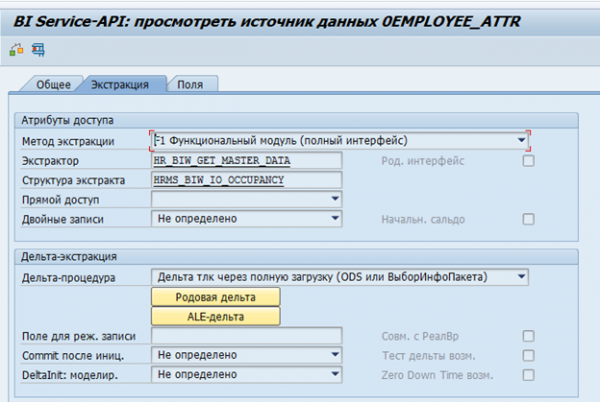
V SAP BW za SAP sisteme obstajajo standardni ekstraktorji podatkov. Ti ekstraktorji lahko samodejno zbirajo potrebne podatke, spremljajo njihovo celovitost in določajo spremembe. Tukaj je na primer standardni vir podatkov za atribute zaposlenih 0EMPLOYEE_ATTR:
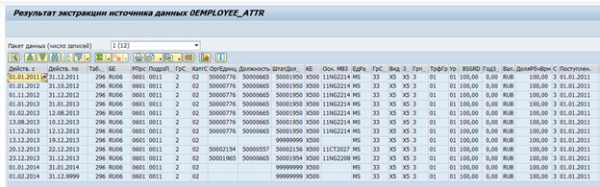
Rezultat ekstrakcije podatkov iz njega za enega zaposlenega:
Po potrebi se lahko tak ekstraktor prilagodi lastnim zahtevam ali pa lahko ustvarimo svoj lastni ekstraktor.
Prva ideja je bila o možnosti njihove ponovne uporabe. Na žalost se je izkazalo, da je to neizvedljiva naloga. Večina logike je bila реализirana na strani SAP BW, in ločiti ekstraktor na viru od SAP BW brez težav ni bilo mogoče.
Postalo je očitno, da bo potrebna razvoj lastnega mehanizma za ekstrakcijo podatkov iz SAP sistemov.
Struktura shranjevanja podatkov v SAP HCM
Za razumevanje zahtev za takšen mehanizem je najprej potrebno določiti, katere podatke bomo potrebovali.
Večina podatkov v SAP HCM je shranjena v ravnih SQL tabelah. Na podlagi teh podatkov aplikacije SAP vizualizirajo uporabniku organizacijske strukture, zaposlene in druge informacije o zaposlenih. Na primer, tako v SAP HCM izgleda organizacijska struktura:
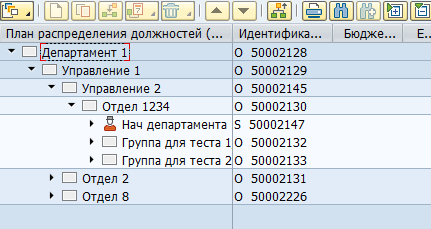
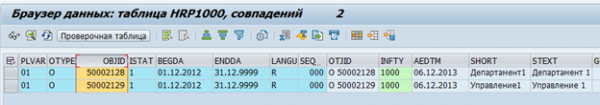
Fizično se to drevo shranjuje v dveh tabelah — v hrp1000 objekti in v hrp1001 povezave med temi objekti.
Objekti „Oddelek 1“ in „Uprava 1“:
Povezava med objekti:
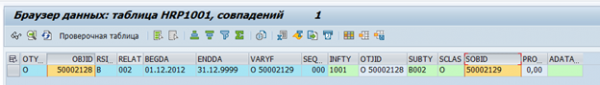
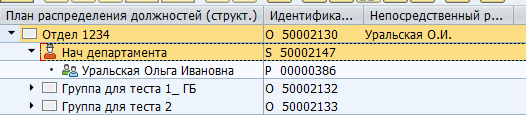
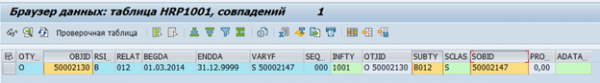
Obstaja lahko ogromno vrst objektov in vrst povezav med njimi. Obstajajo tako standardne povezave med objekti kot tudi prilagojene za lastne specifične potrebe. Na primer, standardna povezava B012 med organizacijsko enoto in delovnim mestom kaže na vodjo oddelka.
Prikaz vodje v SAP:
Shranjevanje v BDP tabeli:
Podatki o zaposlenih so shranjeni v tabelah pa*. Na primer, podatki o kadrovskih dogodkih za zaposlenega so shranjeni v tabeli pa0000.
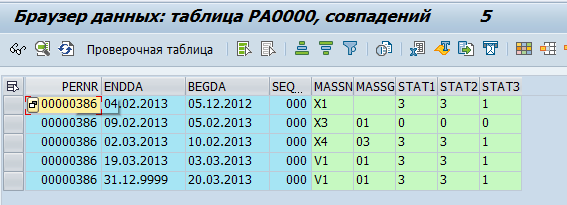
Odločili smo se, da bo GreenPlum pridobival „surove“ podatke, to jest, preprosto jih kopiral iz SAP tabel. In šele nato bodo v GreenPlum obdelani in spremenjeni v fizične objekte (na primer, Oddelek ali Zaposleni) in metrike (na primer, povprečna števila zaposlenih).
Določili smo približno 70 tabel, katerih podatke je treba prenesti v GreenPlum. Po tem smo se lotili razprave o načinu prenosa teh podatkov.
SAP ponuja precej velik nabor mehanizmov integracije. Vendar je najpreprostejši način – neposreden dostop do baze podatkov prepovedan zaradi licenčnih omejitev. Tako morajo biti vsi integracijski tokovi izvedeni na ravni strežnika aplikacij.
Naslednja težava je bila pomanjkanje podatkov o izbrisanih zapisih v BDP SAP. Ko je vrstica izbrisana v BDP, se fizično izbriše. To pomeni, da je oblikovanje delte sprememb po času spremembe bilo nemogoče.
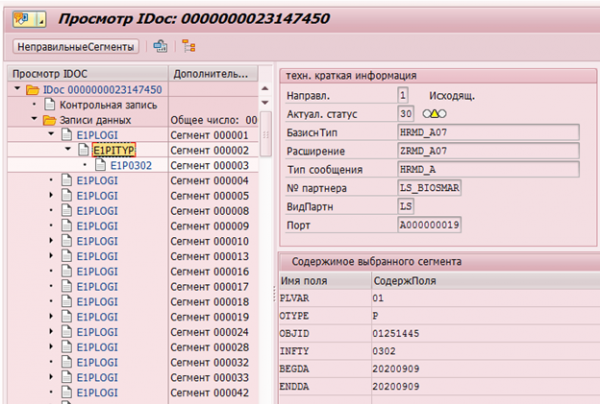
Seveda, v SAP HCM obstajajo mehanizmi za beleženje sprememb podatkov. Na primer, za nadaljnji prenos v sistem prejemnike obstajajo pokazatelji sprememb (change pointer), ki beležijo vse spremembe in na podlagi katerih se oblikujejo Idoc (objekt za prenos v zunanje sisteme).
Primer IDoc za promenu infotipa 0302 kod zaposlenog sa brojem 1251445:
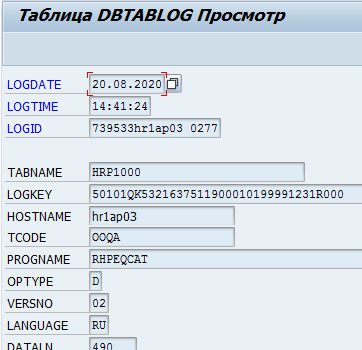
Ili vođenja evidencije promena podataka u tabeli DBTABLOG.
Primer loga brisanja zapisa sa ključem QK53216375 iz tabele hrp1000:
Međutim, ovi mehanizmi nisu dostupni za sve potrebne podatke i njihova obrada na nivou serverskih aplikacija može trošiti značajne resurse. Stoga, masovno uključivanje logovanja za sve potrebne tabele može dovesti do značajnog smanjenja performansi sistema.
Sledeći ozbiljan problem su klasterske tabele. Podaci o proceni vremena i obračunu plata u RDBMS verzije SAP HCM čuvaju se kao skup logičkih tabela za svakog zaposlenog po svakom obračunu. Ove logičke tabele se u obliku binarnih podataka čuvaju u tabeli pcl2.
Klasterski obračun plata:
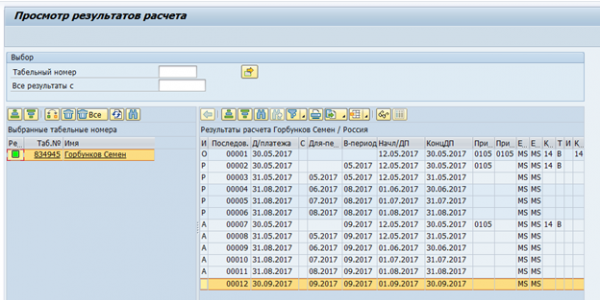
Podaci iz klasterskih tabela ne mogu se čitati SQL komandama, već je potrebno koristiti makro komande SAP HCM ili specijalne funkcionalne module. Prema tome, brzina čitanja takvih tabela će biti dovoljno niska. S druge strane, u takvim klasterima se čuvaju podaci koji su potrebni samo jednom mesečno - konačni obračun plata i procena vremena. Tako da brzina u ovom slučaju nije toliko kritična.
Procjenjujući opcije za formiranje delte promena podataka, odlučeno je takođe razmotriti opciju sa potpunim izvozom. Opcija svakodnevnog prenosa gigabajta nepromenjenih podataka između sistema ne može izgledati dobro. Međutim, ima i niz prednosti - nema potrebe za implementacijom delte sa strane izvora, kao ni za implementaciju ugradnje te delte sa strane primaoca. Tako se smanjuju troškovi i rokovi realizacije, a povećava se pouzdanost integracije. Pri tome je utvrđeno da se praktično sve promene u SAP HR dešavaju u horizontu od tri meseca pre trenutnog datuma. Tako je donesena odluka da se zaustavimo na svakodnevnom potpunom izvozu podataka iz SAP HR za N meseci pre trenutnog datuma i na mesečnom potpunom izvozu. Parametar N zavisi od konkretne tabele.
i kreće se od 1 do 15.
Za ekstrakciju podataka predložena je sledeća šema:
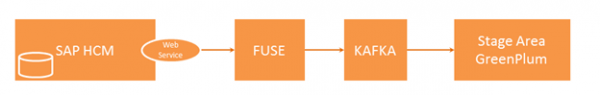
Zunanja sistem oblikuje zahtevo in jo pošlje v SAP HCM, kjer se zahteva preveri glede popolnosti podatkov in pooblastil za dostop do tabel. V primeru uspešnega preverjanja, v SAP HCM zažene program, ki zbira potrebne podatke in jih prenaša v integracijsko rešitev Fuse. Fuse določi potreben topic v Kafka in prenese podatke tja. Podatki iz Kafka se nato prenesejo v Stage Area GP.
V tej verigi nas zanima vprašanje pridobivanja podatkov iz SAP HCM. Poglejmo to podrobneje.
Shema interakcije SAP HCM-FUSE.
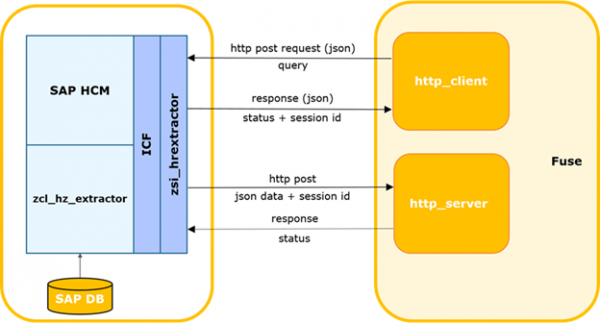
Zunanja sistem določa čas zadnje uspešne zahteve v SAP.
Postopek se lahko sproži s časovnikom ali drugimi dogodki, lahko pa je določen tudi časovni prag za čakanje na odgovor s podatki iz SAP in iniciacija ponovne zahteve. Nato oblikuje zahtevo za delto in jo pošlje v SAP.
Podatki zahteve se prenašajo v body v formatu json.
Metoda http: POST.
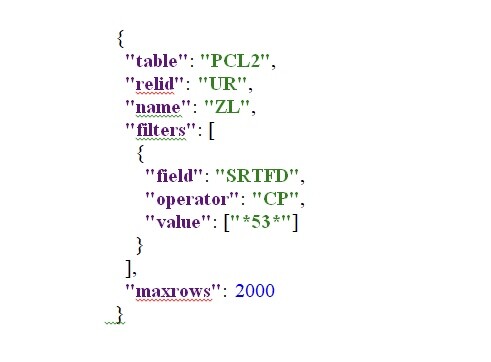
Primer zahteve:
Storitve SAP izvajajo nadzor zahteve glede popolnosti, skladnosti s trenutnimi strukturo SAP in prisotnosti dovoljenja za dostop do zahtevane tabele.
V primeru napak storitev vrne odgovor s pripadajočo kodo in opisom. V primeru uspešnega nadzora ustvari ozadnji postopek za oblikovanje izbire, generira in sinhrono vrne edinstven id seje.
Zunanja sistem v primeru napake registrira le-to v dnevnik. V primeru uspešnega odgovora prenese id seje in ime tabele, na kateri je bila oblikovana zahteva.
Zunanja sistem registrira trenutno sejo kot odprto. Če obstajajo druge seje za to tabelo, se te zaprejo s registracijo opozorila v dnevniku.
Ozadnje naloge SAP oblikujejo kazalec po določenih parametrih in paket podatkov določene velikosti. Velikost paketa je največje število zapisov, ki jih postopek prebere iz Baze podatkov. Privzeto je nastavljena na 2000. Če je v bazi več zapisov, kot je uporabljena velikost paketa, se po prenosu prvega paketa oblikuje naslednji blok s pripadajočim offsetom in inkrementiranim številom paketa. Številke se inkrementirajo za 1 in pošiljajo strogo zaporedno.
Nato SAP pošilja paket na vhod web storitvi zunanjega sistema. Ta sistem izvaja kontrole prejetega paketa. V sistemu mora biti registrirana seja s prejetim id in mora biti v odprtem stanju. Če je številka paketa > 1, mora biti v sistemu registrirano uspešno prejemanje prejšnjega paketa (package_id-1).
V primeru uspešne kontrole zunanja sistem obdeluje in shranjuje podatke iz tabele.
Dodatno, če paket vsebuje zastavico final in je bila serializacija uspešna, se obvesti modul integracije o uspešnem zaključku obdelave seje in modul posodobi stanje seje.
V primeru napake pri kontrolah/šifriranju se napaka zabeleži in paketi tega seje bodo zavrnjeni s strani zunanjega sistema.
Podobno, ko zunanja sistem vrne napako, se ta zabeleži in prenos paketov se prekine.
Za zahtevo podatkov na strani SAP HCM je bil uresničen integracijski servis. Servis je implementiran na okvirju ICF (SAP Internet Communication Framework — ). Omogoča poizvedovanje podatkov iz sistema SAP HCM za določene tabele. Pri oblikovanju poizvedbe podatkov je mogoče določiti seznam specifičnih polj in parametre filtriranja z namenom pridobitve potrebnih podatkov. Pri tem implementacija servisa ne predvideva nobene poslovne logike. Algoritmi za izračun delta, parametrov poizvedbe, nadzor celovitosti itd. so prav tako implementirani na strani zunanjega sistema.
Ta mehanizem omogoča zbiranje in prenos vseh potrebnih podatkov v nekaj urah. Takšna hitrost je na robu sprejemljive, zato to rešitev obravnavamo kot začasno, ki je omogočila zapolnitev potrebe po orodju za ekstrakcijo v projektu.
V ciljni sliki za reševanje naloge ekstrakcije podatkov se obravnavajo možnosti uporabe sistemov CDC, kot je Oracle Golden Gate ali ETL orodij, kot so SAP DS.
Izvor: habr.com
