

Pred tremi leti sta Viktor Tarnavski in Aleksej Milovidov iz Yandexa na odru HighLoad++ , govorila, kako je ClickHouse odličen in kako ne zastaja. Na sosednjem odru je bil Aleksander Zajtsev z o selitvi na ClickHouse drugo analitično DB in s sklepom, da ClickHouse, seveda, je dober, vendar ni ravno enostaven za uporabo. Ko je leta 2016 podjetje LifeStreet, v katerem je takrat delal Aleksander, prenašalo večpetabajtni analitični sistem na ClickHouse, je bila to zanimiva ‘pot iz rumenih opeke’, polna neznanih nevarnosti — ClickHouse takrat je spominjalo na mino polje.
Tri leta kasneje ClickHouse je postalo veliko boljše — v tem času je Aleksander ustanovil podjetje Altinity, ki ne le da pomaga pri selitvah na ClickHouse številne projekte, temveč tudi izboljšuje sam izdelek skupaj s kolegi iz Yandexa. Zdaj ClickHouse ni več brezskrbna sprehod, a že tudi ne mino polje.
Aleksander se s porazdeljenimi sistemi ukvarja od leta 2003, razvijal je velike projekte na MySQL, Oracle in Vertica. Na preteklem HighLoad++ 2019 je Aleksander, eden od pionirjev uporabe ClickHouse, povedal, kakšna je ta DB danes. Ugotovili bomo glavne značilnosti ClickHouse: kako se razlikuje od drugih sistemov in v katerih primerih je učinkoviteje uporabljati. Preučili bomo sveže in preizkušene prakse gradnje sistemov na ClickHouse.
Retrospektiva: kaj se je zgodilo pred 3 leti
Pred tremi leti smo prenesli podjetje LifeStreet na ClickHouse z druge analitične baze podatkov, in migracija analitike oglasne mreže je izgledala takole:
- Junij 2016. V OpenSource pojavil ClickHouse je začel naš projekt;
- Avgust. Proof Of Concept: velika oglasna mreža, infrastruktura in 200-300 terabajtov podatkov;
- Oktober. Prvi produkcijski podatki;
- December. Polno produktno obremenitev - 10-50 milijard dogodkov na dan.
- Junij 2017. Uspešna selitev uporabnikov na ClickHouse, 2,5 petabajtov podatkov na klasterju iz 60-ih strežnikov.
Med procesom migracije se je povečalo razumevanje, da ClickHouse je dober sistem, s katerim je prijetno delati, vendar je to notranji projekt podjetja Yandex. Zato obstajajo posebnosti: Yandex se bo najprej ukvarjal z lastnimi notranjimi naročniki in šele nato - s skupnostjo in potrebami zunanjih uporabnikov, medtem ko ClickHouse takrat ni dosegal ravni podjetja v mnogih funkcionalnih področjih. Zato smo marca 2017 ustanovili podjetje Altinity, da bi to naredili. ClickHouse še hitreje in bolj priročno ne le za Yandex, ampak tudi za druge uporabnike. In zdaj smo:
- Usposabljamo in pomagamo pri gradnji rešitev na ClickHouse tako, da naročniki ne naletijo na težave, in da rešitev na koncu deluje;
- Zagotavljamo 24/7 podporo ClickHouse-namestitev;
- Razvijamo lastne ekosistemske projekte;
- Aktivno sodelujemo v samem ClickHouse, odgovarjamo na zahteve uporabnikov, ki si želijo videti različne funkcije.
In seveda, pomagamo pri selitvi na ClickHouse z MySQL, Vertica, Oracle, Greenplum, Redshift in druge sisteme. Udeležili smo se najrazličnejših selitev, in vse so bile uspešne.
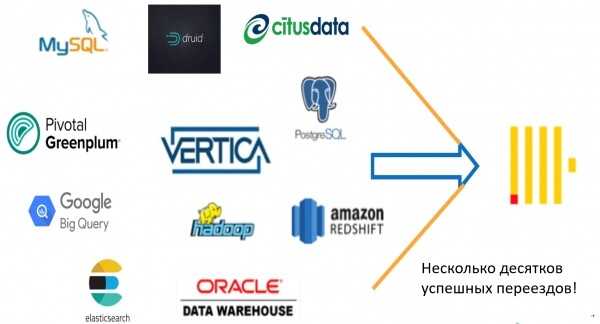
Zakaj se sploh seliti na ClickHouse
Ne upočasnjuje se! To je glavni razlog. ClickHouse — zelo hitra baza podatkov za različne scenarije:
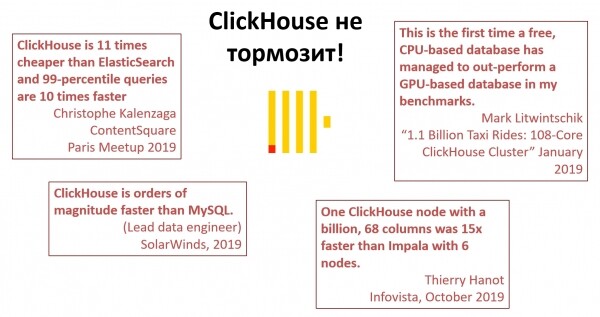
Naključni citati ljudi, ki dolgo delajo s ClickHouse.
Širljivost. Na neki drugi BDP lahko dosežete dobro zmogljivost na eni strojni opremi, vendar ClickHouse lahko skalirate ne samo navpično, ampak tudi horizontalno, preprosto z dodajanjem strežnikov. Vse ne teče tako gladko, kot bi si želeli, ampak deluje. Sistemo lahko širite ob rasti podjetja. Pomembno je, da nismo omejeni z rešitvijo zdaj in vedno obstaja potencial za razvoj.
Prenosljivost. Brez vezave na nekaj enega. Na primer, s Amazon Redshift je težko kamor koli preseliti. A ClickHouse lahko namestite na svoj prenosnik, strežnik, ga razporedite v oblak, preidete na Kubernetes — ni omejitev pri upravljanju infrastrukture. To je priročno za vse in velika prednost, s katero se ne morejo pohvaliti mnoge druge podobne BDP.
Fleksibilnost. ClickHouse se ne ustavi pri nečem enem, na primer, pri Yandex.Metriki, ampak se razvija in uporablja v vse večjem številu različnih projektov in industrij. Lahko ga razširite z dodajanjem novih možnosti za reševanje novih nalog. Na primer, menijo, da je shranjevanje logov v BDP slabo, zato so za to izumili Elasticsearch. Ampak, zahvaljujoč prilagodljivosti ClickHouse, je mogoče tudi v njem shranjevati loge, in pogosto je to celo boljše kot v Elasticsearch — v ClickHouse za to potrebuje 10-krat manj strojne opreme.
Brezplačno Open Source. Ni treba nič plačati. Ni treba se dogovoriti za dovoljenje, da si postavite sistem na prenosnik ali strežnik. Brez skritih plačil. Pri tem pa nobena druga Open Source tehnologija baz podatkov ne more konkurirati hitrostjo z ClickHouse. MySQL, MariaDB, Greenplum — vsi so precej počasnejši.
Skupnost, zagon in zabavno. Ima ClickHouse odlično skupnost: srečanja, klepeta in Aleksej Milovidov, ki nas vse napolni s svojo energijo in optimizmom.
Prehod na ClickHouse
Da bi prešli na ClickHouse nekaj drugega, potrebujete le tri stvari:
- Razumeti omejitve ClickHouse in za kaj ni primeren.
- Izkoristiti prednosti tehnologije in njene najmočnejše točke.
- Eksperimentirati. Tudi razumevanje delovanja ClickHouse, ni vedno dovolj za napoved, kdaj bo hitrejši, kdaj počasnejši, kdaj boljši in kdaj slabši. Zato preizkusite.
Problem prehoda
Obstaja le ena 'ampak': če prehajate na ClickHouse nečesa drugega, običajno kaj ne gre tako, kot bi moralo. Navadili smo se na določene prakse in stvari, ki delujejo v naši ljubljeni bazi podatkov. Na primer, vsak človek, ki dela s SQL-bazi podatkov, šteje ta nabor funkcij za obvezne:
- transakcije;
- omejitve;
- skladnost;
- indeksi;
- UPDATE/DELETE;;
- NULL;;
- milisekunde;
- samodejna pretvorba tipov;
- večkratni spoj;
- poljubne particije;
- orodja za upravljanje grozdov.
Obvezni nabor obstaja, vendar pred tremi leti v ClickHouse ni bilo nobene od teh funkcij! Zdaj je ostalo manj kot polovica nerealiziranih: transakcije, omejitve, skladnost, milisekunde in pretvorba tipov.
In kar je najpomembneje — to, da nekatere standardne prakse in pristopi ne delujejo ali delujejo drugače, kot smo navajeni. Vse, kar se pojavi v ClickHouse , ustreza ' ClickHouseClickHouse way', tj. funkcije se razlikujejo od drugih baz podatkov. Na primer:Indeksi ne izbirajo, temveč prepuščajo.
- so asinhrone, ne sinhrone.
- UPDATE/DELETE; Večkratni spoj obstaja, vendar ni načrtovalnika poizvedb. Kako se potem izvajajo, ljudem iz sveta baz podatkov ni preveč jasno.
- Scenariji ClickHouse
Leta 1960 je ameriški matematik madžarskega porekla
Wigner E. P. napisal članek ' Nepochopljiva učinkovitost matematike v naravnih znanostih' o tem, da svet okoli nas nekako dobro opisujejo matematični zakoni. Matematika je abstraktna znanost, fizični zakoni, izraženi v matematični obliki, niso trivialni inje poudaril, da je to zelo čudno. napisal članek ' Zame je
enaka čudnost. Preoblikovano Wignerjevo misel lahko rečemo tako: osupljiva nepojmljiva učinkovitost ClickHouse v najrazličnejših analitičnih aplikacijah! ClickHouse Na primer, vzemimo
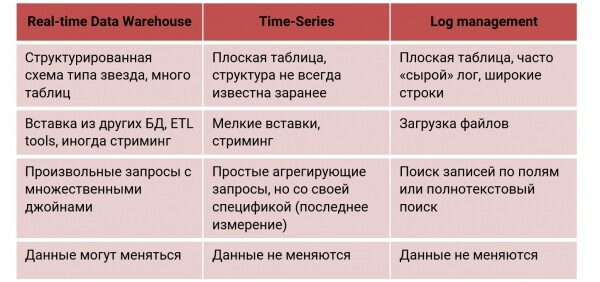
Real-Time Data Warehouse , v katerega se podatki nenehno nalagajo. Želimo, da od njega prejemamo poizvedbe z zamudo v sekundah. Prosim — uporabimo, v katerega se podatki nalagajo skoraj neprekinjeno. Želimo prejemati zahteve z enosekundnim zamikom. Prosim — uporabimo ClickHouse, ker je bil zasnovan prav za ta scenarij. ClickHouse prav tako se uporablja ne samo na spletu, temveč tudi v marketingu in finančni analitiki, AdTech, pa tudi v odkrivanju prevar. V Real-time Data Warehouse se uporablja zapletena strukturirana shema tipa 'zvezda' ali 'mohor', z več tabelami JOIN (včasih večkratnimi), podatki pa se običajno shranjujejo in spreminjajo v določenih sistemih.
Vzemimo drug scenarij — Časovne serije: spremljanje naprav, omrežij, statistika uporabe, internet stvari. Tukaj se srečujemo s časovno urejenimi precej preprostimi dogodki. ClickHouse za to sprva ni bil zasnovan, je pa dobro deloval, zato velike podjetja uporabljajo ClickHouse kot shrambo za spremljevalne informacije. Da bi ugotovili, ali je ClickHouse primeren za časovne serije, smo izvedli benchmark na podlagi pristopa in rezultatov InfluxDB in TimescaleDB — specializiranih časovnih serij baz podatkov. , da ClickHouse, celo brez optimizacije za to nalogo, zmaga tudi na tujem terenu:
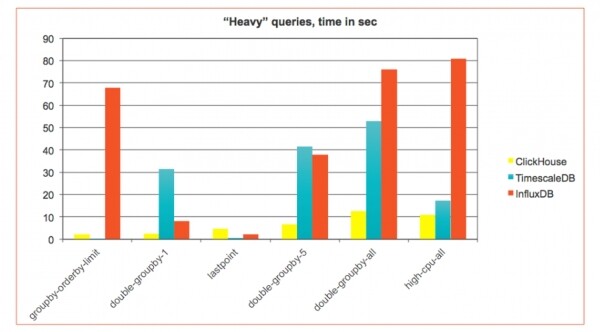
V časovnih serij običajno se uporablja ozka tabela — nekaj majhnih stolpcev. S spremljanja lahko pride zelo veliko podatkov — milijoni zapisov na sekundo — in običajno pridejo v manjših vložkih (real-time streamingu). Zato potrebujemo drugačen scenarij vstavljanja, sami poizvedbe pa — s svojo nekakšno specifičnostjo.
Upravljanje dnevnikov. Zbiranje dnevnikov v BDP — to običajno ni dobro, a v ClickHouse to lahko počnemo z nekaterimi komentarji, kot je opisano zgoraj. Mnoge družbe to uporabljajo ClickHouse prav za to. V tem primeru se uporablja široka ploska tabela, kjer shranjujemo dnevnike v celoti (na primer, v obliki JSON), ali jih razdelimo na dele. Podatki se običajno prenašajo v velikih serijah (datotekah), iščemo po katerem koli polju.
Za vsako od teh funkcij se običajno uporabljajo specializirane baze podatkov. ClickHouse ena lahko vse to opravi tako dobro, da premaga njihovo zmogljivost. Poglejmo zdaj podrobneje časovnih serij scenarij in kako pravilno 'pripraviti' ClickHouse za ta scenarij.
Časovne serije
To je trenutno glavni scenarij, za katerega ClickHouse se šteje za standardno rešitev. Časovne serije so niz časovno urejenih dogodkov, ki predstavljajo spremembe nekega procesa skozi čas. Na primer, to je lahko srčna frekvenca čez dan ali število procesov v sistemu. Vse, kar daje časovne tike z nekaterimi merjenji, je to časovnih serij:
Največ takih dogodkov prihaja iz monitoringa. To ni le monitoring spleta, temveč tudi realnih naprav: avtomobilov, industrijskih sistemov, IoT, proizvodnje ali brezpilotnih taksijev, v prtljažnikih katerih Yandex že zdaj postavlja ClickHouse-strežnik.
Na primer, obstajajo podjetja, ki zbirajo podatke s plovil. Vsake nekaj sekund senzorji s kontejnerskega plovila pošiljajo stotine različnih meritev. Inženirji jih proučujejo, gradijo modele in poskušajo razumeti, kako učinkovito plovilo uporablja, ker kontejnersko plovilo ne sme stati niti sekundo. Vsaka ustavitev je izguba denarja, zato je pomembno napovedati pot tako, da so postanki čim manjši.
Trenutno je opazen porast specializiranih podatkovnih baz, ki merijo časovnih serij. Na spletni strani DB-Engines kako na nek način rangirajo različne podatkovne baze, ki jih je mogoče gledati po vrstah:
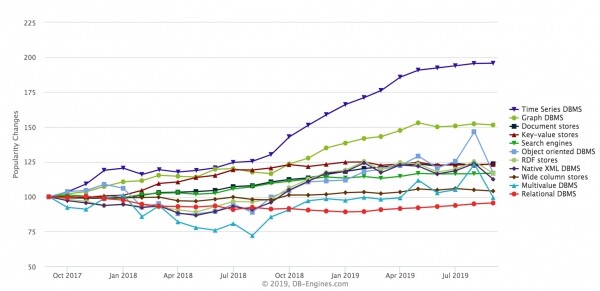
Najhitreje rastoča vrsta je time-series. Prav tako rastejo grafične podatkovne baze, vendar time-seriesrastejo hitreje v zadnjih letih. Tipični predstavniki te družine podatkovnih baz so InfluxDB, Prometheus, KDB, TimescaleDB (zgrajena na PostgreSQL), rešitve od Amazon. ClickHouse tukaj se lahko prav tako uporablja in se uporablja. Navedel bom nekaj javnih primerov.
Eden od pionirjev je podjetje CloudFlare (CDN-ponudnik). Oni spremljajo svoje CDN preko ClickHouse (DNS-poizvedbe, HTTP-poizvedbe) z ogromno obremenitvijo - 6 milijonov dogodkov na sekundo. Vse gre skozi Kafka, pošilja se v ClickHouse, ki omogoča v realnem času videti nadzorne plošče dogodkov v sistemu.
Comcast je eden vodilnih telekomunikacijskih podjetij v ZDA: internet, digitalna televizija, telefonija. Ustvarili so podobni sistem upravljanja CDN v okviru Open Source projekta Apache Traffic Control za delo s svojimi ogromnimi podatki. ClickHouse se uporablja kot backend za analitiko.
Percona so vgradili ClickHouse v svojo PMM, da shranijo monitoring različnih MySQL.
Specifične zahteve
K časovno serijskim podatkovnim bazam so specifične zahteve.
- Hitro vstavljanje iz mnogih agentov. Moramo zelo hitro vstaviti podatke iz mnogih tokov. ClickHouse dobro to dela, ker ni nobena od vstavitev blokirajoča. Vsaka insert je nova datoteka na disku, majhne vstavitve pa lahko tamponiramo na tak ali drugačen način. V ClickHouse je bolje vstaviti podatke v velikih paketih, namesto po eni vrstici.
- Fleksibilna shema. U časovnih serij Obično ne znamo strukturu podataka do kraja. Moguće je izgraditi sistem praćenja za određenu aplikaciju, ali tada je teško koristiti ga za drugu aplikaciju. Za to je potrebna fleksibilnija shema. ClickHouse, što to omogućava, iako je to strogo tipizirana baza.
- Efikasno skladištenje i "zaboravljanje" podataka. Obično u časovnih serij gigantskom obimu podataka, pa ih treba skladištiti maksimalno efikasno. Na primer, do InfluxDB dobra kompresija — to je njegova glavna karakteristika. Ali osim skladištenja, potrebno je još biti sposoban i "zaboraviti" stare podatke i raditi neki downsampling — automatsko računanje agregata.
- Brzi upiti agregiranih podataka. Ponekad je zanimljivo pogledati poslednjih 5 minuta sa preciznošću do milisekundi, ali kod mesečnih podataka, minuta ili sekunda granularnost možda nije potrebna — dovoljna je opšta statistika. Podrška ove vrste je potrebna, inače će upit za 3 meseca trajati veoma dugo čak i u ClickHouse.
- Upiti tipa "last point, as of». Ovo su tipični za časovnih serij upiti: gledamo poslednje merenje ili stanje sistema u trenutku t. Za baze podataka to nisu prijatni upiti, ali ih takođe treba biti moguće izvršiti.
- "Spajanje" vremenskih serija. Časovne serije — to je vremenska serija. Ako postoje dve vremenske serije, često ih treba spojiti i korrelirati. Ne na svim bazama podataka je to praktično raditi, posebno sa neusklađenim vremenskim serijama: ovde — jedan vremenski pečat, tamo — drugi. Moguće je izračunati proseke, ali tada će možda ostati rupa, pa to nije jasno.
Hajde da vidimo kako se ovi zahtevi ispunjavaju u ClickHouse.
Scheme
V ClickHouse shema za časovnih serij može se napraviti na različite načine, u zavisnosti od stepena regularnosti podataka. Može se izgraditi sistem na redovnim podacima, kada unapred znamo sve metrike. Na primer, tako je uradio CloudFlare sa praćenjem CDN — to je dobro optimizovan sistem. Moguće je izgraditi opštiji sistem koji prati celu infrastrukturu, različite servise. U slučaju neredovnih podataka, ne znamo unapred šta pratimo — i verovatno je to najopštiji slučaj.
Redovni podaci. Kolone. Šema je jednostavna – kolone sa potrebnim tipovima:
USTVARITE TABELO cpu (
  created_date Date DEFAULT today(),
  created_at DateTime DEFAULT now(),
  time String,
  tags_id UInt32,
  /* povezava na dim_tag */
  usage_user Float64,
  usage_system Float64,
  usage_idle Float64,
  usage_nice Float64,
  usage_iowait Float64,
  usage_irq Float64,
  usage_softirq Float64,
  usage_steal Float64,
  usage_guest Float64,
  usage_guest_nice Float64
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
To je običajna tabela, ki spremlja določeno aktivnost glede na obremenitev sistema (uporabnik, system, neaktiven, nice). Preprosto in udobno, vendar ne prožno. Če želimo bolj fleksibilno shemo, lahko uporabimo tabele.
Nerazporejeni podatki. Tabele:
USTVARITE TABELO cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  )
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);

IZBERITE max(metrics.value[indexOf(metrics.name,'usage_user')]) IZ ...
Struktura Vloženi — to sta dva seznama: metrics.name in metrics.value. Tukaj lahko shranjujemo takšne poljubne podatke o nadzoru, kot so seznam imen in seznam meritev pri vsakem dogodku. Za nadaljnjo optimizacijo namesto ene takšne strukture lahko ustvarimo več. Na primer, eno — za float-vrednosti, drugo — za int-vrednosti, ker int želimo shraniti bolj učinkovito.
Toda takšni strukturi je težje dostopati. Uporabiti bomo morali posebno konstrukcijo, s posebnimi funkcijami najprej izvleči vrednosti indeksa, nato pa iz seznama:
IZBERITE max(metrics.value[indexOf(metrics.name,'usage_user')]) IZ ...Ampak vseeno deluje dovolj hitro. Drug način shranjevanja nerazporejenih podatkov je po vrsticah.
Nerazporejeni podatki. Vrstice. V tem tradicionalnem načinu brez seznamov so shranjena takoj imena in vrednosti. Če z enega napravka pride takoj 5.000 meritev — se generira 5.000 vrstic v BД:
USTVARITE TABELO cpu_rlc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metric_name LowCardinality(String),
  metric_value Float64
) ENGINE = MergeTree(created_date, (metric_name, tags_id, created_at), 8192);


IZBERITE
    maxIf(metric_value, metric_name = 'usage_user'),
    ...
IZ CPU_R
KJER metric_name V ('usage_user', ...)
ClickHouse s tem se spopada — ima posebne razširitve ClickHouse SQL. Na primer, maxIf — posebna funkcija, ki izračuna največje vrednosti merila pri izpolnjevanju določenega pogoja. V enem poizvedovanju lahko napišete več takšnih izrazov in hkrati izračunate vrednost za več meril.
Primerjajmo tri pristope:
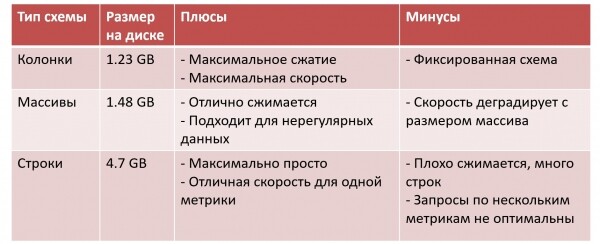
Tukaj sem dodal „Velikost podatkov na disku“ za nek nabor testnih podatkov. V primeru stolpcev imamo najmanjšo velikost podatkov: maksimalno stiskanje, maksimalna hitrost poizvedb, vendar plačamo tako, da moramo vse takoj zabeležiti.
V primeru matrik je malo slabše. Podatki se še vedno dobro stiskajo, prav tako lahko shranjujemo neregularno shemo. Ampak ClickHouse — je stolpčna baza podatkov, in ko začnemo shranjevati vse v matriko, se spremeni v nizovno, in plačamo za prilagodljivost z učinkovitostjo. Za vsako operacijo bo potrebno prebrati celo matriko v pomnilnik, nato pa poiskati ustrezen element — in če se matrika povečuje, se hitrost slabša.
V eni izmed podjetij, ki uporablja tak pristop (na primer, ), se matrike razrežejo na koščke po 128 elementov. Podatki več tisoč metrik z obsegom 200 TB podatkov/dan se ne shranjujejo v eni matriki, temveč v 10 ali 30 matrikah s posebno logiko za shranjevanje.
Najbolj preprost pristop — z nizi. A podatki se slabo stiskajo, velikost tabele postane velika, še posebej, ko poizvedbe potekajo po več metrikah, ClickHouse pa deluje neoptimizirano.
Hibridna shema
Predpostavimo, da smo izbrali shemo z matriko. Ampak če vemo, da večina naših nadzornikov prikazuje le metrike uporabnika in sistema, lahko iz matrike na ravni tabele materializiramo te metrike v stolpce na naslednji način:
CREATE TABLE cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  ),
  usage_user Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_user')],
  usage_system Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_system')]
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Pri vstavljanju ClickHouse jo bo avtomatsko preštelo. Tako lahko združimo prijetno s koristnim: shema je fleksibilna in splošna, a najbolj pogosto uporabljene stolpce smo izvlekli. Opozarjam, da to ni zahtevalo spremembe vstavljanja in ETL, ki še naprej vstavlja matrike v tabelo. Preprosto smo naredili ALTER TABLE, dodali nekaj stolpcev in dobili hibridno ter hitrejšo shemo, s katero lahko takoj začnemo uporabljati.
Kodeki in kompresija
Za časovnih serij je pomembno, kako dobro pakirate podatke, saj je lahko obseg informacij zelo velik. V ClickHouse obstaja niz orodij za dosego kompresijskega učinka 1:10, 1:20, včasih pa celo več. To pomeni, da nepokriti podatki v velikosti 1 TB na disku zavzamejo 50-100 GB. Manjša velikost je dobra, podatke je mogoče hitreje prebrati in obdelati.
Za dosego visoke ravni kompresije, ClickHouse podpira naslednje kodeke:
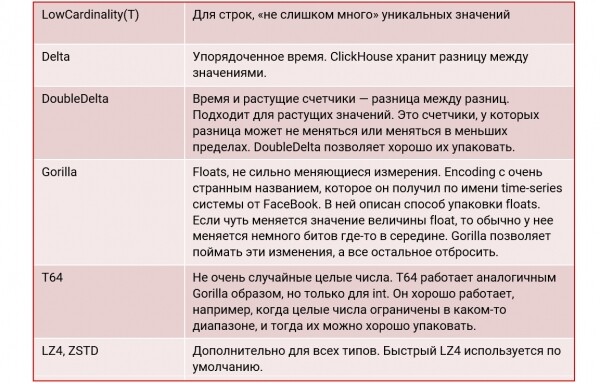
Primer tabele:
USTVARI TABELO benchmark.cpu_codecs_lz4 (
    created_date Date DEFAULT today(),
    created_at DateTime DEFAULT now() Codec(DoubleDelta, LZ4),
    tags_id UInt32,
    usage_user Float64 Codec(Gorilla, LZ4),
    usage_system Float64 Codec(Gorilla, LZ4),
    usage_idle Float64 Codec(Gorilla, LZ4),
    usage_nice Float64 Codec(Gorilla, LZ4),
    usage_iowait Float64 Codec(Gorilla, LZ4),
    usage_irq Float64 Codec(Gorilla, LZ4),
    usage_softirq Float64 Codec(Gorilla, LZ4),
    usage_steal Float64 Codec(Gorilla, LZ4),
    usage_guest Float64 Codec(Gorilla, LZ4),
    usage_guest_nice Float64 Codec(Gorilla, LZ4),
    additional_tags String DEFAULT ''
)
ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Tukaj definiramo kodek DoubleDelta v enem primeru, v drugem — Gorilla, in nujno dodamo še LZ4 kompresijo. Kot rezultat se velikost podatkov na disku močno zmanjša:
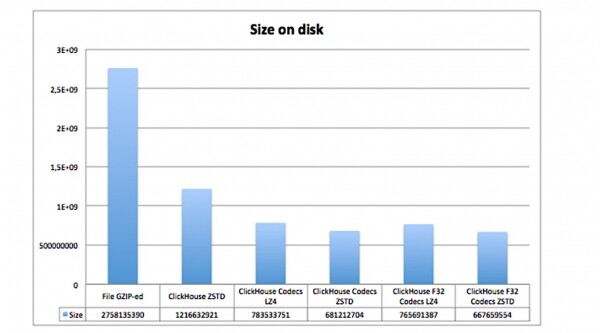
Tukaj je prikazano, koliko prostora zasedajo isti podatki, vendar ob uporabi različnih kodekov in kompresij:
- v GZIP-iranem datoteki na disku;
- v ClickHouse brez kodekov, ampak z ZSTD-kompresijo;
- v ClickHouse s kodeki in kompresijo LZ4 in ZSTD.
Očitno je, da tabele s kodeki zasedajo veliko manj prostora.
Velikost je pomembna
Prav tako je pomembno pravi tip podatkov:
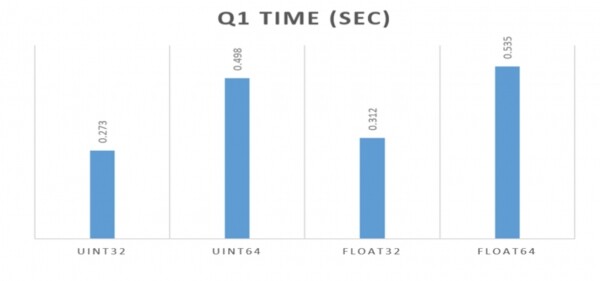
V vseh zgoraj navedenih primerih sem uporabil Float64. Ampak, če bi izbrali Float32, bi bilo to celo bolje. To so dobro pokazali fantje iz Perkone v članku na zgornji povezavi. Pomembno je uporabiti čim bolj kompaktno vrsto, primerno za nalogo: celo v manjšem obsegu za velikost na disku, kot za hitrost poizvedb. ClickHouse je temu zelo občutljivo.
Če lahko uporabite int32 namesto int64, pričakujte skoraj dvojno povečanje zmogljivosti. Podatki zasedajo manj pomnilnika, vsa 'aritmetika' deluje veliko hitreje. ClickHouse v njej — zelo strogo tipiziran sistem, izkorišča vse možnosti, ki jih ponujajo sodobni sistemi.
Agregacija in Materializirani pogledi
Agregacija in materializirani pogledi omogočajo kreiranje agregatov za različne primere rabe:
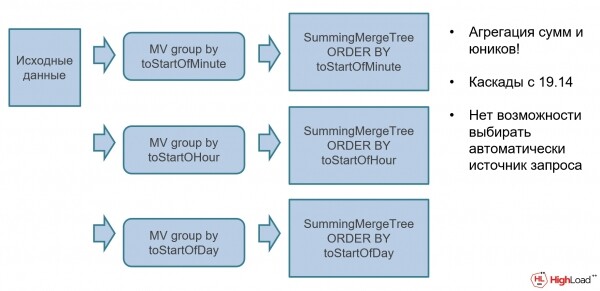
Na primer, lahko imate neagregirane izvorne podatke, na katere lahko povežete različne materializirane poglede z avtomatskim seštevanjem prek posebnega motorja. SummingMergeTree (SMT). SMT — je posebna agregacijska struktura podatkov, ki samodejno izračunava agregate. V podatkovno bazo se vstavijo surovi podatki, ti se samodejno agregirajo in takoj se lahko uporabljajo za nadzorne plošče.
TTL — 'pozabimo' stare podatke.
Kako 'pozabiti' podatke, ki niso več potrebni? ClickHouse to zna. Pri ustvarjanju tabel lahko navedete TTL izraze: na primer, da minutne podatke hranimo en dan, dnevne — 30 dni, tedenske ali mesečne pa nikoli ne obrezujemo:
USTVARI TABELO aggr_by_minute
…
TTL čas + interval 1 dan

USTVARI TABELO aggr_by_day
…
TTL čas + interval 30 dni

USTVARI TABELO aggr_by_week
…
/* brez TTL */
Multi-tier — ločujemo podatke po diskih.
Razvijamo to idejo, podatke lahko hranimo ClickHouse na različnih mestih. Recimo, da želimo shraniti vroče podatke za pretekli teden na zelo hitrem lokalnem SSD, medtem ko bolj zgodovinske podatke shranjujemo na drugem mestu. V ClickHouse je to zdaj mogoče:
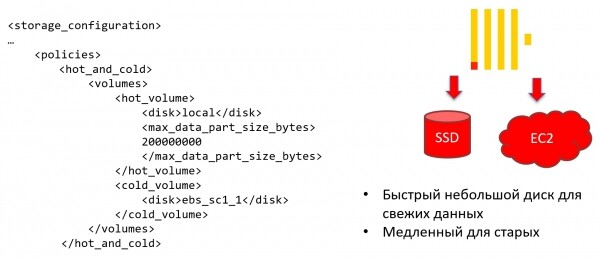
Lahko konfigurirate politiko shranjevanja (storage policy) tako, da ClickHouse samodejno premika podatke, ko so izpolnjeni določeni pogoji, v drugo skladišče.
Toda to še ni vse. Na ravni posamezne tabele lahko določite pravila, kdaj natančno po času podatki preidejo v hladno shranjevanje. Na primer, 7 dni podatki ležijo na zelo hitrem disku, vse, kar je starejše, pa se prenese na počasnejši. To je dobro, ker omogoča sistemu, da ohranja maksimalno zmogljivost, hkrati pa nadzoruje stroške in ne porablja sredstev za hladne podatke:
USTVARI TABELO
…
TTL datum + INTERVAL 7 DNI DO VOLUMNA 'cold_volume',
    datum + INTERVAL 180 DNI IZBRIŠI
Edinstvene možnosti ClickHouse
Skoraj povsod v ClickHouse so take 'čare', toda te se izničijo z ekskluzivnostjo — tistim, česar ni v drugih DB. Na primer, tukaj je nekaj edinstvenih funkcij ClickHouse:
- Matrike. U ClickHouse zelo dobra podpora za matrike ter možnost izvajanja zapletenih izračunov na njih.
- Agregacijske strukture podatkov. To je ena izmed 'killer features' ClickHouse. Kljub temu, da fantje iz Yandexa pravijo, da nočejo agregirati podatkov, vsi agregirajo v ClickHouse, ker je to hitro in priročno.
- Materializirani pogledi. Skupaj z agregatnimi podatkovnimi strukturami materializirane predstave omogočajo udobno real-time agregacijo.
- ClickHouse SQL. To je razširitev jezika SQL z nekaterimi dodatnimi in ekskluzivnimi funkcijami, ki so na voljo le v ClickHouse. Prej je bilo to nekako na eni strani razširitev, po drugi strani pa pomanjkljivost. Zdaj smo skoraj vse pomanjkljivosti v primerjavi z SQL 92 odpravili, zdaj je to le razširitev.
- Lambda–izrazi. Ali obstajajo še kje drugje v bazah podatkov?
- ML-podpora. To je na voljo v različnih DB, nekje bolje, nekje slabše.
- Otvoreni kod.. Lahko širimo ClickHouse skupaj. Zdaj je v ClickHouse približno 500 prispevnikov in to število se stalno povečuje.
Trikaste poizvedbe
V ClickHouse obstaja veliko različnih načinov za dosego istega. Na primer, lahko s tremi različnimi metodami vrnete zadnjo vrednost iz tabele za CPU (obstaja še četrta, a ta je še bolj eksotična).
Prvi prikazuje, kako enostavno je to narediti v ClickHouse poizvedbah, ko želite preveriti, kaj tupla je vključeno v podpoizvedbo. To je tisto, česar mi osebno zelo manjka v drugih DB. Če želim nekaj primerjati s podpoizvedbo, lahko v drugih DB primerjam samo skalar, medtem ko moram za več stolpcev pisati JOIN. U ClickHouse lahko uporabite tuple:
SELECT *
  FROM cpu
 WHERE (tags_id, created_at) IN
    (SELECT tags_id, max(created_at)
        FROM cpu
        GROUP BY tags_id)
Drugi način naredi isto, a uporablja agregatno funkcijo argMax:
SELECT
    argMax(usage_user), created_at),
    argMax(usage_system), created_at),
...
 FROM cpu
V ClickHouse obstaja več deset agregatnih funkcij, če pa uporabimo kombinatorje, jih bo po zakonih kombinatorike okoli tisoč. ArgMax je ena izmed funkcij, ki računa maksimalno vrednost: poizvedba vrne vrednost usage_user, pri kateri je dosežena maksimalna vrednost created_at:
SELECT now() as created_at,
       cpu.*
  FROM (SELECT DISTINCT tags_id from cpu) baza
  ASOF LEFT JOIN cpu USING (tags_id, created_at)
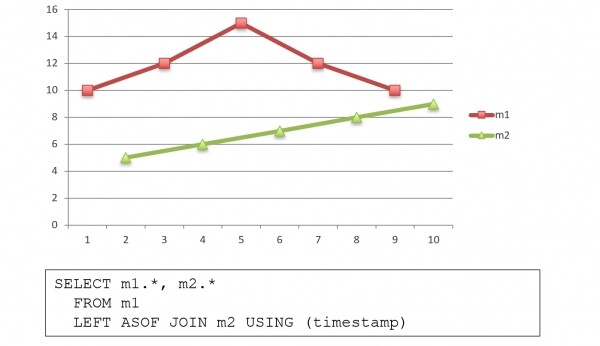
ASOF JOIN je »spajanje« vrstic z različnim časom. To je edinstvena funkcija za baze podatkov, ki jo ima še le kdb+. Če obstajata dva časovna niza z različnim časom, ASOF JOIN omogoča njihovo premikanje in spajanje v eni poizvedbi. Za vsak vrednost v enem časovnem nizu se najde najbližja vrednost v drugem in se vrne na isti vrstici:
Analitične funkcije
V standardu SQL-2003 lahko pišemo tako:
SELECT origin,
       timestamp,
       timestamp -LAG(timestamp, 1) OVER (PARTITION BY origin ORDER BY timestamp) AS duration,
       timestamp -MIN(timestamp) OVER (PARTITION BY origin ORDER BY timestamp) AS startseq_duration,
       ROW_NUMBER() OVER (PARTITION BY origin ORDER BY timestamp) AS sequence,
       COUNT() OVER (PARTITION BY origin ORDER BY timestamp) AS nb
  FROM mytable
ORDER BY origin, timestamp;
V ClickHouse to ni mogoče - ne podpira standarda SQL-2003 in verjetno tega nikoli ne bo. Namesto tega se ClickHouse običajno piše tako:
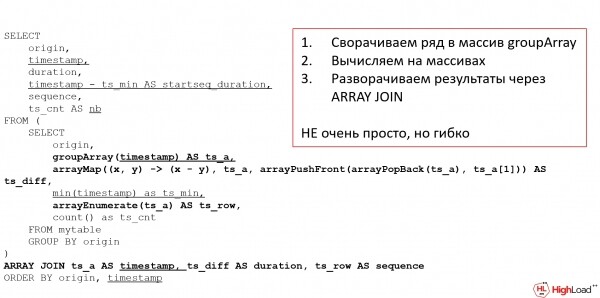
Obljubil sem lambda funkcije - tukaj so!
To je ekvivalent analitičnega poizvedovanja po standardu SQL-2003: izračuna razliko med dvema timestamp, duration, zaporedno število - vse, kar običajno štejemo kot analitične funkcije. V ClickHouse mi jih štejem skozi nize: najprej podatke združimo v niz, nato pa na nizu naredimo vse, kar želimo, in pozneje spet razdelimo. To ni zelo priročno, zahteva ljubitelja funkcionalnega programiranja, vsaj, ampak je zelo fleksibilno.
Posebne funkcije
Poleg tega v ClickHouse je veliko specializiranih funkcij. Na primer, kako določiti, koliko sej poteka hkrati? Tipična naloga za spremljanje je določitev največje obremenitve z enim poizvedovanjem. V ClickHouse obstaja posebna funkcija za to:
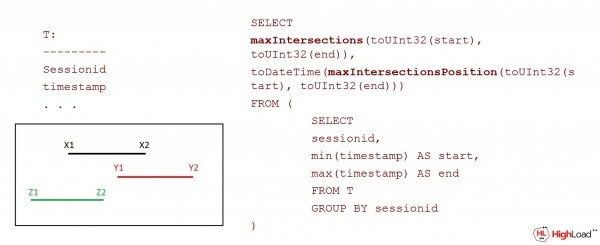
Na splošno, za mnoge cilje v ClickHouse obstajajo posebne funkcije:
- runningDifference, runningAccumulate, neighbor;
- sumMap(key, value);
- timeSeriesGroupSum(uid, timestamp, value);
- timeSeriesGroupRateSum(uid, timestamp, value);
- skewPop, skewSamp, kurtPop, kurtSamp;
- WITH FILL / WITH TIES;
- simpleLinearRegression, stochasticLinearRegression.
To ni celoten seznam funkcij, vseh je 500-600. Namig: vse funkcije v ClickHouse so v sistemski tabeli (ne vse so dokumentirane, a vse so zanimive):
select * from system.functions order by nameClickHouse sam v sebi hrani veliko informacij o sebi, vključno z log tables, query_log, log sledenja, log operacij z blokom podatkov (part_log), log metrik in sistemski log, ki ga običajno zapisuje na disk. Log metrik - to je časovnih serij u ClickHouse pravzaprav ClickHouse: Baza podatkov sama lahko igra vlogo časovnih serij baz podatkov, tako da »požira« samo sebe.
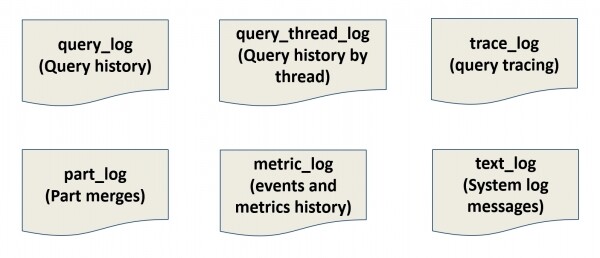
To je tudi edinstvena stvar - ker dobro opravljamo delo za časovnih serij, zakaj ne moremo vsega potrebnega shraniti v sebi? Ne potrebujemo Prometheus, vse shranjujemo v sebi. Povezali smo Grafana in sami sebe spremljamo. Vendar, če ClickHouse pade, tega ne bomo videli - zakaj, - zato tega običajno ne počnemo.
Velik grozd ali veliko majhnih ClickHouse
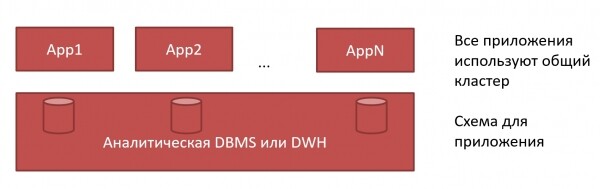
Kaj je boljše - en velik grozd ali veliko majhnih ClickHouse? Tradicionalni pristop k DWH — to je veliki klaster, u kojem se izdvajaju sheme za svaku aplikaciju. Obratili smo se administratoru baze podataka — dajte nam shemu, i dobili smo je:
V ClickHouse može se to uraditi drugačije. Svakoj aplikaciji može se napraviti vlastita ClickHouse:
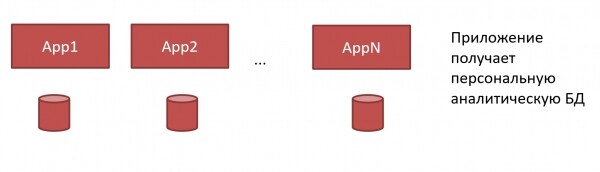
Više nam nije potreban veliki monstruozni DWH i nesaglasni administratori. Svakoj aplikaciji možemo izdati svoju ClickHouse, i programer to može učiniti sam, jer ClickHouse veoma se lako instalira i ne zahteva složeno administriranje:
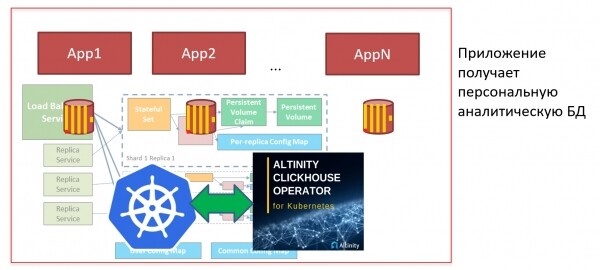
Ali ako imamo mnogo ClickHouse, i ako ga često instaliramo, želimo da automatizujemo taj proces. Na primer, možemo koristiti Kubernetes in clickhouse-operator. U Kubernetes ClickHouse može se instalirati ‘jednim klikom’: mogu da pritisnem dugme, pokrenem manifest i baza je spremna. Odmah možemo napraviti shemu, početi da učitavamo metrike, i za 5 minuta već imam gotov dashboard Grafana. Tako je sve jednostavno!
Kaj na koncu?
Dakle, ClickHouse je:
- Hitro. To je svima poznato.
- Jednostavno. Malo je spornog, ali smatram da je teško u učenju, lako u borbi. Ako shvatite kako ClickHouse radi, dalje je sve veoma jednostavno.
- Univerzalno. Odgovara različitim scenarijima: DWH, Time Series, Log Storage. Ali to nije OLTP baza podataka, pa nemojte pokušavati da radite kratke umetanja i čitanja.
- Interesantno. Verovatno je onaj ko radi sa ClickHouse, doživeo mnogo zanimljivih trenutaka u dobrom i lošem smislu. Na primer, objavljen je novi izdanak, sve je prestalo da funkcioniše. Ili kada ste se borili sa zadatkom dva dana, ali nakon pitanja u Telegram čatu, zadatak je rešen za dve minute. Ili kao na konferenciji, na predavanju Alekse Milovidova da je snimak iz ClickHouse pokidao prenos HighLoad++. Ovako nešto se dešava neprekidno i čini naš život sa ClickHouse živopisnim i zanimljivim!
Prezentaciju možete pogledati .
Dugo očekivani sastanak programera visokonaprednih sistema na održaće se 9. i 10. novembra u Skolkovu. Konačno će to biti offline konferencija (iako uz poštovanje svih mera opreza), jer energiju HighLoad++ nije moguće pakovati u online.
Za konferenciju nalazimo i prikazujemo vam slučajeve o maksimalnim mogućnostima tehnologija: HighLoad++ je bio, jeste i biće jedinstveno mesto gde možete za dva dana saznati kako funkcionišu Facebook, Yandex, Vkontakte, Google i Amazon.
Od 2007. godine održavamo naše sastanke bez prekida, a ove godine susrećemo se po četrnaesti put. Tokom tog vremena, konferencija je porasla deset puta; prošle godine je ključni događaj industrije okupio 3339 učesnika, 165 govornika i simultano se održavalo 16 sesija.
Prošle godine bilo je 20 autobusa, 5280 litara čaja i kafe, 1650 litara voćnih napitaka i 10200 flašica vode. Takođe, 2640 kilograma hrane, 16000 tanjira i 25000 čašica. Usput, novac zarađen od recikliranog papira iskoristili smo za sadnju 100 sadnica hrasta 🙂Ulaznice se mogu kupiti , da biste dobili vesti o konferenciji — , a da porazgovarate — na svim društvenim mrežama: , , in .
Izvor: habr.com
