

Kako backend razvijalec razume, da bo SQL poizvedba dobro delovala na 'produ'? V velikih ali hitro rastočih podjetjih dostop do 'produ' ni na voljo vsem. In tudi z dostopom ni mogoče brez težav preveriti vseh poizvedb, saj ustvarjanje kopije baze podatkov pogosto traja ure. Da bi rešili te težave, smo ustvarili umetnega DBA - Joe. Že je uspešno implementiran v več podjetjih in pomaga ne samo desetim razvijalcem.
Video:
Pozdravljeni! Moje ime je Anatoli Stanler. Delam v podjetju . Ukvarjamo se s tem, da pospešujemo proces razvoja, odpravljamo zamude, povezane z delom Postgresa, za razvijalce, DBA in QA.
Imamo odlične stranke in del našega predavanja bo posvečen primerom, s katerimi smo se srečali pri delu z njimi. Povedal vam bom, kako smo jim pomagali rešiti kar precej resne težave.
Ko izvajamo razvoj in delamo kompleksne obremenitvene migracije, si postavljamo vprašanje: 'Bo ta migracija uspela?'. Uporabljamo preglede, z znanjem bolj izkušenih kolegov, DBA strokovnjakov. In oni lahko povedo - bo uspela ali ne.
Ampak morda bi bilo bolje, če bi to lahko sami testirali na polno delujočih kopijah. In danes bomo govorili o tem, kakšni so zdaj pristopi k testiranju in kako to narediti bolje ter s pomočjo katerih orodij. Prav tako se bomo pogovorili o prednostih in slabostih teh pristopov ter kaj lahko tukaj izboljšamo.
Kdo je kdaj delal indekse ali uvajal kakšne spremembe neposredno na produ? Kar precej jih je. A kolikokrat je to povzročilo izgubo podatkov ali izpad storitev? Potem poznate to bolečino. Hvala bogu, da imamo varnostne kopije.
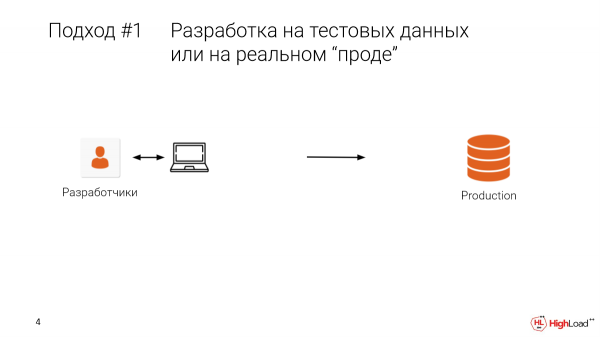
Prvi pristop je testiranje na produ. Ali ko razvijalec sedi na svojem lokalnem računalniku, ima testne podatke, neko omejeno izbiro. In jo potem uvedemo na produ, in dobimo takšno situacijo.
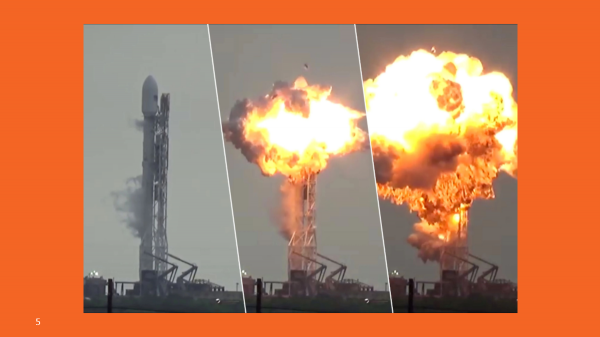
To boli, to je drago. Verjetno je tako bolje ne delati.
Kako narediti bolje?
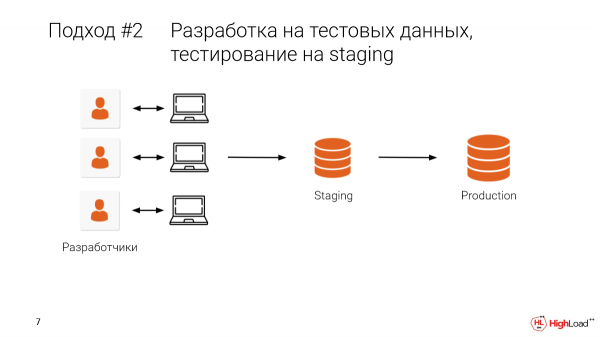
Poglejmo staging in izločimo del produkcije. Ali v najboljšem primeru vzamemo pravi prod, vse podatke. In potem, ko smo lokalno razvili, dodatno preverimo še na stagingu.
To nam bo omogočilo, da odpravimo del napak in preprečimo napake na produ.
Kakšne so težave?
- Težava je v tem, da ta staging delimo s kolegi. In zelo pogosto se zgodi, da narediš kakšno spremembo, bum – in podatkov ni, delo je zaman. Staging je bil večterabaiten. In dolgo je trajalo, da se je ponovno dvignil. Zato se odločimo, da bomo to dokončali jutri. Vse, razvoj je ustavljen.
- Seveda pa tam dela veliko kolegov, veliko ekip. In treba je ročno usklajevati. To pa je neprijetno.
Povedati je treba, da imamo samo en poskus, en strel, če želimo vnesti kakšne spremembe v bazo podatkov, manipulirati s podatki, spremeniti strukturo. In če gre kaj narobe, če je pri migraciji prišlo do napake, se hitro ne bomo mogli vrniti nazaj.
To je boljše od prejšnjega pristopa, a še vedno obstaja velika verjetnost, da bo kakšna napaka šla v produkcijo.
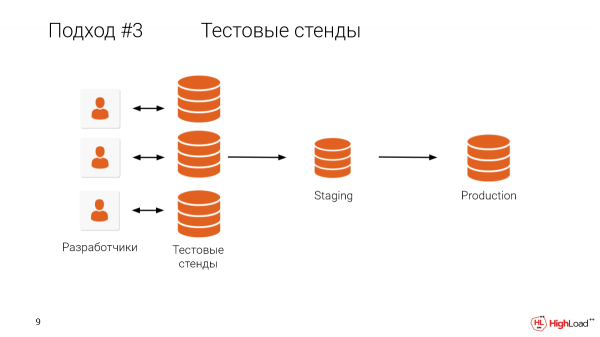
Kaj nam preprečuje, da vsakemu razvijalcu damo testno okolje, polno velikost kopije? Mislim, da je jasno, kaj ovira.
Kdo ima bazo podatkov večjo od terabajta? Večina v dvorani.
In jasno je, da je vzdrževanje naprav za vsakega razvijalca, ko je produkcija tako velika, zelo drago, poleg tega pa traja dolgo.
Imamo stranke, ki so spoznale, da je zelo pomembno testirati vse spremembe na popolni kopiji, vendar imajo bazo manjšo od terabajta, virov pa, da bi za vsakega razvijalca imeli testno okolje, nimajo. Zato morajo prenesti dumping datoteke na svoje lokalne računalnike in testirati na ta način. To vzame ogromno časa.
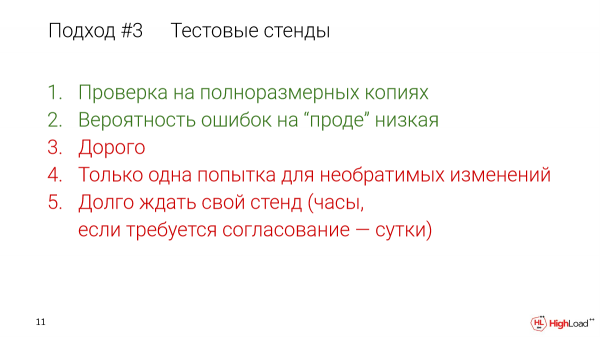
Tudi če to delate znotraj infrastrukture, je prenos enega terabajta podatkov na uro že zelo dobro. A oni uporabljajo logične dump-e, prenašajo lokalno iz oblaka. Zanje je hitrost okoli 200 gigabajtov na uro. In potrebujemo tudi čas, da se iz logičnega dump-a razreši, naloži indekse itd.
Ampak ta pristop uporabljajo, ker im omogoča, da ostane produkcija zanesljiva.
Kaj lahko tukaj naredimo? Ustvarimo najcenejše testne steze in vsakemu razvijalcu damo svoj lasten testni stez.
To je mogoče.
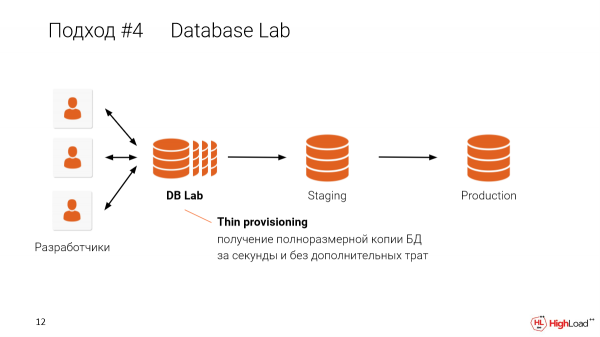
In this approach, when we create thin clones for each developer, we can share it on a single machine. For example, if you have a four terabyte database and want to provide it to 10 developers, you don't need to have 10 times four terabyte databases. One machine is enough to create thin isolated copies for each developer using a single machine. I'll explain how this works a bit later.
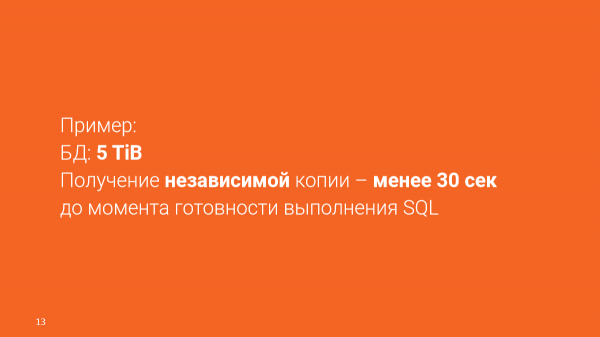
A real example:
The database is 4.5 terabytes.
We can obtain independent copies in 30 seconds.
You don't need to wait for a testing environment or depend on its size. You can get it in seconds. It will be completely isolated environments, but they share data among themselves.
That's cool. Here we're talking about magic and a parallel universe.
In our case, this works using the OpenZFS system.
OpenZFS is a copy-on-write file system that natively supports snapshots and clones. It is reliable and scalable. It's very easy to manage. You can deploy it with just two commands.
There are other options:
LVM,
Storage array (e.g., Pure Storage).
The Database Lab I'm talking about is modular. It can be implemented using such options. But for now, we've focused on OpenZFS because there were specific issues with LVM.
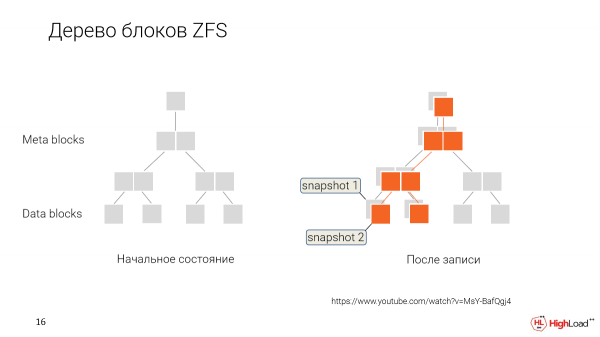
How does it work? Instead of rewriting the data every time we change it, we save it, simply marking that these new data correspond to a new point in time, to a new snapshot.
And later, when we want to roll back or create a new clone from some older version, we just say: 'Okay, give us those blocks of data that are marked this way.'
And this user will work with that set of data. They will gradually modify it, create their snapshots.
And we will have branching. Each developer will have the opportunity to have their own clone that they edit, while the data that is common will be shared among all.
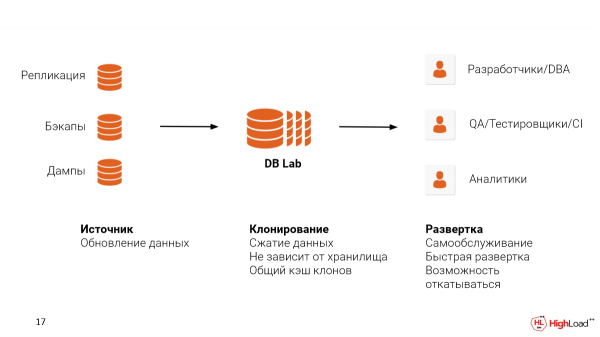
To deploy such a system, two issues need to be resolved:
Prvi je izvor podataka iz kojeg ćete ih uzimati. Možete postaviti replikaciju s produkcijom. Možete koristiti već postojeće rezervne kopije, nadam se. WAL-E, WAL-G ili Barman. I čak, ako koristite neko Cloud rešenje, poput RDS-a ili Cloud SQL-a, možete koristiti logičke dumpove. Ali svakako vam savetujemo da koristite rezervne kopije, jer će vam ovaj pristup omogućiti očuvanje fizičke strukture fajlova, što će vas dovesti bliže metrima koje biste videli na produkciji, kako biste uhvatili probleme koji postoje.
Drugi je mesto gde želite da hostujete Database Lab. To može biti Cloud, može biti On-premise. Ovde je važno reći da ZFS podržava kompresiju podataka. I to jako dobro radi.
Zamislite da će svaki takav klon, u zavisnosti od operacija koje radimo s bazom, akumulirati neki dev. Za taj dev će takođe biti potrebno mesto. Ali s obzirom na to da smo uzeli bazu od 4,5 terabajta, ZFS će je kompresovati na 3,5 terabajta. U zavisnosti od podešavanja, to se može varirati. A mi ćemo imati i mesto za dev.
Ovakav sistem se može koristiti za različite slučajeve.
To su developeri, DBA za proveru upita, za optimizaciju.
Može se koristiti u QA testiranju za proveru određene migracije pre nego što to pustimo u prod. Takođe, možemo podići posebne okruženje za QA sa realnim podacima, gde mogu testirati novu funkcionalnost. I to će trajati sekunde umesto da čekate sate, a možda čak i dane u nekim drugim slučajevima gde se tanki klonovi ne koriste.
I još jedan poseban slučaj. Ako u kompaniji nije postavljen sistem analitike, možemo izdvojiti tanki klon proizvodne baze i predati ga za duge upite ili za posebne indekse koji se mogu koristiti u analitici.
S ovakvim pristupom:
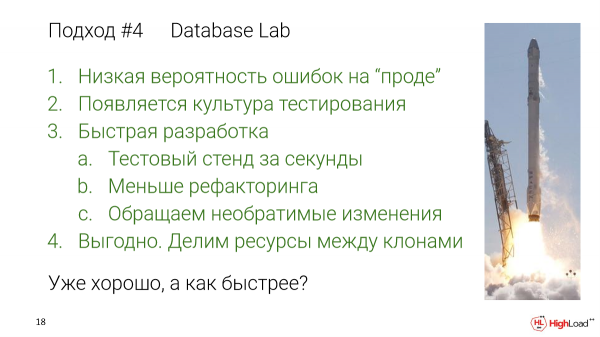
Niska verovatnoća grešaka na „produkciji“, jer smo sve promene testirali na punim podacima.
Pojavljuje nam se kultura testiranja, pošto više nije potrebno satima čekati svoj vlastiti sto.
I nema prepreka, nema čekanja između testiranja. Stvarno možete otići i proveriti. I biće bolje, jer ćemo ubrzati razvoj.
Bodo bo manj refaktoringa. Manj napak bo prispelo v prod. Manj jih bomo kasneje refaktorirali.
Lahko se vračamo na nepovratne spremembe. To v standardnih pristopih ni mogoče.
- To je koristno, ker delimo vire testnih okolij.
Že je dobro, kaj bi še lahko pospešili?
Zahvaljujoč takšni sistemu lahko močno znižamo prag vstopa v to testiranje.
Trenutno obstaja začaran krog, kjer mora razvijalec, da dobi dostop do pravih popolnih podatkov, postati strokovnjak. Mora mu biti zaupan ta dostop.
Ampak kako rasti, če tega ni. Kaj pa, če imaš na voljo samo zelo majhen nabor testnih podatkov? Potem ne moreš pridobiti prave izkušnje.
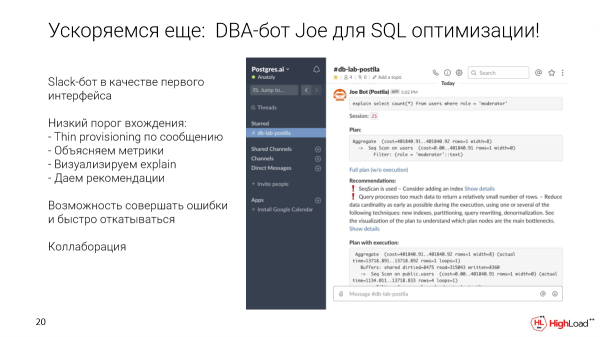
Kako priti iz tega kroga? Kot prvi vmesnik, prijazen za razvijalce vseh ravni, smo izbrali Slack-bota. Ampak to je lahko katerikoli drug vmesnik.
Kaj omogoča? Lahko vzamete določen poizvedbo in jo pošljete v poseben kanal za podatkovno bazo. Samodejno bomo v nekaj sekundah izvedli tanko kloniranje. Izvršili to poizvedbo. Zbrali meritev in priporočila. Prikazali vizualizacijo. In ta klon bo ostal, da bo možno optimizirati to poizvedbo, dodati indekse itd.
In Slack nam ponuja možnosti za sodelovanje kar iz samega začetka. Ker je to preprosto kanal, lahko tam v threadu za to poizvedbo začnete razpravljati o tej poizvedbi, pingate svoje kolege, DBA, ki so v podjetju.
Toda seveda obstajajo tudi težave. Ker je to resnični svet, in uporabljamo strežnik, na katerem gostimo več klonov hkrati, smo primorani skrčiti količino pomnilnika in procesorske moči, ki so na voljo klonom.
Toda, da so ti testi verodostojni, moramo na nek način rešiti to težavo.
Jasno je, da je pomemben trenutek enakost podatkov. Ampak to že imamo. In želimo doseči enako konfiguracijo. Takšno praktično enako konfiguracijo lahko zagotovimo.
Super bi bilo imeti enako strojno opremo kot na produkciji, vendar se lahko ta razlikuje.
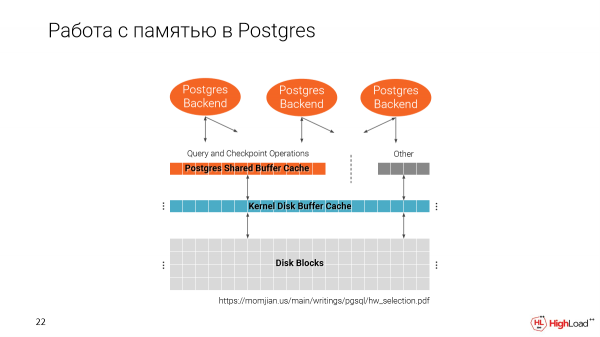
Poglejmo, kako Postgres deluje s pomnilnikom. Imamo dve predpomnilni, eno od datotečnega sistema in eno lastno Postgres, tj. Shared Buffer Cache.
Pomembno je opozoriti, da se Shared Buffer Cache alocira ob zagonu Postgresa, odvisno od velikosti, ki jo nastavite v konfiguraciji.
Drugi predpomnilnik pa uporablja ves razpoložljiv prostor.
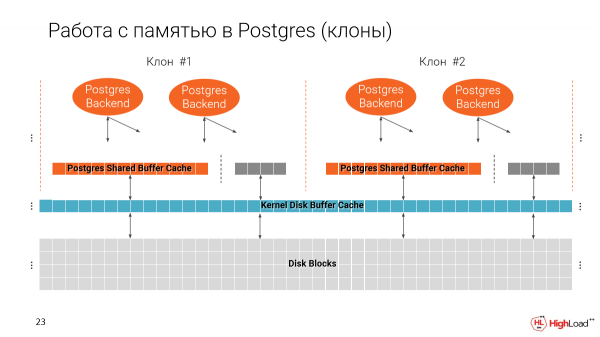
Ko pa na eni napravi ustvarimo več klonov, postopoma napolnimo pomnilnik. Na splošno naj bi bil Shared Buffer Cache 25 % celotne količine pomnilnika, ki je na voljo na napravi.
Tako, če ne spremenimo tega parametra, bomo na eni napravi lahko zagnali le 4 instance, torej 4 take tanke klone. To pa ni dobro, ker si želimo imeti veliko več.
Po drugi strani pa se Buffer Cache uporablja za izvajanje poizvedb, za indekse, torej načrt je odvisen od velikosti naših predpomnilnikov. Če ta parameter preprosto zmanjšamo, se lahko načrti močno spremenijo.
Na primer, če imamo v produkciji velik predpomnilnik, bo Postgres raje uporabljal indeks. Če pa ga ni, bo uporabljen SeqScan. Kakšen smisel bi imel, če se ti načrti ne bi ujemali?
Pri tem pridemo do spoznanja, da načrt v Postgresu ni odvisen od specifično nastavljene velikosti Shared Buffer v načrtu, temveč od effective_cache_size.
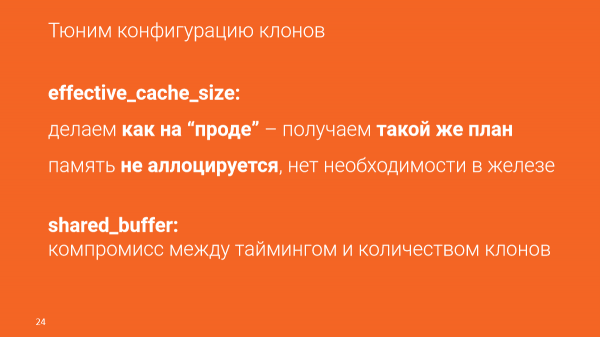
Effective_cache_size je predvidena količina predpomnilnika, ki je na voljo, torej vsota Buffer Cache in predpomnilnika datotečnega sistema. To je določeno s konfiguracijo. In ta pomnilnik ni alociran.
Zaradi tega parametra lahko 'prevaramo' Postgres, da rečemo, da imamo na voljo veliko podatkov, tudi če jih dejansko nimamo. Tako bodo načrti popolnoma usklajeni s produkcijo.
To pa lahko vpliva na časovno učinkovitost. Optimiziramo poizvedbe glede na čas, vendar je pomembno, da časovna učinkovitost odvisna od mnogih dejavnikov:
Odvisna je od obremenitve, ki trenutno obstaja v produkciji.
Odvisna je od značilnosti same naprave.
To je posreden parameter, vendar lahko dejansko optimiziramo glede na količino podatkov, ki jih bo ta poizvedba prebrala, da dosežemo rezultat.
In če želite, da je časovno usklajevanje čim bližje tistemu, kar bomo videli v produkciji, potem moramo vzeti opremo, ki je čim bolj podobna, in morda celo več, da bodo vsi kloni sprejeti. Ampak to je kompromis, tj. dobili boste take načrte, videli boste, koliko podatkov prebere določen poizvedba in boste lahko sklepali – ali je ta poizvedba dobra (ali migracija) ali slaba, potrebno jo je še optimizirati.
Poglejmo, kako konkretno z Joe poteka optimizacija.
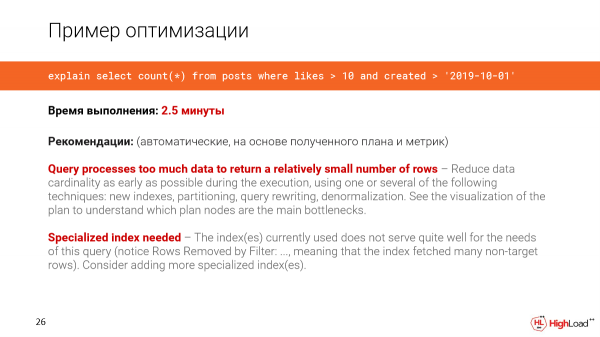
Vzamemo poizvedbo iz resničnega sistema. V tem primeru je baz podatkov – 1 terabajt. In želimo prešteti število svežih objav, ki so prejele več kot 10 všečkov.
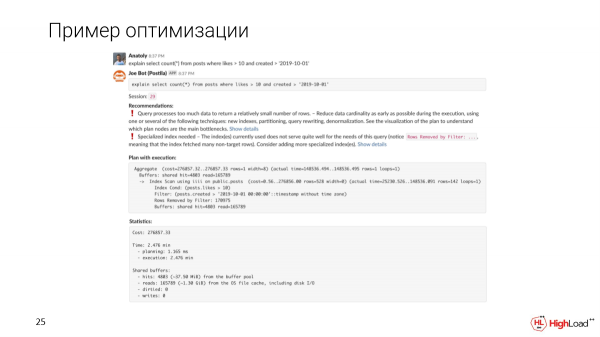
Pošljemo sporočilo v kanal, klon se je razvil za nas. In videli bomo, da bo takšna poizvedba izvedena v 2,5 minutah. To je prvo, kar bomo opazili.
Joe bo prikazal samodejna priporočila, temelječa na načrtu in metričnih podatkih.
Videli bomo, da poizvedba obdeluje preveč podatkov, da bi dobili razmeroma majhno število vrstic. Potreben je nek specializiran indeks, saj smo opazili, da je v poizvedbi preveč filtriranih vrstic.
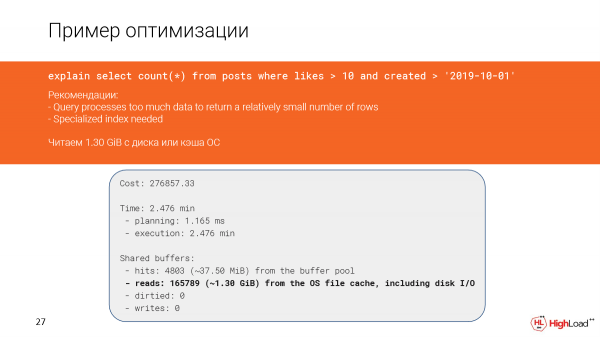
Poglejmo podrobneje, kaj se je zgodilo. Res vidimo, da smo prebrali skoraj en in pol gigabajta podatkov iz datotečnega predpomnilnika ali celo z diska. In to ni dobro, ker smo dobili le 142 vrstic.
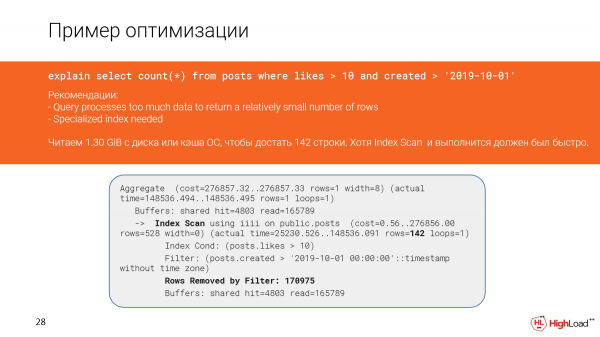
In na videz imamo tukaj indeksno analizo, ki bi morala delovati hitro, ampak ker smo filtrirali preveč vrstic (morali smo jih prešteti), je poizvedba delovala počasi.
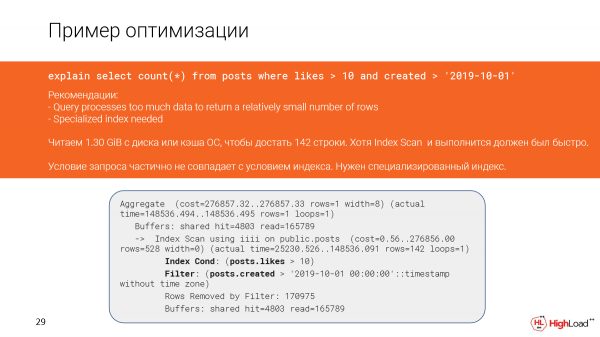
In to se je zgodilo v načrtu, ker deloma niso ujemali pogoji v poizvedbi in pogoji v indeksu.
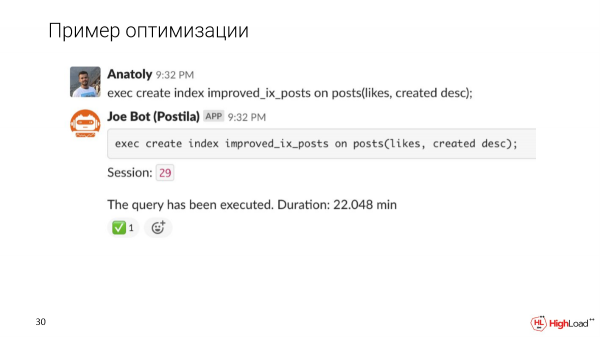
Poskusimo narediti indeks bolj natančen in poglejmo, kako se bo izvedba poizvedbe spremenila po tem.
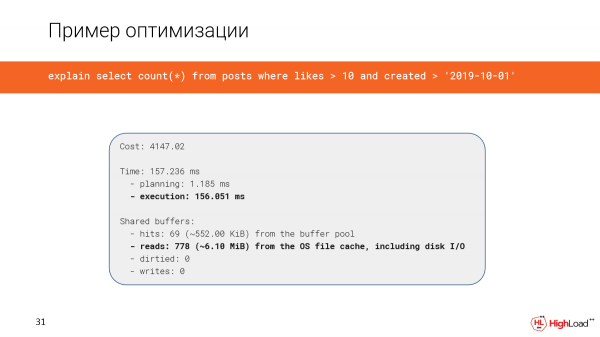
Ustvarjanje indeksa je vzelo precej časa, ampak zdaj preverjamo poizvedbo in vidimo, da se je čas namesto 2,5 minut zmanjšal na samo 156 milisekund, kar je precej dobro. In preberemo le 6 megabajtov podatkov.
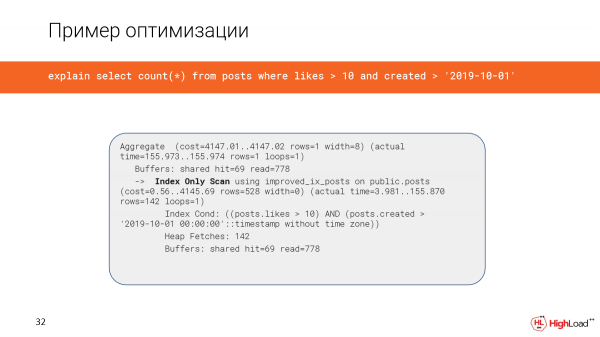
In zdaj imamo uporabljen indeksni samo analizo.
Druga pomembna zgodba je, da želimo načrt predstaviti na bolj razumljiv način. Uvedli smo vizualizacijo z uporabo Flame Graphs.
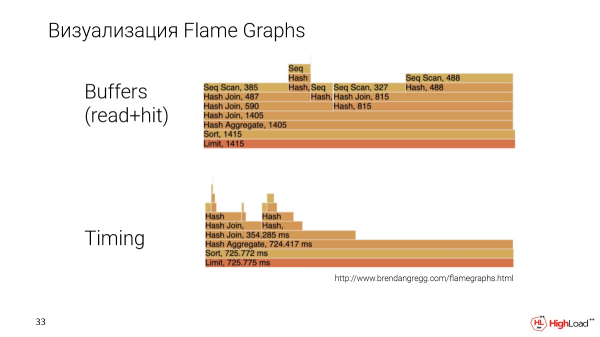
To je druga poizvedba, bolj kompleksna. In Flame Graphs gradimo na dveh parametrih: to je količina podatkov, ki jih je konkretna vozlišče v načrtu prebrala, in čas, tj. čas izvajanja vozlišča.
Tukaj lahko specifično primerjamo vozlišča med seboj. Tako bo jasno, katero od njih jemlje več ali manj prostora, kar je običajno težko ugotoviti pri drugih načinih vizualizacije.
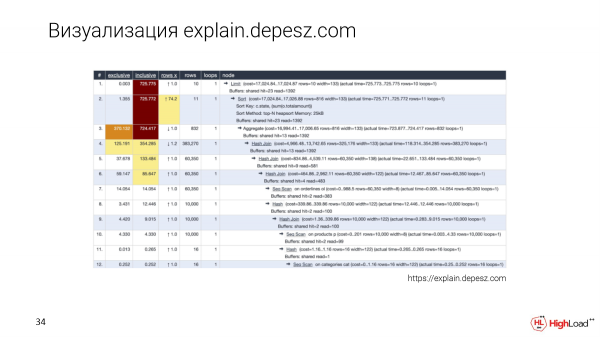
Seveda, vsi poznajo explain.depesz.com. Dober atribut te vizualizacije je, da shranimo besedilni načrt in tudi izpostavimo nekatere glavne parametre v tabelo, da jih lahko razvrstimo.
In razvijalci, ki se še niso podrobno ukvarjali s to temo, prav tako uporabljajo explain.depesz.com, saj jim tako lažje razjasniti, katere metrike so pomembne in katere ne.
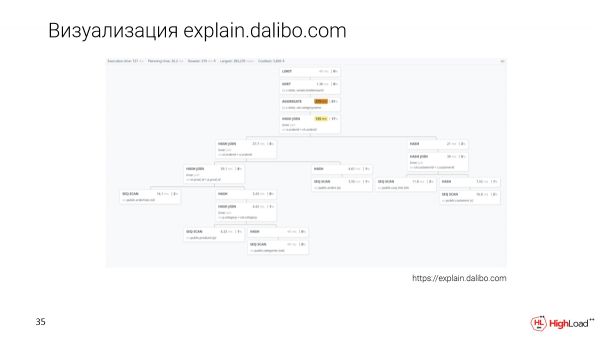
Obstaja nov pristop k vizualizaciji – to je explain.dalibo.com. Ustvarjajo drevesno vizualizacijo, vendar tukaj zelo težko primerjate vozlišča med seboj. Tu lahko dobro razumete strukturo, res pa je, da se pri večjem poizvedovanju morate pomikati naprej in nazaj, a je to tudi ena od možnosti.
Sodelovanje
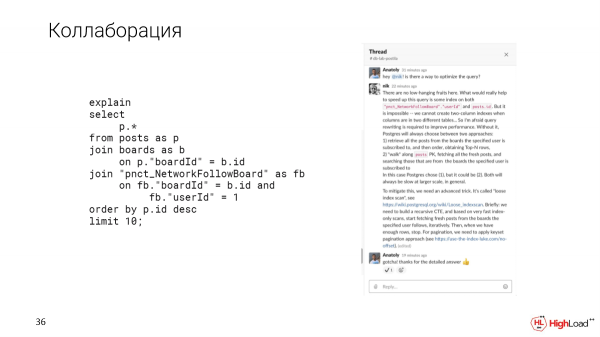
In kot sem že omenil, nam Slack omogoča sodelovanje. Na primer, če naletimo na zapleteno poizvedbo, ki je ne vemo, kako optimizirati, lahko to vprašanje pojasnimo v threadu v Slacku s svojimi kolegi.
Menimo, da je pomembno testirati na celotnih podatkih. Zato smo ustvarili orodje Update Database Lab, ki je na voljo kot odprta koda. Uporabite lahko tudi bota Joe. Lahko ga vzamete takoj in ga uvedete pri sebi. Vsi vodiči so tam na voljo.
Pomembno je tudi omeniti, da to rešitev sama po sebi ni revolucijska, saj obstaja Delphix, ampak to je rešitev za velika podjetja. Je popolnoma zaprta in zelo draga. Osredotočamo se na Postgres. To so vsi izdelki odprtokodnega značaja. Pridružite se nam!
S tem končujem. Hvala!
Vprašanja
Pozdravljeni! Hvala za predstavitev! Zelo zanimivo, še posebej zame, ker sem podobno nalogo reševal pred nekaj časa. Zato imam vrsto vprašanj. Upam, da bom vsaj del vprašal.
Zanima me, kako izračunate prostor za to okolje? Tehnologija predvideva, da se lahko vaši kloni v nekaterih okoliščinah povečajo do največje velikosti. Na grobo rečeno, če imate deset terabajtno bazo in 10 klonov, lahko enostavno simulirate situacijo, kjer vsak klon zasede 10 unikatnih podatkov. Kako izračunate ta prostor, torej razliko, o kateri ste govorili, v kateri bodo živeli ti kloni?
Dober vprašaj. Pomembno je, da spremljamo konkretne klone. In če se nek klon preveč spremeni in začne rasti, lahko najprej uporabniku izdamo opozorilo glede tega, ali pa takoj ustavimo ta klon, da ne pride do fail situacije.
Da, imam še eno vprašanje. T. j. kako zagotavljate življenjski cikel teh modulov? To je pri nas težava in cela zgodba. Kako to poteka?
Vsak klon ima nek TTL. Na splošno imamo določen TTL.
Kateri, če ni skrivnost?
1 ura, t. j. idle – 1 ura. Če se ne uporablja, ga uničimo. Toda tukaj ni nobenega presenečenja, saj lahko klon vzpostavimo v nekaj sekundah. In če ga potrebujemo znova, ni težav.
Tudi mene zanima izbira tehnologij, saj mi uporabljamo več metod iz različnih razlogov. Zakaj ravno ZFS? Zakaj niste uporabili LVM? Omenili ste, da ste imeli težave z LVM. Katere težave so bile? Po mojem mnenju je najbolj optimalna izbira SAN, glede na zmogljivost.
Kakšna je glavna težava z ZFS? Da moraš teči na enem gostitelju, t. j. vsi inštanci bodo živeli v okviru enega operacijskega sistema. V primeru SAN lahko priključite različno opremo. In ozka mesta so samo tisti bloki, ki so na SAN. In zanimivo je vprašanje izbire tehnologij. Zakaj ne LVM?
O LVM lahko konkretno spregovorimo na meetup-u. Glede SAN – to je preprosto drago. Sistem ZFS lahko uvedemo kjer koli. Lahko ga razpnete na svoji napravi. Preprosto lahko prenesete repozitorij in ga razpnete. ZFS je skoraj povsod nameščen, če govorimo o Linuxu. T. j. dobimo zelo fleksibilno rešitev. In sam ZFS že iz škatle ponuja zelo veliko. Lahko nalagate neomejeno količino podatkov, priključite veliko število diskov, imamo posnetke. In, kot sem že omenil, ga je preprosto upravljati. Zdi se zelo prijeten za uporabo. Je preverjen, obstaja že vrsto let. Ima zelo veliko skupnost, ki se širi. ZFS je zelo zanesljiva rešitev.
Nikolaj Samohvalov: Lahko še komentiram? Ime mi je Nikolaj, skupaj z Anatolijem delava. Strinjam se, da je SAN odličen. In nekateri naši kupci imajo Pure Storage itd.
Anatoliy rightly noted that we are focused on modularity. In the future, we can implement a single interface – create a snapshot, make a clone, destroy a clone. It’s all easy. And the storage system is great, if available.
But ZFS is accessible to everyone. Enough with DelPhix, they have 300 clients, of which 50 are in the Fortune 100, meaning they are targeting NASA, etc. It’s time to make this technology available to all. That’s why we have an open-source core. We have an interface part that is not open-source. This is a platform we will demonstrate. But we want it to be accessible to everyone. We want to create a revolution so that all testers stop guessing on laptops. We should be able to write SELECT and immediately see if it's slow. No more waiting for a DBA to inform us. That’s the main goal. And I believe we will all get there. We are developing this thing so that it’s available to everyone. Therefore, ZFS, because it will be available everywhere. Thanks to the community for solving problems and for the open-source license, etc.*
Hello! Thank you for the presentation! My name is Maxim. We faced similar problems. We solved them on our end. How do you allocate resources among these clones? Each clone at any given time can be doing its own thing: one tests one thing, another tests something else, one is building an index, and another is running a heavy job. While it's possible to divide CPU usage, how do you segregate IO? That’s my first question.
And my second question is about the dissimilarity of environments. For example, I have ZFS here and everything is great, but a client in production does not have ZFS but ext4, for example. How do you handle that?
These are very good questions. I briefly mentioned this problem with resource allocation. The solution is as follows. Imagine you’re testing in staging. You might also have a situation where someone is creating one load while another is creating a different load. As a result, you see metrics that are ambiguous. The same problem can occur in production. When you want to check a query and see that there is some issue – it runs slowly – the problem might not actually be with the query but with some parallel load.
In this context, it's important to focus on the plan we'll be taking, the steps involved, and how much data we will lift for it. The load on our disks, for instance, will specifically affect timing. However, we can assess the load of this request based on the volume of data. It's not so important that there will be some execution running simultaneously.
I have two questions. This is a really great tool. Have there been cases where production data is critically important, such as credit card numbers? Is there something ready-made for this, or is it a separate task? And the second question – is there something similar for MySQL?
Regarding the data. We will implement obfuscation; we are not doing this yet. But if you deploy Joe specifically, and if you do not grant access to the developers, then there is no access to the data. Why? Because Joe does not show the data. He only displays metrics, plans, and so on. This was done intentionally since it is one of our client's requirements. They wanted the ability to optimize but not provide access to everyone.
Regarding MySQL. This system can be used for anything that maintains state on disk. Since we are working with Postgres, we are currently prioritizing full automation for Postgres. We want to automate data retrieval from backup. We correctly configure Postgres. We know how to ensure that plans align, etc.
However, since the system is extensible, it can also be used for MySQL. There are examples of this. Yandex has a similar tool, but they do not publish it anywhere. They use it internally in Yandex.Metrics, and it relates specifically to MySQL. But the technologies are the same: ZFS.
Thank you for the presentation! I have a couple of questions as well. You mentioned that cloning can be used for analytics, for instance, to build additional indexes there. Could you explain in more detail how this works?
And I'll ask the second question right away regarding the uniformity of environments and plans. The plan also depends on the statistics collected by Postgres. How do you address this issue?
Na voljo ni analitike specifičnih primerov, ker jih še nismo uporabili, vendar je ta možnost prisotna. Če govorimo o indeksih, si predstavljajte, da se izvede poizvedba nad tabelo s stotimi milijoni vnosi in po stolpcu, ki običajno ni indeksiran v produkciji. In nekako želimo izračunati podatke. Če to poizvedbo izvedemo v produkciji, obstaja možnost, da bo v produkciji zastoja, ker bo ta poizvedba trajala minuto.
V redu, naredimo tisti tanki klon, ki ga ni strah zaustaviti za nekaj minut. In da bo udobneje pri analitiki, dodajmo indekse za stolpce, katerih podatki nas zanimajo.
Ali se bo indeks ustvaril vsakič?
Lahko naredimo tako, da bomo podatke osmotrili, naredili posnetke, nato se bomo iz tega posnetka obnavljali in izvajali nove poizvedbe. To pomeni, da lahko ustvarimo nove klone z že nastavljenimi indeksi.
Kar se tiče vprašanja o statistiki, če se obnavljamo iz varnostne kopije, če izvajamo replikacijo, bo naša statistika točno taka. Ker bomo v celoti prenesli vso fizično strukturo podatkov, torej vse podatke z vsemi statističnimi metričnimi podatki.
Tu je drug problem. Če uporabljate oblačno rešitev, so na voljo samo logične kopije, ker Google in Amazon ne dovolite vzeti fizične kopije. Tam bo problem.
Hvala za poročilo. Tu sta bila postavljena dva dobra vprašanja o MySQL in o razdelitvi virov. A v bistvu se vse svodi na to, da to ni tema specifičnih DBMS, temveč na splošno datotečnega sistema. In zato morajo biti vprašanja razdelitve virov reševana tam, ne na koncu, da je to Postgres, temveč v datotečnem sistemu. strežnikom, v instance.
Moje vprašanje je nekoliko drugačno. Bolj se nanaša na večplastnost podatkovne baze, kjer je več plasti. Na primer, nastavili smo posodobitev deset terabajtnega posnetka, imamo replikacijo. To rešitev konkretno uporabljamo za baze podatkov. Replikacija poteka, prihaja do posodobitve podatkov. Hkrati dela 100 zaposlenih, ki nenehno izvajajo te različne posnetke. Kaj storiti? Kako narediti, da ne bo konflikta, da so zagnali eno, nato pa je datotečni sistem zamenjan in so ti posnetki vsi zmedeni?
Ne bodo odšli, ker tako deluje ZFS. Lahko obdržimo ločeno v enem toku spremembe datotečnega sistema, ki prihajajo zaradi replikacije. In ohranjamo klone starih različic podatkov, ki jih uporabljajo razvijalci. To deluje pri nas, z tem je vse v redu.
Torej bo posodobitev potekala kot dodaten sloj, novi posnetki pa bodo izhajali iz tega sloja, kajne?
Iz prejšnjih slojev, ki so bili iz prejšnjih replikacij.
Prejšnji sloji se odstranijo, vendar se bodo sklicevali na starejši sloj, novi imidži pa bodo vzeti iz zadnjega sloja, ki je bil pridobljen v posodobitvi?
Na splošno, ja.
Potem bomo imeli veliko slojev. In sčasoma jih bo treba stisniti?
Da, točno tako. Obstaja nekako okno. Ohranjamo tedenske posnetke. To je odvisno od tega, kakšne vire imate. Če imate možnost shranjevati veliko podatkov, lahko ohranjate posnetke dalj časa. Sami se ne bodo izbrisali. Nobene korupcije podatkov ne bo. Če se nam zdi, da so posnetki zastareli, tj. to je odvisno od politike v podjetju, jih lahko preprosto izbrišemo in sprostimo prostor.
Pozdravljeni, hvala za poročilo! Glede vprašanja Joe. Rekli ste, da naročnik ni želel dati dostopa vsem do podatkov. Strogo gledano, če ima nekdo rezultat Explain Analyze, lahko vpogleda v podatke.
Tako je. Na primer, lahko napišemo: "SELECT FROM WHERE email = nekdo". Tj. ne bomo videli samih podatkov, vendar lahko pogledamo nekatere posredne oznake. To je treba razumeti. A po drugi strani je vse to vidno. Imamo revizijske dnevnike, imamo nadzor drugih kolegov, ki prav tako vidijo, s čim se ukvarjajo razvijalci. In če kdo poskuša tako narediti, bo varnostna služba prišla k njim in se ukvarjala s tem vprašanjem.
Dober dan! Hvala za poročilo! Imam kratko vprašanje. Če v podjetju Slack ni v uporabi, ali obstaja kakšna vezanost nanj ali lahko razvijalci razporedijo instance, da povežejo aplikacijo za testiranje z bazami?
Trenutno postoji povezanost sa Slack-om, tj. nema drugog messenger-a, ali veoma bismo želeli da podržimo i druge messengere. Šta možete učiniti? Možete pokrenuti DB Lab kod sebe bez Joe-a, koristiti REST API ili našu platformu za kreiranje klonova i povezivanje putem PSQL-a. No, ovo je moguće samo ako ste spremni da date svojim programerima pristup podacima, jer ovde više neće biti nikakvog interfejsa.
Ova sloj mi nije potreban, potrebna mi je takva mogućnost.
U tom slučaju – da, to se može uraditi.
Izvor: habr.com
