

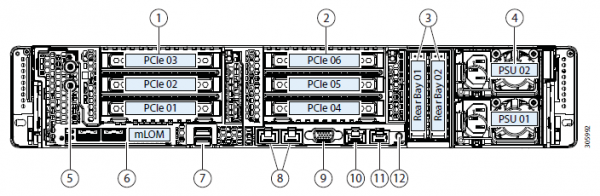
To je mit, precej razširjen na področju strežniškega strojne opreme. V praksi pa so hiper-konvergentne rešitve (ko je vse v enem) potrebne za mnoge namene. Zgodovinsko gledano, prve arhitekture so razvile podjetja Amazon in Google za svoje storitve. Takrat je bila ideja ustvariti računalniško farmo iz enakih enot, pri čemer ima vsaka svoje diske. Vse to je združil nek software (hipervizor) in razdelil na virtualne stroje. Glavna naloga je minimalna potrebna skrb za eno enoto in minimalni problemi pri širitvi: preprosto kupite še tisoč ali dva enakih strežnikov in jih priključite ob strani. V praksi so to enkratni primeri, pogosteje pa gre za manjšo število enot in nekoliko drugačno arhitekturo.
A prednost ostaja enaka – neverjetna enostavnost pri širjenju in upravljanju. Slabost pa je, da različne naloge porabijo vire različno, in kje bo lokalnih diskov preveč, bo drugje premalo RAM-a in tako naprej; torej, pri različnih vrstah nalog bo izkoriščenost virov padla.
Izkazalo se je, da plačujete 10–15% več za udobje nastavitve. To je pravzaprav povzročilo mit iz naslova. Dolgo smo iskali, kje bi bila tehnologija optimalna, in jo našli. Gre za to, da Cisco ni imel svojih podatkovnih shrambe, a so želeli popoln strežniški trg. In so naredili Cisco Hyperflex – rešitev z lokalnimi skladišči na enotah.
In iz tega je nenadoma nastala zelo dobra rešitev za rezervne podatkovne centre (Disaster Recovery). Zakaj in kako – to vam bom zdaj povedal. In pokazal bom testiranje klasterja.
Kjer je potrebno
Hiper-konvergenca je:
- Prenos diskov v računalniške enote.
- Popolna integracija pod-sistema shranjevanja podatkov s pod-sistemom virtualizacije.
- Prenos/integracija s mrežnim pod-sistemom.
Takšna povezava omogoča uresničevanje mnogih funkcij shranjevanja podatkov na ravni virtualizacije in vse iz enega okna za upravljanje.
V našem podjetju so projekti za načrtovanje rezervnih podatkovnih centrov zelo iskani, in pogosto se izbere prav hiper-konvergentna rešitev zaradi številnih možnosti replikacije (do metroklastrov) že iz škatle.
V primeru rezervnih podatkovnih centrov običajno govorimo o oddaljenem objektu na lokaciji na drugem koncu mesta ali celo v drugem mestu. To omogoča obnovitev kritičnih sistemov v primeru delne ali popolne okvare glavnega podatkovnega centra. Podatki se nenehno replicirajo s prodajnega mesta, ta replikacija pa je lahko na ravni aplikacije ali na ravni blokovnega naprave (SAN).
Zato zdaj bom predstavil zasnovo sistema in teste, nato pa še nekaj scenarijev dejanske uporabe z podatki o prihrankih.
Testovi
Naš primer se sestoji iz štirih strežnikov, pri čemer ima vsak po 10 SSD-diskov s kapaciteto 960 GB. Obstaja ločen disk za shranjevanje pisanja in ohranjanje servisne virtualne naprave. Samo rešitev predstavlja četrto različico. Prva je bila očitno nedodelana (sodnik po mnenjih), druga je bila še vedno nedodelana, tretja pa je že dokaj stabilna, to pa lahko imenujemo izid po koncu beta-testiranja za širšo javnost. Med testiranjem nisem naletel na težave, vse deluje kot ura.
Spremembe v v4Odpravljeno je bilo veliko napak.
Sprva je platforma lahko delovala le s hipervizorjem VMware ESXi in je podpirala majhno število vozlišč. Postopek uvajanja tudi ni vedno uspešno zaključil, včasih je bilo potrebno znova zagnati določene korake, nastajale so težave pri posodabljanju iz starih različic, podatki v GUI-ju se niso vedno pravilno prikazovali (čeprav trenutno še vedno nisem navdušen nad prikazovanjem grafikonov zmogljivosti), občasno so se pojavile težave pri virtualizaciji.
Zdaj so vse otroške bolezni odpravljene, HyperFlex podpira tako ESXi kot Hyper-V, poleg tega je možno:
- Ustvarjanje raztegnjenega klasterja.
- Ustvarjanje klasterja za pisarne brez uporabe Fabric Interconnect, od dveh do štirih vozlišč (kupimo le strežnike).
- Možnost delovanja z zunanjimi SAN-ji.
- Podpora za kontejnerje in Kubernetes.
- Ustvarjanje območij dosega.
- Integracija z VMware SRM, če vgrajena funkcionalnost ni zadostna.
Arhitektura se ne razlikuje značajno od rešenja glavnih konkurenata, nisu se trudili da izume bicikl. Sve to funkcioniše na platformi virtualizacije VMware ili Hyper-V. Hardverski se smešta na serverima vlastitog dizajna Cisco UCS. Ima onih koji mrze platformu zbog relativne složenosti početnog podešavanja, mnoštva dugmića, nesvakidašnjeg sistema šablona i zavisnosti, ali ima i onih koji su otkrili zen, ušli u ideju i više ne žele da rade sa drugim serverima.
Razmotrićemo rešenje za VMware, jer je rešenje prvobitno razvijeno za njega i ima veću funkcionalnost, dok je Hyper-V dorađivan usput da ne zaostaje za konkurencijom i odgovara tržišnim očekivanjima.
Postoji klaster servera opremljenih diskovima. Ima diskove za skladištenje podataka (SSD ili HDD — po vašem izboru i potrebama), kao i jedan SSD disk za keširanje. Kada se podaci zapisuju na datastor, oni se čuvaju na keširanoj sloju (posvećeni SSD disk i RAM servisne VM). Paralelno, blok podataka se šalje čvorovima unutar klastera (broj čvorova zavisi od faktora replikacije klastera). Nakon potvrde od svih čvorova o uspešnom zapisu, potvrda se šalje hipervizoru, a zatim — VM. Zapisani podaci se u pozadini deduplikuju, kompresuju i zapisuju na skladišne diskove. Pri tome se na skladišne diskove uvek zapisuje veliki blok i sekvencijalno, što smanjuje opterećenje na skladišnim diskovima.
Deduplikaacija i kompresija su trajno uključene i ne mogu se isključiti. Čitanje podataka se vrši direktno sa skladišnih diskova ili iz RAM keša. Ako se koristi hibridna konfiguracija, čitanje se takođe kešira na SSD disku.
Podaci nisu vezani za trenutno mesto fizičke mašine i ravnomerno se raspoređuju između čvorova. Ovaj pristup omogućava ravnomerno opterećenje svih diskova i mrežnih interfejsa. Logičan nedostatak se nameće: ne možemo maksimalno smanjiti latenciju čitanja, jer nema garancije da su podaci lokalno dostupni. Ali smatram da je to beznačajna žrtva u poređenju sa dobijenim prednostima. Tim više što su latencije u mreži dostigle takve vrednosti da praktično ne utiču na ukupni rezultat.
Za celotno logiko delovanja diskovnega podsistema je odgovorna posebna storitvena VM Cisco HyperFlex Data Platform controller, ki se ustvari na vsakem vozlišču shranjevanja. V naši konfiguraciji je storitveni VM imel dodeljenih osem vCPU in 72 GB RAM, kar ni zanemarljivo. Spomnim, da ima sam gostitelj na voljo 28 fizičnih jeder in 512 GB RAM.
Storitev VM ima dostop do fizičnih diskov neposredno s pomočjo pretvornika SAS, ki je usmerjen v VM. Komunikacija z hiperizvozniki poteka skozi poseben modul IOVisor, ki zajame operacije vnosa in izhoda, ter s pomočjo agenta, ki omogoča pošiljanje ukazov v API hiperizvoznika. Agent je odgovoren za delo s HyperFlex posnetki in kloni.
V hiperizvoznika so diskovni viri montirani kot NFS ali SMB deljenje (odvisno od vrste hiperizvoznika, ugibajte, kateri je kateri). Pod pokrovom pa je to razdeljen datotečni sistem, ki omogoča dodajanje funkcij odraslih celovitih SKD: tanke dodelitve volumov, stiskanje in deduplikacijo, posnetke s tehnologijo Redirect-on-Write, sinhrono/asinhrono replikacijo.
Storitev VM zagotavlja dostop do spletnega vmesnika za upravljanje podsistema HyperFlex. Obstaja integracija z vCenter, in večina vsakodnevnih nalog se lahko izvede iz njega, vendar je za datastore, na primer, lažje razdeliti skozi ločeno spletno stran, če ste že prešli na hiter HTML5 vmesnik, ali uporabiti poln Flash odjemalec z polno integracijo. V storitveni spletni aplikaciji lahko pregledate zmogljivost in podroben status sistema.
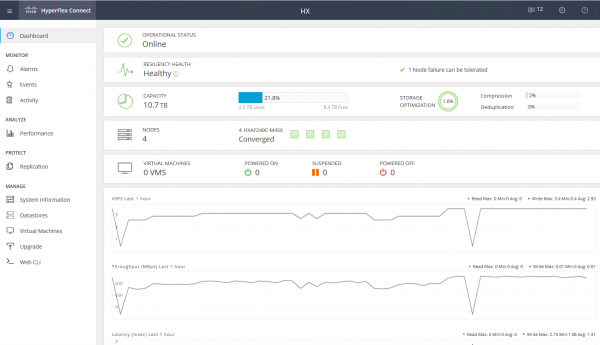
Obstaja tudi drugi tip vozlišč v klastru - računska vozlišča. To so lahko rack-mount ali blade strežniki brez vgrajenih diskov. Na teh strežnikih lahko zaženete VM, katerih podatki se shranjujejo na strežnikih z diski. Z vidika dostopa do podatkov ni razlike med tipi vozlišč, saj arhitektura predvideva abstrakcijo fizične lokacije podatkov. Največje razmerje med računalniškimi vozlišči in vozlišči shranjevanja je 2:1.
Uporaba računalniških vozlišč povečuje prilagodljivost pri razširjanju virov klastrske: ni nam treba kupiti vozlišč z diski, če potrebujemo samo CPU/RAM. Poleg tega lahko dodamo blade košaro in dosežemo prihranke pri namestitvi strežnikov v omarici.
Kot rezultat imamo hiper-konvergentno platformo z naslednjimi funkcijami:
- Doe 64 nodi u klasteru (do 32 nodi za skladištenje).
- Minimalan broj nodi u klasteru je tri (dve za Edge klaster).
- Mehanizam redundantnosti podataka: mirroriranje sa faktorom replikacije 2 i 3.
- Metro klaster.
- Asinhrona replikacija VM na drugi HyperFlex klaster.
- Orkestracija prebacivanja VM u udaljeni podatkovni centar.
- Nativni snimci pomoću tehnologije Redirect-on-Write.
- Do 1 PB korisnog prostora pri faktoru replikacije 3 i bez dedupikacije. Faktor replikacije 2 se ne uzima u obzir, jer to nije opcija za ozbiljnu prodaju.
Još jedna ogromna prednost je jednostavnost upravljanja i implementacije. Sve složenosti podešavanja UCS servera preuzima specijalizovana VM koju su pripremili inženjeri kompanije Cisco.
Konfiguracija testnog okruženja:
- 2 x Cisco UCS Fabric Interconnect 6248UP kao upravljački klaster i mrežni komponenti (48 portova, radi u režimu Ethernet 10G/FC 16G).
- Četiri servera Cisco UCS HXAF240 M4.
Karakteristike servera:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/dual rank/x4/1.2v
Mreža
UCSC-MLOM-CSC-02 (VIC 1227). 2 porta 10G Ethernet
Storage HBA
Cisco 12G Modular SAS Pass-through Controller
Storage Disks
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Više opcija konfiguracijaOsim odabranog hardvera, trenutno su dostupne sledeće opcije:
- HXAF240c M5.
- Jedan ili dva CPU počevši od Intel Silver 4110 do Intel Platinum I8260Y. Dostupna je druga generacija.
- 24 slota za memoriju, moduli od 16 GB RDIMM 2600 do 128 GB LRDIMM 2933.
- Od 6 do 23 diskova za podatke, jedan keširajući disk, jedan sistemski i jedan boot disk.
Capacity Drives
- HX-SD960G61X-EV 960GB 2.5 inčni Enterprise Value 6G SATA SSD (1X izdržljivost) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 inčni Enterprise Value 6G SATA SSD (1X izdržljivost) SAS 3.8 TB.
- Caching Drives
- HX-NVMEXPB-I375 375GB 2.5 inčni Intel Optane Disk, Extreme Perf & Izdržljivost.
- HX-NVMEHW-H1600* 1.6TB 2.5 inčni Ent. Perf. NVMe SSD (3X izdržljivost) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 inčni Ent. Perf. 12G SAS SSD (10X izdržljivost) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 inčni Ent. Perf. 12G SAS SED SSD (10X izdržljivost) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 inčni Enterprise performance 12G SAS SSD (3X izdržljivost).
System / Log Drives
- HX-SD240GM1X-EV 240GB 2.5 inčni Enterprise Value 6G SATA SSD (zahteva nadogradnju).
Boot Drives
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Povezivanje sa mrežom putem 40G, 25G ili 10G Ethernet portova.
Kao FI mogu biti HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G).
Test samog testa
Za testiranje diskovne pod-sistem koristio sam HCIBench 2.2.1. Ovo je besplatan alat koji omogućava automatizaciju opterećenja iz više virtuelnih mašina. Samo opterećenje se generiše običnim fio.
Naš klaster se sastoji od četiri nodi, faktor replikacije 3, svi diskovi su Flash.
Za testiranje sam stvorio četiri datastora i osam virtualnih mašina. U testovima zapisa predviđa se mogućnost kada predmemorijski disk ne prelazi veličinu.
Rezultati testova su sljedeći:
100 % Čitanje 100 % Nasumično
0 % Čitanje 100 % Nasumično
Blok/gupan red
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36 ms 374348 IOPS
2,47 ms 414116 IOPS
4,86 ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376484 IOPS
5,47 ms 373176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
Podebljana su inačica nakon koje više ne dolazi do povećanja performansi, ponekad se čak može primijetiti degradacija. To je povezano s time da smo na ograničenju performansi mreže/kontrolera/diskova.
- Sekvencijalno čitanje 4432 MB/s.
- Sekvencijalno pisanje 804 MB/s.
- U slučaju kvara jednog kontrolera (kvar virtualne mašine ili hosta) performanse padaju za polovicu.
- U slučaju kvara diska za pohranu — pad za 1/3. Rebuild diska oduzima 5% resursa svakog kontrolera.
Na malom bloku nailazimo na performanse kontrolera (virtualna mašina), CPU je opterećen 100%, a prilikom povećanja bloka nailazimo na propusnost portova. 10 Gbit/s nije dovoljno za otkrivanje potencijala AllFlash sustava. Nažalost, nije moguće testirati rad na 40 Gbit/s zbog parametara dostupnog demostenda.
Prema mojem dojmu iz testova i proučavanja arhitekture, zahvaljujući algoritmu koji raspoređuje podatke između svih hostova, dobivamo skalabilne predvidljive performanse, ali to je i ograničenje pri čitanju, jer bi se s lokalnih diskova moglo izvući više; ovdje bi mogla pomoći učinkovitija mreža, na primjer, dostupni su FI na 40 Gbit/s.
Jedan disk za keširanje i deduplikaciju također može biti ograničenje, u ovom uspostavljenom sistemu možemo zapravo pisati na četiri SSD diska. Bilo bi sjajno imati mogućnost povećanja broja predmemornih diskova i vidjeti razliku.
Stvarna upotreba
Za organizaciju rezervnog centra podataka mogu se koristiti dva pristupa (ne razmatramo pohranu sigurnosne kopije na udaljenoj lokaciji):
- Active-Passive. Vse aplikacije so nameščene v glavnem DC-ju. Replikacija je lahko sinhrona ali asinhrona. V primeru izpada glavnega DC-ja moramo aktivirati rezervni. To lahko storimo ročno/prek skript/kot aplikacije za orkestracijo. Tu bomo dobili RPO, ki je sorazmeren s frekvenco replikacije, RTO pa je odvisen od reakcije in znanja administratorja ter kakovosti obdelave/razvoja načrta preklopa.
- Active-Active. V tem primeru imamo le sinhrono replikacijo, dostopnost DC-jev pa določa kvorum/arbitrar, ki je strogo nameščen na tretji lokaciji. RPO = 0, RTO pa lahko doseže 0 (če aplikacija to omogoča) ali je enak času za obvladovanje napake vozlišča v virtualizacijskem klastru. Na ravni virtualizacije se ustvari raztegnjen (Metro) klaster, ki zahteva Active-Active SAN.
Običajno pri strankah vidimo že implementirano arhitekturo s klasičnim SAN-om v glavnem DC-ju, zato načrtujemo še enega za replikacijo. Kot sem omenil, Cisco HyperFlex ponuja asinhrono replikacijo in ustvarjanje raztegnjenega virtualizacijskega klasterja. Pri tem ne potrebujemo namenskega SAN-a ravni Midrange in višje z dragimi funkcijami replikacije in Active-Active dostopa do podatkov na dveh SAN-ih.
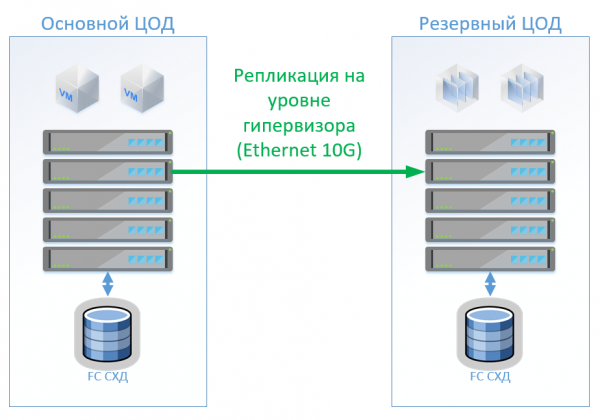
Scenarij 1: Imamo glavni in rezervni DC, platformo virtualizacije na VMware vSphere. Vsi produktivni sistemi so nameščeni v glavnem DC-ju, replikacija virtualnih strojev pa poteka na ravni hipervizorja, kar bo omogočilo, da ne držimo VM-ov vklopljenih v rezervnem DC-ju. Podatkovne baze in posebne aplikacije replikiramo z vgrajenimi sredstvi in držimo VM-e vklopljene. V primeru izpada glavnega DC-ja zaženemo sisteme v rezervnem DC-ju. Predpostavljamo, da imamo okoli 100 virtualnih strojev. Dokler deluje glavni DC, lahko v rezervnem DC-ju zaženemo testna okolja in druge sisteme, ki jih je mogoče izklopiti v primeru preklopa glavnega DC-ja. Možna je tudi možnost, da uporabljamo dvosmerno replikacijo. Z vidika strojne opreme se ne bo nič spremenilo.
V primeru klasične arhitekture bomo v vsak center podatkov namestili hibridno SAN z dostopom prek FibreChannel, tieringom, deduplikacijo in stiskanjem (ampak ne v živo), 8 strežnikov na vsako lokacijo, po 2 stikala FibreChannel in Ethernet 10G. Za replikacijo in upravljanje preklopa v klasični arhitekturi lahko uporabimo orodja VMware (Replication + SRM) ali pa tretje strani, ki bodo nekoliko cenejše in včasih bolj priročne.
Na shemi je prikazana zasnova.
V primeru uporabe Cisco HyperFlex dobimo naslednjo arhitekturo:
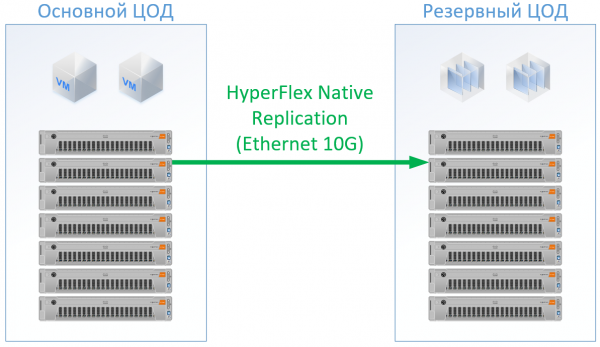
Za HyperFlex sem uporabil strežnike z velikimi viri CPU/RAM, saj bodo nekateri viri namenjeni VM kontrolerju HyperFlex. Kar se tiče CPU in pomnilnika, sem celo nekoliko pridobil v konfiguraciji HyperFlex, da ne bi prekomerno prilagodil Cisco in zagotovil vire za preostale VM. Tako se lahko odrečemo stikalom FibreChannel, in ne bomo potrebovali Ethernet priključkov za vsak strežnik, lokalni promet se preklaplja v okviru FI.
Končala se je naslednja konfiguracija za vsak center podatkov:
Strežniki
8 x 1U Strežnik (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
SAN
Hibridna SAN s FC Front-End (20TB SSD, 130 TB NL-SAS)
—
LAN
2 x Ethernet stikalo 10G 12 rež
—
SAN
2 x FC stikalo 32/16Gb 24 rež
2 x Cisco UCS FI 6332
Licence
VMware Ent Plus
Replikacija in/ali orkestracija preklopa VM
VMware Ent Plus
Za Hyperflex nisem predvidel licenc za programsko opremo za replikacijo, saj imamo to na voljo iz škatle.
Za klasično arhitekturo sem izbral dobavitelja, ki se je izkazal kot kakovosten in cenovno ugoden proizvajalec. Za obe možnosti sem uporabil standardno popust, tako da sem na koncu dobil realne cene.
Rešitev na Cisco HyperFlex je bila 13% cenejša.
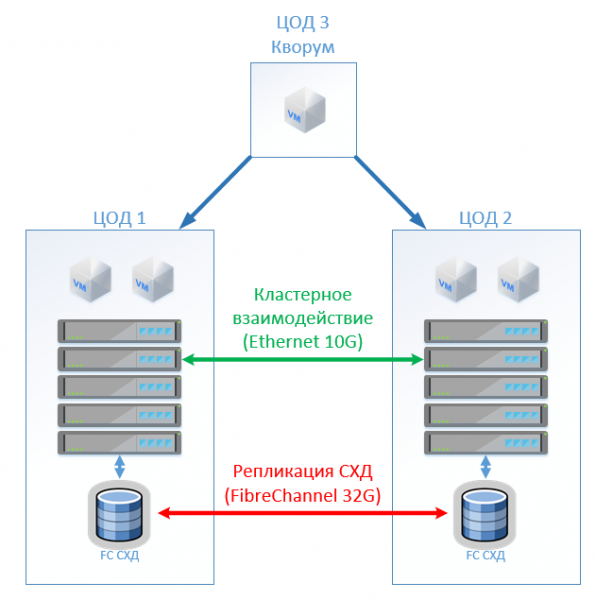
Scenarij 2: ustvarjanje dveh aktivnih centrov podatkov. V tem scenariju projektiramo razširjen grozd na VMware.
Klasična arhitektura se sestavlja iz virtualizacijskih strežnikov, SAN (protokol FC) in dveh SAN, ki znata brati in pisati na tistem, raztegnjenem med njima. Na vsakem SAN-u predvidevamo koristno kapaciteto za lok.
Pri HyperFlex preprosto ustvarimo Stretch Cluster z enakim številom vozlišč na obeh lokacijah. V tem primeru se uporablja faktor replikacije 2+2.
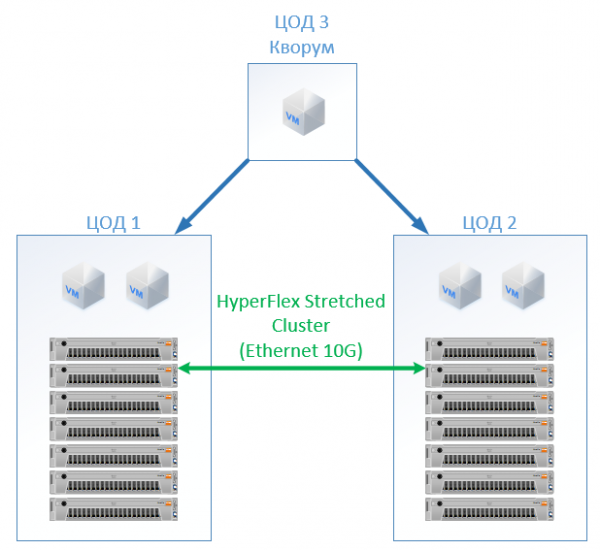
Nastala je naslednja konfiguracija:
Klasična arhitektura
HyperFlex
Strežniki
16 x 1U Strežnik (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
SAN
2 x AllFlash SAN (150 TB SSD)
—
LAN
4 x Ethernet stikalo 10G 24 rež
—
SAN
4 x FC stikalo 32/16Gb 24 rež
4 x Cisco UCS FI 6332
Licence
VMware Ent Plus
VMware Ent Plus
V vseh izračunih nisem upošteval omrežne infrastrukture, stroškov podatkovnega centra itd.: ti bodo enaki za klasično arhitekturo in za rešitev na HyperFlex.
Po stroških je HyperFlex prišel 5 % dražje. Tukaj je pomembno omeniti, da sem na CPU/RAM virih za Cisco dobil nerazmerje, saj sem v konfiguraciji enakomerno zapolnil pomnilniške kanale kontrolerjev. Cena je nekoliko višja, vendar ne za razred, kar očitno kaže, da hiperkohezija ni nujno 'igrača za bogate', temveč lahko tekmuje s standardnim pristopom k gradnji podatkovnega centra. To bi bilo zanimivo tudi tistim, ki že imajo strežnike Cisco UCS in ustrezno infrastrukturo zanje.
Med prednostmi bomo pridobili odsotnost stroškov za upravljanje SAN in shranjevanja podatkov, spletno stiskanje in deduplikacijo, eno samo točko dostopa za podporo (virtualizacija, strežniki, ti so tudi shranjevanje podatkov), prihranek prostora (vendar ne v vseh scenarijih), poenostavitev obratovanja.
Kar zadeva podporo, jo tukaj dobite od enega dobavitelja - Cisco. Če sodim po izkušnjah z delom s strežniki Cisco UCS, mi je to všeč, na HyperFlex pa nisem potreboval odpirati, vse je delovalo. Inženirji hitro odgovarjajo in znajo reševati ne le tipične težave, ampak tudi kompleksne mejne primere. Včasih se nanje obrnem s vprašanji: 'Ali je možno, da naredim tako, priklopim to?' ali 'Tu sem nekaj konfiguriral in noče delovati. Pomoč!' - potrpežljivo bodo našli pravi vodič in pokazali pravilne korake, odgovoriti 'Rešujemo samo strojne težave' pa ne bodo.
Povezave
- Moj e-poštni naslov je StGeneralov@croc.ru
Izvor: habr.com
