

Pozdravljen, Habr! V tem članku želim govoriti o enem čudovitem orodju za razvijanje batch procesov obdelave podatkov, na primer v infrastrukturi korporativnega DWH ali vašem DataLake. Govorili bomo o Apache Airflow (nadalje Airflow). Na Habrju mu nepravično namenjajo malo pozornosti in v osrednjem delu vas bom poskušal prepričati, da ga je vsaj vredno upoštevati pri izbiri načrtovalnika za vaše ETL/ELT procese.
Prej sem napisal serijo člankov o temi DWH, ko sem delal v Tinkoff Bank. Zdaj sem del ekipe Mail.Ru Group in se ukvarjam z razvojem platforme za analizo podatkov na področju iger. Svojim novicam in zanimivim rešitvam bomo z ekipo tukaj poročali o naši analitični platformi.
Prolog
Torej, začnimo. Kaj je Airflow? To je knjižnica (ali ) za razvijanje, načrtovanje in spremljanje delovnih tokov. Glavna značilnost Airflowa je, da za opisovanje (razvijanje) procesov uporabljate kodo v jeziku Python. To prinaša številne prednosti za organizacijo vašega projekta in razvoj: vaš (na primer) ETL projekt je pravzaprav preprosto Python projekt in ga lahko organizirate, kot vam ustreza, ob upoštevanju značilnosti infrastrukture, velikosti ekipe in drugih zahtev.
Zdaj poglejmo glavne entitete Airflowa. Ko razumete njihovo bistvo in namen, boste optimalno organizirali arhitekturo procesov. Verjetno je glavna entiteta usmerjeni aciklični graf (DAG).
DAG
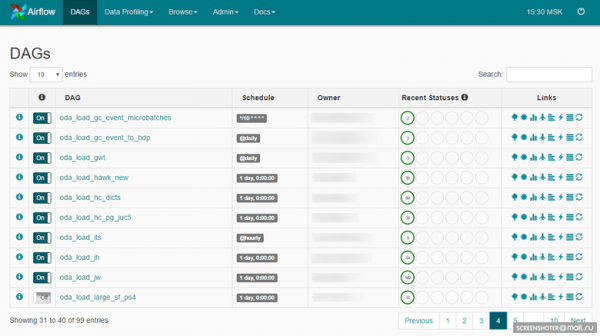
DAG je smiselno združevanje vaših nalog, ki jih želite izvesti v strogo določenem zaporedju po določenem razporedu. Airflow ponuja prijazen spletni vmesnik za delo z DAG-i in drugimi entitetami:
DAG lahko izgleda takole:
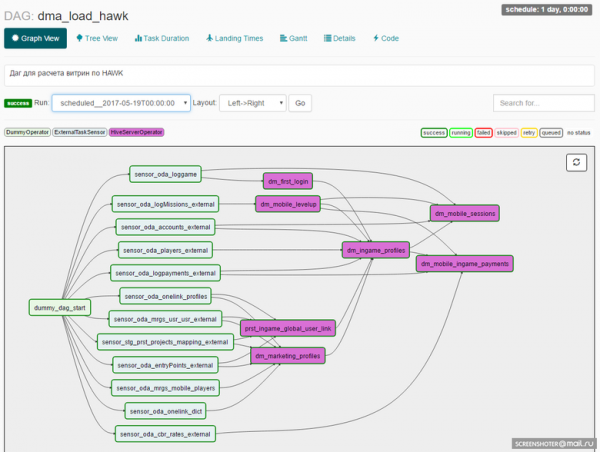
Razvijalec, ki načrtuje DAG, določi nabor operaterjev, na katerih bodo temeljile naloge znotraj DAG-a. Tu pridemo še do ene pomembne entitete: Airflow Operator.
Operaterji
Operater je entiteta, na podlagi katere se ustvarjajo primerki nalog, kjer je opisano, kaj se bo zgodilo med izvajanjem primerka naloge. već sadrže set operatera spremnih za korištenje. Primjeri:
- BashOperator — operater za izvršavanje bash komandi.
- PythonOperator — operater za pozivanje Python koda.
- EmailOperator — operater za slanje email-a.
- HTTPOperator — operater za rad sa http zahtevima.
- SqlOperator — operater za izvršavanje SQL koda.
- Sensor — operater koji čeka na događaj (dostizanje potrebnog vremena, pojava potrebnog fajla, stringa u bazi, odgovora iz API-a itd.).
Postoje više specifičnih operatera: DockerOperator, HiveOperator, S3FileTransferOperator, PrestoToMysqlOperator, SlackOperator.
Možete također razvijati operatere usmerene na vaše potrebe i koristiti ih u projektu. Na primjer, kreirali smo MongoDBToHiveViaHdfsTransfer, operater za eksport dokumenata iz MongoDB u Hive, i nekoliko operatera za rad sa : CHLoadFromHiveOperator i CHTableLoaderOperator. U suštini, čim se u projektu javi često korišćen kod, temeljen na osnovnim operaterima, možete razmisliti o tome da ga skupite u novi operater. To će olakšati dalji razvoj i dopuniti vašu biblioteku operatera u projektu.
Nakon toga, sve te instance zadataka treba izvršiti, a sada će biti reči o planeru.
Planer
Planer zadataka u Airflow-u izgrađen je na . Celery je Python biblioteka koja omogućava organizaciju reda, plus asinhrono i distribuirano izvršavanje zadataka. Sa strane Airflow-a, svi zadaci se dele na grupe. Grupe se kreiraju ručno. Njihova svrha je najčešće da ograniče opterećenje rada sa izvorom ili da tipiziraju zadatke unutar DWH-a. Grupe se mogu upravljati putem web interfejsa:
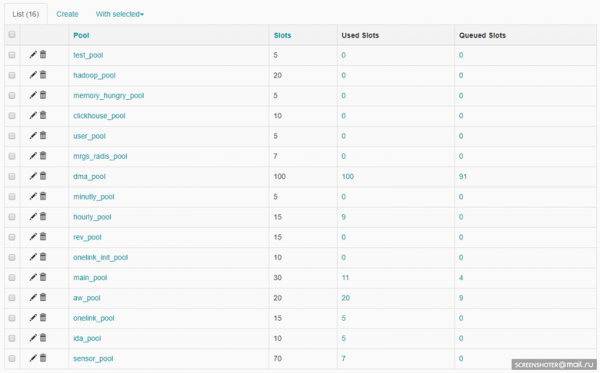
Svaka grupa ima ograničenje broja slotova. Kada se kreira DAG, dodeljuje mu se grupa:
ALERT_MAILS =  Variable.get("gv_mail_admin_dwh")
DAG_NAME = 'dma_load'
OWNER = 'Vasya Pupkin'
DEPENDS_ON_PAST = True
EMAIL_ON_FAILURE = True
EMAIL_ON_RETRY = True
RETRIES = int(Variable.get('gv_dag_retries'))
POOL = 'dma_pool'
PRIORITY_WEIGHT = 10

start_dt = datetime.today() - timedelta(1)
start_dt = datetime(start_dt.year, start_dt.month, start_dt.day)

default_args = {
    'owner': OWNER,
    'depends_on_past': DEPENDS_ON_PAST,
    'start_date': start_dt,
    'email': ALERT_MAILS,
    'email_on_failure': EMAIL_ON_FAILURE,
    'email_on_retry': EMAIL_ON_RETRY,
    'retries': RETRIES,
    'pool': POOL,
    'priority_weight': PRIORITY_WEIGHT
}
dag = DAG(DAG_NAME, default_args=default_args)
dag.doc_md = __doc__
Grupa dodeljena na nivou DAG-a može se prepisati na nivou zadatka.
Za načrtovanje vseh nalog v Airflow skrbi poseben proces — Scheduler. Ta se ukvarja z mehaniko postavljanja nalog v izvajanje. Preden naloga pride v izvajanje, preide več stopenj:
- V DAG-u so bile prejšnje naloge zaključene, novo pa lahko postavimo v čakalno vrsto.
- Čakalna vrsta se sortira glede na prioritet nalog (prioritete je mogoče tudi upravljati), in če je v bazenu prosti prostor, se naloga lahko zgrabi v delo.
- Če je prost delavec Celery, se naloga usmeri nanj; začne se delo, ki ste ga programirali v nalogi z uporabo določenega operatorja.
Preprosto je.
Scheduler deluje na številnih vseh DAG-ih in vseh nalogah znotraj DAG-ov.
Da bi Scheduler začel delati z DAG-om, mu je treba dodeliti urnik:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='@hourly')Na voljo je nabor pripravljenih prednastavitev: @once, @hourly, @daily, @weekly, @monthly, @yearly.
Lahko se uporabljajo tudi cron izrazi:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='*\/10 * * * *')Datum izvršitve
Za razumevanje delovanja Airflow je pomembno vedeti, kaj je Datum izvršitve za DAG. V Airflow ima DAG meritev Datuma izvršitve, tj. na podlagi urnika dela DAG-a se ustvarjajo primerki nalog za vsak Datum izvršitve. Za vsak Datum izvršitve je naloge mogoče izvajati večkrat — ali pa lahko DAG deluje hkrati na več Datumih izvršitve. To je jasno prikazano tukaj:
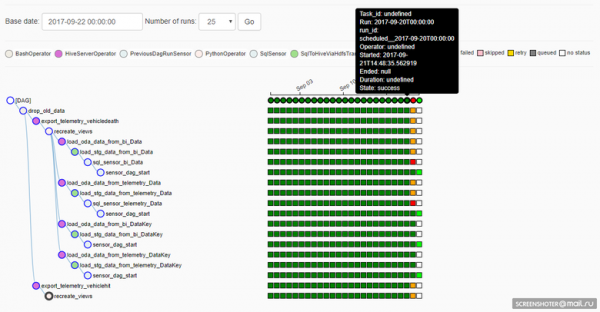
Žal (morda pa tudi sreča: odvisno od situacije), če se popravi implementacija naloge v DAG-u, se bo izvajanje v prejšnjih Datumih izvršitve že upoštevalo popravke. To je dobro, če je treba prekalkulirati podatke iz prejšnjih obdobij z novim algoritmom, vendar slabo, ker se izgubi ponovljivost rezultata (seveda nikomur ne preprečuje, da bi iz Git-a vrnil potrebno različico izvorne kode in enkratno izračunal to, kar potrebujete, tako, kot je potrebno).
Generiranje nalog
Implementacija DAG-a je koda v Pythonu, zato imamo zelo priročen način za zmanjšanje obsega kode, ko delamo, na primer, s shardiranimi viri. Predpostavimo, da imate tri sharde MySQL kot vir, potrebujete iti v vsak in pridobiti nekatere podatke. In to neodvisno in vzporedno. Koda v Pythonu v DAG-u lahko izgleda takole:
connection_list = lv.get('connection_list')

export_profiles_sql = '''
SELECT
  id,
  user_id,
  nickname,
  gender,
  {{params.shard_id}} as shard_id
FROM profiles
'''

for conn_id in connection_list:
    export_profiles = SqlToHiveViaHdfsTransfer(
        task_id='export_profiles_from_' + conn_id,
        sql=export_profiles_sql,
        hive_table='stg.profiles',
        overwrite=False,
        tmpdir='\/data\/tmp',
        conn_id=conn_id,
        params={'shard_id': conn_id[-1:], },
        compress=None,
        dag=dag
    )
    export_profiles.set_upstream(exec_truncate_stg)
    export_profiles.set_downstream(load_profiles)
DAG se prikaže takole:
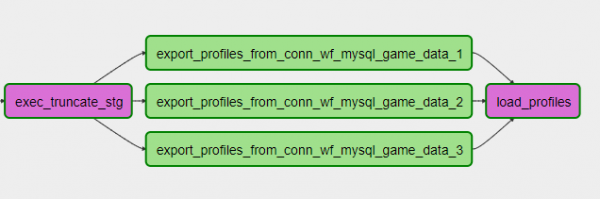
Ob tem lahko dodate ali odstranite shard, preprosto prilagodite nastavitev in osvežite DAG. Praktično!
Lahko pa uporabite tudi bolj zapleteno generacijo kode, na primer delate z viri v obliki DB ali opišete tabelarno strukturo, algoritem dela s tabelo in ob upoštevanju posebnosti infrastrukture DWH generirate proces nalaganja N tabel v vašo skladišče. Ali pa, na primer, delo z API-jem, ki ne podpira dela s parametrom v obliki seznama, lahko po tem seznamu generirate N nalog v DAG-u, omejite sočasnost zahtevkov v API-ju s skupino in pridobite potrebne podatke iz API-ja. Fleksibilno!
Repozitorij
V Airflowu je svoj backend repozitorij, DB (lahko je MySQL ali Postgres, pri nas je Postgres), v kateri so shranjena stanja nalog, DAG-ov, nastavitve povezav, globalne spremenljivke itd. Tukaj bi rad omenil, da je repozitorij v Airflowu zelo preprost (približno 20 tabel) in priročen, če želite zgraditi kakšen svoj proces nad njim. Spomnim se 100500 tabel v repozitoriju Informatica, ki so jih bilo treba dolgo prebaviti, preden si razumel, kako zgraditi poizvedbo.
Nadzor
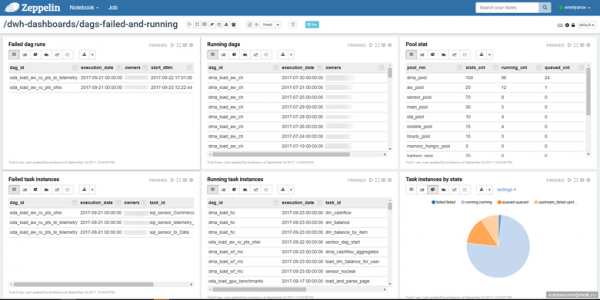
Glede na preprostost repozitorija, lahko sami zgradite proces spremljanja nalog, ki vam ustreza. Uporabljamo beležnico v Zeppelinu, kjer spremljamo stanje nalog:
To je lahko tudi spletni vmesnik samega Airflowa:
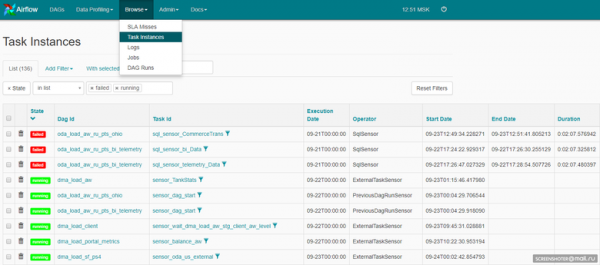
Koda Airflowa je odprta, zato smo dodali obvestila v Telegram. Vsak delujoči primer naloge, če pride do napake, sporoča v skupino v Telegramu, kjer je vsa ekipa za razvoj in podporo.
Prejmete hitro odzivanje preko Telegrama (če je to potrebno), preko Zeppelina pa splošno sliko nalog v Airflowu.
Ukupno
Airflow je najprej odprtokoden in ne gre pričakovati čudes. Bodite pripravljeni vložiti čas in trud, da zgradite delujočo rešitev. Cilj je dosegljiv, verjemite, vredno je truda. Hitrost razvoja, prilagodljivost, enostavnost dodajanja novih procesov - všeč vam bo. Seveda je treba posvetiti veliko pozornosti organizaciji projekta in stabilnosti delovanja samega Airflow: čudežev ni.
Trenutno naš Airflow vsak dan obdeluje približno 6,5 tisoč nalog. Po naravi so dovolj različne. Obstajajo naloge za nalaganje podatkov v glavno DWH iz številnih različnih in zelo specifičnih virov, naloge za izračun vitrin znotraj glavnega DWH, naloge za objavo podatkov v hitrem DWH, obstaja še mnoga druga naloga - in Airflow vse to obdeluje dan za dnem. Če govorimo v številkah, imamo 2,3 tisoč ELT nalog različnih zahtevnosti znotraj DWH (Hadoop), okoli 250 baz podatkov virov, to je ekipa čterih ETL razvijalcev, ki se delijo na ETL procesiranje podatkov v DWH in ELT procesiranje podatkov znotraj DWH, ter seveda še enega skrbnika, ki se ukvarja z infrastrukturo storitve.
Načrti za prihodnost
Število procesov nezadržno narašča in glavno, s čimer se bomo ukvarjali na področju infrastrukture Airflow, je razširitev. Želimo zgraditi Airflow grozd, nameniti nekaj enot za workerje Celery in ustvariti duplicirano glavo s procesi načrtovanja nalog in repozitorijem.
Epilog
To je seveda le delček tistega, kar bi želel povedati o Airflow, vendar sem poskušal osvetliti glavne točke. Apetit prihaja med jedjo, preizkusite - in všeč vam bo 🙂
Izvor: habr.com
