

Pred začetkom tečaja smo pripravili prevod še enega koristnega gradiva.
Huffmanovo kodiranje je algoritem za stiskanje podatkov, ki formulira osnovno idejo stiskanja datotek. V tem članku bomo govorili o fiksnih in spremenljivih dolžinah kodiranja, edinstveno dekodirljivih kodah, prednostnih pravilih in gradnji Huffmanovega drevesa.
Vemo, da se vsak simbol shrani kot zaporedje 0 in 1 ter zavzema 8 bitov. To imenujemo kodiranje fiksne dolžine, ker vsak simbol uporablja enako fiksno število bitov za shranjevanje.
Recimo, da imamo besedilo. Kako lahko zmanjšamo količino prostora, ki je potrebna za shranjevanje enega simbola?
Osnovna ideja je v kodiranju spremenljive dolžine. Lahko izkoristimo dejstvo, da se nekateri simboli v besedilu pojavljajo pogostejše kot drugi (), da razvijemo algoritem, ki bo predstavljal isto zaporedje simbolov z manjšim številom bitov. Pri kodiranju spremenljive dolžine dodelimo simbolom spremenljivo število bitov, odvisno od pogostosti njihovega pojavljanja v danem besedilu. Na koncu lahko nekateri simboli zavzamejo le 1 bit, drugi pa 2 bita, 3 ali več. Težava pri kodiranju spremenljive dolžine je le v kasnejšem dekodiranju zaporedja.
Kako, če poznamo zaporedje bitov, to dekodirati enoznačno?
Poglejmo niz «aabacdab». V njem je 8 simbolov, in pri kodiranju fiksne dolžine bo za njegovo shranjevanje potrebnih 64 bitov. Opazimo, da so pogostosti simbolov «a», «b», «c» in «d» enake 4, 2, 1, 1. Poskusimo predstaviti «aabacdab» z manjšim številom bitov, tako da izkoristimo dejstvo, da je «a» pogostejši kot «b», a «b» pogostejši kot «c» in «d». Začnemo tako, da kodiramo «a» z enim bitom, ki je 0, «b» dodelimo dvobitno kodo 11, z uporabo treh bitov pa kodiramo 100 in 011 «c» in «d».
Na koncu bomo imeli:
a
0
b
11
c
100
d
011
Tako bomo niz «aabacdab» kodirali kot 00110100011011 (0|0|11|0|100|011|0|11), z uporabo zgoraj predstavljenih kod. Vendar bo glavna težava pri dekodiranju. Ko poskusimo dekodirati niz 00110100011011, dobimo nejasen rezultat, saj ga lahko predstavimo kot:
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
itd.
Da bi se izbegla ova nejasnoća, moramo garantovati da naše kodiranje zadovoljava takvo poimanje kao prefiksno pravilo, što podrazumeva da se kodovi mogu dekodirati na samo jedan jedinstven način. Prefiksno pravilo garantuje da nijedan kod neće biti prefiks drugog. Pod kodom smatramo bitove koji se koriste za predstavljanje specifičnog simbola. U datom primeru 0 – to je prefiks 011, što krši prefiksno pravilo. Dakle, ako naši kodovi zadovoljavaju prefiksno pravilo, dekodiranje se može izvršiti jednoznačno (i obrnuto).
Pogledajmo ponovo gornji primer. Ovoga puta dodelićemo simbolima «a», «b», «c» in «d» kodove koji zadovoljavaju prefiksno pravilo.
a
0
b
10
c
110
d
111
Uz korišćenje takvog kodiranja, niz «aabacdab» biće kodiran kao 00100100011010 (0|0|10|0|100|011|0|10). A ovo 00100100011010 ćemo moći jednoznačno da dekodiramo i vratimo se našem izvorom nizu. «aabacdab».
Hafmanovo kodiranje
Sada kada smo razjasnili kodiranje promenljive dužine i prefiksno pravilo, razgovarajmo o Hafmanovom kodiranju.
Metoda se zasniva na kreiranju binarnih stabala. U njemu čvor može biti ili terminalan ili unutrašnji. U početku se svi čvorovi smatraju listovima (terminalnim), koji predstavljaju sam simbol i njegovu težinu (tj. frekvenciju pojavljivanja). Unutrašnji čvorovi sadrže težinu simbola i upućuju na dva naslednika. Prema opštem dogovoru, bit „0“ predstavlja putanju kroz levu granu, a „1“ — kroz desnu. U potpunom stablu N ima listova i N-1 unutrašnjih čvorova. Preporučuje se da se prilikom konstrukcije Hafmanovog stabla odbace neiskorišćeni simboli kako bi se dobili kodovi optimalne dužine.
Koristićemo prioritetnu red za građenje Hafmanovog stabla, gde čvoru sa najmanjom frekvencijom pripada najviši prioritet. U nastavku su opisani koraci građenja:
- Kreirajte čvor-list za svaki simbol i dodajte ih u prioritetnu red.
- Dok u redu ima više od jednog lista, uradite sledeće:
- Uklonite dva čvora sa najvišim prioritetom (sa najnižom frekvencijom) iz reda;
- Kreirajte novi unutrašnji čvor, gde će ta dva čvora biti naslednici, a frekvencija pojava će biti jednaka zbiru frekvencija ta dva čvora.
- Dodajte novi čvor u prioritetnu red.
- Edini preostali vozel bo koren, na tem se konča gradnja drevesa.
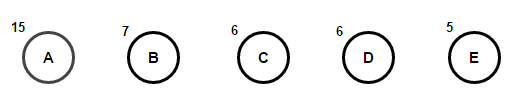
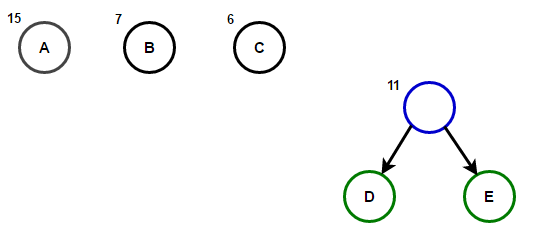
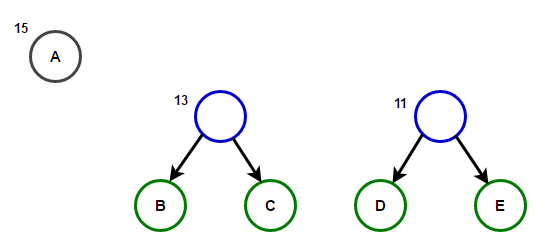
Predstavljajmo si, da imamo neko besedilo, ki je sestavljeno samo iz znakov „a“, „b“, „c“, „d“ in „e“, pri čemer so frekvencije njihovega pojavljanja 15, 7, 6, 6 in 5. Spodaj so prikazi, ki odražajo korake algoritma.
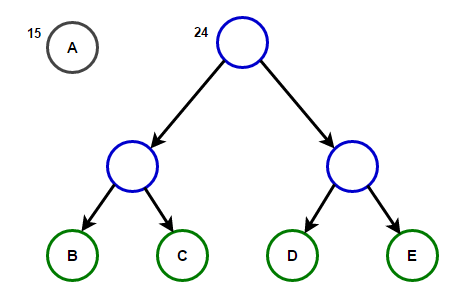
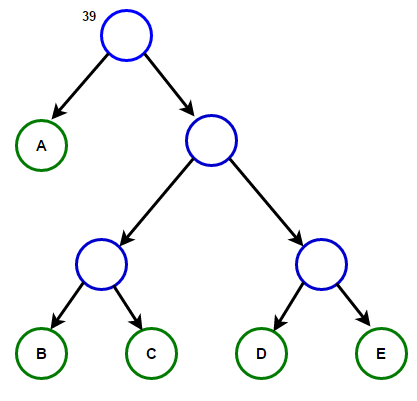
Pot od korena do katerega koli končnega vozla bo hranila optimizirano prefiksno kodo (znano tudi kot Huffmanov kodeks), povezano z znakom, ki je povezan s tem končnim vozlom.
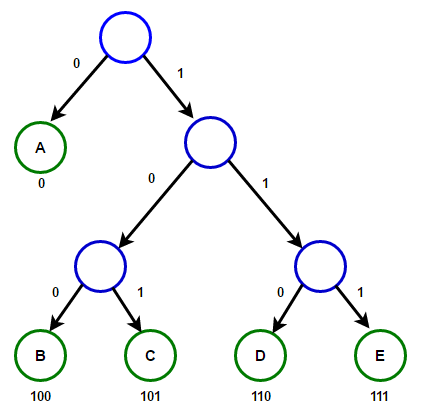
Huffmanovo drevo
Spodaj boste našli implementacijo Huffmanovega algoritma za stiskanje v jezikih C++ in Java:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// Vozel drevesa
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// Pojdi skozi Huffmanovo drevo in shranite Huffmanove kode
// v zemljevidu.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// našli smo listnati vozel
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// Pojdi skozi Huffmanovo drevo in dekodiraj kodirano niz
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// našli smo listnati vozel
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Ustvari Huffmanovo drevo in Huffmanovo kodo ter dekodiraj podani vnosni tekst
public static void buildHuffmanTree(String text)
{
// preštej frekvenco pojavljanja vsakega znaka
// in shranite v zemljevid
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Ustvari prioriteto vrsto za shranjevanje živih vozlov Huffmanovega drevesa
// Upoštevajte, da ima najbolj prioritetna naloga najnižjo frekvenco
PriorityQueue pq = new PriorityQueue((l, r) -> l.freq - r.freq);
// Ustvari listnati vozel za vsak znak in ga dodaj
// v prioriteto vrsto.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// Delajte, dokler ni več kot en vozel v vrsti
while (pq.size() != 1)
{
// Odstranite dva vozla z najvišjo prioriteto
// (najmanjša frekvenca) iz vrste
Node left = pq.poll();
Node right = pq.poll();
// Ustvari nov interni vozel s tema dvema vozloma kot otroki
// in s frekvenco, ki je enaka vsoti obeh vozlov
// frekvenc. Dodajte nov vozel v prioriteto vrsto.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// root shranjuje kazalec na koren Huffmanovega drevesa
Node root = pq.peek();
// Pojdi skozi Huffmanovo drevo in shranite Huffmanove kode v zemljevid
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// natisnite Huffmanove kode
System.out.println("Huffmanove kode so :\n");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("\nIzvirni niz je bil :\n" + text);
// natisnite kodirani niz
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("\nKodirani niz je :\n" + sb);
// Pojdi skozi Huffmanovo drevo znova in tokrat
// dekodiraj kodirani niz
int index = -1;
System.out.println("\nDekodirani niz je: \n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "Huffmanova kodiranja je algoritem za stiskanje podatkov.";
buildHuffmanTree(text);
}
}Opomba: Pomnilnik, ki ga uporablja vhodna vrstica, znaša 47 * 8 = 376 bitov, kodirana vrstica pa zavzame le 194 bitov, kar pomeni, da se podatki stisnejo približno za 48 %. V zgornjem C++ programu uporabljamo razred string za shranjevanje kodirane vrstice, da naredimo program berljiv.
Ker učinkovite podatkovne strukture prioritetnih vrst pričakujejo, da bo vstavljanje O(log(N)) časa, in v popolnem binarnem drevesu s N listi je navzočih 2N-1 vozlišč, in Huffmanovo drevo je popolno binarno drevo, torej algoritem deluje v O(Nlog(N)) časa, kjer N je število simbolov.
Viri:
Izvor: habr.com
