

Običajno za spremljanje in analizo delovanja Nginx uporabljajo komercialne produkte ali pripravljene odprtokodne alternative, kot sta Prometheus in Grafana. To je dobra izbira za spremljanje ali analitiko v realnem času, vendar ni preveč priročna za zgodovinsko analizo. Na priljubljeni spletni strani se količina podatkov iz Nginx logov hitro povečuje, zato je logično uporabiti nekaj bolj specializiranega za analizo velikega obsega podatkov.
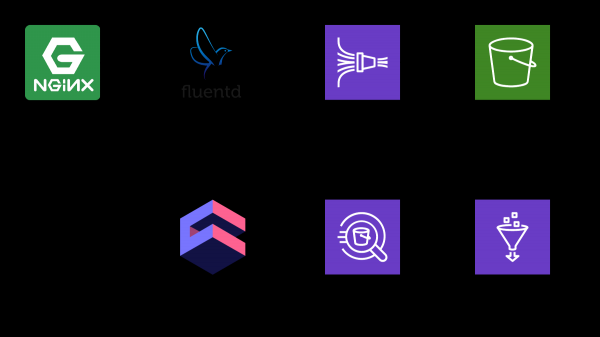
V tem članku bom predstavil, kako lahko uporabite za analizo logov, s poudarkom na Nginx, in pokazal, kako iz teh podatkov sestaviti analitični nadzorno ploščo z uporabo odprtokodnega okvira cube.js. Tukaj je celotna arhitektura rešitve:
TL:DR;
.
Za zbiranje informacij uporabljamo , za procesiranje — in , za shranjevanje — . S pomočjo te kombinacije lahko shranjujemo ne le Nginx loge, temveč tudi druge dogodke in loge drugih storitev. Nekatere dele lahko zamenjate z analogi za vašo tehnologijo, na primer, loge lahko pošljete neposredno v Kinesis iz Nginx, mimo fluentd, ali uporabite logstash za to.
Zbiranje Nginx logov
Privzeto so Nginx logi videti približno tako:
4/9/2019 12:58:17 PM 1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-up HTTP/2.0" 200 9168 "https://example.com/sign-in" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
4/9/2019 12:58:17 PM 1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-in HTTP/2.0" 200 9168 "https://example.com/sign-up" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
Lahko jih analizirate, vendar je veliko lažje popraviti konfiguracijo Nginx, da loge izda v JSON formatu:
log_format json_combined escape=json '{ "created_at": "$msec", '
            '"remote_addr": "$remote_addr", '
            '"remote_user": "$remote_user", '
            '"request": "$request", '
            '"status": $status, '
            '"bytes_sent": $bytes_sent, '
            '"request_length": $request_length, '
            '"request_time": $request_time, '
            '"http_referrer": "$http_referer", '
            '"http_x_forwarded_for": "$http_x_forwarded_for", '
            '"http_user_agent": "$http_user_agent" }';

access_log  /var/log/nginx/access.log  json_combined;
S3 za shranjevanje
Za shranjevanje logov bomo uporabili S3. To omogoča shranjevanje in analizo logov na enem mestu, saj lahko Athena dela z podatki v S3 neposredno. Kasneje v članku bom opisal, kako pravilno shranjevati in obdelovati loge, vendar najprej potrebujemo čist S3 vedro, v katerem ne bo nič drugega. Vnaprej razmislite, v kateri regiji boste ustvarili vedro, saj Athena ni na voljo v vseh regijah.
Ustvarjanje sheme v konzoli Athena
Ustvarili bomo tabelo v Athena za dnevnike. Potrebna bo tako za zapisovanje kot za branje, če nameravate uporabljati Kinesis Firehose. Odprite konzolo Athena in ustvarite tabelo:
SQL za ustvarjanje tabele
CREATE EXTERNAL TABLE `kinesis_logs_nginx`(
  `created_at` double,
  `remote_addr` string,
  `remote_user` string,
  `request` string,
  `status` int,
  `bytes_sent` int,
  `request_length` int,
  `request_time` double,
  `http_referrer` string,
  `http_x_forwarded_for` string,
  `http_user_agent` string)
ROW FORMAT SERDE
  'org.apache.hadoop.hive.ql.io.orc.OrcSerde'
STORED AS INPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcInputFormat'
OUTPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcOutputFormat'
LOCATION
  's3://'
TBLPROPERTIES ('has_encrypted_data'='false');
Ustvarjanje Kinesis Firehose Streza
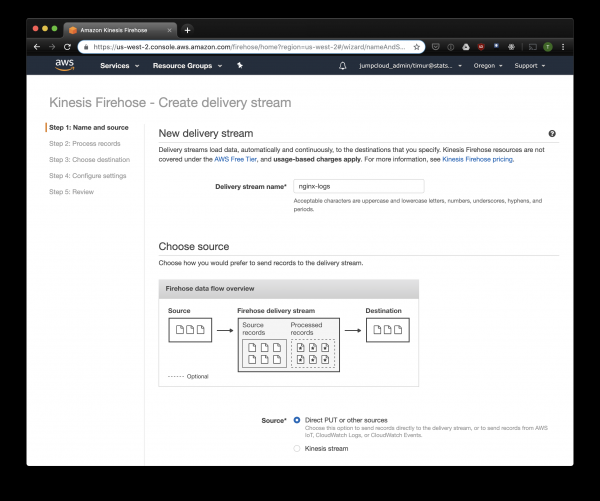
Kinesis Firehose bo zapisoval podatke, pridobljene od Nginx, v S3 v izbranem formatu, razdeljenih po imenikih v formatu LLLLL/MM/DD/ČČ. To bo koristno pri branju podatkov. Seveda lahko podatke pošljete neposredno v S3 iz fluentd, vendar boste morali napisati JSON, kar ni učinkovito zaradi velike velikosti datotek. Poleg tega, pri uporabi PrestoDB ali Athena, je JSON najpočasnejši format podatkov. Odprimo torej konzolo Kinesis Firehose, kliknemo „Create delivery stream“, izberemo „direct PUT“ v polju „delivery“:
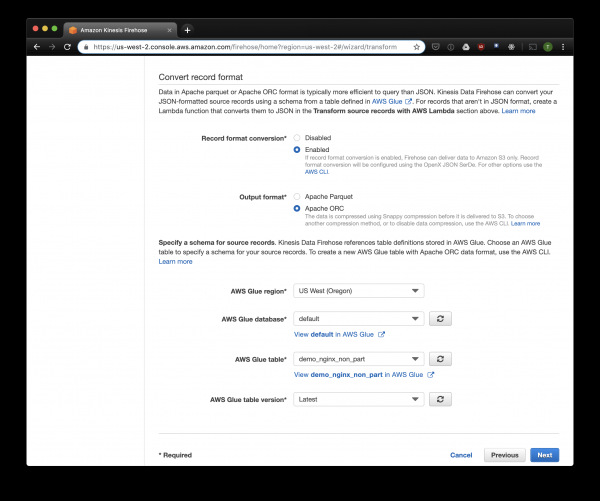
Na naslednji zavihku izberemo „Record format conversion“ — „Enabled“ in izberemo „Apache ORC“ kot format za zapis. Glede na raziskave nekaterih , to je optimalen format za PrestoDB in Athena. Kot shemo navedemo tabelo, ki smo jo ustvarili prej. Upoštevajte, da lahko S3 lokacijo v kinesis navedete kakršnokoli, iz tabele se uporablja samo shema. Če pa navedete drugo S3 lokacijo, iz te tabele teh zapisov ne boste mogli prebrati.
Izberemo S3 za shranjevanje in vedro, ki smo ga ustvarili prej. Aws Glue Crawler, o katerem bom govoril malo kasneje, ne zna delovati s predznaki v S3 vedru, zato je pomembno, da ga pustimo praznega.
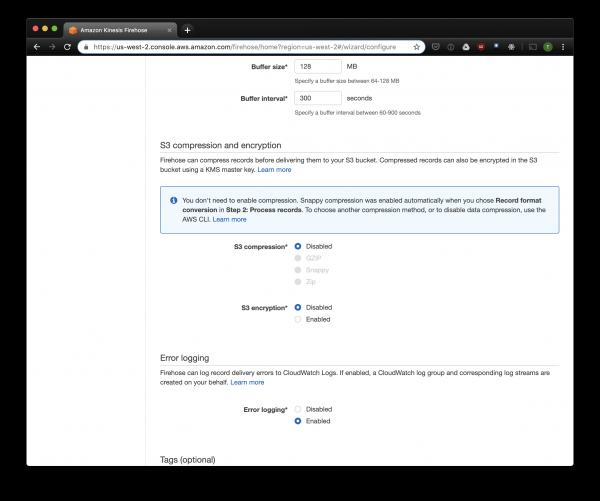
Ostale možnosti lahko spreminjate glede na svojo obremenitev, jaz običajno uporabljam privzete. Upoštevajte, da stiskanje S3 ni na voljo, vendar ORC privzeto uporablja lastno stiskanje.
Fluentd
Zdaj, ko imamo nastavljeno shranjevanje in prejemanje dnevnikov, moramo nastaviti pošiljanje. Uporabili bomo , ker imam rad Ruby, vendar lahko uporabite Logstash ali pošljete dnevnike v kinesis neposredno. Fluentd strežnik lahko zaženete na več načinov, govoril bom o dockertu, ker je to enostavno in priročno.
Na začetku potrebujemo datoteko konfiguracije fluent.conf. Ustvarite jo in dodajte source:
forward
port 24224
bind 0.0.0.0
Zdaj lahko zaženete Fluentd strežnik. Če potrebujete naprednejšo konfiguracijo, je na voljo podroben vodnik, tudi o tem, kako zgraditi svojo sliko.
$ docker run
  -d
  -p 24224:24224
  -p 24224:24224/udp
  -v /data:/fluentd/log
  -v :/fluentd/etc fluentd
  -c /fluentd/etc/fluent.conf
  fluent/fluentd:stable
Ta konfiguracija uporablja pot /fluentd/log za predpomnjenje dnevnikov pred pošiljanjem. To je mogoče storiti tudi brez tega, a takrat lahko ob ponovnem zagonu izgubite vse predpomnjene podatke, pridobljene z mukotrpnim delom. Tudi port lahko uporabite poljuben, 24224 je privzeti port Fluentd.
Zdaj, ko imamo zagnan Fluentd, lahko tja pošljemo dnevnike Nginx. Običajno zaženemo Nginx v Docker vsebniku, in v tem primeru Docker ima naravni gonilnik dnevnikov za Fluentd:
$ docker run
--log-driver=fluentd
--log-opt fluentd-address=
--log-opt tag="{{.Name}}"
-v /some/content:/usr/share/nginx/html:ro
-d
nginx
Če Nginx zaženete drugače, lahko uporabite dnevniške datoteke, v Fluentd je na voljo .
Dodali bomo v konfiguracijo Fluent analizo dnevnikov, ki je bila nastavljena prej:
@type parser
  key_name log
  emit_invalid_record_to_error false

    @type json
In pošiljanje dnevnikov v Kinesis, z uporabo :
@type kinesis_firehose
    region region
    delivery_stream_name
    aws_key_id
    aws_sec_key
Athena
Če ste vse pravilno nastavili, boste po nekem času (privzeto Kinesis shranjuje prejel podatke vsakih 10 minut) morali videti datoteke dnevnikov v S3. V meniju „monitoring“ Kinesis Firehose lahko vidite, koliko podatkov je bilo shranjenih v S3, pa tudi napake. Ne pozabite dati pravic za pisanje v S3 koš za vlogo Kinesis. Če Kinesis česa ne more razčleniti, bo napake shranil v isti koš.
Zdaj lahko podatke pregledamo v Atheni. Poglejmo, ali lahko najdemo sveže poizvedbe, pri katerih smo dobili napake:
SELECT * FROM "db_name"."table_name" WHERE status > 499 ORDER BY created_at DESC limit 10;Skener vseh zapisov na vsak poizvedbo
Zdaj so naši dnevniki obdelani in shranjeni v S3 v ORC, stisnjeni in pripravljeni na analizo. Kinesis Firehose jih je celo razdelil po direktorijih na vsako uro. Vendar, dokler tabela ni particionirana, bo Athena nalagala podatke za celotno obdobje na vsak poizvedbo, razen v redkih primerih. To je velik problem iz dveh razlogov:
- Obseg podatkov se nenehno povečuje, kar upočasnjuje poizvedbe;
- Račun za Atheno se obračunava glede na obseg pregledanih podatkov, z minimumom 10 MB za vsak poizvedbo.
Za rešitev tega uporabljamo AWS Glue Crawler, ki skenira podatke v S3 in zabeleži informacije o delitvah v Glue Metastore. To nam bo omogočilo, da uporabimo delitve kot filter pri poizvedbah v Atheni, ki bo skenirala samo direktorije, navedene v poizvedbi.
Nastavitev Amazon Glue Crawler
Amazon Glue Crawler skenira vse podatke v S3 vedru in ustvarja tabele z delitvami. Ustvarite Glue Crawler iz AWS Glue konzole in dodajte vedro, v katerem hranite podatke. Uporabite lahko enega crawlerja za več vedrov, pri čemer bo ustvaril tabele v navedeni bazi podatkov z imeni, ki se ujemajo z imeni vedrov. Če nameravate te podatke stalno uporabljati, ne pozabite nastaviti urnik za zagon crawlerja v skladu z vašimi potrebami. Uporabljamo enega crawlerja za vse tabele, ki se zbira vsakih eno uro.
Tabele z delitvami
Po prvem zagonu crawlerja v podatkovni bazi, navedeni v nastavitvah, bi se morale pojaviti tabele za vsako skenirano vedro. Odprite konzolo Athena in poiščite tabelo z Nginx dnevniki. Poskusimo prebrati nekaj:
SELECT * FROM "default"."part_demo_kinesis_bucket"
WHERE(
  partition_0 = '2019' AND
  partition_1 = '04' AND
  partition_2 = '08' AND
  partition_3 = '06'
  );
Ta poizvedba bo izbrala vse zapise, pridobljene od 6. do 7. ure 8. aprila 2019. Kako pa to učinkovitost primerjati z branjem iz tabele brez delitev? Oglejmo si in izberimo iste zapise, ki jih filtriramo po časovnem žigu:
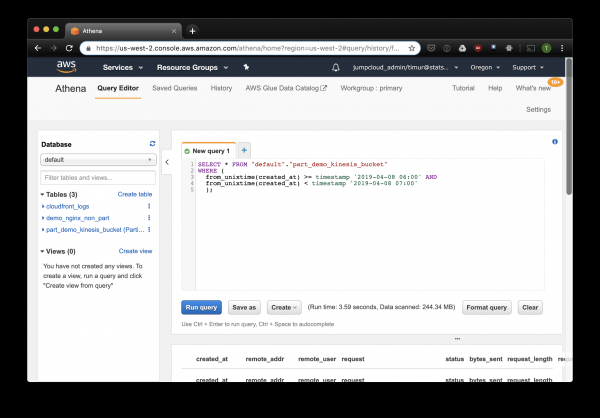
3.59 sekunde in 244.34 megabajtov podatkov na podatkovnem naboru, v katerem so logi stare le en teden. Poskusimo filtrirati po delitvah:
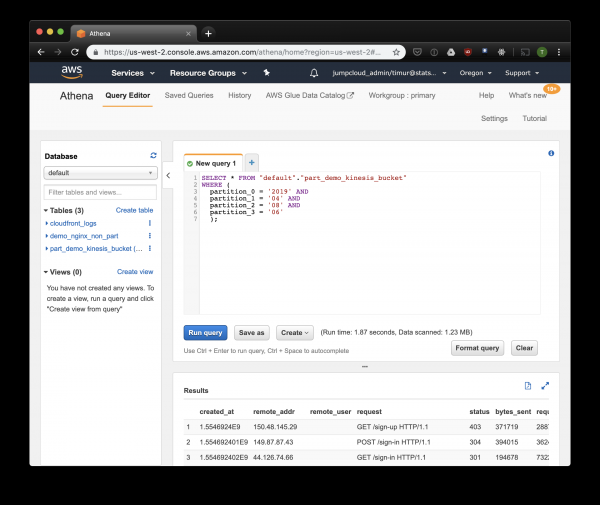
Malo hitreje, a kar je najpomembneje — le 1.23 megabajta podatkov! To bi bilo veliko ceneje, če ne bi bilo minimalnih 10 megabajtov na poizvedbo v ceniku. Kljub temu je to še vedno veliko bolje, na večjih podatkovnih nizih pa bo razlika veliko bolj presenetljiva.
Собираем дэшборд с помощью Cube.js
Za ustvarjanje nadzorne plošče uporabljamo analitični okvir Cube.js. Ima precej funkcij, vendar nas zanimata dve: zmožnost avtomatskega uporabe filtrov po delitvah in predagregacijo podatkov. Uporablja shemo podatkov , napisano v Javascriptu, da generira SQL in izvede poizvedbo na bazo podatkov. Od nas se zahteva le, da določimo, kako uporabiti filter po delitvah v shemi podatkov.
Ustvarimo novo aplikacijo Cube.js. Ker že uporabljamo AWS sklad, je smiselno uporabiti Lambda za uvajanje. Lahko uporabite express predlogo za generiranje, če nameravate gostiti Cube.js backend v Heroku ali Docker-ju. V dokumentaciji so opisane druge .
$ npm install -g cubejs-cli
$ cubejs create nginx-log-analytics -t serverless -d athena
Za nastavitev dostopa do podatkovne baze v cube.js se uporabljajo okoljske spremenljivke. Generator bo ustvaril datoteko .env, v kateri lahko navedete vaše ključe za .
Sedaj bomo potrebovali , v kateri bomo navedli, kako točno so shranjeni naši logi. Tam lahko navedete tudi, kako izračunati metrike za nadzorne plošče.
V imeniku schema, ustvarite datoteko Logs.js. Tukaj je primer podatkovnega modela za nginx:
Koda modela
const partitionFilter = (from, to) => `
    date(from_iso8601_timestamp(${from})) = date_parse(partition_0 || partition_1 || partition_2, '%Y%m%d')
    `

cube(`Logs`, {
  sql: `
  select * from part_demo_kinesis_bucket
  WHERE ${FILTER_PARAMS.Logs.createdAt.filter(partitionFilter)}
  `,

  measures: {
    count: {
      type: `count`,
    },

    errorCount: {
      type: `count`,
      filters: [
        { sql: `${CUBE.isError} = 'Yes'` }
      ]
    },

    errorRate: {
      type: `number`,
      sql: `100.0 * ${errorCount} / ${count}`,
      format: `percent`
    }
  },

  dimensions: {
    status: {
      sql: `status`,
      type: `number`
    },

    isError: {
      type: `string`,
      case: {
        when: [{
          sql: `${CUBE}.status >= 400`, label: `Yes`
        }],
        else: { label: `No` }
      }
    },

    createdAt: {
      sql: `from_unixtime(created_at)`,
      type: `time`
    }
  }
});
Tukaj uporabljamo spremenljivko , da generiramo SQL poizvedbo s filtrom za particije.
Prav tako določamo metrike in parametre, ki jih želimo prikazati na nadzorni plošči, ter navajamo pre-aggregacije. Cube.js bo ustvaril dodatne tabele s pre-aggregiranimi podatki in jih bo samodejno osveževal, ko podatki prihajajo. To omogoča ne le pospešitev poizvedb, ampak tudi zmanjšanje stroškov uporabe Athen.
Dodajmo te informacije v datoteko sheme podatkov:
preAggregations: {
  main: {
    type: `rollup`,
    measureReferences: [count, errorCount],
    dimensionReferences: [isError, status],
    timeDimensionReference: createdAt,
    granularity: `day`,
    partitionGranularity: `month`,
    refreshKey: {
      sql: FILTER_PARAMS.Logs.createdAt.filter((from, to) =>
        `select
           CASE WHEN from_iso8601_timestamp(${to}) + interval '3' day > now()
           THEN date_trunc('hour', now()) END`
      )
    }
  }
}
V tem modelu navajamo, da je treba pre-aggregirati podatke za vse uporabljene metrike ter uporabiti particioniranje po mesecih. lahko znatno pospeši zbiranje in posodabljanje podatkov.
Sedaj lahko sestavimo nadzorno ploščo!
Backend Cube.js ponuja in niz odjemalskih knjižnic za priljubljene frontend ogrodja. Uporabili bomo različico odjemalca za React za sestavo nadzorne plošče. Cube.js zagotavlja samo podatke, zato bomo potrebovali knjižnico za vizualizacije — meni je všeč , lahko pa uporabite katero koli drugo.
Strežnik Cube.js sprejema poizvedbo v , ki vsebuje zahtevane metrike. Na primer, da bi izračunali, koliko napak je Nginx posredoval na dan, je treba poslati naslednjo poizvedbo:
{
  "measures": ["Logs.errorCount"],
  "timeDimensions": [
    {
      "dimension": "Logs.createdAt",
      "dateRange": ["2019-01-01", "2019-01-07"],
      "granularity": "day"
    }
  ]
}
Namestimo Cube.js odjemalca in knjižnico React komponent preko NPM:
$ npm i --save @cubejs-client/core @cubejs-client/reactUvozimo komponente cubejs in QueryRenderer, da naložimo podatke in sestavimo nadzorno ploščo:
Koda nadzorne plošče
import React from 'react';
import { LineChart, Line, XAxis, YAxis } from 'recharts';
import cubejs from '@cubejs-client/core';
import { QueryRenderer } from '@cubejs-client/react';

const cubejsApi = cubejs(
  'YOUR-CUBEJS-API-TOKEN',
  { apiUrl: 'http://localhost:4000/cubejs-api/v1' },
);

export default () => {
  return (
     {
        if (!resultSet) {
          return 'Nalagam...';
        }

        return (


        );
      }}
    />
  )
}
Izvorne kode nadzorne plošče so na voljo na .
Izvor: habr.com
