

Dziś omówimy metryki systemu dyskowego w vSphere. Problemy ze storage'em są najczęstszą przyczyną wolnej pracy wirtualnej maszyny. W przypadku CPU i RAM troubleshooting kończy się na poziomie hypervisora, podczas gdy w problemach z dyskiem może być konieczne zbadanie sieci transmisyjnej i macierzy dyskowej.
Temat będę omawiać na przykładzie dostępu blokowego do macierzy dyskowej, chociaż przy dostępie plikowym wskaźniki są podobne.
Nekaj teorije
Kiedy mówi się o wydajności systemu dyskowego wirtualnych maszyn, zazwyczaj zwraca się uwagę na trzy ze sobą powiązane parametry:
- liczbę operacji wejścia/wyjścia (Input/Output Operations Per Second, IOPS);
- przepustowość (Throughput);
- opóźnienie operacji wejścia/wyjścia (Latency).
Liczba IOPS jest zwykle ważna dla obciążeń o charakterze losowym (random): dostęp do bloków na dysku rozmieszczonych w różnych miejscach. Przykładem takiego obciążenia mogą być bazy danych, aplikacje biznesowe (ERP, CRM) itp.
Propustnost jest ważna dla obciążeń o charakterze sekwencyjnym: dostęp do bloków umieszczonych za sobą. Na przykład takie obciążenie mogą generować serwery plikowe (choć nie zawsze) i systemy monitoringu wideo.
Przepustowość związana jest z liczbą operacji wejścia/wyjścia w następujący sposób:
Throughput = IOPS * Rozmiar bloku, gdzie Rozmiar bloku to wielkość bloku.
Rozmiar bloku jest dość ważną cechą. Nowoczesne wersje ESXi obsługują bloki o rozmiarze do 32 767 KB. Jeśli blok jest jeszcze większy, jest dzielony na mniejsze. Nie wszystkie macierze dyskowe mogą efektywnie pracować z tak dużymi blokami, dlatego w Ustawieniach zaawansowanych ESXi istnieje parametr DiskMaxIOSize. Dzięki niemu można zmniejszyć maksymalny rozmiar bloku obsługiwanego przez hypervisora (więcej ). Zalecam skonsultowanie się z producentem macierzy dyskowej przed zmianą tego parametru lub przynajmniej przetestowanie zmian na stanowisku laboratoryjnym.
Duży rozmiar bloku może negatywnie wpływać na wydajność macierzy dyskowej. Nawet jeśli liczba IOPS i throughput jest stosunkowo niewielka, przy dużym rozmiarze bloku mogą wystąpić wysokie opóźnienia. Dlatego zwracaj uwagę na ten parametr.
Opóźnienie – najzanimljivejši parametar zmogljivosti. Zamuda operacij vhod/izhod za virtualni stroj je sestavljena iz:
- zamude znotraj hipervizorja (KAVG, povprečna mila sekunda/kernel/bralna operacija);
- zamude, ki jo povzročata omrežje in shrambe podatkov (DAVG, povprečna mila sekunda/ukaz).
Skupna zamuda, ki jo vidimo v gostujočem operacijskem sistemu (GAVG, povprečna mila sekunda/gostiteljska operacija), je vsota KAVG in DAVG.
GAVG in DAVG se merita, KAVG pa se izračuna: GAVG–DAVG.
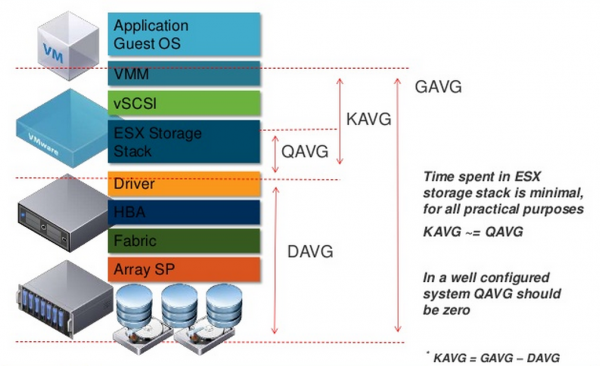
Poglejmo podrobneje o KAVG. Ob normalnem delovanju naj KAVG teži k ničli ali pa naj bo vsaj močno nižji od DAVG. Edini znan primer, ko je KAVG pričakovano visok, je omejitev IOPS na disku VM. V tem primeru se bo KAVG povečal, ko boste poskušali preseči omejitev.
Najpomembnejša sestavina KAVG je QAVG – čas v vrsti za obdelavo znotraj hipervizorja. Druge komponente KAVG so zanemarljive.
Vrsta v gonilniku diskovnega adapterja in vrste do lun je fiksne velikosti. Za okolja z visokimi obremenitvami je včasih koristno povečati to velikost. opisano, kako povečati vrste v gonilniku adapterja (s tem se bo povečala tudi vrsta do lun). Ta nastavitev deluje, ko z lun opravlja le ena VM, kar je redko. Če je na lunu več VM, je treba tudi povečati parameter Disk.SchedNumReqOutstanding (navodilo ). S povečanjem vrste zmanjšate QAVG in KAVG ustrezno.
Toda, znova, najprej se seznanite z dokumentacijo dobavitelja HBA in preizkusite spremembe na laboratorijskem testnem okolju.
Na velikost vrste do luna lahko vpliva vklop mehanizma SIOC (Storage I/O Control). Ta zagotavlja enak dostop do luna s strani vseh strežnikov v gruči z dinamičnim prilagajanjem vrste do luna na strežnikih. To pomeni, da če na katerem koli od gostiteljev deluje VM, ki zahteva nesorazmerno veliko zmogljivosti (noisy neighbor VM), SIOC zmanjša dolžino vrste do luna na tem gostitelju (DQLEN). Več o tem .
S KAVG smo razjasnili, zdaj pa malo o DAVG. Tu je vse preprosto: DAVG je zamuda, ki jo povzroča zunanje okolje (omrežje in shrambe podatkov). V vsaki sodobni in ne tako sodobni shrambi podatkov so na voljo lastni števec zmogljivosti. Za analizo težav z DAVG ima smisel, da jih preverite. Če je vse normalno s strani ESXi in shrambe podatkov, preverite omrežje.
Da bi se izbegli problemi s performansama, odaberite pravilnu politiku izbora puta (PSP) za vaš skladišni sistem. Gotovo svi savremeni skladišni sistemi podržavaju Round-Robin PSP (s ALUA, Asymmetric Logical Unit Access, ili bez). Ova politika omogućava korišćenje svih dostupnih puteva do skladišnog sistema. U slučaju ALUA koriste se samo putevi do kontrolera koji poseduje LUN. Nisu svi skladišni sistemi na ESXi postavljeni s podrazumevanim pravilima koja uspostavljaju Round-Robin politiku. Ako za vaš skladišni sistem nema pravila, koristite dodatak proizvođača skladišnog sistema koji će kreirati odgovarajuće pravilo na svim hostovima klastera, ili kreirajte pravilo sami. Detalji .
Takođe, neki proizvođači skladišnih sistema preporučuju promenu broja IOPS na putu sa standardne vrednosti 1000 na 1. U našoj praksi to je omogućilo "izvlačenje" više performansi iz skladišnog sistema i značajno skraćenje vremena potrebnog za prebacivanje u slučaju kvara ili ažuriranja kontrolera. Proverite preporuke vendor-a, i ako nema kontraindikacija, pokušajte da promenite ovaj parametar. Detalji .
Osnovni brojaci performansi diskovnog podsistema virtuelne mašine
Brojači performansi diskovnog podsistema u vCenter-u su prikupljeni u sekcijama Datastore, Disk, Virtual Disk:
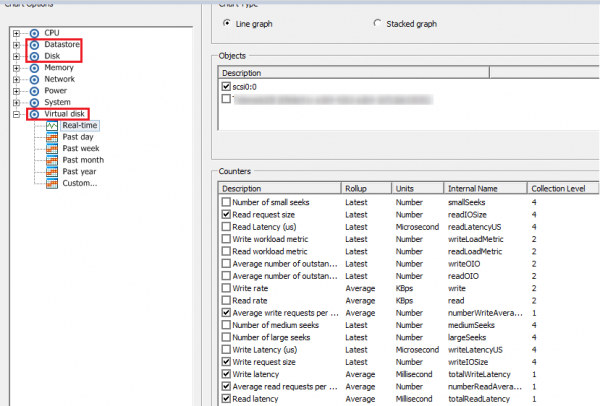
V razdelku Datastore sadrže metrike o diskovnim skladištima vSphere (datastorima), na kojima se nalaze diskovi VM-a. Ovde ćete pronaći standardne brojace za:
- IOPS (prosečne operacije čitanja/pisanja po sekundi),
- propusnost (brzina čitanja/pisanja),
- kašnjenja (čitanje/pisanje/najveće kašnjenje).
Iz naziva brojaca je uglavnom sve jasno. Još jednom ću napomenuti da ovde statistika nije specifična za određenu VM (ili disk VM-a), već je ukupna za ceo datastore. Po mom mišljenju, ovu statistiku je lakše pregledati u ESXTOP-u, barem iz razloga što je minimalni period merenja tamo 2 sekunde.
V razdelku Disk sadrže metrike o blokovnim uređajima koji se koriste u VM-u. Ovde su brojaci za IOPS u obliku sumacije (broj operacija ulaza/izlaza tokom mernog perioda) i nekoliko brojaca koji se odnose na blokovski pristup (Commands aborted, Bus resets). Ove informacije, po mom mišljenju, takođe je lakše pregledati u ESXTOP-u.
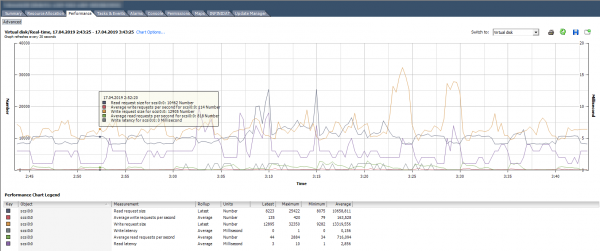
Oddelek Virtual Disk – je najkorisnija za pronalaženje problema sa performansama diskovnog sistema VM. Ovdje možete vidjeti performanse po svakom virtuelnom disku. Ove informacije su ključne za razumevanje da li postoji problem sa određenom virtuelnom mašinom. Pored standardnih mera unosa/izlaza, volumena čitanja/pisanja i latencije, u ovom odeljku su prisutni korisni merni podaci koji pokazuju veličinu bloka: Veličina čitanja/pisanja zahteva.
Na slici ispod je grafikon performansi diska VM, na kojem možete videti broj IOPS, latenciju i veličinu bloka.
Takođe, metrike performansi se mogu pregledati za ceo datastore, ako je uključen SIOC. Ovdje su predstavljene osnovne informacije o prosečnoj latenciji i IOPS-u. Podrazumevano se ove informacije mogu videti samo u realnom vremenu.
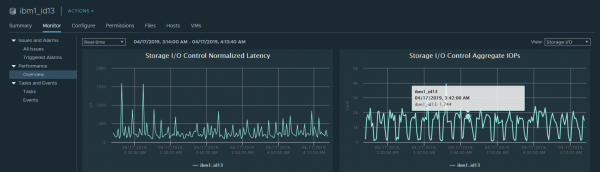
ESXTOP
U ESXTOP-u postoje više ekrana na kojima su prikazane informacije o diskovnom sistemu hosta u celini, kao i pojedinačnim virtuelnim mašinama i njihovim diskovima.
Počnimo od informacija o virtuelnim mašinama. Ekran “Disk VM” aktivira se tasterom “v”:
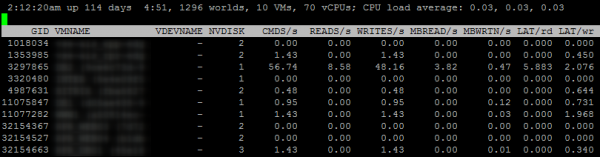
NVDISK – to je broj diskova VM. Da biste video informacije za svaki disk, pritisnite “e” i unesite GID željene virtuelne mašine.
Vrednosti ostalih parametara na ovom ekranu mogu se lako razumeti iz njihovih oznaka.
Još jedan koristan ekran pri traženju problema je Disk adapter. Aktivira se tasterom “d” (na slici ispod su izabrana polja A, B, C, D, E, G):
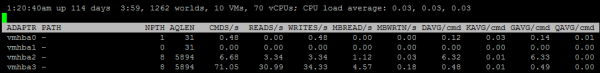
NPTH – broj puteva do lun-a koji su vidljivi sa ovog adaptera. Da biste dobili informacije o svakom putu na adapteru, pritisnite “e” i unesite naziv adaptera:
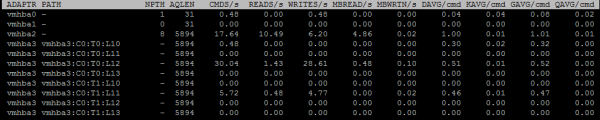
AQLEN – maksimalna veličina reda na adapteru.
Na ovom ekranu su takođe prikazani merni podaci o latenciji koje sam ranije pominjao: KAVG/cmd, GAVG/cmd, DAVG/cmd, QAVG/cmd.
Na ekranu Disk device, koji se aktivira tasterom “u”, prikazane su informacije o pojedinačnim blok uređajima – lun-ima (na slici ispod su izabrana polja A, B, F, G, I). Ovde možete videti stanje reda ka lun-ima.

DQLEN – veličina reda za blok uređaj.
ACTV – broj komandi unosa/izlaza u ESXi jezgru.
QUED – broj komandi unosa/izlaza u redu.
%USD – ACTV / DQLEN × 100%.
LOAD – (ACTV + QUED) / DQLEN.
Ako je %USD visok, treba razmotriti mogućnost povećanja reda. Što je veći broj komandi u redu, to je veći QAVG i, samim tim, KAVG.
Na zaslonu diskovnega naprava lahko prav tako preverite, ali na shranjevanju deluje VAAI (vStorage API for Array Integration). Za to morate izbrati polji A in O.
Mehanizem VAAI omogoča prenos dela dela iz hipervizorja neposredno na shranjevanje, na primer, ničeljenje, kopiranje blokov ali zaklepanja.

Kot je razvidno iz slike zgoraj, na tem shranjevanju VAAI deluje: aktivno se uporabljajo primitivi Zero in ATS.
Nasveti za optimizacijo dela z diskovno podstrukturirano na ESXi
- Upoštevajte velikost bloka.
- Nastavite optimalno velikost vrste na HBA.
- Ne pozabite vključiti SIOC na podatkovnih skladiščih.
- Izberite PSP v skladu s priporočili proizvajalca shranjevanja.
- Preverite, ali VAAI deluje.
Koristni članki na to temo:
Izvor: habr.com
