

Baza podatkov serij (TSDB, database za časovne serije) v Prometheusu 2 je odličen primer inženirskega rešitve, ki ponuja pomembne izboljšave v primerjavi s shranjevanjem v2 v Prometheusu 1, z vidika hitrosti kopičenja podatkov in izvajanja poizvedb ter učinkovitosti porabe virov. Implementirali smo Prometheus 2 v Percona Monitoring and Management (PMM), in imel sem priložnost raziskati zmogljivost TSDB Prometheus 2. V tem članku bom predstavil rezultate teh opazovanj.
Povprečna delovna obremenitev Prometheusa
Za tiste, ki so navajeni delati z običajnimi podatkovnimi bazami, je običajna delovna obremenitev Prometheusa dokaj zanimiva. Hitrost kopičenja podatkov stremi k stabilni vrednosti: ponavadi storitve, ki jih nadzorujete, pošiljajo približno enako število metrik, infrastruktura pa se spreminja razmeroma počasi.
Poizvedbe za informacije lahko prihajajo iz različnih virov. Nekateri od teh, kot so opozorila, prav tako stremejo k stabilni in predvidljivi vrednosti. Drugi, kot so uporabniške poizvedbe, lahko povzročijo vrhunce, čeprav to ni značilno za večji del obremenitve.
Obremenitveni test
Med testiranjem sem se osredotočil na sposobnost kopičenja podatkov. Razložil sem Prometheus 2.3.2, skompiliran z uporabo Go 1.10.1 (kot del PMM 1.14) na storitvi Linode z uporabo tega skripta: . Za čim bolj realistično generiranje obremenitve sem s tem zagnal več MySQL vozlišč z resnično obremenitvijo (Sysbench TPC-C Test), vsako od njih je emuliralo 10 vozlišč Linux/MySQL.
Vse spodnje teste smo izvedli na strežniku Linode z osmimi virtualnimi jedri in 32 GB pomnilnika, na katerem je bilo zagnanih 20 simulacij obremenitve za nadzor dvesto instanc MySQL. Ali, v terminih Prometheus, 800 ciljev (targets), 440 zbirk (scrapes) na sekundo, 380 tisoč vrednosti (samples) na sekundo in 1,7 milijona aktivnih časovnih serij.
Oblikovanje
Običajen pristop tradicionalnih baz podatkov, vključno s tistim, ki ga je uporabljal Prometheus 1.x, je . Če ga ni dovolj, da vzdrži obremenitev, se boste srečali z velikimi zamudami, nekateri poizvedbe pa ne bodo izvedene. Porabo pomnilnika v Prometheus 2 lahko konfigurirate preko ključa storage.tsdb.min-block-duration, ki določa, kako dolgo se zapisi hranijo v pomnilniku, preden se prenesejo na disk (privzeto je to 2 uri). Potrebna količina pomnilnika bo odvisna od števila časovnih vrst, oznak (labels) ter intenzivnosti zbiranja podatkov (scrapes), skupaj s čistim vhodnim tokom. V smislu prostora na disku si Prometheus prizadeva uporabiti 3 bite na zapis (sample). Po drugi strani pa so zahteve po pomnilniku veliko višje.
Kljub temu, da je možnost konfigurirati velikost bloka, se ne priporoča, da bi to nastavili ročno, zato ste postavljeni pred nujo, da Prometheusu omogočite toliko pomnilnika, kolikor ga bo zahteval za vašo obremenitev.
Če pomnilnika ne bo dovolj za podporo vhodnega toka metrik, bo Prometheus propadel zaradi pomanjkanja pomnilnika ali pa ga bo dosegla OOM killer.
Dodajanje swap-a, da bi odložili trenutek padca, ko Prometheusu zmanjka pomnilnika, ne pomaga prav veliko, saj ta funkcija povzroča eksplozivno porabo pomnilnika. Mislim, da gre za Go, njegov garbage collector in to, kako deluje s swapom.
Drug zanimiv pristop se zdi nastavitev prenosa head block na disk ob določenem času, namesto da bi se odštevalo od trenutka začetka procesa.
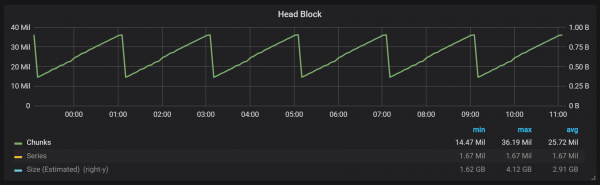
Kot lahko vidite na grafu, se prenosi na disk dogajajo vsakih dva uri. Če spremenite parameter min-block-duration na eno uro, se bodo ti prenosi dogajali vsakih eno uro, začenši čez pol ure.
Če želite uporabiti to in druge grafe v vaši namestitvi Prometheus, lahko uporabite to . Razvijena je bila za PMM, vendar jo z manjšimi spremembami lahko prilagodite kateri koli namestitvi Prometheus.
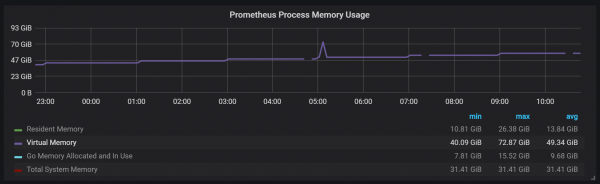
Imamo aktivni blok, imenovan head block, ki se hrani v pomnilniku; bloki z starejšimi podatki pa so dostopni preko mmap(). To odpravi potrebo po ločeni konfiguraciji predpomnilnika, pomeni pa tudi, da morate pustiti dovolj prostora za predpomnilnik operacijskega sistema, če želite izvajati poizvedbe po podatkih, starejših od tistih, ki jih vsebuje head block.
In to pomeni, da bo poraba virtualnega pomnilnika Prometheus izgledala precej visoka, kar ni razlog za skrb.
Še en zanimiv vidik oblikovanja je uporaba WAL (write ahead log). Kot je razvidno iz dokumentacije o shranjevanju, Prometheus uporablja WAL, da se izogne izgubi podatkov ob padcih. Konkretnimi mehanizmi zagotavljanja vzdržljivosti podatkov, nažalost, ni dovolj dokumentirano. Različica Prometheus 2.3.2 zapisuje WAL na disk vsakih 10 sekund, ta nastavitev pa ni uporabniško konfigurabilna.
Kompakcije (Compactions)
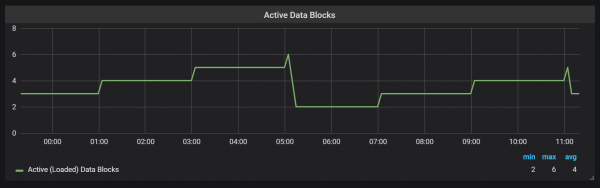
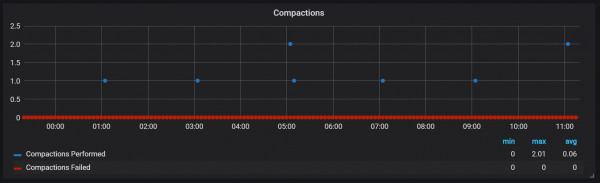
Prometheus TSDB je zasnovan po zgledu LSM-shranjevanja (Log Structured Merge — zapisno strukturirano drevo z združevanjem): glavni blok se redno zapisuje na disk, medtem ko mehanizem kompakcije združuje več blokov, da se izogne skeniranju prevelikega števila blokov pri poizvedbah. Tukaj je prikazano število blokov, ki sem jih opazoval na testnem sistemu po enem dnevu obremenitve.
Če želite izvedeti več o shranjevanju, lahko raziščete datoteko meta.json, ki vsebuje informacije o obstoječih blokih in o tem, kako so nastali.
{
       "ulid": "01CPZDPD1D9R019JS87TPV5MPE",
       "minTime": 1536472800000,
       "maxTime": 1536494400000,
       "stats": {
               "numSamples": 8292128378,
               "numSeries": 1673622,
               "numChunks": 69528220
       },
       "compaction": {
               "level": 2,
               "sources": [
                       "01CPYRY9MS465Y5ETM3SXFBV7X",
                       "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                       "01CPZ6NR4Q3PDP3E57HEH760XS"
               ],
               "parents": [
                       {
                               "ulid": "01CPYRY9MS465Y5ETM3SXFBV7X",
                               "minTime": 1536472800000,
                               "maxTime": 1536480000000
                       },
                       {
                               "ulid": "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                               "minTime": 1536480000000,
                               "maxTime": 1536487200000
                       },
                       {
                               "ulid": "01CPZ6NR4Q3PDP3E57HEH760XS",
                               "minTime": 1536487200000,
                               "maxTime": 1536494400000
                       }
               ]
       },
       "version": 1
}
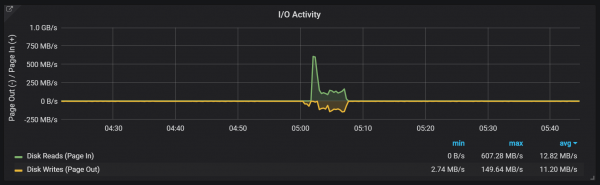
Kompakcije v Prometheus so vezane na čas zapisovanja glavnega bloka na disk. V tem trenutku se lahko izvede več takšnih operacij.
Sodeč po vsem, stiskanje ni omejeno in lahko povzroča velike skoke v disku I/O med izvajanjem.
Skoki obremenitve CPU
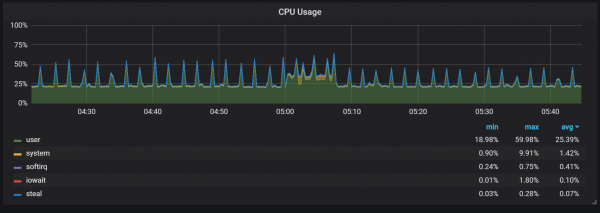
Seveda to precej negativno vpliva na hitrost delovanja sistema in predstavlja resen izziv za LSM-hrambe: kako izvajati stiskanje za podporo visoki hitrosti poizvedb in hkrati ne povzročiti prevelikega obremenjevanja?
Uporaba pomnilnika med stiskanjem se prav tako zdi precej zanimiva.
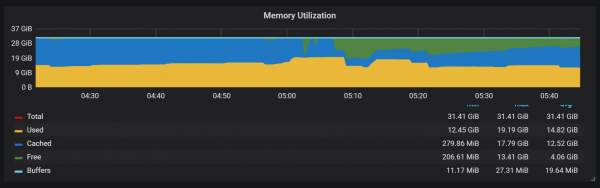
Vidimo, da po stiskanju velika večina pomnilnika spremeni stanje iz Cached v Free: to pomeni, da je potencialno dragocene informacije odstranjene. Zanimivo je, ali se tukaj uporablja fadvice() ali kakšna druga tehnika minimiziranja, ali pa je to posledica tega, da je bil predpomnilnik osvobojen blokov, ki so bili uničeni med stiskanjem?
Obnova po zrušitvi
Obnova po zrušitvah traja čas, in to je razumljivo. Za prihajajoči tok milijon zapisov na sekundo sem moral čakati približno 25 minut, medtem ko se je obnova izvajala z upoštevanjem SSD-diskov.
level=info ts=2018-09-13T13:38:14.09650965Z caller=main.go:222 msg="Začínám Prometheus" version="(version=2.3.2, branch=v2.3.2, revision=71af5e29e815795e9dd14742ee7725682fa14b7b)"
level=info ts=2018-09-13T13:38:14.096599879Z caller=main.go:223 build_context="(go=go1.10.1, user=Jenkins, date=20180725-08:58:13OURCE)"
level=info ts=2018-09-13T13:38:14.096624109Z caller=main.go:224 host_details="(Linux 4.15.0-32-generic #35-Ubuntu SMP Fri Aug 10 17:58:07 UTC 2018 x86_64 1bee9e9b78cf (none))"
level=info ts=2018-09-13T13:38:14.096641396Z caller=main.go:225 fd_limits="(soft=1048576, hard=1048576)"
level=info ts=2018-09-13T13:38:14.097715256Z caller=web.go:415 component=web msg="Začínám naslouchat připojením" address=:9090
level=info ts=2018-09-13T13:38:14.097400393Z caller=main.go:533 msg="Začínám TSDB ..."
level=info ts=2018-09-13T13:38:14.098718401Z caller=repair.go:39 component=tsdb msg="nalezena zdravá blokace" mint=1536530400000 maxt=1536537600000 ulid=01CQ0FW3ME8Q5W2AN5F9CB7R0R
level=info ts=2018-09-13T13:38:14.100315658Z caller=web.go:467 component=web msg="prefix routeru" prefix=\/prometheus
level=info ts=2018-09-13T13:38:14.101793727Z caller=repair.go:39 component=tsdb msg="nalezena zdravá blokace" mint=1536732000000 maxt=1536753600000 ulid=01CQ78486TNX5QZTBF049PQHSM
level=info ts=2018-09-13T13:38:14.102267346Z caller=repair.go:39 component=tsdb msg="nalezena zdravá blokace" mint=1536537600000 maxt=1536732000000 ulid=01CQ78DE7HSQK0C0F5AZ46YGF0
level=info ts=2018-09-13T13:38:14.102660295Z caller=repair.go:39 component=tsdb msg="nalezena zdravá blokace" mint=1536775200000 maxt=1536782400000 ulid=01CQ7SAT4RM21Y0PT5GNSS146Q
level=info ts=2018-09-13T13:38:14.103075885Z caller=repair.go:39 component=tsdb msg="nalezena zdravá blokace" mint=1536753600000 maxt=1536775200000 ulid=01CQ7SV8WJ3C2W5S3RTAHC2GHB
level=error ts=2018-09-13T14:05:18.208469169Z caller=wal.go:275 component=tsdb msg="Zjištěna korupce WAL; truncating" err="neočekávaná CRC32 kontrolní součet d0465484, chci 0" file=\/opt\/prometheus\/data\/.prom2-data\/wal\/007357 pos=15504363
level=info ts=2018-09-13T14:05:19.471459777Z caller=main.go:543 msg="TSDB spuštěn"
level=info ts=2018-09-13T14:05:19.471604598Z caller=main.go:603 msg="Načítání konfiguračního souboru" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499156711Z caller=main.go:629 msg="Dokončeno načítání konfiguračního souboru" filename=\/etc\/prometheus.yml
level=info ts=2018-09-13T14:05:19.499228186Z caller=main.go:502 msg="Server je připraven přijímat webové požadavky."
Hlavním problémem procesu obnovy je vysoká spotřeba paměti. I když server může ve standardních situacích pracovat stabilně s touto stejnou množinou paměti, při havárii se nemusí úspěšně obnovit kvůli OOM. Jediným řešením, které jsem našel, je vypnout sběr dat, spustit server, dovolit mu obnovit se a poté jej restartovat se zapnutým sběrem.
Zahřívání
Dalším chováním, na které je třeba pamatovat během zahřívání, je poměr nízkého výkonu a vysoké spotřeby zdrojů hned po spuštění. Při některých, ale ne všech spuštěních jsem pozoroval výraznou zátěž na CPU a paměti.
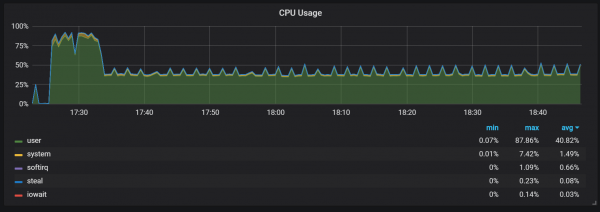
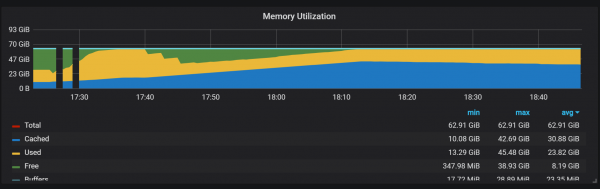
Výpadky ve využívání paměti ukazují na to, že Prometheus nedokáže při startu nakonfigurovat všechny sběry a nějaké informace tak zůstávají ztraceny.
Nisem odkril natančnih razlogov za visoko obremenitev procesorja in pomnilnika. Sumim, da je to povezano s hitro ustvarjanjem novih časovnih vrst v glavni blok.
Preskoki obremenitve CPU
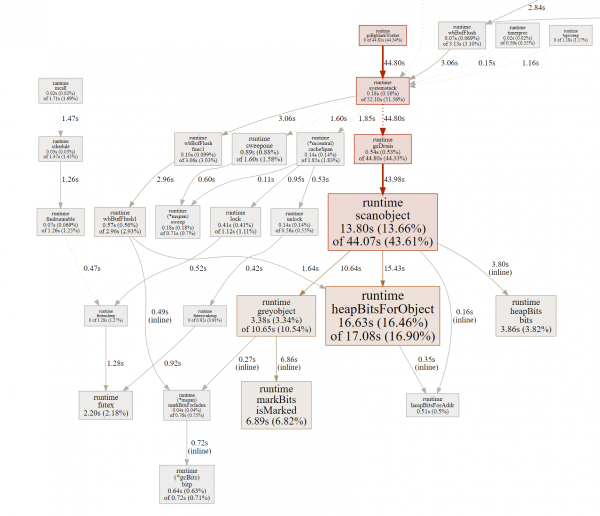
Poleg tesnil, ki povzročajo precej visoke obremenitve I/O, sem opazil resne preskoke obremenitve procesorja vsakih dve minuti. Vrški trajajo dlje pri visokom vhodnem toku in zdi se, da so povzročeni z zbiralcem smeti Go, vsaj nekateri jedri so popolnoma obremenjeni.
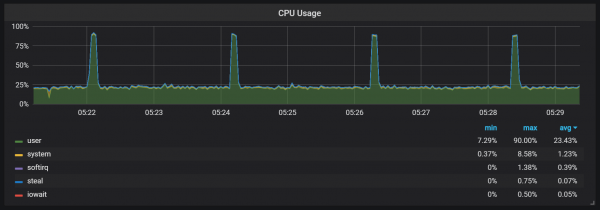
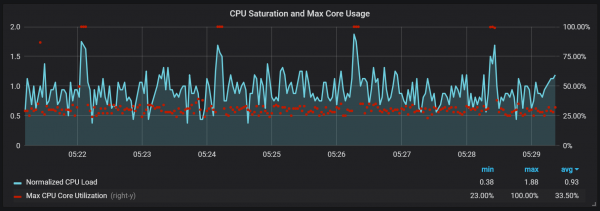
Ti preskoki niso brez pomena. Zdi se, da ko se pojavijo, notranja vstopna točka in metrične podatke Prometheus postanejo nedostopni, kar povzroča izgube podatkov v teh istih časovnih odsekih.
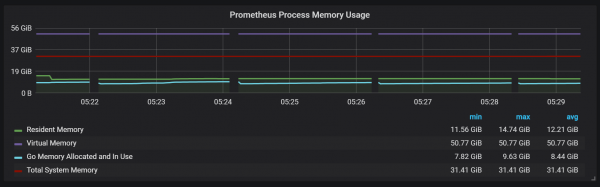
Opaziti je tudi, da se Prometheusov izvoznik zatakne za eno sekundo.
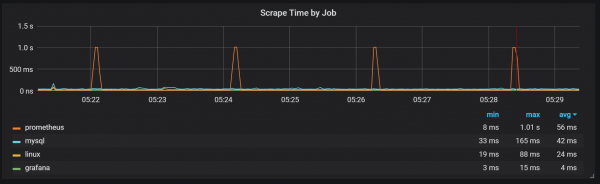
Lahko opazimo korelacije s čiščenjem smeti (GC).
Zaključek
TSDB v Prometheus 2 deluje hitro, sposoben obvladovati milijone časovnih vrst in hkrati tisoče zapisov na sekundo, ob uporabi precej skromne strojne opreme. Uporaba CPU in disčnega I/O je prav tako impresivna. Moj primer je pokazal do 200.000 metrik na sekundo na eno uporabljeno jedro.
Pri načrtovanju širitve je treba upoštevati zadostne količine pomnilnika, pri čemer mora biti ta resničen pomnilnik. Količina uporabljenega pomnilnika, ki sem jo opazil, je znašala približno 5 GB na 100.000 zapisov na sekundo vhodnega toka, kar skupaj s predpomnilnikom operacijskega sistema znaša približno 8 GB zasedenega pomnilnika.
Seveda je še veliko dela pri omejevanju preskokov CPU in disčnega I/O, kar ni presenetljivo, glede na to, kako mlada je še TSDB Prometheus 2 v primerjavi z InnoDB, TokuDB, RocksDB, WiredTiger, vendar so vsi imeli podobne težave na začetku življenjskega cikla.
Izvor: habr.com
