

Pozdrav, jaz sem Dmitrij Logvinenko — Data Engineer v oddelku za analitiko skupine podjetij „Veže”.
Povedal vam bom o čudovitem orodju za razvijanje ETL-procesov — Apache Airflow. Vendar je Airflow tako vsestranski in bogat, da se mu morate posvetiti tudi, če se ne ukvarjate s pretoki podatkov, ampak imate občasno potrebo po zagonu kakršnih koli procesov in spremljanju njihovega izvajanja.
In ja, ne bom le govoril, temveč tudi pokazal: program vsebuje veliko kode, posnetkov zaslona in priporočil.
Kaj običajno vidiš, ko googlaš besedo Airflow / Wikimedia Commons
Taula de continguts
Uvod
Apache Airflow — je prav tako kot Django:
- napisan v Pythonu,
- ima odličen administrativni vmesnik,
- neomejeno razširljiv,
— le da je boljši, narejen pa je povsem za druge namene, in sicer (kot je zapisano pred katom):
- zagon in spremljanje nalog na neomejenem številu računalnikov (kolikor vam omogočajo Celery/Kubernetes in vaša vest)
- s dinamičnim generiranjem delovnega toka iz zelo enostavno pisljivega in razumljivega Python-kode
- in možnostjo povezovanja katerikoli podatkovni baze in API z uporabo tako pripravljenih komponent kot tudi doma izdelanih pluginov (kar je izjemno preprosto).
Apache Airflow uporabljamo tako:
- zbira podatke iz različnih virov (mnogo primerkov SQL Server in PostgreSQL, različni API-ji z metričnimi podatki aplikacij, celo 1C) v DWH in ODS (pri nas sta to Vertica in Clickhouse).
- kot napreden
cron, ki zažene procese konsolidacije podatkov na ODS, pa tudi spremlja njihovo vzdrževanje.
Do nedavnega so naše potrebe pokrivali en majhen strežnik z 32 jedri in 50 GB pomnilnika. V Airflow trenutno deluje:
- več kot 200 dagov (pravzaprav delovni tokovi, v katere smo naložili naloge),
- v vsakem v povprečju po 70 nalog,
- to dobrino zaženemo (prav tako v povprečju) enkrat na uro.
O tem, kako smo se širili, bom napisal spodaj, zdaj pa določimo über-nalogo, ki jo bomo reševali:
Imamo tri izvorna SQL Servera, po 50 baza podataka na svakom — instanci jednog projekta, stoga, struktura im je ista (gotovo svuda, muha-ha-ha), što znači da u svakoj postoji tabela Orders (dobro, tabelu s tim nazivom možete staviti u svaku vrstu poslovanja). Uzimamo podatke, dodajući korisna polja (izvor-server, izvor-baza, identifikator ETL-zadatka) i naivno ih ubacujemo u, recimo, Verticu.
Gremo!
Glavni del, praktičen (in nekaj teoretičnega)
Zakaj ga potrebujemo (in vi)
Kada su drveća bila velika, a ja sam bio običan SQL-radnik u jednom ruskom maloprodajnom lancu, provodili smo ETL procese, odnosno tokove podataka, koristeći dva dostupna alata:
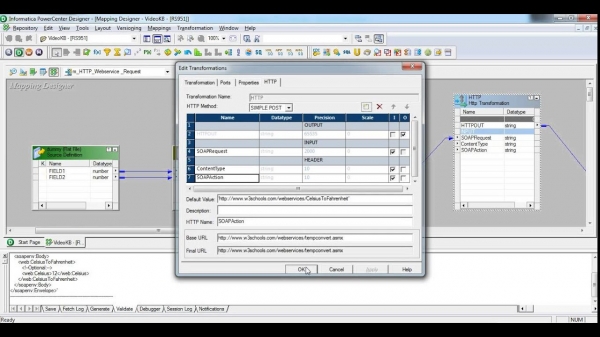
- Informatica Power Center — izuzetno složen sistem, izuzetno produktivan, sa sopstvenim hardverom, sopstvenim verzioniranjem. Koristio sam, bože sačuvaj, 1% njenih mogućnosti. Zašto? Pa, prvo, ovaj interfejs izgleda kao da je iz nultih, psihički nas je pritiskao. Drugo, ova naprava je prilagođena izuzetno komplikovanim procesima, žestokom ponovnom korišćenju komponenti i drugim veoma važnim preduzećima-specijalitetima. O ceni, koja je kao krilo Airbus A380/godinu, ćemo ćutati.
Pazite, screenshot može povrediti ljude mlađe od 30

- SQL Server Integration Server — ovim smo se koristili u našim unutrašnjim projektima. Pa, uistinu: SQL Server već koristimo, i ne koristiti njegove ETL alate bilo bi nekako nerazborito. Sve je u njemu dobro: i interfejs je lep, i izveštaji o izvršenju... Ali ne volimo softverske proizvode zbog toga, oh, ne zbog toga. Verzije možemo
dtsx(koji predstavlja XML sa premešanim čvorovima prilikom čuvanja) možemo verzionirati, ali kakva korist? A napraviti paket zadataka koji će prebaciti stotinu tabela sa jednog servera na drugi? Da, šta stotinu, od dvadeset će vam otpasti kažiprst koji klikće po mišu. Ali se, definitivno, čini moderan:
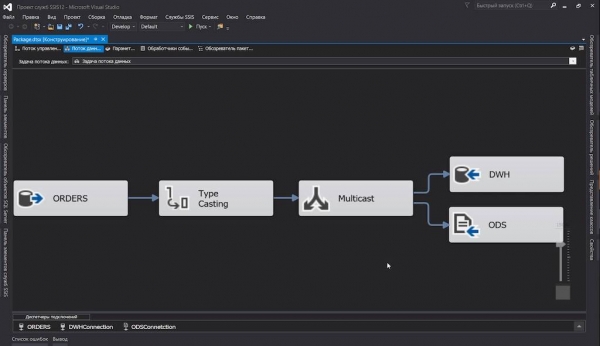
Nesumnjivo smo tražili izlaze. Stvar je čak gotovo došla do samostalnog generatora SSIS paketa...
... a onda me je pronašao novi posao. A na njemu me je sustigao Apache Airflow.
Kada sam saznao da su opisi ETL procesa samo običan Python kod, jedva sam izdržao da ne plešem od radosti. Tako su tokovi podataka došli do verzioniranja i diffa, a prebacivanje tabela sa jedinstvenom strukturom iz stotinu baza podataka u jedan cilj postalo je stvar Python koda na jedan i po do dva 13” ekrana.
Zbiramo klaster
Zavrzimo s tem otroškim vrtičkom in ne govorimo o očitnih stvareh, kot so namestitev Airflow, izbrana baza podatkov, Celery in druge stvari, opisane v dokumentaciji.
Da bomo lahko takoj začeli z eksperimentiranjem, sem pripravljen docker-compose.yml v katerem:
- Začnimo z dejansko Airflow: Scheduler, Webserver. Tam bo prav tako tekel Flower za spremljanje Celery nalog (ker je že vključen v
apache/airflow:1.10.10-python3.7, in nismo proti); - PostgreSQL, v katerega bo Airflow zapisoval svoje delovne informacije (podatki o načrtovalniku, statistika izvajanja itd.), Celery pa bo beležil končane naloge;
- Redis, ki bo deloval kot posrednik nalog za Celery;
- Celery delavec, ki se bo ukvarjal z neposrednim izvajanjem nalog.
- V mapo
. /dagsbomo shranjevali naše datoteke z opisi dagov. Ti bodo zajeti v realnem času, zato po vsakem majhnem premikanju ni treba znova zagnati celotnega sklada.
Marsikje je koda v primerih prikazana nepopolna (da ne bi obremenjevala besedila), drugod pa se med postopkom spreminja. Celovite delujoče primere kode si lahko ogledate v repozitoriju. .
docker-compose.yml
version: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: /dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2://airflow:airflow@airflow-db:5432/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis://broker:6379/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql://airflow:airflow@airflow-db/airflow

x-airflow-base: &airflow-base
  image: apache/airflow:1.10.10-python3.7
  entrypoint: /bin/bash
  restart: always
  volumes:
    - ./dags:/dags
    - ./requirements.txt:/requirements.txt

services:
  # Redis as a Celery broker
  broker:
    image: redis:6.0.5-alpine

  # DB for the Airflow metadata
  airflow-db:
    image: postgres:10.13-alpine

    environment:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volumes:
      - ./db:/var/lib/postgresql/data

  # Main container with Airflow Webserver, Scheduler, Celery Flower
  airflow:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint initdb &&
          (/entrypoint webserver & ) &&
          (/entrypoint flower & ) &&
           /entrypoint scheduler"

    ports:
      # Celery Flower
      - 5555:5555
      # Airflow Webserver
      - 8080:8080

  # Celery worker, will be scaled using `--scale=n`
  worker:
    <<: *airflow-base

    environment:
      <
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint worker"

    depends_on:
      - airflow
      - airflow-db
      - broker
Opombe:
- При создании композиций я во многом опирался на известный образ — обязательно посмотрите. Может, вам больше ничего и не понадобится.
- Все настройки Airflow доступны не только через
airflow.cfg, но и через переменные среды (благодарим разработчиков), чем я активно воспользовался. - Естественно, он не готов к продакшену: я намеренно не ставил heartbeat на контейнеры и не заморачивался с безопасностью. Но хотя бы минимальный подходящий для наших экспериментов я создал.
- Обратите внимание, что:
- Папка с дагами должна быть доступна как планировщику, так и работникам.
- То же самое касается всех сторонних библиотек — они все должны быть установлены на машинах с шедулером и работниками.
Ну а теперь просто:
$ docker-compose up --scale worker=3После того, как всё поднимется, можно смотреть на веб-интерфейсы:
- Airflow:
- Flower:
Osnovni pojmi
Če niste razumeli vseh teh "dagov", tukaj je kratek slovar:
- Načrtovalec — najpomembnejša oseba v Airflowu, ki skrbi, da delajo roboti, ne ljudje: spremlja urnik, posodablja dage, zažene naloge.
Na splošno je imel v starih različicah težave s pomnilnikom (ne, ne amnezija, ampak uhajanje) in v konfugiracijah je ostal stari parameter
run_duration— interval njegove ponovne zagonitve. Toda zdaj je vse v redu. - DAG (tudi "dag") — "usmerjeni aciklični graf", toda ta definicija malo komu kaj pove, dejansko pa je to vsebnik za naloge, ki med seboj sodelujejo (glej spodaj) ali analog paketa v SSIS in delovnega toka v Informatica.
Poleg dagov so lahko tudi poddagi, vendar do njih verjetno ne bomo prišli.
- DAG Run — inicializiran dag, ki mu je dodeljen svoj
execution_date. Dagani istega daga lahko delujejo paralelno (če so seveda vaše naloge idempotentne). - Operater — to so kosi kode, odgovorni za izvajanje določenih dejanj. Obstajajo trije tipi operaterjev:
- akcija, na primer naš priljubljeni
PythonOperator, ki zmore izvesti katero koli (veljavno) Python kodo; - prenos, ki prenašajo podatke z enega mesta na drugo, recimo,
MsSqlToHiveTransfer; - senzor pa omogoča reagiranje ali ustavljanje nadaljnjega izvajanja daga, dokler ne nastopi določeni dogodek.
HttpSensorlahko pokliče določen končni točko, in ko prejme želeni odgovor, zažene prenosGoogleCloudStorageToS3Operator. Radoveden um se bo vprašal: "zakaj? Kajti ponovitve lahko opravimo kar znotraj operaterja!" Nato pa, da ne bi obremenjevali skladišča nalog s visenjem operaterjev. Senzor se zažene, preveri in umre do naslednjega poskusa.
- akcija, na primer naš priljubljeni
- Naloga — razglašeni operaterji ne glede na vrsto in pripeti na dag, se povišajo v nalogo.
- Instanca naloge — ko je general-načrtovalec sklenil, da je čas za pošiljanje nalog boju izvajalcem-delavcem (kar na mestu, če uporabljamo
LocalExecutorali na oddaljeno vozlišče v primeruCeleryExecutor), jim dodeli kontekst (tj. niz spremenljivk — parametrov izvajanja), razširi predloge ukazov ali poizvedb in jih zloži v skladišče.
Generiramo naloge
Najprej bomo označili splošno shemo našega daga, nato pa se bomo vse bolj poglabljali v podrobnosti, ker uporabljamo nekaj netradicionalnih rešitev.
Torej, v najpreprostejši obliki bo tak dag videti takole:
od datetime import timedelta, datetime

od airflow import DAG
od airflow.operators.python_operator import PythonOperator

od commons.datasources import sql_server_ds

dag = DAG('orders',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

for conn_id, schema in sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
Poglejmo:
- Najprej uvozimo potrebne knjižnice in še nekaj drugega;
sql_server_ds— to jeList[namedtuple[str, str]]z imeni povezav iz Airflow Connections in bazami podatkov, iz katerih bomo pridobili našo tabelo;dag— deklaracija našega dag-a, ki mora biti nujno vglobals(), drugače ga Airflow ne bo našel. Dag-u moraš tudi povedati:- kako se imenuje
orders— to ime bo kasneje prikazano v spletnem vmesniku, - da začne delovati ob polnoči osmega julija,
- in da se naj izvaja približno na vsake 6 ur (za napredne uporabnike je tu namesto
timedelta()dovoljenacron-vrstica0 0 0/6 ? * * *, za manj napredne pa izraz kot je@daily);
- kako se imenuje
workflow()bo opravljal glavno delo, vendar ne zdaj. Zdaj bomo enostavno zapisali naš kontekst v dnevnik.- Zdaj pa preprosta magija ustvarjanja nalog:
- gremo čez naše vire;
- inicializiramo
PythonOperator, ki bo izvajal našo prazno nalogoworkflow(). Ne pozabi navesti edinstveno (v okviru dag-a) ime naloge in jo povezati z dag-om. Oznakaprovide_contextbo v funkcijo dodala dodatne argumente, ki jih bomo previdno zbrali s pomočjo**context.
Za zdaj je to vse. Kaj imamo:
- nov dag v spletnem vmesniku,
- približno sto petdeset nalog, ki se bodo izvajale hkrati (če to dovolijo nastavitve Airflow, Celery in zmogljivosti strežnikov).
No, skoraj smo to dobili.
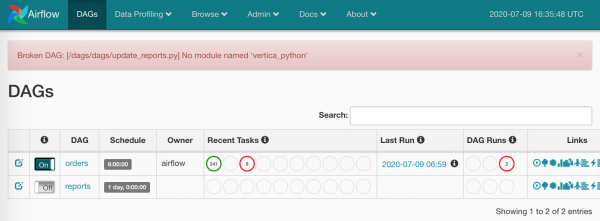
Kdo bo postavil odvisnosti?
Da bi to poenostavil, sem dodal v docker-compose.yml obdelavo requirements.txt na vseh vozliščih.
Zdaj pa gremo naprej:
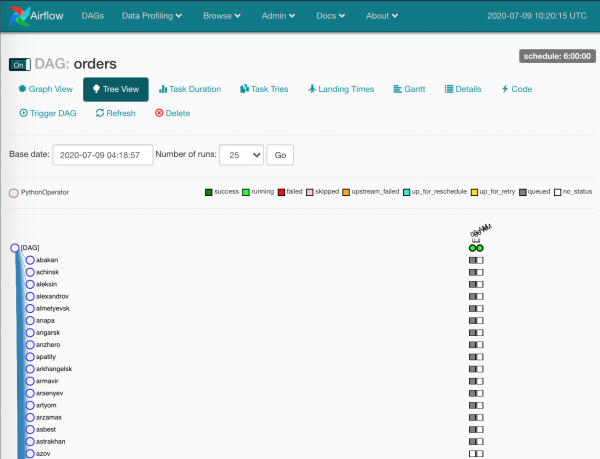
Sivi kvadrati — primeri nalog, ki jih obdeluje načrtovalnik.
Malce počakamo, naloge prevzamejo delavci:
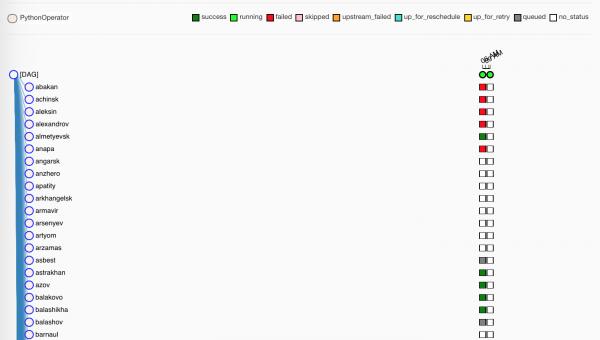
Zeleni, seveda, — uspešno izvedeni. Rdeči — ne ravno uspešni.
Mimogrede, na našem produkcijskem okolju ni nobene mape
. /dags, ki bi se sinhronizirala med stroji — vsi dag-i so vgitnašem Gitlabu, Gitlab CI pa razporedi posodobitve na stroje ob združitvi vmaster.
Malo o Flower
Medtem ko delavci izvajajo naše prazne naloge, se spomnimo še enega orodja, ki nam lahko pokaže nekaj — Flower.
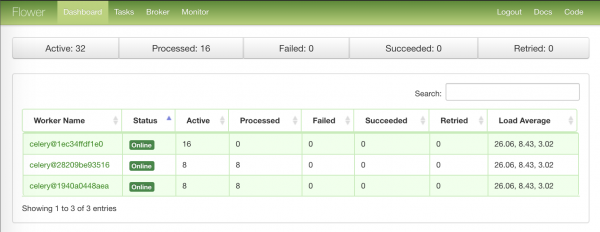
Prva stran s povzetkom informacij o delavskih vozliščih:
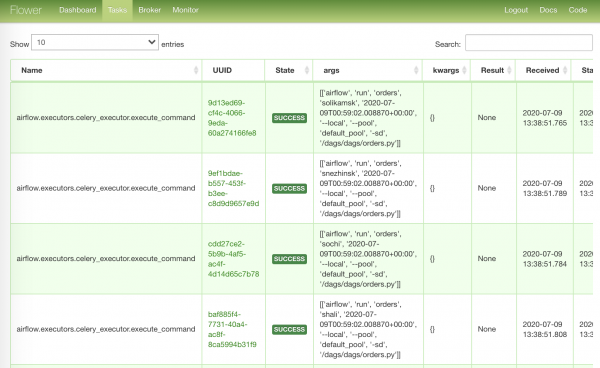
Najbolj natrpan razdelek z nalogami, ki so se začele izvajati:
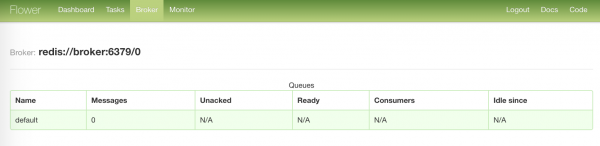
Najbolj dolgčas oddelek s stanjem našega posrednika:
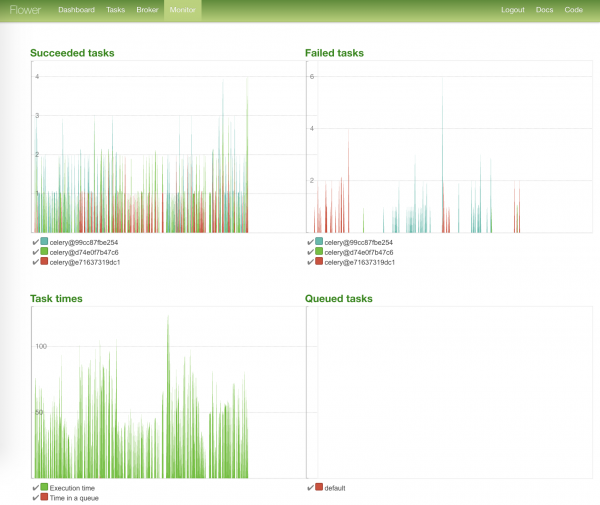
Najbolj barvit oddelek — z grafi stanja nalog in njihovimi časi izvajanja:
Nalagamo nedokončano
Torej, vse naloge so se zaključile, lahko odnesemo ranjene.
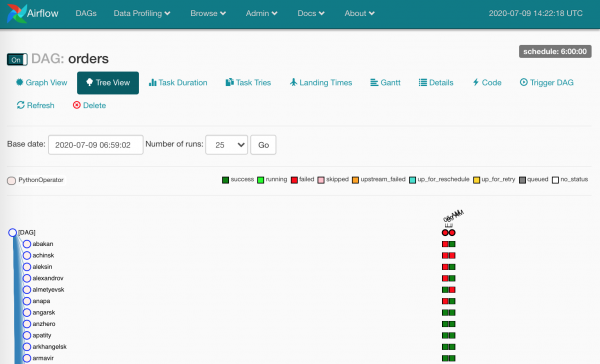
In ranjenih se je nabralo kar nekaj — iz različnih razlogov. V primeru pravilne uporabe Airflow ti kvadrati jasno kažejo, da podatki zagotovo niso prispeli.
Treba je preveriti log in znova zagnati neuspele instance nalog.
S klikom na katerikoli kvadrat, bomo videli na voljo zavezke:
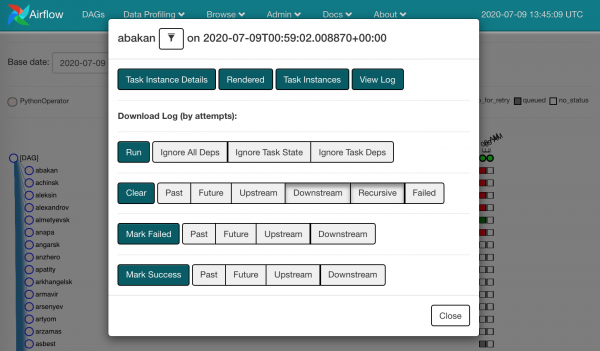
Lahko vzamemo in opravimo Clear neuspelem. To pomeni, da pozabimo, da je bilo nekaj pokvarjeno, in ista instanca naloge gre nazaj k načrtovalniku.
Seveda, tako ravnati z vsemi rdečimi kvadrati z miško ni ravno humano — to ne pričakujemo od Airflow. Seveda imamo orodje za množično uničenje: Browse/Task Instances
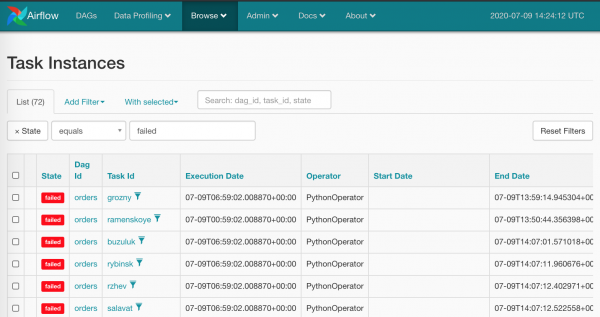
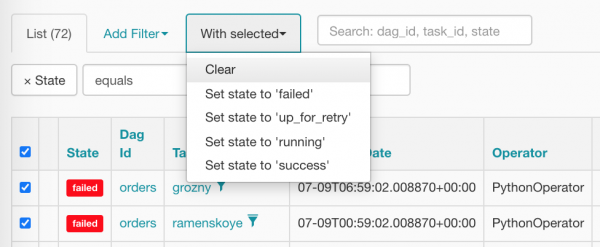
Izberemo vse hkrati in ponastavimo, pritisnemo pravilno točko:
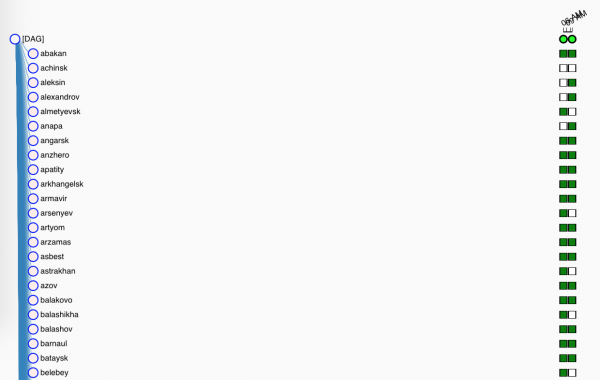
Po čiščenju naše naloge izgledajo tako (že komaj čakajo, kdaj jih bo skrbnik načrtoval):
Povezave, hooki in druge spremenljivke
Zdaj je čas, da pogledamo naslednji DAG, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='DWH Reports updated',
    html_content=dedent("""Gospodje, poročila so posodobljena"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Nataša, prebudi se, mi smo {{ dag.dag_id }} zrušili
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

    report_update >> [email, tg]
Vsi smo vsaj enkrat delali posodobitve poročil? To je ponovno to: imamo seznam virov, od koder pridobivamo podatke; imamo seznam, kamor jih shraniti; ne pozabimo opozoriti, ko se vse zgodi ali pokvari (no, to ne velja za nas, ne).
Poglejmo ponovno datoteko in si oglejmo nove nejasne stvari:
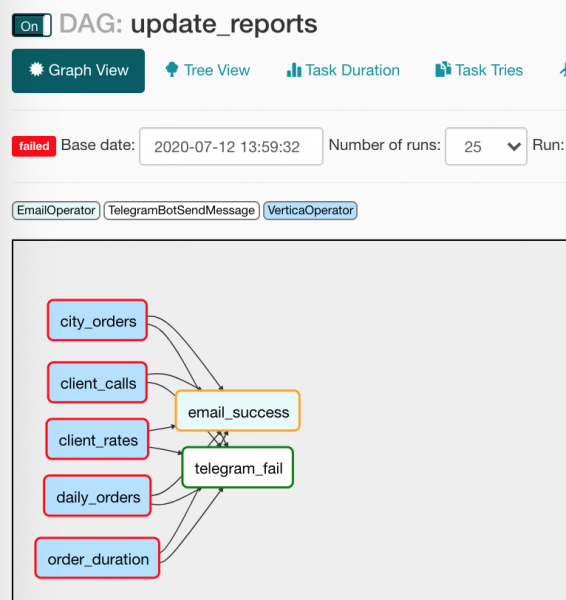
from commons.operators import TelegramBotSendMessage— nič nas ne ovira, da bi ustvarili svoje operaterje, kar smo tudi storili, ko smo naredili majhno embalažo za pošiljanje sporočil v Razblojeno. (O tem operaterju se bomo še pogovarjali spodaj);default_args={}— DAG lahko razdeli iste argumente vsem svojim operaterjem;to='{{ var.value.all_the_kings_men }}'— poljetone bo trdo kodiran, ampak se bo dinamično oblikoval s pomočjo Jinja in spremenljivke s seznamom e-poštnih naslovov, ki sem jo skrbno dal vAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— pogoj za zagon operaterja. V našem primeru bo sporočilo posredovano šefom le, če so vse odvisnosti uspešno zaključene uspešno;tg_bot_conn_id='tg_main'— argumenticonn_idsprejemajo identifikatorje povezav, ki jih ustvarimo vAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— sporočila v Telegram bodo odposlana le ob prisotnosti neuspelih nalog;task_concurrency=1— prepovedujemo hkratno izvajanje več primerkov naloge. V nasprotnem primeru bomo dobili hkratno izvajanje večVerticaOperator(ki gledajo na eno tabelo);report_update >> [email, tg]— vsiVerticaOperatorse bodo zbrali pri pošiljanju e-pošte in sporočila, tako:

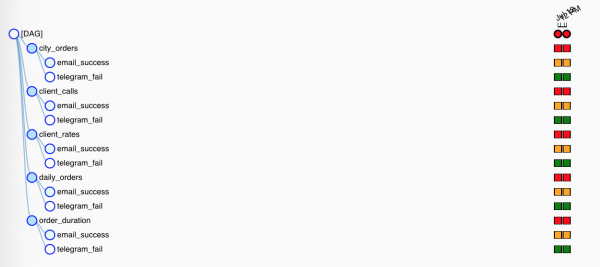
Toda ker imajo operaterji obvestil različne pogoje za zagon, bo deloval le en. V Tree View izgleda nekoliko manj pregledno:

Povedal bom nekaj besed o makrosih in njihovih prijateljih — spremenljivkah.
Makrosi so Jinja plasderji, ki lahko vstavijo različne koristne informacije v argumente operaterjev. Na primer, takole:
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
{{ ds }} se bo razširila v vsebino spremenljivke konteksta execution_date v formatu YYYY-MM-DD: 2020-07-14. Najboljše je, da so vrednosti konteksta pritrjene na določen primer naloge (kvadrat v Tree View), in ob ponovnem zagonu se bodo plasderji razkrili v iste vrednosti.
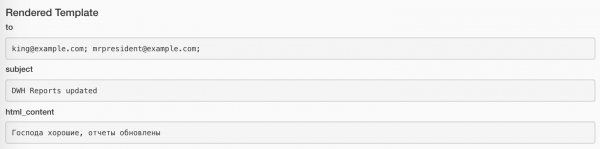
Dodeljene vrednosti si lahko ogledate s pomočjo gumba Rendered na vsakem primeru naloge. Tako izgleda naloga s pošiljanjem e-pošte:
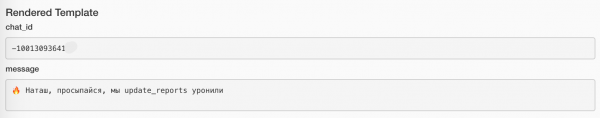
Tako pa izgleda naloga s pošiljanjem sporočila:
Celoten seznam vgrajenih makrov za zadnjo razpoložljivo različico je na voljo tukaj:
Poleg tega lahko z vtičniki razglasimo lastne makre, vendar je to že druga zgodba.
Poleg predhodno določenih stvari lahko vstavimo vrednosti svojih spremenljivk (v zgornjem kodu sem to že uporabil). Ustvarimo v Admin/Variables par stvari:
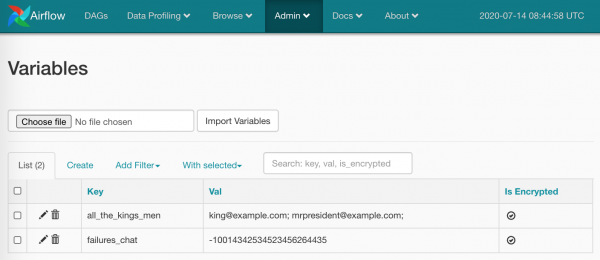
V redu, zdaj lahko uporabljamo:
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')V vrednosti je lahko skalar, lahko pa je tudi JSON. V primeru JSON:
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
samo uporabimo pot do potrebnega ključa: {{ var.json.bot_config.bot.token }}.
Povem lahko dosledno eno besedo in pokažem eno sliko o povezavah. Tu je vse preprosto: na strani Admin/Connections ustvarimo povezavo, vanjo shranimo naše uporabniške aktualne/pasovne ključe in bolj specifične parametre. Tako:
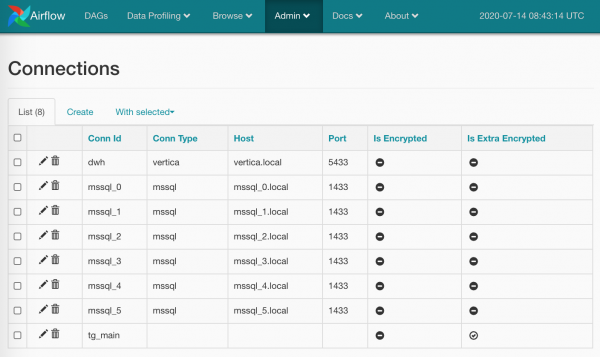
Gesla je mogoče šifrirati (bolj natančno kot v privzetem primeru), lahko pa ne navedemo tipa povezave (kot sem to storil za tg_main) — stvar je v tem, da je seznam tipov zaklenjen v modelih Airflow in se brez posega v izvorne kode ne spreminja (če sem morda kaj zgrešil — prosim, naj me popravijo), a pridobitev kredencialov samo po imenu nam nič ne preprečuje.
In prav tako lahko ustvarimo več povezav z enim imenom: v tem primeru bo metoda BaseHook.get_connection(), ki pridobi povezave po imenu, vrnila naključno iz več dvojnikov (bilo bi logično, da se izvede Round Robin, a pustimo to razvijalcem Airflow v zameno).
Spremenljivke in povezave so zagotovo odlična orodja, toda pomembno je, da ne izgubimo ravnotežja: katere dele svojih tokov hranite dejansko v kodi, in katere – predajate na shranjevanje Airflowu. S ene strani je morda priročno hitro spremeniti vrednost, na primer, poštni predal, prek UI. Po drugi strani pa se vračamo k klikanju z miško, česar smo (jaz) želeli odpraviti.
Delo s povezavami je ena izmed nalog hookov. Resda so Airflowovi vtiči točke povezave z zunanjimi storitvami in knjižnicami. Na primer, JiraHook bo odprl klienta za sodelovanje z Jira (lahko premikamo naloge nazaj in naprej), medtem ko z SambaHook lahko potisnemo lokalno datoteko na smbtočko.
Analiziramo prilagojen operator
In skoraj smo prišli do tega, da si ogledamo, kako je bil narejen TelegramBotSendMessage
Код commons/operators.py s samim operatorjem:
from typing import Union

from airflow.operators import BaseOperator

from commons.hooks import TelegramBotHook, TelegramBot

class TelegramBotSendMessage(BaseOperator):
    """Pošlji sporočilo na chat_id z uporabo TelegramBotHook

    Primer:
        >>> TelegramBotSendMessage(
        ...     task_id='telegram_fail', dag=dag,
        ...     tg_bot_conn_id='tg_bot_default',
        ...     chat_id='{{ var.value.all_the_young_dudes_chat }}',
        ...     message='{{ dag.dag_id }} failed :(',
        ...     trigger_rule=TriggerRule.ONE_FAILED)
    """
    template_fields = ['chat_id', 'message']

    def __init__(self,
                 chat_id: Union[int, str],
                 message: str,
                 tg_bot_conn_id: str = 'tg_bot_default',
                 *args, **kwargs):
        super().__init__(*args, **kwargs)

        self._hook = TelegramBotHook(tg_bot_conn_id)
        self.client: TelegramBot = self._hook.client
        self.chat_id = chat_id
        self.message = message

    def execute(self, context):
        print(f'Send "{self.message}" to the chat {self.chat_id}')
        self.client.send_message(chat_id=self.chat_id,
                                 message=self.message)
Tukaj, kot vse drugo v Airflow, je vse zelo enostavno:
- Podedovali smo
BaseOperator, ki implementira kar nekaj Airflow-specifičnih funkcij (poglejte v prostem času) - Razglasili smo polja
template_fields, v katerih bo Jinja iskala makre za obdelavo. - Organizirali smo ustrezne argumente za
__init__(), postavili privzete vrednosti, kjer je to potrebno. - O inicializaciji prednika tudi nismo pozabili.
- Odprli smo ustrezen hook
TelegramBotHook, pridobili njegovo objekt-klienta. - Prepisali smo metodo
BaseOperator.execute(), ki jo bo Airflow klical, ko bo čas za zagon operatorja — v njem uresničimo glavno dejanje, ne pozabimo se prijaviti. (Prijavimo se, mimogrede, kar vstdoutinstderr— Airflow vse ujame, lepo ovije, razvrsti, kam je potrebno.)
Poglejmo, kaj imamo v commons/hooks.py. Prvi del datoteke, sam hook:
from typing import Union

from airflow.hooks.base_hook import BaseHook
from requests_toolbelt.sessions import BaseUrlSession

class TelegramBotHook(BaseHook):
    """Telegram Bot API hook

    Opomba: dodajte povezavo z prazno vrsto povezave in ne pozabite
    izpolniti Dodatno:

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    def __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    def get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Tudi ne vem, kaj bi tukaj razlagal, samo izpostavil bom pomembne točke:
- Dedujemo, premislimo o argumentih — v večini primerov bo le en:
conn_id; - Prepisujemo standardne metode: omejil sem se na
get_conn(), v katerem pridobim parametre povezave po imenu in le izvlečem odsekextra(to polje za JSON), v katerega sem (po svoji lastni navodilih!) dal Telegram-bota token:{"bot_token": "YOuRAwEsomeBOtToKen"}. - Ustvarjam instanco našega
TelegramBot, mu predajam že točno določen token.
To je vse. Klienta iz hooka lahko dobimo s pomočjo TelegramBotHook().client ili TelegramBotHook().get_conn().
In druga del datoteke, kjer sem naredil mikroovo wrappo za Telegram REST API, da ne nosim istega zaradi enega metoda sendMessage.
class TelegramBot:
    """Ovitek API-ja Telegram Bota

    Primeri:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Hej, draga')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Hej, draga', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
Pravilna pot je, da zložimo vse to:
TelegramBotSendMessage,TelegramBotHook,TelegramBot— v vtičnik, dati v javni repozitorij in dati v odprto kodo.
Medtem ko smo vse to proučevali, so se naši posodobitveni poročili uspeli uspešno zrušiti in mi poslali sporočilo o napaki v kanal. Pojdem preverit, kaj je spet narobe...
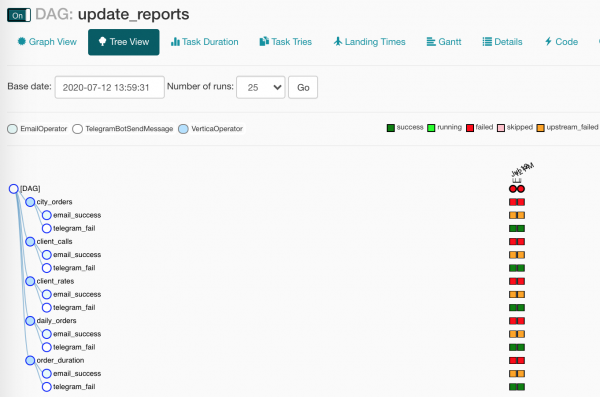
V našem dagsu je nekaj pokvarjeno! In to je bilo, kar smo čakali? Natančno!
Boste dolili?
Čutim, da sem nekaj zamudil? Zdi se, da sem obljubil, da bom prenašal podatke iz SQL Serverja v Vertico, in potem sem zlahka odstopil od teme, zlobnež!
To zlo deed je bilo namerno, preprosto sem moral razložiti nekaterih terminologij. Zdaj lahko nadaljujemo.
Naš načrt je bil naslednji:
- Ustvariti dag
- Generirati naloge
- Poglejte, kako vse lepo izgleda
- Dodeliti nalogam številke sej
- Pridobiti podatke iz SQL Serverja
- Dati podatke v Vertico
- Zbrati statistiko
Torej, da vse to zaženemo, sem naredil majhno dopolnilo našem docker-compose.yml:
docker-compose.db.yml
version: '3.4'

x-mssql-base: &mssql-base
  image: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  restart: always
  environment:
    ACCEPT_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

services:
  dwh:
    image: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    image: mio101/py3-sql-db-client-base
    command: python3 ./mssql_init.py
    depends_on:
      - mssql_0
      - mssql_1
      - mssql_2
    environment:
      SA_PASSWORD: SayThanksToSatiaAt2020
    volumes:
      - ./mssql_init.py:/mssql_init.py
      - ./dags/commons/datasources.py:/commons/datasources.py
Tuk smo nastavili:
- Vertica kot gostitelja
dwhs privzetimi nastavitvami, - tri primerka SQL strežnika,
- napolnili baze s poslednjimi nekaterimi podatki (v nobenem primeru ne poglejte v
mssql_init.py!)
Zagonimo vse skupaj z rahlo bolj zapletenim ukazom, kot je bil prejšnjič:
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3Kaj je naš čudežni generator ustvaril, lahko preverimo s pomočjo poglavja Profiliranje podatkov/Ad Hoc poizvedba:
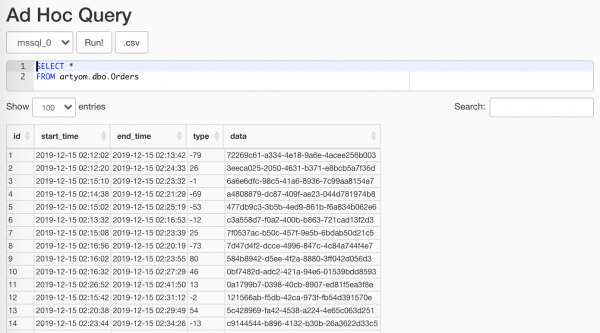
Pomembno je, da tega ne pokažete analitikom
Podrobno se ne bom ustavljal pri ETL sejah je vse preprosto: ustvarimo bazo, v njej tabelo, ovijemo vse v upravitelja konteksta, in zdaj naredimo tako:
with Session(task_name) as session:
    print('Naloženo', session.id, 'se je začelo')

    # Naloži delovni potek
    ...

    session.successful = True
    session.loaded_rows = 15
session.py
iz sys import stderr

class Session:
    """ETL delovni tok

    Primer:
        z Session(task_name) kot sejo:
            print(seja.id)
            seja.uspešna = True
            seja.naložene_vrstice = 15
            seja.komentar = 'Odlično'
    """

    def __init__(self, povezava, ime_naloge):
        self.povezava = povezava
        self.povezava.autocommit = True

        self._ime_naloge = ime_naloge
        self._id = None

        self.naložene_vrstice = None
        self.uspešna = None
        self.komentar = None

    def __enter__(self):
        return self.odpri()

    def __exit__(self, exc_type, exc_val, exc_tb):
        if any(exc_type, exc_val, exc_tb):
            self.uspešna = False
            self.komentar = f'{exc_type}: {exc_val}n{exc_tb}'
            print(exc_type, exc_val, exc_tb, file=stderr)
        self.zapri()

    def __repr__(self):
        return (f'')

    @property
    def ime_naloge(self):
        return self._ime_naloge

    @property
    def id(self):
        return self._id

    def _izvedi(self, poizvedba, *args):
        with self.povezava.cursor() as cursor:
            cursor.execute(poizvedba, args)
            return cursor.fetchone()[0]

    def _ustvari(self):
        poizvedba = """
            USTVARI TABELO, ČE NE OBSTAJA sessions (
                id          SERIAL       NOT NULL PRIMARY KEY,
                ime_naloge   VARCHAR(200) NOT NULL,

                začeto     TIMESTAMPTZ  NOT NULL DEFAULT current_timestamp,
                končano    TIMESTAMPTZ           DEFAULT current_timestamp,
                uspešna  BOOL,

                naložene_vrstice INT,
                komentar     VARCHAR(500)
            );
            """
        self._izvedi(poizvedba)

    def odpri(self):
        poizvedba = """
            VSTAVI V sessions (ime_naloge, končano)
            VREDNOSTI (%s, NULL)
            VRNE id;
            """
        self._id = self._izvedi(poizvedba, self.ime_naloge)
        print(self, 'odprto')
        return self

    def zapri(self):
        if not self._id:
            raise SessionClosedError('Seja ni odprta')
        poizvedba = """
            POSODOBI sessions
            SET
                končano    = DEFAULT,
                uspešna  = %s,
                naložene_vrstice = %s,
                komentar     = %s
            KJER
                id = %s
            VRNE id;
            """
        self._izvedi(poizvedba, self.uspešna, self.naložene_vrstice,
                      self.komentar, self.id)
        print(self, 'zaprto',
              ', uspešno: ', self.uspešna,
              ', Naloženo: ', self.naložene_vrstice,
              ', komentar:', self.komentar)

class SessionError(Exception):
    pass

class SessionClosedError(SessionError):
    pass
Prišel je čas da pridobimo naše podatke iz našega dobrih sto petdeset tabel. Dobili jih bomo s pomočjo zelo preprostih vrstic:
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

poizvedba = f"""
    IZBERI
        id, čas_začetka, čas_konca, tip, podatki
    IZ dbo.Orders
    KJER
        CONVERT(DATE, čas_začetka) = '{dt}'
    """

df = pd.read_sql_query(poizvedba, source_conn)- S pomočjo huka pridobimo iz Airflow
pymssql-povezava - V poizvedbo damo omejitev v obliki datuma — funkcija jo bo dodala s pomočjo predloge.
- K prehrani dajemo našo poizvedbo
pandas, ki nam bo dostavilaDataFrame— koristila nam bo v nadaljevanju.
Uporabljam nadomestek
{dt}namesto parametra poizvedbe%sne zato, ker sem zlobni Buratino, ampak zato, kerpandasne morem obvladati zpymssqlin podtika zadnjemuparams: Seznam, čeprav si zelo želitupla.
Upoštevajte tudi, da je razvijalecpymssqlse odločil, da ga ne bo več podpiral, in prav je, da se preselimo napyodbc.
Poglejmo, s čim je Airflow napolnil argumente naših funkcij:
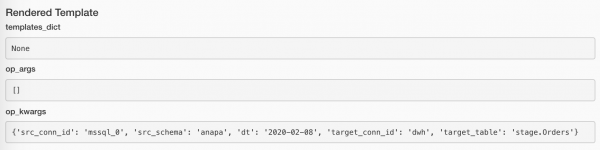
Če podatkov ni, ni smiselno nadaljevati. Vendar je tudi čudno šteti nalaganje za uspešno. A to ni napaka. Oh, kaj pa zdaj?! Torej, kaj pa:
if df.empty:
    raise AirflowSkipException('Ni vrstic za nalaganje')
AirflowSkipException bo rekel Airflow, da dejansko ni napake, nalogo pa preskočimo. V vmesniku ne bo zelene niti rdeče kvadratek, temveč barva roza.
Dodajmo našim podatkom nekaj kolon:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
Naime:
- DB, iz katere smo vzeli naročila,
- Identifikator naše nalagalne seje (ta bo drugačna za vsakoa nalogo),
- Hash iz vira in identifikatorja naročila — da imamo v končni bazi (kjer se vse zmeša v eno tabelo) edinstven identifikator naročila.
Ostal je predzadnji korak: vse naliti v Vertico. In, kot se zdi nenavadno, en od najučinkovitejših načinov za to je preko CSV!
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- Ustvarimo posebnega sprejemnika
StringIO. pandasbo prijazno shranil našoDataFramev oblikiCSV-vrstice.- Odprimo povezavo do našega ljubega Vertica preko vtičnika.
- Zdaj pa s pomočjo
copy()pošljemo naše podatke neposredno v Vertico!
Iz gonilnika vzamemo, koliko vrstic se je naložilo, in povemo upravitelju seje, da je vse v redu:
session.loaded_rows = cursor.rowcount
session.successful = True
To je to.
Na produkciji ročno ustvarimo ciljno tabelo. Tukaj sem si privoščil majhno avtomatizacijo:
create_schema_query = f'CREATE SCHEMA IF NOT EXISTS {target_schema};'
create_table_query = f"""
    CREATE TABLE IF NOT EXISTS {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
Z uporabo
VerticaOperator()ustvarjam shemo DB in tabelo (če jih seveda še ni). Ključnega pomena je, da pravilno postavimo odvisnosti:
for conn_id, schema in sql_server_ds:
    load = PythonOperator(
        task_id=schema,
        python_callable=workflow,
        op_kwargs={
            'src_conn_id': conn_id,
            'src_schema': schema,
            'dt': '{{ ds }}',
            'target_conn_id': target_conn_id,
            'target_table': f'{target_schema}.{target_table}'},
        dag=dag)

    create_table >> load
Zaključno
— No, rekel je mišek, — ali to ni res, zdaj
Se prepričal, da sem v gozdu najbolj strašna zver?
Julia Donaldson, „Gruffalo“
Mislim, da če bi s kolegi organizirali tekmovanje: kdo hitreje sestavi in zažene ETL proces od nule: oni s svojimi SSIS in miško, jaz pa z Airflow ... Potem bi še primerjali enostavnost vzdrževanja ... Uf, mislim, da se boste strinjali, da jih bom prehitel na vseh frontah!
Če pa malo resneje, je Apache Airflow — s tem, da procese opisujemo v obliko programske kode — naredil moje delo veliko bolj udobno in prijetno.
Njegova neomejena razširljivost: tako glede vtičnikov kot nagnjenosti k razširljivosti — vam daje možnost, da uporabljate Airflow praktično na katerem koli področju: bodisi v celotnem ciklu zbiranja, priprave in obdelave podatkov, bodisi pri izstrelitvi raket (na Mars, seveda).
Zaključni del, informativno-referenčni
Težave, ki smo jih zbrali za vas
start_date. Da, to je že lokalni meme. Čez glavni argument dnevastart_dategredo vsi. Na kratko, če navedete vstart_datetrenutni datum, in vschedule_interval— en dan, bo DAG zagnan jutri ne prej.start_date = datetime(2020, 7, 7, 0, 1, 2)In več nobenih težav.
S tem se povezuje še ena napaka pri izvajanju:
Task is missing the start_date parameter, ki najpogosteje pomeni, da ste pozabili povezati z operatorjem dneva.- Vse na enem računalniku. Da, tako baze (Airflow samega in naše omake), kot spletni strežnik, in razporejevalnik, in delavci. In celo je delovalo. A sčasoma se je število nalog pri storitvah povečevalo, in ko je PostgreSQL začel odgovarjati po indeksu za 20 ms namesto 5 ms, smo ga premestili.
- LocalExecutor. Da, še vedno smo na njem, in že smo pri robu prepadov. LocalExecutor nam je še vedno zadostoval, a zdaj je prišel čas, da razširimo vsaj z enim delavcem, in potrebno bo malo naprezanja, da preidemo na CeleryExecutor. In ker se ga lahko uporablja tudi na enem računalniku, nič ne preprečuje uporabe Celery, celo na strežniku, ki „naravno nikoli ne bo šel v produkcijo, prisežem!“
- Neuporaba vgrajenih sredstev:
- Connections za shranjevanje poverilnic storitev,
- SLA Misses za odzivanje na naloge, ki niso bile opravljene pravočasno,
- XCom za izmenjavo metapodatkov (sem rekel metapodatki!) med nalogami dneva.
- Zloraba pošte. Kaj naj tukaj rečem? Opozorila so bila nastavljena za vse ponovitve padlih nalog. Zdaj imam v svojem delovnem Gmail-u >90k sporočil od Airflow, in spletna pošta zavrača, da bi vzela in izbrisala več kot 100 hkrati.
Več skritih težav:
Orodja za dodatno avtomatizacijo
Da bi še bolj delali z glavo in ne z rokami, je Airflow pripravila tole:
- — še vedno ima status eksperimentalnega, kar ne ovira njegovega delovanja. Z njegovo pomočjo lahko ne samo pridobimo informacije o dagih in nalogah, temveč tudi ustavimo/zagnamo dag, ustvarimo DAG Run ali bazen.
- — preko ukazne vrstice so na voljo številna orodja, ki niso samo nepraktična za uporabo skozi WebUI, temveč v resnici sploh ne obstajajo. Na primer:
backfillje potreben za ponovni zagon instanc nalog.
Na primer, prišli so analitiki, rečejo: 'Imate pa, kolega, smeti v podatkih od 1. do 13. januarja! Popravljajte, popravljajte, popravljajte!'. In ti takoj:airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Vzdrževanje baze:
initdb,resetdb,upgradedb,checkdb. run, ki omogoča zagon ene instance naloge, brez skrbi za vse odvisnosti. Bolj pomembno je, da jo lahko zaženete prekoLocalExecutor, tudi če imate Celery-klaster.- Približno enako počne
test, le da v bazo ne piše. connectionsomogoča množično ustvarjanje povezav iz ukazne vrstice.
- — precej hardcore način interakcije, ki je namenjen vtičnikom, ne pa kopanju po njem z rokami. Ampak kdo nas lahko ustavi, da gremo v
/home/airflow/dags, zagnamoipythonin začnemo delati nered? Lahko, na primer, izvozimo vse povezave s to kodo:from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Povezava do baze metapodatkov Airflow. Pisati vanjo ne priporočam, a stanja nalog za različne specifične metrike je mogoče pridobiti veliko hitreje in enostavneje kot preko katerega koli API-ja.
Recimo, da daleč niso vse naše naloge idempotentne in lahko občasno padejo, kar je povsem v redu. Toda večje težave so že sumljive in bi jih bilo treba preveriti.
Bodite previdni, SQL!
Z ZADNJA_EXECUTIONS KOT (
IZBERI
    task_id,
    dag_id,
    execution_date,
    state,
        row_number()
        OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC) AS rn
IZ PUBLIC.TASK_INSTANCE
KJER
    execution_date > zdaj() - INTERVAL '2' DNEVA
),
neuspešne AS (
    IZBERI
        task_id,
        dag_id,
        execution_date,
        state,
        CASE KO Rn = row_number() OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC)
                 POTEM RES END AS last_fail_seq
    IZ zadnjih_exec
    KJER
        state IN ('failed', 'up_for_retry')
)
IZBERI
    task_id,
    dag_id,
    count(last_fail_seq)                       AS neuspešne,
    count(CASE KO last_fail_seq
        IN STATE = 'failed' POTEM 1 END)       AS neuspešne,
    count(CASE KO last_fail_seq
        IN STATE = 'up_for_retry' POTEM 1 END) AS up_for_retry
IZ neuspešne
SKUPINA PO
    task_id,
    dag_id
IMETI
    count(last_fail_seq) > 0
Povezave
Seveda pa so prvih deset povezav iz Googlovih iskalnih rezultatov vsebina mape Airflow iz mojih zaznamkov.
- — seveda, začeti je treba z uradno dokumentacijo, ampak kdo pa bere navodila?
- — vsaj priporočila od ustvarjalcev preberite.
- — najbolj osnovno: uporabniški vmesnik na slikah
- — dobro so opisani osnovni pojmi, če (morda!) česa niste razumeli pri meni.
- — kratek vodnik za nastavitev Airflow klustra.
- — skoraj enako zanimiv članek, le da je formalizma več, primerov pa manj.
- — o delovanju v povezavi s Celery.
- — o idempotentnosti nalog, nalaganju po ID namesto po datumu, transformacijah, strukturi datotek in drugih zanimivih stvareh.
- — odvisnosti nalog in Trigger Rule, o katerih sem omenil le na hitro.
- — kako premagati nekatere "deluje, kot je bilo načrtovano" pri načrtovalniku, naložiti izgubljene podatke in določiti prioritete nalog.
- — koristni SQL poizvedbe za metapodatke Airflow.
- — obstaja koristni oddelek o ustvarjanju prilagojenega senzorja.
- — zanimiva kratka opomba o gradnji infrastrukture na AWS za Data Science.
- — pogoste napake (ko nekdo vseeno ne bere navodil).
- — nasmeh, kako ljudje nerodno shranjujejo gesla, čeprav lahko preprosto uporabijo Povezave.
- — neizrazita propuštanja DAG-a, prosljeđivanje konteksta u funkcijama, ponovo o zavisnostima, a i o propuštanju pokretanja zadataka.
- — o korištenju
podrazumijevani argumentiinparametriu šablonima, kao i o Variables i Connections. - — priča o tome kako je raspoređivač pripremljen za Airflow 2.0.
- — pomalo zastarjela članak o implementaciji našeg klastera u
docker-compose. - — dinamički zadaci pomoću šablona i proslijeđivanja konteksta.
- — standardne i prilagođene obavijesti putem e-pošte i Slack-a.
- — Grananje zadataka, makroi i XCom.
I linkovi korišteni u članku:
- — dostupni za korištenje u šablonima.
- — Uobičajene greške prilikom izrade DAG-ova.
- —
docker-composeza eksperimente, debagiranje i ne samo. - — Python omot za Telegram REST API.
Izvor: habr.com
