

Zdravo, ja sam Sergey Yalcsev, razvijam u Yandex.Cloudu. Pre toga, vodio sam razvoj L7-balansirnika portala Yandex — kolege se šale da šta god da radim, to ispadne balansirnik. Ispričaću čitateljima Habra kako da upravljaju opterećenjem u oblaku, kakav mi vidimo idealan alat za postizanje tog cilja i kako napredujemo ka izgradnji ovog alata.
Za početak, uvodićemo neke termine:
- VIP (Virtual IP) — IP adresa balansirnika
- Server, backend, instanca — virtuelna mašina sa pokrenutom aplikacijom
- RIP (Real IP) — IP adresa servera
- Healthcheck — provera spremnosti servera
- Zona dostupnosti, Availability Zone, AZ — izolovana infrastruktura u data centru
- Region — objedinjavanje različitih AZ
Balansirnici opterećenja rešavaju tri osnovna zadatka: izvode samu balansiranje, poboljšavaju otpornost servisa i olakšavaju njegovo skaliranje. Otpornost se obezbeđuje automatskim upravljanjem saobraćajem: balansirnik prati stanje aplikacije i isključuje iz balansiranja instance koje nisu prošle provere dostupnosti. Skaliranje se obezbeđuje ravnomernim raspodelom opterećenja među instancama, kao i ažuriranjem liste instanci u hodu. Ako balansiranje ne bude dovoljno ravnomerno, neke od instanci će dobiti opterećenje koje premašuje njihov radni kapacitet, a servis će postati manje pouzdan.
Balansirnik opterećenja se često klasifikuje prema nivou protokola iz OSI modela na kojem radi. Balansirnik Oblaka radi na TCP nivou, što odgovara četvrtom nivou, L4.
Pređimo na pregled arhitekture balansirnika Oblaka. Postepeno ćemo povećavati nivo detaljnosti. Delimo komponente balansirnika u tri klase. Klasa config plane odgovara za interakciju sa korisnikom i čuva željeno stanje sistema. Control plane čuva trenutno stanje sistema i upravlja sistemima iz klase data plane, koji su direktno odgovorni za isporuku saobraćaja od klijenata do vaših instanci.
Data plane
Promet za promet prolazi kroz skupe uređaje poznate kao border routeri. Kako bi se povećala otpornost na kvarove, u jednom data centru istovremeno radi više takvih uređaja. Zatim promet dolazi do balansiranih servera, koji za klijente oglašavaju anycast IP adresu na svim AZ putem BGP-a.
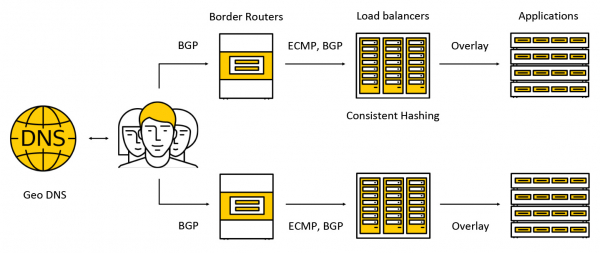
Promet se prenosi putem ECMP – to je strategija usmjeravanja prema kojoj može postojati više jednako dobrih ruta do odredišta (u našem slučaju odredišni IP adresi) i paketi se mogu slati bilo kojom od njih. Također podržavamo rad u više zona dostupnosti prema sljedećoj shemi: oglašavamo adresu u svakoj od zona, promet dolazi do najbliže i više ne izlazi iz nje. U daljnjem tekstu detaljnije ćemo pogledati što se događa s prometom.
Config plane
Ključna komponenta config planea je API, preko kojeg se obavljaju osnovne operacije s balansiranim serverima: kreiranje, brisanje, promjena sastava instanci, dobivanje rezultata healthcheckova itd. S jedne strane, to je REST API, a s druge strane, u oblaku vrlo često koristimo gRPC okvir, stoga "prevodimo" REST u gRPC i dalje koristimo samo gRPC. Svaki zahtjev dovodi do stvaranja serije asinkronih idempotentnih zadataka koji se izvršavaju na zajedničkom skupu radnika Yandex.U oblaku. Zadaci su napisani na način da se mogu u bilo kojem trenutku suspendirati, a zatim ponovo pokrenuti. To osigurava skalabilnost, ponovljivost i evidenciju operacija.
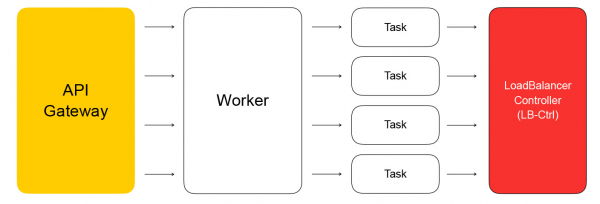
Na kraju, zadatak iz API-ja izvršit će zahtjev prema servisu kontroler balansir annih servera, koji je napisan na Go. Može dodavati i brisati balansirane servere, mijenjati sastav backendova i postavke.
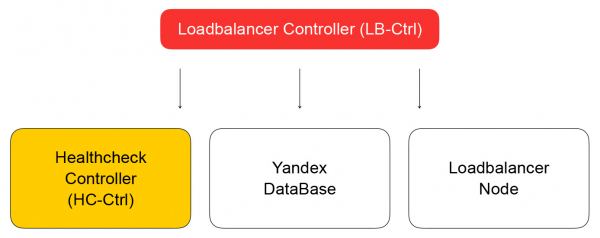
Servis čuva svoje stanje u Yandex Database – distribuiranoj upravljanoj Bazi podataka kojom ćete uskoro moći i vi upravljati. U Yandex.U oblaku, kao što smo već , djeluje koncept dog food: ako sami koristimo svoje usluge, naši klijenti će također rado koristiti njih. Yandex Database je primjer realizacije tog koncepta. Sva svoja podatke čuvamo u YDB-u, i ne moramo razmišljati o održavanju i skaliranju baze: ti problemi su riješeni umjesto nas, koristimo bazu kao uslugu.
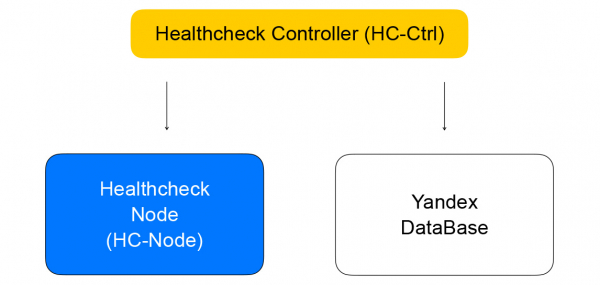
Vraćamo se kontroleru ravnoteže. Njegova svrha je da sačuva informacije o ravnoteži, da pošalje zadatak provere spremnosti virtuelne mašine kontroleru za healthcheck.
Kontroler za healthcheck
On prima zahteve za izmene pravila provere, čuva ih u YDB, raspodeljuje zadatke po healthcheck nodovima i agregira rezultate, koji se zatim čuvaju u bazi i šalju u kontroler ravnoteže. On, s druge strane, šalje zahtev za izmenu sastava klastera u data plane na loadbalancer-node, o kojem ću govoriti u nastavku.
Hajde da razgovaramo detaljnije o healthchecks. Mogu ih se podeliti u nekoliko klasa. Provere imaju različite kriterijume uspeha. TCP provere treba da uspostave vezu uspešno u fiksnom vremenskom okviru. HTTP provere zahtevaju kako uspešnu vezu, tako i dobijanje odgovora sa status kodom 200.
Takođe, provere se razlikuju po klasi delovanja — one mogu biti aktivne i pasivne. Pasivne provere jednostavno prate šta se dešava sa saobraćajem, ne preduzimajući nikakve posebne radnje. To ne funkcioniše dobro na L4, jer zavisi od logike protokola višeg nivoa: na L4 nema informacija o tome koliko je vremena operacija trajala i da li je završetak veze bio dobar ili loš. Aktivne provere zahtevaju od ravnoteže da šalje zahteve svakom instancu servera.
Većina ravnoteža opterećenja obavlja provere "živosti" samostalno. U Oblačnim rešenjima odlučili smo da podelimo ove delove sistema radi povećanja skalabilnosti. Ovakav pristup će nam omogućiti da povećamo broj ravnoteža, zadržavajući broj healthcheck zahteva na servisu. Provere se obavljaju odvojeno na healthcheck nodovima, na koje su šardovani i replikovani ciljevi provere. Ne može se vršiti provera sa jednog hosta, jer on može otkazati. U tom slučaju nećemo dobiti stanje proverenih instanci. Provere bilo koje instance se vrše minimum sa tri healthcheck nodova. Ciljevi provere se šarduju između nodova pomoću algoritama konzistentnog heširanja.
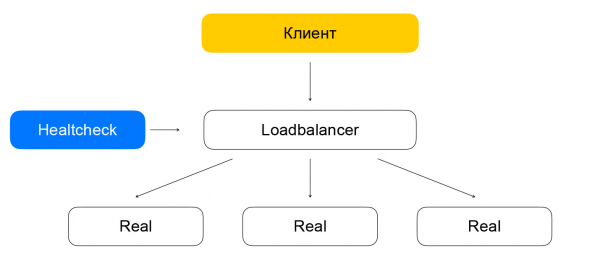
Ločitev obremenitvene uravnoteženosti in preverjanja zdravja lahko povzroči težave. Če preverjanje zdravja izvede poizvedbe proti instanci, mimo uravnoteževalnika (ki trenutno ne obravnava prometa), nastane nenavadna situacija: vir je videti živ, a promet do njega ne pride. Ta problem rešujemo na naslednji način: zagotavljamo, da promet za preverjanje zdravja potuje preko uravnoteževalnikov. Z drugimi besedami, shema prenosa paketov s prometom strank in preverjanjem zdravja se minimalno razlikuje: v obeh primerih paketi pridejo do uravnoteževalnikov, ki jih dostavijo do ciljnih virov.
Razlika je v tem, da stranke pošiljajo poizvedbe na VIP, preverjanja zdravja pa se obračajo na vsak posamezen RIP. Tukaj se pojavi zanimiv problem: našim uporabnikom omogočamo ustvarjanje virov v sivih IP-mrežah. Predstavljamo si, da obstajata dva različna lastnika oblakov, ki so skrinili svoje storitve za uravnoteževalniki. Vsak od njiju ima vire v podmreži 10.0.0.1/24, pri čemer imajo enake naslove. Tako je potrebno nekako razlikovati med njimi, zato se moramo poglobiti v strukturo virtualnega omrežja Yandex.Cloud. Podrobnosti je bolje izvedeti v , trenutno nam je pomembno, da je omrežje večplastno in vsebuje predore, ki jih je mogoče razlikovati po id podmreže.
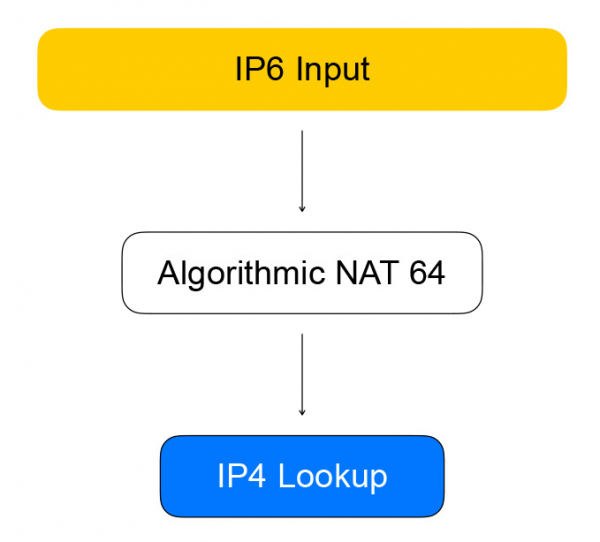
Vojske za preverjanje zdravja se obračajo na uravnoteževalnike s pomočjo tako imenovanih kvazi-IPv6 naslovov. Kvazi naslov je IPv6 naslov, v katerem je zaklenjen IPv4 naslov in id podmreže uporabnika. Promet pride na uravnoteževalnik, ki izvleče iz njega IPv4 naslov vira, zamenja IPv6 z IPv4 in pošlje paket v omrežje uporabnika.
Povratni promet poteka enako: uravnoteževalnik vidi, da je cilj - siva omrežja preverjevalnikov zdravja, in pretvori IPv4 v IPv6.
VPP - srce podatkovne ravni
Uravnoteževalnik je realiziran na tehnologiji Vector Packet Processing (VPP) - okvirju podjetja Cisco za obdelavo mrežnega prometa. V našem primeru deluje okvir nad knjižnico za upravljanje mrežnih naprav v uporabniškem prostoru - Data Plane Development Kit (DPDK). To zagotavlja visoko zmogljivost obdelave paketov: jedro doživlja bistveno manj prekinitev, ni preklapljanja konteksta med jedrskim prostorom in uporabniškim prostorom.
VPP gre še dlje in iz sistema iztisne še več zmogljivosti s kombiniranjem paketov v serije. Povečanje zmogljivosti se zgodi zahvaljujoč agresivni uporabi predpomnilnikov sodobnih procesorjev. Uporabljajo se tako predpomnilniki podatkov (paketi se obdelujejo 'z vektorji', podatki so blizu drug drugemu), kot tudi predpomnilniki navodil: v VPP obdelava paketov poteka po grafu, v katerega vozlišča so vključene funkcije, ki opravljajo en sam cilj.
Na primer, obdelava IP-paketov v VPP poteka v takem zaporedju: najprej v vozlišču razčlenjevanja poteka razčlenitev glave paketov, nato pa se ti pošljejo v vozlišče, ki poganja pakete naprej v skladu s usmerjevalnimi tabelami.
Malce hardcore. Avtorji VPP ne prenašajo kompromisov pri uporabi predpomnilnikov procesorja, zato tipična koda za obdelavo paketov vsebuje ročno vektorizacijo: obstaja cikel obdelave, v katerem se obravnava situacija 'imamo štiri pakete v vrsti', nato pa to isto za dva, nato za enega. Pogosto se uporabljajo pre-fetch ukazi, ki naložijo podatke v predpomnilnike za hitrejši dostop do njih v naslednjih iteracijah.
n_left_from = frame->n_vectors;
while (n_left_from > 0)
{
    vlib_get_next_frame (vm, node, next_index, to_next, n_left_to_next);
    // ...
    while (n_left_from >= 4 && n_left_to_next >= 2)
    {
        // obdelava več paketov hkrati
        u32 next0 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        u32 next1 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        // ...
        /* Pre-fetch naslednja iteracija. */
        {
            vlib_buffer_t *p2, *p3;

            p2 = vlib_get_buffer (vm, from[2]);
            p3 = vlib_get_buffer (vm, from[3]);

            vlib_prefetch_buffer_header (p2, LOAD);
            vlib_prefetch_buffer_header (p3, LOAD);

            CLIB_PREFETCH (p2->data, CLIB_CACHE_LINE_BYTES, STORE);
            CLIB_PREFETCH (p3->data, CLIB_CACHE_LINE_BYTES, STORE);
        }
        // dejansko obdelaj podatke
        /* preveri spekulativne vpiše, morda preklopi trenutni naslednji okvir */
        vlib_validate_buffer_enqueue_x2 (vm, node, next_index,
                to_next, n_left_to_next,
                bi0, bi1, next0, next1);
    }

    while (n_left_from > 0 && n_left_to_next > 0)
    {
        // obdelava paketov po enega
    }

    // obdelana serija
    vlib_put_next_frame (vm, node, next_index, n_left_to_next);
}
Torej, Healthchecks se obračajo na VPP po IPv6, ki jih pretvori v IPv4. S tem se ukvarja vozlišče grafa, ki ga imenujemo algoritmični NAT. Za povratni promet (in pretvorbo iz IPv6 v IPv4) obstaja enako vozlišče algoritmičnega NAT.
Neposreden promet od strank uravnoteževalnika gre skozi vozlišča grafa, ki opravljajo samo uravnoteženje.
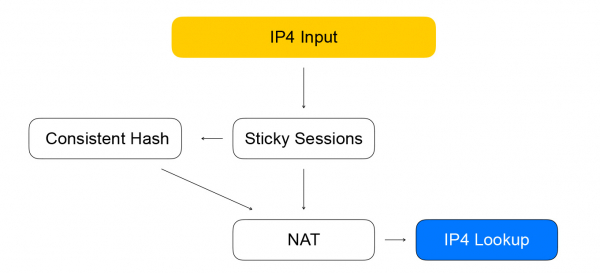
Prvo vozlišče — sticky sessions. V njem je shranjena hasha od za nameščenih sej. 5-tuple vključuje naslov in vrata odjemalca, s katerega se prenašajo informacije, naslov in vrata virov, dostopnih za sprejem prometa, ter omrežni protokol.
Hash od 5-tuple nam pomaga izvajati manj izračunov v naslednjem vozlišču doslednega razprševanja, prav tako pa bolj obvladovati spremembo seznama virov za ravnotežnikom. Ko na ravnotežnik pride paket, za katerega ni seje, se pošlje v vozlišče doslednega razprševanja. Tu se izvede ravnotežje s pomočjo doslednega razprševanja: izberemo vir iz seznama razpoložljivih "živih" virov. Nato se paketi pošljejo v vozlišče NAT, ki izvede dejansko zamenjavo naslova ciljnega in ponovno izračuna kontrolne vsote. Kot vidite, sledimo pravilom VPP — podobno k podobnemu, skupimo podobne izračune za povečanje učinkovitosti predpomnilnikov procesorja.
Dosledno razprševanje
Zakaj smo izbrali prav njega in kaj pravzaprav je? Najprej si poglejmo prejšnjo nalogo — izbiro vira iz seznama.
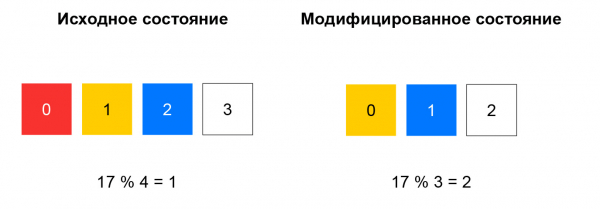
Pri nedsledljivem razprševanju izračunajo hash od prihajajočega paketa, vir pa izberejo iz seznama na podlagi ostanka deljenja tega hasha s številom virov. Dokler seznam ostaja nespremenjen, ta shema dobro deluje: vedno pošiljamo pakete z enakim 5-tuple na isti instančni. Če pa, na primer, kateri koli vir preneha odgovarjati na healthchecks, se bo izbira za pomemben delež hash-ev spremenila. TCP-povezave pri stranki se bodo prekinile: paket, ki je prej prihajal na instanco A, lahko začne prihajati na instanco B, ki za ta paket nima seje.
Dosledno razprševanje reši opisano težavo. Najlažje razložimo to koncept tako: predstavljajte si, da imate obroč, na katerega razporedite vire po hash-u (na primer, po IP:port). Izbira vira je kot obračanje kolesa pod kotom, ki ga določa hash od paketa.
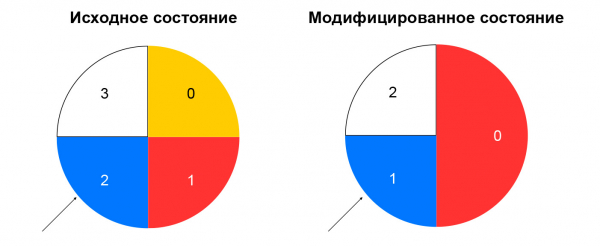
S tem se minimizira prerazporeditev prometa ob spremembi sestave virov. Odstranitev vira bo vplivala le na tisti del obroča doslednega razprševanja, na katerem se je nahajal ta vir. Dodajanje vira prav tako spremeni razporeditev, vendar imamo vozlišče sticky sessions, ki omogoča, da ne preklapljamo že vzpostavljenih sej na nove vire.
Smo smo se posvetili, kaj se dogaja s prihajajočim prometom med uravnoteževalnikom in viri. Zdaj pa se osredotočimo na povratni promet. Poteka na enak način kot promet preverjanja — preko algoritmičnega NAT, torej preko povratnega NAT 44 za promet strank in preko NAT 46 za promet healthchecks. Držimo se svoje sheme: poenotimo promet healthchecks in dejanski promet uporabnikov.
Loadbalancer-node in komponente v zbirki
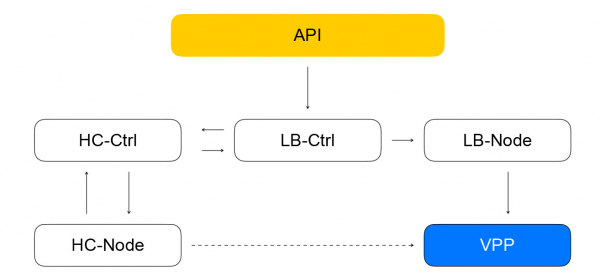
O sestavi uravnoteževalnikov in virov v VPP poroča lokalna storitev — loadbalancer-node. Naroči se na tok dogodkov od loadbalancer-controllerja, zna zgraditi razliko med trenutnim stanjem VPP in ciljnim stanjem, pridobljenim od kontrolerja. Prejeli smo zaprt sistem: dogodki iz API-ja prihajajo do kontrolerja uravnoteževalnika, ki nalaga healthcheck-kontrolerju naloge za preverjanje 'živosti' virov. Ta pa naloge prenese na healthcheck-node in agregira rezultate, nato jih pošlje nazaj kontrolerju uravnoteževalnikov. Loadbalancer-node se prijavi na dogodke od kontrolerja in spreminja stanje VPP. V takšnem sistemu vsak servis ve le tisto, kar potrebujeta o sosednjih servisih. Število povezav je omejeno in imamo možnost neodvisnega obratovanja in razširjanja različnih segmentov.
Katerih vprašanj smo se izognili
Vse naše storitve v nadzornem sistemu so napisane v Go in se ponašajo z dobrimi lastnostmi razširljivosti in zanesljivosti. V Go obstaja veliko odprtokodnih knjižnic za gradnjo porazdeljenih sistemov. Aktivno uporabljamo GRPC, vse komponente vsebujejo odprtokodno implementacijo odkrivanja storitev — naše storitve spremljajo delovanje druga druge, lahko dinamično spreminjajo svoj sestav, in to smo povezali z GRPC-uravnoteženjem. Tudi za metrike uporabljamo odprtokodno rešitev. V podatkovnem sistemu smo pridobili dostojno zmogljivost in veliko rezervo virov: izkazalo se je, da ni enostavno zbrati stojala, na katerem bi se lahko dotaknili zmogljivosti VPP in ne železne omrežne kartice.
Težave in rešitve
Kaj ni delovalo tako dobro? V Go je upravljanje z dolgoročnimi podatki avtomatsko, vendar še vedno prihaja do uhajanja pomnilnika. Najbolj preprost način za spopadanje s tem je zagon gorutin in ne pozabiti na njihovo končanje. Iz tega izhaja: spremljajte porabo pomnilnika Go programov. Pogosto je dober indikator število gorutin. V tej zgodbi je tudi prednost: v Go je enostavno pridobiti podatke o runtime-u — o porabi pomnilnika, številu aktivnih gorutin in mnogih drugih parametrih.
Poleg tega Go morda ni najboljša izbira za funkcionalne teste. Ti so precej obsežni, standardni pristop 'zagon vsega v CI v paketu' zanje ne deluje najbolje. Gre namreč za to, da so funkcionalni testi bolj zahtevni glede virov, pojavljajo se pravi časovni izzivi. Zaradi tega lahko testi ne uspejo, saj je CPU zaposlen z enotnimi testi. Iz tega izhaja: kadar je mogoče, izvajajte 'težje' teste ločeno od enotnih testov.
Mikroservisna dogodkovna arhitektura je bolj zapletena od monolita: preiskovanje logov na desetinah različnih strojev ni zelo priročno. Iz tega izhaja: če delate mikroservise, takoj razmislite o sledenju.
Naši načrti
Zagnali bomo notranji uravnoteževalnik, uravnoteževalnik IPv6, dodali podporo za scenarije Kubernetes, nadalje sharding naših storitev (trenutno so shardani samo healthcheck-node in healthcheck-ctrl), dodali nove healthchecks in uvedli pametno agregacijo preverjanj. Razmišljamo o možnosti, da bi naše storitve naredili še bolj neodvisne – da bi komunicirale ne neposredno med seboj, ampak s pomočjo sporočilne vrste. V Oblaku je nedavno prišla storitev, združljiva z SQS. .
Nedavno je potekala javna izdaja Yandex Load Balancer. Raziskujte storitev, upravljajte uravnoteževalnike na vam prijazen način in povečajte odpornost svojih projektov!
Izvor: habr.com
