

KDB+, proizvod podjetja — je široko znana v ožjih krogih, izjemno hitra, stolpčna baza podatkov, namenjena shranjevanju časovnih vrst in analitičnim izračunom na njihovi osnovi. Sprva je bila (in še vedno je) zelo priljubljena v finančni industriji — uporabljajo jo vse največje investicijske banke in mnogi znani hedž skladi, borze in druge organizacije. V zadnjem času so se pri KX odločili razširiti bazo strank in zdaj ponujajo rešitve tudi na drugih področjih, kjer je veliko podatkov, urejenih po času ali na druge načine — telekomunikacije, bioinformatika, proizvodnja itd. Med drugim so postali partner ekipe Aston Martin Red Bull Racing v Formuli 1, kjer pomagajo zbirati in obdelovati podatke iz senzorjev dirkalnikov ter analizirati teste v aerodinamičnem tunelu. V tem članku želim opisati, katere značilnosti KDB+ jo naredijo izjemno zmogljivo, zakaj so podjetja pripravljena zapravljati velike zneske zanjo in nenazadnje, zakaj to v resnici ni baza podatkov.
V tem članku bom skušal na splošno opisati, kaj KDB+ predstavlja, katere možnosti in omejitve ima ter kako je koristna za podjetja, ki želijo obdelovati velike količine podatkov. Ne bom se spuščal v podrobnosti implementacije KDB+ in v podrobnosti njenega programskega jezika Q. Obe temi sta zelo obsežni in si zaslužita posebne članke. Veliko informacij na teh temah lahko najdete na spletnem naslovu code.kx.com, vključno s knjigo o Q — Q For Mortals (glejte povezavo spodaj).
Nekateri izrazi
- In-memory baza podatkov. Baza podatkov, ki shranjuje podatke v pomnilniku za pospešitev dostopa. Prednosti take baze so očitne, slabosti pa — možnost izgube podatkov, potreba po veliko pomnilnika na strežniku.
- Stolpčna baza podatkov. Baza podatkov, kjer so podatki shranjeni po stolpcih in ne zapis za zapisom. Glavna prednost te baze je, da se podatki iz enega stolpca shranjujejo skupaj na disku in v pomnilniku, kar znatno pospešuje dostop do njih. Ni potrebe po nalaganju stolpcev, ki se ne uporabljajo v poizvedbi. Glavna slabost je, da je težko modificirati in odstranjevati zapise.
- Časovna vrsta. Podaci s kolonama tipa datum ili vreme. Obično je redosled važan za takve podatke kako bi se lako moglo odrediti koja stavka prethodi ili sledi trenutnoj, ili kako bi se primenile funkcije čiji rezultati zavise od redosleda stavki. Klasične baze podataka zasnovane su na sasvim drugačijem principu — prikazivanju skupa zapisa kao množine, gde redosled zapisa u suštini nije definisan.
- Vektor. U kontekstu KDB+ — to je lista elemenata jednog atomarnog tipa, na primer, brojeva. Drugim rečima, niz elemenata. Nizovi se, za razliku od lista, mogu kompaktno čuvati i obrađivati koristeći vektorske instrukcije procesora.
Zgodovinski pregled
Kompaniju KX je 1993. godine osnovao Artur Vitni, koji je pre toga radio u banci Morgan Stanley na jeziku A+, nasledniku APL — veoma originalnom i svojevremeno popularnom jeziku u finansijskom svetu. Naravno, u KX je Artur nastavio u istom duhu i stvorio vektorsko-funkcionalni jezik K, vodeći se idejama radikalnog minimalizma. Programi na K izgledaju kao haotičan skup interpunkcijskih znakova i specijalnih simbola, značenje znakova i funkcija zavisi od konteksta, a svaka operacija nosi mnogo više značenja nego što je to slučaj u uobičajenim programskim jezicima. Zbog toga program na K zauzima minimum prostora — nekoliko redova može zameniti stranice teksta opširnog jezika poput Jave — i predstavlja superkoncentrisanu realizaciju algoritma.
Funkcija na K koja реализује veći deo LL1 parser generatora prema zadatoj gramatici:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"/1_r),"]";""]]}
To filozofijo ekstremne učinkovitosti pri minimalnih gibalnih aktivnostih je Arthur uresničil tudi v KDB+, ki je bila predstavljena leta 2003 (mislim, da je zdaj jasno, od kod črka K v imenu) in ni nič drugega kot interpreter četrte verzije jezika K. Nad K je dodana prijaznejša različica za uporabnika, imenovana Q. V Q je prav tako dodana podpora za specifični dialekt SQL — QSQL, ter podpora za tabele kot sistemskega tipa podatkov, orodja za delo s tabelami v pomnilniku in na disku in tako naprej.
Tako je z vidika uporabnika KDB+ preprosto interpreter jezika Q s podporo za tabele in izrazi, podobni SQL, v slogu LINQ iz C#. To je najpomembnejša razlika KDB+ od drugih baz podatkov in njena glavna konkurenčna prednost, ki jo pogosto spregledajo. To ni baza podatkov + pomožni invalidski jezik, temveč celovit, močan programski jezik + vgrajena podpora za funkcije baze podatkov. Ta razlika bo igral odločilno vlogo pri naštevanju vseh prednosti KDB+. Na primer...
Dimenzije
Po sodobnih merilih KDB+ ima preprosto mikroskopsko velikost. To je dobesedno ena izvršljiva datoteka, manjša od enega megabajta, in ena mala besedilna datoteka z nekaterimi sistemskimi funkcijami. Dejansko — manj kot en megabajt, in podjetja za to programsko opremo plačujejo desetine tisoč dolarjev na leto za en procesor na strežniku.
- Takšna velikost omogoča, da se KDB+ odlično obnese na vseh strojnih napravah — od mikroračunalnika Pi do strežnikov s terabajti pomnilnika. Na funkcionalnost to nikakor ne vpliva, več kot to, Q se zažene takoj, kar omogoča uporabo tudi kot skriptni jezik.
- Pri taki velikosti interpreter Q popolnoma pride v predpomnilnik procesorja, kar pospeši izvajanje programov.
- Pri taki velikosti izvršljive datoteke proces Q zavzema izjemno malo prostora v pomnilniku, kar omogoča zagon več sto procesov. Hkrati pa lahko Q obravnava tudi več deset-gigabajtov pomnilnika v okviru enega procesa.
Univerzalnost
Q je odličan za različite zadatke. Proces Q može igrati ulogu povijesne baze podataka i pružati brz pristup terabajtima informacija. Na primjer, imamo desetke povijesnih baza, u kojima jedan nesabran dan podataka zauzima više od 100 gigabajta. Ipak, uz razumna ograničenja, upit prema bazi bit će izvršen za desetke ili stotine milisekundi. Općenito, imamo univerzalno vrijeme čekanja na korisničke upite — 30 sekundi — i to se rijetko događa.
S istom lakoćom Q može biti in-memory baza podataka. Dodavanje novih podataka u tablice u memoriji događa se toliko brzo da su korisnički upiti ograničavajući faktor. Podaci u tablicama pohranjuju se po kolonama, što znači da svaka operacija po koloni koristi procesorski cache na maksimum. Osim toga, u KX su se potrudili implementirati sve osnovne operacije poput aritmetičkih putem vektorskih instrukcija procesora, maksimizirajući njihovu brzinu. Q može obavljati i zadatke koji nisu svojstveni bazama podataka — na primjer, obrađivati stream podatke i izračunavati u 'stvarnom vremenu' (s vremenom kašnjenja od nekoliko desetaka milisekundi do nekoliko sekundi, ovisno o zadatku) razne agregatne funkcije za financijske instrumente za različite vremenske intervale ili graditi model utjecaja izvršene transakcije na tržište i provoditi njegovo profiliranje praktički odmah nakon izvršenja. U takvim zadacima najveće kašnjenje obično ne dolazi od Q-a, već od potrebe za sinhronizacijom podataka iz različitih izvora. Visoka brzina se postiže zahvaljujući tome što su podaci i funkcije koje ih obrađuju u istom procesu, a obrada se svodi na izvršenje nekoliko QSQL izraza i joinova, koji se ne interpretiraju, već se izvršavaju binarnim kodom.
Na kraju, na Q se mogu pisati i svi uslužni procesi. Na primjer, Gateway procesi, koji automatski raspoređuju korisničke upite na odgovarajuće baze i poslužitelje. Programer ima potpunu slobodu implementirati bilo koji algoritam za ravnotežu, prioritetizaciju, otpornost na kvarove, prava pristupa, kvote i zapravo sve što mu srce želi. Glavni problem ovdje je što će sve to morati realizirati sam.
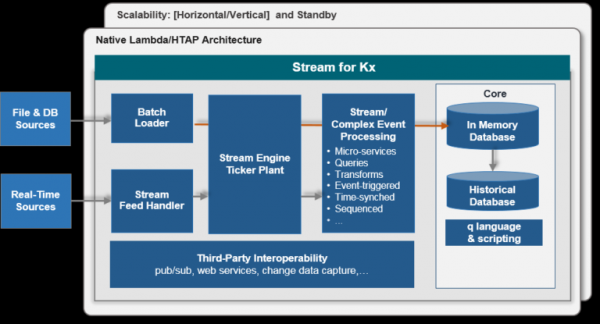
Kot za primer bom naštel, katero vrsto procesov imamo. Vse aktivno delujejo in sodelujejo ter združujejo desetine različnih baz, obdelujejo podatke iz številnih virov in podpirajo stotine uporabnikov in aplikacij.
- Povezovalniki (feedhandler) do virov podatkov. Ti procesi praviloma uporabljajo zunanje knjižnice, ki se nalagajo v Q. C vmesnik v Q je izjemno preprost in omogoča enostavno ustvarjanje proxy funkcij za katero koli C/C++ knjižnico. Q je dovolj hiter, da zlahka obdeluje na primer tok FIX sporočil iz vseh evropskih borz hkrati.
- Razdelilniki podatkov (tickerplant), ki delujejo kot vmesni člen med povezovalniki in potrošniki. Hkrati zapisujejo prihajajoče podatke v posebno binarno dnevnik, kar potrošnikom zagotavlja odpornost proti izgubi povezave ali ponovnim zagonu.
- In-memory baze podatkov (rdb). Te baze omogočajo kar najhitrejši dostop do svežih surovih podatkov, saj jih shranjujejo v pomnilniku. Praviloma zbirajo podatke v tabelah čez dan in jih obnavljajo ponoči.
- Persist baze podatkov (pdb). Te baze zagotavljajo shranjevanje podatkov za današnji dan v zgodovinsko bazo. Praviloma, za razliko od rdb, ne shranjujejo podatkov v pomnilniku, ampak uporabljajo poseben diskovni predpomnilnik čez dan in ob polnoči kopirajo podatke v zgodovinsko bazo.
- Zgodovinske baze (hdb). Te baze zagotavljajo dostop do podatkov iz prejšnjih dni, mesecev in let. Njihova velikost (v dnevih) je omejena le z velikostjo trdih diskov. Podatki so lahko shranjeni kjer koli, vključno z različnimi diski za hitrejši dostop. Možno je stisniti podatke z več različnimi algoritmi. Struktura baze je dobro dokumentirana in enostavna, podatki so shranjeni kolonovno v običajnih datotekah, kar omogoča obdelavo tudi z operacijskim sistemom.
- Baze z agregiranimi informacijami. Shranjujejo različne agregacije, praviloma grupirane po imenu orodja in časovnem intervalu. In-memory baze posodabljajo svoje stanje ob vsakem prihodu sporočila, zgodovinske baze pa shranjujejo vnaprej izračunane podatke za hitrejši dostop do zgodovinskih podatkov.
- Finally, gatewayProcesi, ki obdelujejo aplikacije in uporabnike. Q omogoča popolno asinhrono obdelavo prihodnjih sporočil, njihovo razporeditev po bazah, preverjanje pravic dostopa itd. Opozarjam, da sporočila niso omejena in pogosto niso SQL izrazi, kot je to v drugih podatkovnih bazah. Pogosto je SQL izraz skrit v posebni funkciji in se konstruira na podlagi parametrov, ki jih zahteva uporabnik — poteka pretvorba časa, filtriranje, podatki se normalizirajo (na primer, cena delnic se izravna, če so bili izplačani dividende) itd.
Tipična arhitektura za en tip podatkov:
Hitrost
Čeprav je Q interpretirani jezik, je hkrati tudi vektorski jezik. To pomeni, da mnoge vgrajene funkcije, zlasti aritmetične, sprejemajo argumente katere koli oblike — številke, vektorje, matrike, sezname, od programerja pa se pričakuje, da bo program izvajal kot operacije nad množicami. V takem jeziku, če sešteješ dva vektorja po milijon elementov, že nima pomena, da je jezik interpretiran, seštevanje bo izvedeno s superoptimizirano binarno funkcijo. Ker se večina časa v programih na Q porabi za operacije s tabelami, ki uporabljajo te osnovne vektorizirane funkcije, imamo na koncu precej dobro hitrost delovanja, ki omogoča obdelavo ogromnih količin podatkov tudi v enem postopku. To je podobno matematičnim knjižnicam v Pythonu — čeprav je sam Python precej počasen jezik, ima številne odlične knjižnice, kot je numpy, ki omogočajo obdelavo številskih podatkov s hitrostjo kompajliranega jezika (mimogrede, numpy je ideološko blizu Q).
Poleg tega je KX zelo natančno pristopil k oblikovanju tabel in optimizaciji dela z njimi. Prvič, podpira več vrst indeksov, ki jih podpirajo vgrajene funkcije in jih je mogoče uporabiti ne le na stolpcih tabel, temveč tudi na kateri koli vektor - združevanje, sortiranje, atribut edinstvenosti in posebna združitev za zgodovinske baze. Indeks se nalaga elementarno in se samodejno prilagaja ob dodajanju elementov v stolpec/vektor. Indeksi se enako uspešno lahko nalagajo na stolpce tabel tako v pomnilniku kot na disku. Ob izvajanju poizvedbe QSQL se indeksi samodejno uporabljajo, če je to mogoče. Drugič, delo z zgodovinskimi podatki je opravljeno preko mehanizma mapiranja datotek OS (memory map). Velike tabele nikoli ne naložijo v pomnilnik, namesto tega se potrebni stolpci neposredno prikažejo v pomnilniku, in dejansko se naloži le tisti del, ki je potreben (tukaj vključno s pomočjo indeksov). Za programerja ni razlike, ali so podatki v pomnilniku ali ne, mehanizem dela z mmap je popolnoma skrit v notranjosti Q.
KDB+ je nerelacijska podatkovna baza, tabele lahko vsebujejo poljubne podatke, pri tem pa se vrstni red vrstic v tabeli ne spremeni ob dodajanju novih elementov in ga je mogoče in treba uporabiti pri pisanju poizvedb. Ta lastnost je izjemno potrebna za delo s časovnimi vrsticami (podatki z borze, telemetrija, dnevniki dogodkov), saj če so podatki razvrščeni po času, uporabnik ne potrebuje uporabljati nobenih SQL trikov, da bi našel prvo ali zadnjo vrstico po času ali N vrstic, določil, katera vrstica sledi N-ti vrstici itd. Še bolj poenostavi združevanje tabel, na primer iskanje zadnje cene za 16000 transakcij VOD.L (Vodafone) v tabeli s 500 milijoni elementov traja okoli sekunde na disku in deset milisekund v pomnilniku.
Primer združevanja po času - tabela quote se prikaže v pomnilniku, zato ni potrebno navajati VOD.L v where, implicitno se uporablja indeks na stolpcu sym in dejstvo, da so podatki razvrščeni po času. Skoraj vse združitve v Q so običajne funkcije in ne del select izraza:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Na koncu je treba poudariti, da so inženirji v KX, ki jih vodi Arthur Whitney, resnično obseden z učinkovitostjo in si prizadevajo, da iz standardnih funkcij Q iztisnejo maksimum ter optimizirajo najpogostejše vzorce uporabe.
Zaključek
KDB+ je v poslovnem svetu priljubljena predvsem zaradi svoje izjemne vsestranskosti — enako dobro deluje kot in-memory baza, kot baza za shranjevanje terabajtov zgodovinskih podatkov in kot platforma za analizo podatkov. Ker se obdelava podatkov izvaja neposredno v bazi, dosežemo visoko hitrost delovanja in gospodarnost virov. Popoln programski jezik, integriran s funkcijami baze podatkov, omogoča izvajanje celotnega sklada potrebnih procesov na eni platformi — od pridobivanja podatkov do obdelave zahtevkov uporabnikov.
Additional information
Slabosti
Pomembna pomanjkljivost KDB+/Q je visok vstopni prag. Jezik ima nenavaden sintaks, nekaterih funkcij je zelo preobremenjenih (value na primer ima približno 11 možnosti uporabe). Najpomembneje je, da zahteva radikalno drugačen pristop k pisanju programov. Vektorski jezik zahteva nenehno razmišljanje v smislu preobrazb array-ov, vse zanke je treba izvajati prek več različic funkcij map/reduce (ki jih imenujemo adverbs v Q), nikoli ne poskušajte varčevati z zamenjavo vektorskih operacij s atomskimi. Na primer, za iskanje indeksa N-tega pojava elementa v array-u je treba zapisati:
1. (where element=vector)[N]
čeprav to izgleda grozno neučinkovito glede na C/Java (= ustvarja boolean vektor, where vrača indekse true elementov v njem). Toda takšen zapis naredi smisel izraza bolj razumljiv in uporabljate hitre vektorske operacije namesto počasnih atomskih. Konceptualna razlika med vektorskim jezikom in ostalimi je primerljiva z razliko med imperativnim in funkcionalnim pristopom k programiranju, in na to se je treba pripraviti.
Nekateri uporabniki so tudi nezadovoljni s QSQL. Gre za to, da je le podoben pravemu SQL-ju. V resnici gre samo za interpretator SQL-podobnih izrazov, ki ne podpira optimizacije poizvedb. Uporabnik mora sam napisati optimalne poizvedbe, in to v Q, kar je za mnoge nepripravljeno. Po drugi strani pa je seveda vedno možno sam napisati optimalno poizvedbo, namesto da se zanašamo na črni škatla-optimizator.
Kot plus, knjiga o Q - Q For Mortals je na voljo brezplačno na , kjer je zbranih tudi veliko drugih koristnih materialov.
Še en velik minus je strošek licence. To so desetine tisoč dolarjev na leto za en CPU. Le velika podjetja si lahko privoščijo tovrstne stroške. V zadnjem času je KX naredil licenčno politiko bolj fleksibilno in ponuja možnost plačila le za čas uporabe ali najem KDB+ v oblakih Google in Amazon. KX prav tako ponuja za prenos (32-bitna različica ali 64-bitna na zahtevo).
Tekmeci
Obstaja precej veliko specializiranih baz, ki temeljijo na podobnih principih — stolpčne, v pomnilniku, usmerjene na zelo velike količine podatkov. Težava je v tem, da so to prav posebne baze podatkov. Omenimo Clickhouse kot jasen primer. Ta baza podatkov uporablja shranjevanje podatkov na disku in strukturo indeksov, podobno kot KDB+, nekatere poizvedbe pa izvaja hitreje kot KDB+, čeprav ne bistveno. Vendar pa je Clickhouse še vedno bolj specializirana kot KDB+ — spletna analitika proti poljubnim časovnim vrsticam (to razlikovanje je zelo pomembno — zato na primer v Clickhouse ni možnosti za ohranjanje zaporedja zapisov). Najpomembneje pa je, da Clickhouse nima univerzalnosti KDB+, jezika, ki omogoča obdelavo podatkov neposredno v bazi, namesto da bi jih prej naložili v ločeno aplikacijo, oblikovali poljubne SQL izraze, uporabljali poljubne funkcije v poizvedbi ter ustvarjali procese, ki niso povezani z izvajanjem funkcij zgodovinske baze. Zato je težko primerjati KDB+ z drugimi bazami; te so lahko boljše v posameznih scenarijih uporabe ali preprosto boljše, ko gre za naloge klasičnih baz podatkov, vendar mi ni znan drug tako učinkovit in univerzalen instrument za obdelavo časovnih podatkov.
Integracija s Python
Da bi olajšali delo z KDB+ za osebe, ki niso seznanjene s tehnologijo, je KX ustvaril knjižnice za tesno integracijo s Pythonom v okviru enega procesa. Možno je klicati katero koli Python funkcijo iz Q, pa tudi obratno — klicati katero koli Q funkcijo iz Pythona (vključno z QSQL izrazi). Knjižnice po potrebi (z vidika učinkovitosti ne vedno) pretvarjajo podatke iz formata enega jezika v format drugega. Tako Q in Python živita v tesnem simbiozi, da so meje med njima zabrisane. Kot rezultat ima programer, s ene strani, popoln dostop do številnih uporabnih Python knjižnic, s druge strani pa pridobi hitro bazo, integrirano v Python, za delo z velikimi podatki, kar je še posebej koristno tistim, ki se ukvarjajo z strojno učenje ali modeliranjem.
Delo z Q v Pythonu:
1. >>> q()
2. q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
Povezave
Spletna stran podjetja —
Spletna stran za razvijalce —
Knjiga Q For Mortals (v angleščini) —
Članki o aplikacijah KDB+/Q od zaposlenih podjetja kx —
Izvor: habr.com
