

Uspešno smo projektovali strukturo naše PostgreSQL baze za shranjevanje sporočil. Minilo je leto, uporabniki jo aktivno polnijo, že ima milijone zapisov, in... nekaj se je začelo zaustavljati.
- Deo 2: sekcioniramo 'u živo'
Gre za to, da z rastjo obsega tabele raste tudi „globina“ indeksov — čeprav logaritemsko. A s časom to pomeni, da mora strežnik za izvajanje istih nalog branja/pisanja obdelovati mnogo več strani podatkov, kot na začetku.
Tukaj pa pride na pomoč sekcioniranje.
Opazil bi, da ne govorimo o sharding, torej razdelitvi podatkov med različnimi bazami ali strežniki. Ker, tudi če razdelite podatke na nekaterih strežnike, se ne morete znebiti težave „napihnjenih“ indeksov s časom. Jasno je, da če si lahko privoščite vsak dan vključiti nov strežnik, bodo vaše težave ležale že na povsem drugačni ravni od konkretne Baze podatkov.
Mi pa bomo obravnavali ne konkretne skripte za izvajanje sekcioniranja „v strojni opremi“, temveč sam pristop — kaj in kako je treba „razrezati na kose“, in do česa to vodi.
Koncept
Še enkrat določimo naš cilj: želimo narediti tako, da bo danes, jutri in čez leto število berljivih PostgreSQL podatkov pri kateri koli operaciji branja/pisanja ostalo približno enako.
Za vse kronološko akumulirane podatke (sporočila, dokumenti, dnevniki, arhivi, …) je naravna izbira za ključenje sekcioniranja datum/čas dogodka. V našem primeru je takšno dogodke trenutek pošiljanja sporočila.
Opazimo, da uporabniki praktično vedno delujejo samo z „zadnjimi“ takšnimi podatki — berejo zadnja sporočila, analizirajo zadnje dnevnike,… Ne, seveda, lahko prelistajo tudi naprej v preteklost, a to počnejo zelo redko.
Iz teh omejitev postane očitno, da bodo optimalne rešitve za sporočila „dnevne“ sekcije — kajti skoraj vedno bo naš uporabnik bral tisto, kar je prišlo „danes“ ali „včeraj“.
Če v teku dneva pišemo in beremo praktično samo v eno sekcijo, to zagotavlja še bolj učinkovito uporabo pomnilnika in diska — saj se vsi indeksi sekcije zlahka prilegajo v pomnilnik, za razliko od „velikih in debelih“ po celotni tabeli.
korak za korakom
V splošnem vse, kar je bilo prej rečeno, zveni kot enkraten dobiček. In dosegljiv je, vendar se bomo morali potruditi — kajti odločitev o sekvenciranju ene od entitet prinaša potrebo po "razžaganju" in povezanih z njo.
Sporočilo, njegove lastnosti in projekcije
Ker smo se odločili razdeliti sporočila po datumih, je smiselno tudi odvisne lastnosti (priložene datoteke, seznam prejemnikov) prav tako deliti, in tudi po datumu sporočila.
Ker je ena od naših tipičnih nalog prav pregledovanje registrov sporočil (neprebranih, prejetih, vseh), je logično, da jih prav tako "vključimo" v sekvenciranje po datumih sporočil.
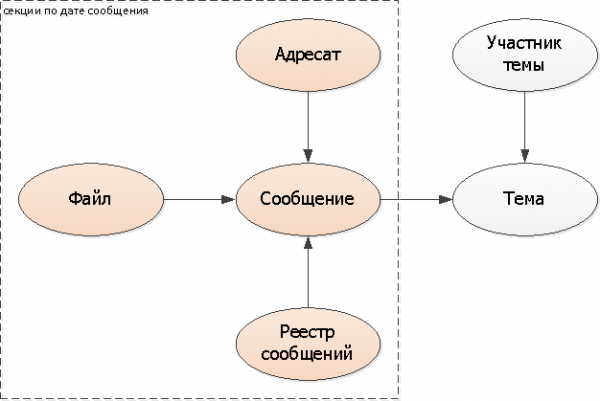
Dodajamo ključ sekvenciranja (datum sporočila) v vse tabele: prejemniki, datoteka, registri. V samo sporočilo ga ni potrebno dodajati, ampak uporabiti obstoječi DatumČas.
Teme
Ker je tema skupna več sporočilom, je ne moremo razdeliti v isti shemi, treba se je opreti na nekaj drugega. V našem primeru se odlično prilega datum prvega sporočila v korespondenci - torej trenutek nastanka, lastne teme.
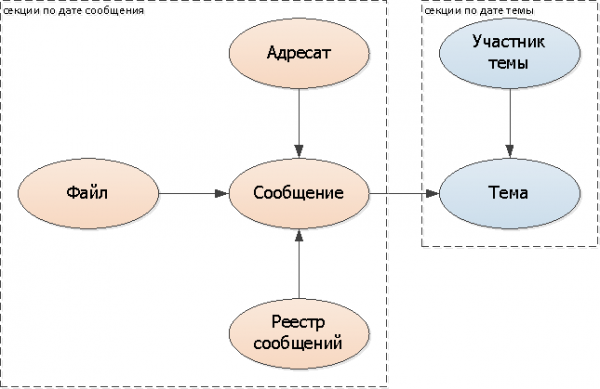
Dodajamo ključ sekvenciranja (datum teme) v vse tabele: tema, udeleženec.
Toda zdaj se nam pojavita kar dva problema:
- v kateri sekciji iskati sporočila po temi?
- v kateri sekciji iskati temo od sporočila?
Seveda, lahko nadaljujemo iskati po vseh sekcijah, vendar bo to zelo žalostno in bo izničilo vse naše dobičke. Zato, da bi vedeli, kje konkretno iskati, bomo naredili logične povezave/oznake na sekcije:
- v sporočilo dodamo polje z datumom teme
- k temi dodamo nabor datumov sporočil te korespondence (lahko ločena tabela, lahko pa tudi niz datumov)
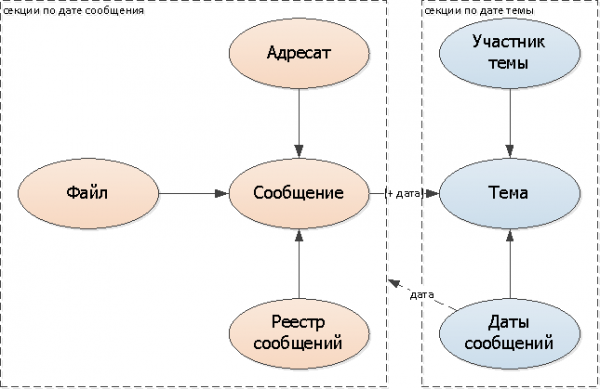
Ker bo modifikacij seznama datumov sporočil za vsak posamezen korespondenco le malo (saj skoraj vse sporočila spadajo v 1-2 sosednja dneva), se bom ustavil prav pri tej možnosti.
Torej, struktura naše baze je pridobila naslednjo obliko ob upoštevanju sekvenciranja:
Tabele: RU, pri odvratnosti do cirilice v imenih tabel/polji bolje ne gledati
-- sekcije po datumu poruke
CREATE TABLE "Poruka_YYYYMMDD"(
  "Poruka"
    uuid
      PRIMARY KEY
, "Tema"
    uuid
, "DatumTeme"
    date
, "Autor"
    uuid
, "DatumVreme" -- koristimo kao datum
    timestamp
, "Tekst"
    text
);

CREATE TABLE "Primalac_YYYYMMDD"(
  "DatumPoruke"
    date
, "Poruka"
    uuid
, "Osoba"
    uuid
, PRIMARY KEY("Poruka", "Osoba")
);

CREATE TABLE "Fajl_YYYYMMDD"(
  "DatumPoruke"
    date
, "Fajl"
    uuid
      PRIMARY KEY
, "Poruka"
    uuid
, "BLOB"
    uuid
, "Ime"
    text
);

CREATE TABLE "RegistarPoruka_YYYYMMDD"(
  "DatumPoruke"
    date
, "Vlasnik"
    uuid
, "TipRegistra"
    smallint
, "DatumVreme"
    timestamp
, "Poruka"
    uuid
, PRIMARY KEY("Vlasnik", "TipRegistra", "Poruka")
);
CREATE INDEX ON "RegistarPoruka_YYYYMMDD"("Vlasnik", "TipRegistra", "DatumVreme" DESC);

-- sekcije po datumu teme
CREATE TABLE "Tema_YYYYMMDD"(
  "DatumTeme"
    date
, "Tema"
    uuid
      PRIMARY KEY
, "Dokument"
    uuid
, "Naslov"
    text
);

CREATE TABLE "UcesnikTeme_YYYYMMDD"(
  "DatumTeme"
    date
, "Tema"
    uuid
, "Osoba"
    uuid
, PRIMARY KEY("Tema", "Osoba")
);

CREATE TABLE "DatumiPorukaTeme_YYYYMMDD"(
  "DatumTeme"
    date
, "Tema"
    uuid
      PRIMARY KEY
, "Datum"
    date
);
Štedimo novčić
Pa, ako ne koristimo na osnovu raspodele vrednosti polja (putem okidača i nasleđivanja ili PARTITION BY), već «ručno» na nivou aplikacije, može se primetiti da se vrednost ključa za sekcionisanje već čuva u imenu same tabele.
Zato, ako ste toliko zabrinuti zbog obima pohranjenih podataka, možete se osloboditi tih «suvišnih» polja i direktno se obraćati konkretnim tabelama. Nažalost, sve pretrage iz više sekcija u ovom slučaju već ćete morati da obavite na strani aplikacije.
Izvor: habr.com
