

Moje ime je Denis Rožkov, vodim razvoj programske opreme v podjetju „Gazinformservice“, v ekipi izdelka . Zakonodaja in korporativna pravila nalagajo določene zahteve glede varnosti shranjevanja podatkov. Nihče noče, da bi tretje osebe pridobile dostop do zaupnih informacij, zato so za vsak projekt pomembna naslednja vprašanja: identifikacija in avtentikacija, upravljanje dostopov do podatkov, zagotavljanje celovitosti informacij v sistemu, beleženje varnostnih dogodkov. Zato želim spregovoriti o nekaterih zanimivih vidikih, povezanih z varnostjo DBMS.
Članek je pripravljen na podlagi nastopa na ki ga je organiziral . Če ne želite brati, si lahko ogledate:
V članku bodo tri dele:
- Kako zaščititi povezave.
- Kaj je revizija dejanj in kako zabeležiti, kaj se dogaja z vidika baze podatkov in njenega povezovanja.
- Kako zaščititi podatke v sami bazi podatkov in katere tehnologije so za to na voljo.
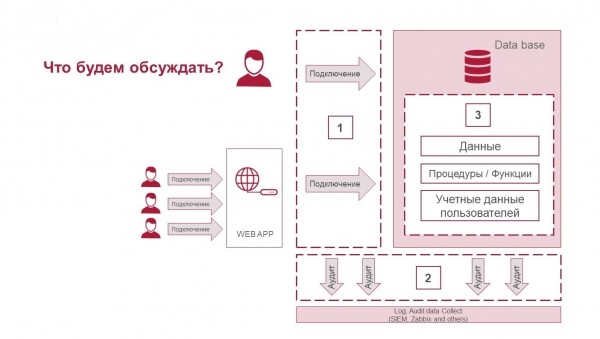
Tri sestavine varnosti DBMS: zaščita povezav, revizija dejanj in zaščita podatkov
Zaščita povezav
Do baze podatkov se lahko povežete neposredno ali posredno preko spletnih aplikacij. Na splošno uporabnik iz poslovnega sektorja, torej oseba, ki dela z DBMS, ne komunicira z njo neposredno.
Preden govorimo o zaščiti povezav, je treba odgovoriti na pomembna vprašanja, od katerih je odvisno, kako bodo oblikovane varnostne dejavnosti:
- ali je eden poslovni uporabnik enak enemu uporabniku DBMS;
- ali je dostop do podatkov DBMS omogočen le preko API-ja, ki ga nadzorujete, ali je dostop neposredno do tabel;
- ali je DBMS dodeljen v ločen zaščiten segment, kdo in kako z njim sodeluje;
- ali se uporabljajo pooling/proxy in vmesni sloji, ki lahko spreminjajo informacije o tem, kako je povezava oblikovana in kdo uporablja bazo podatkov.
Zdaj pa poglejmo, katere instrumente lahko uporabimo za zaščito povezav:
- Uporabite rešitve razreda požarne stene za baze podatkov. Dodatna plast zaščite bo vsaj povečala preglednost tega, kar se dogaja v DBMS, v najboljšem primeru pa boste lahko zagotovili dodatno zaščito podatkov.
- Uporabite politike gesel. Njihova uporaba je odvisna od vaše arhitekture. Kljub temu je en sam gesel v konfiguracijski datoteki spletne aplikacije, ki se povezuje s podatkovno bazo, premalo za zaščito. Na voljo je vrsta orodij za podatkovne baze, ki omogočajo nadzor, ali uporabnik in geslo zahtevata posodobitev.
Več o funkcijah ocenjevanja uporabnikov lahko preberete , prav tako lahko izveste o MS SQL Vulnerability Assessment .
- Obogatite kontekst seje z ustreznimi informacijami. Če je seja neprozorna, ne razumete, kdo deluje v njeni okviru v podatkovni bazi, lahko dodatno obogatitete informacije o tem, kdo, kaj in zakaj počne. Te informacije lahko vidite v reviziji.
- Nastavite SSL, če nimate omrežne ločitve podatkovne baze od končnih uporabnikov, ki ni v ločenem VLAN-u. V takih primerih je nujno zaščititi kanal med potrošnikom in samo podatkovno bazo. Orodja za zaščito so na voljo tudi med odprtokodnimi rešitvami.
Kako bo to vplivalo na zmogljivost podatkovne baze?
Poglejmo na primeru PostgreSQL, kako SSL vpliva na obremenitev CPU, povečanje časov in zmanjšanje TPS, ali ne bo preveliko breme, če ga omogočimo.
Obremenjujemo PostgreSQL z uporabo pgbench — to je preprost program za izvajanje testov zmogljivosti. Večkrat izvaja eno zaporedje ukazov, morda v vzporednih sejah podatkovne baze, in nato izračuna povprečno hitrost transakcij.
Test 1 brez SSL in z uporabo SSL — povezava se vzpostavi pri vsaki transakciji:
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"Test 2 brez SSL in z uporabo SSL — vse transakcije se izvajajo v eni povezavi:
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"Ostale nastavitve:
dejstvo skaliranja: 1
način poizvedbe: preprost
število strank: 10
število niti: 1
število transakcij na stranko: 5000
število dejansko obdelanih transakcij: 50000/50000
Výsledky testování:
Brez SSL
SSL
Povezava se vzpostavi pri vsaki transakciji
povprečna latenca
171.915 ms
187.695 ms
tps vključno z vzpostavljanjem povezav
58.168112
53.278062
tps brez vzpostavljanja povezav
64.084546
58.725846
CPU
24%
28%
Vse transakcije se izvajajo v eni povezavi
povprečna latenca
6.722 ms
6.342 ms
tps vključno z vzpostavljanjem povezav
1587.657278
1576.792883
tps brez vzpostavljanja povezav
1588.380574
1577.694766
CPU
17%
21%
Pri manjših obremenitvah je vpliv SSL primerljiv s napako merjenja. Če je količina prenesenih podatkov zelo velika, je situacija lahko drugačna. Če vzpostavimo eno povezavo za vsako transakcijo (to se redko dogaja, običajno povezavo delijo različni uporabniki), imate veliko število povezav/odklopov, vpliv je lahko nekoliko večji. To pomeni, da so tveganja za zmanjšanje zmogljivosti prisotna, vendar razlika ni dovolj velika, da bi se zaščita ne uporabljala.
Upoštevajte — močna razlika se pojavi, če primerjate načine delovanja: v okviru ene seje delate ali v različnih. To je razumljivo: za vzpostavitev vsake povezave se porabljajo viri.
Imeli smo primer, ko smo povezovali Zabbix v načinu zaupanja, torej nismo preverjali md5, pri avtentikaciji ni bilo potrebe. Pozneje je naročnik zaprosil za vključitev md5 avtentikacije. To je povzročilo veliko obremenitev za CPU, zmogljivost se je poslabšala. Iščemo načine optimizacije. Ena od možnih rešitev problema je izvedba omrežnega omejevanja, da se za DBMS naredijo ločeni VLAN-i, dodati nastavitve, da bo jasno, kdo in od kod se povezuje, ter odstraniti avtentikacijo. Prav tako je mogoče optimizirati nastavitve avtentikacije, da se zmanjšajo stroški pri vključitvi avtentikacije, vendar na splošno različne metode avtentikacije vplivajo na zmogljivost in je treba te dejavnike upoštevati pri načrtovanju računalniške moči strežnikov (strojne opreme) za DBMS.
Zaključek: v nekaterih rešitvah lahko tudi majhne podrobnosti glede avtentikacije močno vplivajo na projekt in slabo, ko to postane jasno šele ob uvedbi v produkcijo.
Revizija dejanj
Revizija ni samo za DBMS. Revizija je pridobivanje informacij o tem, kar se dogaja na različnih segmentih. To je lahko tudi požarni zid za bazo podatkov, pa tudi operacijski sistem, na katerem je zgrajen DBMS.
Pri komercialnih DBMS ravni Enterprise je s revizijo vse v redu, pri odprtokodnih pa ne vedno. Tukaj je, kar je na voljo v PostgreSQL:
- privzeta dnevniška datoteka — vgrajeno beleženje;
- razširitve: pgaudit — če vam privzeta beleženja ne zadostuje, lahko uporabite ločene nastavitve, ki rešujejo del nalog.
Dopolnilo k poročilu v videu:
Osnovna registracija operatera može biti osigurana standardnim sredstvom vođenja beleški sa log_statement = all.
To je prihvatljivo za nadzor i druge vrste upotrebe, ali ne obezbeđuje nivo detaljnosti koji je obično potreban za reviziju.
Nije dovoljno imati listu svih operacija koje se izvode nad bazom podataka.
Takođe, mora postojati mogućnost pronalaženja konkretnih izjava koje su od interesa za revizora.
Standardni sistem vođenja beleški pokazuje ono što je korisnik zatražio, dok se pgAudit fokusira na detalje onoga što se dogodilo kada je baza podataka izvršavala zahtev.
Na primer, revizor može želeti da se uveri da je određena tabela kreirana u dokumentovanom prozoru održavanja.
To se može činiti jednostavnim zadatkom za osnovnu reviziju i grep, ali šta ako imate nešto poput ovog (namerno zbunjujućeg) primera:
DO $$
POČNI
EXECUTE ‘CREATE TABLE import’ || ‘ant_table (id INT)’;
END $$;
Standardno vođenje beleški će vam dati ovo:
LOG: statement: DO $$
POČNI
EXECUTE ‘CREATE TABLE import’ || ‘ant_table (id INT)’;
END $$;
Čini se da će za pronalaženje zanimljive tabele možda biti potrebno neko poznavanje koda u slučajevima kada se tabele dinamički kreiraju.
To nije idealno, jer bi bilo poželjno jednostavno tražiti po imenu tabele.
Eto gde će pgAudit biti koristan.
Za isti unos on će dati ovaj ispravak u beleškama:
AUDIT: SESSION,33,1,FUNCTION,DO,,,«DO $$
POČNI
EXECUTE ‘CREATE TABLE import’ || ‘ant_table (id INT)’;
END $$;"
AUDIT: SESSION,33,2,DDL,CREATE TABLE,TABLE,public.important_table,CREATE TABLE important_table (id INT)
Ne registruje se samo blok DO, već i potpuni tekst CREATE TABLE sa tipom operacije, tipom objekta i punim imenom, što olakšava pretragu.
Kada se beleže SELECT i DML operatori, pgAudit može biti konfigurisano da registruje pojedinačni unos za svaku relaciju na koju se upućuje u operatoru.
Nije potrebna sintaktička analiza da bi se pronašli svi operatori koji se odnose na određenu tabelu ()».
Kako bo to vplivalo na zmogljivost podatkovne baze?
Hajde da testiramo uključivanje potpunog audita i vidimo kako će to uticati na performanse PostgreSQL-a. Uključićemo maksimalno logovanje baze podataka sa svim parametrima.
U konfiguracionom fajlu gotovo ništa ne menjamo, od važnog — aktiviraćemo debug5 režim da bismo dobili maksimalne informacije.
postgresql.conf
log_destination = ‘stderr’
logging_collector = on
log_truncate_on_rotation = on
log_rotation_age = 1d
log_rotation_size = 10MB
log_min_messages = debug5
log_min_error_statement = debug5
log_min_duration_statement = 0
debug_print_parse = on
debug_print_rewritten = on
debug_print_plan = on
debug_pretty_print = on
log_checkpoints = on
log_connections = on
log_disconnections = on
log_duration = on
log_hostname = on
log_lock_waits = on
log_replication_commands = on
log_temp_files = 0
log_timezone = 'Europe/Moscow'
На СУБД PostgreSQL с параметрами 1 CPU, 2,8 ГГц, 2 Гб ОЗУ, 40 Гб HDD проводим три нагрузочных теста, используя команды:
$ pgbench -p 3389 -U postgres -i -s 150 benchmark
$ pgbench -p 3389 -U postgres -c 50 -j 2 -P 60 -T 600 benchmark
$ pgbench -p 3389 -U postgres -c 150 -j 2 -P 60 -T 600 benchmark
Rezultati testiranja:
Без логирования
С логированием
Итоговое время наполнения БД
43,74 сек
53,23 сек
RAM
24%
40%
CPU
72%
91%
Тест 1 (50 коннектов)
Кол-во транзакций за 10 мин
74169
32445
Транзакций/сек
123
54
Средняя задержка
405 мс
925 мс
Тест 2 (150 коннектов при 100 возможных)
Кол-во транзакций за 10 мин
81727
31429
Транзакций/сек
136
52
Средняя задержка
550 мс
1432 мс
Про размеры
Размер БД
2251 МБ
2262 МБ
Размер логов БД
0 Мб
4587 Мб
В итоге: полный аудит — это не очень хорошо. Данных от аудита получится по объему, как данных в самой базе данных, а то и больше. Такой объем журналирования, который генерируется при работе с СУБД, — обычная проблема на продуктиве.
Смотрим другие параметры:
- Скорость сильно не меняется: без логирования — 43,74 сек, с логированием — 53,23 сек.
- Производительность по ОЗУ и CPU будет проседать, так как нужно сформировать файл с аудитом. Это также заметно на продуктиве.
При увеличении числа коннектов, естественно, показатели будут немного ухудшаться.
В корпорациях с аудитом еще сложнее:
- данных много;
- аудит нужен не только через syslog в SIEM, но и в файлы: вдруг с syslog что-то произойдет, должен быть близко к базе файл, в котором сохранятся данные;
- для аудита нужна отдельная полка, чтобы не просесть по I/O дисков, так как он занимает много места;
- бывает, что сотрудникам ИБ нужны везде ГОСТы, они требуют гостовую идентификацию.
Ограничение доступа к данным
Посмотрим на технологии, которые используют для защиты данных и доступа к ним в коммерческих СУБД и open source.
Что в целом можно использовать:
- Шифрование и обфускация процедур и функций (Wrapping) — то есть отдельные инструменты и утилиты, которые из читаемого кода делают нечитаемый. Правда, потом его нельзя ни поменять, ни зарефакторить обратно. Такой подход иногда требуется как минимум на стороне СУБД — логика лицензионных ограничений или логика авторизации шифруется именно на уровне процедуры и функции.
- Omejitev vidnosti podatkov po vrsticah (RLS) pomeni, da različni uporabniki vidijo isto tabelo, vendar različen nabor vrstic v njej, kar pomeni, da določeni uporabniki ne smejo videti nekaterih podatkov na ravni vrstic.
- Urejanje prikazanih podatkov (Masking) pomeni, da uporabniki v isti stolpcu tabele vidijo bodisi podatke bodisi le zvezdice, kar pomeni, da bo za nekatere uporabnike informacija zaprta. Tehnologija določa, katerim uporabnikom je kaj prikazano glede na raven dostopa.
- Razmejitev dostopa Security DBA/Application DBA/DBA se nanaša predvsem na omejevanje dostopa do samega DBMS, kar pomeni, da se zaposleni za informacijsko varnost lahko ločijo od upravljavcev baz podatkov in aplikacij. V odprtokodnih rešitvah je takih tehnologij malo, v komercialnih DBMS jih je dovolj. Te so potrebne, kadar je veliko uporabnikov z dostopom do strežnikov.
- Omejevanje dostopa do datotek na ravni datotečnega sistema. Lahko dodelite pravice in privilegije dostopa do map, tako da vsak upravitelj dobi dostop le do potrebnih podatkov.
- Mandatni dostop in čiščenje pomnilnika – te tehnologije se uporabljajo redko.
- End-to-end šifriranje neposredno DBMS pomeni šifriranje na strani odjemalca z upravljanjem ključev na strežniški strani.
- Šifriranje podatkov. Na primer, stolpično šifriranje – ko uporabljate mehanizem, ki šifrira posamezni stolpec baze.
Kako to vpliva na zmogljivost DBMS?
Poglejmo na primeru stolpičnega šifriranja v PostgreSQL. Tam je modul pgcrypto, ki omogoča shranjevanje izbranih polj v šifrirani obliki. To je koristno, kadar imajo vrednost le nekateri podatki. Da bi prebrali šifrirana polja, odjemalec pošlje dekodirni ključ, strežnik razšifrira podatke in jih izda odjemalcu. Brez ključa vaši podatki ne bodo uporabni.
Izvedimo test s pgcrypto. Ustvarili bomo tabelo s šifriranimi podatki in s običajnimi podatki. Tukaj so ukazi za ustvarjanje tabel, v prvi vrstici je koristna ukaz – ustvarjanje samega razširitve z registracijo DBMS:
CREATE EXTENSION pgcrypto;
CREATE TABLE t1 (id integer, text1 text, text2 text);
CREATE TABLE t2 (id integer, text1 bytea, text2 bytea);
INSERT INTO t1 (id, text1, text2)
VALUES (generate_series(1,10000000), generate_series(1,10000000)::text, generate_series(1,10000000)::text);
INSERT INTO t2 (id, text1, text2) VALUES (
generate_series(1,10000000),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'));
Nadal bomo poskušali pridobiti podatke iz vsake tabele in pogledali čas izvajanja.
Pridobitev iz tabele brez funkcije šifriranja:
psql -c "timing" -c "select * from t1 limit 1000;" "host=192.168.220.129 dbname=taskdb
user=postgres sslmode=disable" > 1.txt
Štoper je vklopljen.
id | text1 | text2
——+——-+——-
1 | 1 | 1
2 | 2 | 2
3 | 3 | 3
…
997 | 997 | 997
998 | 998 | 998
999 | 999 | 999
1000 | 1000 | 1000
(1000 vrstic)
Čas: 1,386 ms
Pridobitev iz tabele s funkcijo šifriranja:
psql -c "timing" -c "select id, decrypt(text1, 'key'::bytea, 'bf'),
decrypt(text2, 'key'::bytea, 'bf') from t2 limit 1000;"
"host=192.168.220.129 dbname=taskdb user=postgres sslmode=disable" > 2.txt
Štoper je vklopljen.
id | decrypt | decrypt
——+—————+————
1 | x31 | x31
2 | x32 | x32
3 | x33 | x33
…
999 | x393939 | x393939
1000 | x31303030 | x31303030
(1000 vrstic)
Čas: 50,203 ms
Výsledky testování:
Brez šifriranja
Pgcrypto (decrypt)
Pridobitev 1000 vrstic
1,386 ms
50,203 ms
CPU
15%
35%
RAM
+5%
Šifriranje močno vpliva na zmogljivost. Vidno je, da se je čas povečal, saj operacije dešifriranja šifriranih podatkov (in dešifriranje je običajno še ovito v vašo logiko) zahtevajo znatne vire. To pomeni, da ideja, da se šifrira vse stolpce, ki vsebujejo kakršne koli podatke, prinaša zmanjšanje zmogljivosti.
Vendar šifriranje ni srebrna krogla, ki reši vse težave. Dešifrirani podatki in ključ dešifriranja so med dešifriranjem in prenosom podatkov na strežniku. Zato lahko ključe prestrežejo tisti, ki imajo popoln dostop do strežnika podatkov, na primer sistemski administrator.
Ko je na celotnem stolpcu za vse uporabnike en ključ (tudi če ne za vse, ampak za stranke omejenega nabora), to ni vedno dobro in pravilno. Zato so uvedli šifriranje od konca do konca, v SDB so začeli razmišljati o možnostih šifriranja podatkov s strani odjemalca in strežnika, pojavili so se tisti key-vault sistemi — ločeni izdelki, ki zagotavljajo upravljanje s ključi na strani SDB.

Varnostna sredstva v komercialnih in odprtokodnih SDB
Functions
Tip
Politika gesel
Revizija
Zaščita izvorne kode postopkov in funkcij
RLS
Šifriranje
Oracle
Komercialno
+
+
+
+
+
MsSql
Komercialno
+
+
+
+
+
Komercialno
+
+
+
+
razširitve
PostgreSQL
Brezplačno
razširitve
razširitve
—
+
razširitve
MongoDb
Brezplačno
—
+
—
—
Na voljo samo v MongoDB Enterprise
Tabela ni popolna, toda situacija je taka: v komercialnih izdelkih se varnostni problemi rešujejo že dolgo, v odprtokodnih pa običajno za varnost uporabljajo različne nadgradnje, mnogim funkcijam primanjkuje, včasih je potrebno kaj dodati. Na primer, politike gesel — v PostgreSQL je kar precej različnih razširitev., , , , ), ki izvajajo politike gesel, ampak po mojem mnenju nobena ne pokriva vseh potreb domačega korporativnega segmenta.
Kaj storiti, če nikjer ni tistega, kar potrebujete? Например, хочется использовать определенную СУБД, в которой нет функций, которые требует заказчик.
Potem lahko uporabite zunanje rešitve, ki delujejo z različnimi DBMS, na primer „Crypto DB“ ali „Garda DB“. Če govorimo o rešitvah iz domačega segmenta, tam bolje poznajo GOST-e kot v open source.
Druga možnost je, da sami napišete, kar potrebujete, izvedete dostop do podatkov in šifriranje na ravni postopkov v aplikaciji. Res je, da bo s GOST-om težje. Ampak na splošno — lahko skrijete podatke, kot želite, shranite v DBMS in jih nato pridobite ter dešifrirate, kako je treba, neposredno na ravni aplikacije. Pri tem takoj razmislite, kako boste ti algoritmi zaščitili na ravni aplikacije. Po našem mnenju je to treba narediti na ravni DBMS, saj bo tako delovalo hitreje.
Ta predstavitev je prvič zazvenela na by Mail.ru Cloud Solutions. Oglejte sidruge nastope in se prijavite na novice o dogodkih na Telegramu .
Kaj še prebrati o temi:
- .
- .
Izvor: habr.com
