

Ljudje, ki se ukvarjajo z obravnavo podatkov, pogosto nimajo realističnih predstave o tem, kaj jih čaka. Mnogi mislijo, da bodo zdaj lahko enostavno pisali nevronske mreže, ustvarjali glasovne pomočnike, kot je Iron Man, ali premagovali vse na finančnih trgih.
Ampak delo Podatki Data Scientist deluje na osnovi podatkov, in en najpomembnejših in časovno najintenzivnejših trenutkov je obdelava podatkov, preden jih damo v nevronsko mrežo ali jih analiziramo na določen način.
V tem članku naša ekipa opisuje, kako lahko enostavno in hitro obdelate podatke s korak za korakom navodili in kodo. Potrudili smo se, da je koda dovolj fleksibilna in jo je mogoče uporabiti za različne nize podatkov.
Verjetno mnogim strokovnjakom ta članek ne bo pokazal ničesar izjemnega, vendar se lahko začetniki naučijo nekaj novega, prav tako pa vsak, ki si je dolga leta želel ustvariti svoj lasten zvezek za hitro in strukturirano obdelavo podatkov, lahko kopira kodo in jo prilagodi sebi, ali
Imamo nabor podatkov. Kaj pa zdaj?
Torej, standard: potrebno je razumeti, s čim imamo opravka, splošno sliko. Za to uporabimo pandas, da preprosto ugotovimo različne tipe podatkov.
import pandas as pd #uvozimo pandas
import numpy as np  #uvozimo numpy
df = pd.read_csv("AB_NYC_2019.csv") #preberemo nabor podatkov in ga zapišemo v spremenljivko df
df.head(3) #gledamo prvih 3 vrstice, da vidimo, kako izgledajo vrednosti 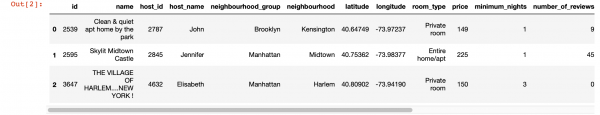
df.info() #Prikažemo informacije o stolpcih 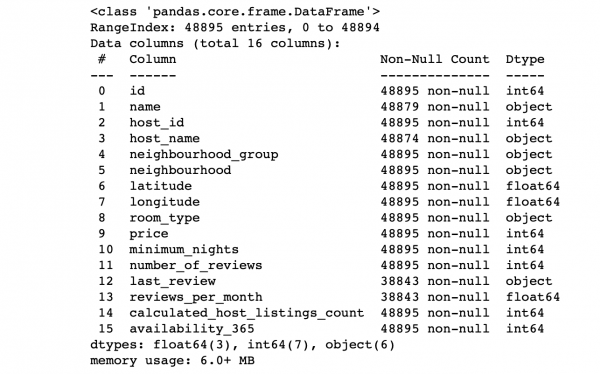
Poglejmo vrednosti stolpcev:
- Ali se število vrstic v vsakem stolpcu ujema s skupnim številom vrstic?
- Kaj je bistvo podatkov v vsakem stolpcu?
- Kateri stolpec želimo narediti cilj, da za njega izvajamo napovedi?
Odgovori na ta vprašanja omogočajo analizo niza podatkov in približno nakazujejo načrt naslednjih korakov.
Poleg tega lahko za globlji vpogled v vrednosti v vsakem stolpcu uporabimo funkcijo pandas describe(). Vendar pa je pomanjkljivost te funkcije, da ne daje informacij o stolpcih z vrednostmi tipa string. S temi se bomo ukvarjali kasneje.
df.describe() 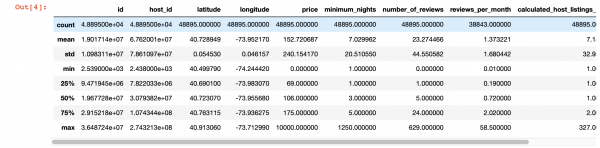
Čarobna vizualizacija
Poglejmo, kje nimamo vrednosti na voljo:
import seaborn as sns
sns.heatmap(df.isnull(), yticklabels=False, cbar=False, cmap='viridis') 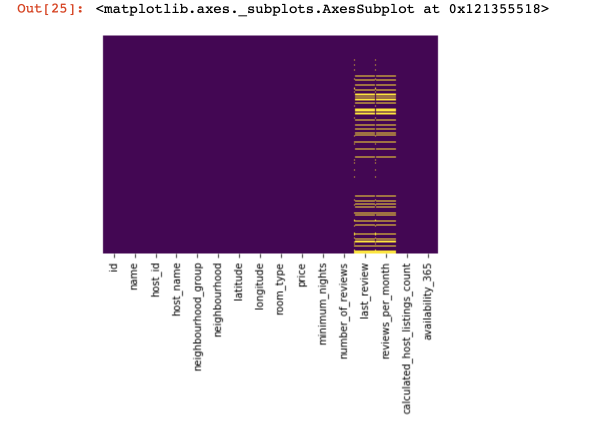
To je bil kratek pogled od zgoraj, zdaj pa se bomo lotili bolj zanimivih stvari.
Poskusimo najti in po možnosti odstraniti stolpce, v katerih je v vseh vrsticah le ena vrednost (ti ne bodo vplivali na rezultat):
df = df[[c for c in list(df) if len(df[c].unique()) > 1]] #Prepišemo podatkovni niz, pri čimer obdržimo le tiste stolpce, v katerih je več kot ena unikatna vrednostZdaj se zaščitimo in uspeh našega projekta pred dvojniki vrstic (vrsticami, ki vsebujejo iste informacije v istem vrstnem redu kot že obstojna vrstica):
df.drop_duplicates(inplace=True) #To storimo, če menimo, da je potrebno.
                                 #V nekaterih projektih podatkov z začetka ni smiselno odstranjevati.
Razdelimo podatkovni niz na dva dela: enega z kvalitativnimi vrednostmi in drugega – s kvantitativnimi
Tukaj je potrebno narediti majhno pojasnilo: če se vrstice s manjkajočimi podatki pri kvalitativnih in kvantitativnih podatkih močno ne ujemajo med seboj, bomo morali sprejeti odločitev, čemu žrtvujemo – vse vrstice z manjkajočimi podatki, le njihov del ali določene stolpce. Če pa se vrstice ujemajo, imamo povsem pravico razdeliti podatkovni niz na dva dela. V nasprotnem primeru bomo morali najprej razčistiti vrstice, kjer se manjkajoči podatki ne ujemajo v kvalitativnih in kvantitativnih, šele nato razdeliti podatkovni niz na dva dela.
df_numerical = df.select_dtypes(include = [np.number])
df_categorical = df.select_dtypes(exclude = [np.number])
To delamo, da nam olajša obdelavo teh dveh različnih vrst podatkov – kasneje bomo razumeli, kako zelo to poenostavi naše delo.
Delamo s kvantitativnimi podatki
Prvo, kar moramo storiti – preveriti, ali ni v kvantitativnih podatkih "vohunski stolpci". Te stolpce imenujemo tako, ker se pretvarjajo za kvantitativne podatke, v resnici pa delujejo kot kvalitativni.
Kako jih opredeliti? Seveda je vse odvisno od narave podatkov, ki jih analizirate, vendar dokazano taki stolpci lahko vsebujejo malo unikatnih podatkov (približno 3-10 unikatnih vrednosti).
print(df_numerical.nunique())Ko se odločimo za vohunske stolpce, jih premaknemo iz kvantitativnih podatkov v kvalitativne:
spy_columns = df_numerical[['kolonka1', 'kolonka2', 'kolonka3']]# выделяем колонките-шпиони и записваме в отделна dataframe
df_numerical.drop(labels=['kolonka1', 'kolonka2', 'kolonka3'], axis=1, inplace = True)# изрязваме тези колонки от количествените данни
df_categorical.insert(1, 'kolonka1', spy_columns['kolonka1']) # добавяме първата колонка-шпион в качествените данни
df_categorical.insert(1, 'kolonka2', spy_columns['kolonka2']) # добавяме втората колонка-шпион в качествените данни
df_categorical.insert(1, 'kolonka3', spy_columns['kolonka3']) # добавяме третата колонка-шпион в качествените данни
Най-накрая напълно отделихме количествените данни от качествените и сега можем да работим с тях както трябва. Първото — трябва да разберем, къде имаме пустите стойности (NaN, а в някои случаи и 0 ще се считат за пустите стойности).
for i in df_numerical.columns:
    print(i, df[i][df[i]==0].count())
На този етап е важно да разберем, в кои колонки нулите могат да означават отсъстващи стойности: свързано ли е това с начина, по който са събирани данните? Или може да е свързано със стойностите на данните? На тези въпроси трябва да отговорим в конкретния случай.
И така, ако все пак решим, че данните могат да отсъстват там, където има нули, трябва да заменим нулите с NaN, за да е по-лесно след това да работим с тези загубени данни:
df_numerical[["kolonka 1", "kolonka 2"]] = df_numerical[["kolonka 1", "kolonka 2"]].replace(0, nan)Сега да видим къде имаме пропуснати данни:
sns.heatmap(df_numerical.isnull(), yticklabels=False, cbar=False, cmap='viridis') # Може също да използвате df_numerical.info() 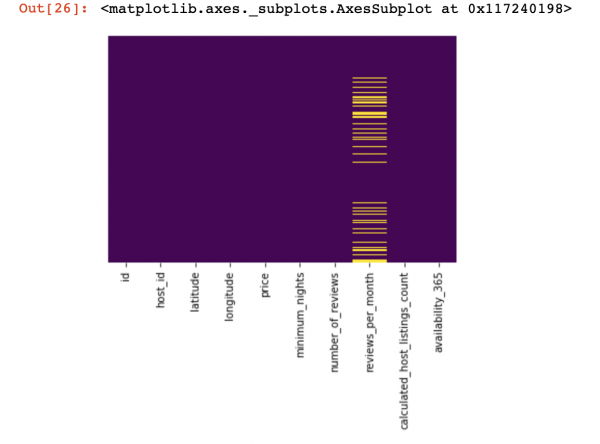
Тук трябва да бъдат отбелязани с жълт цвят тези стойности в колонките, които отсъстват. И най-интересното започва сега — как да действаме с тези стойности? Да премахнем редовете с тези стойности или колонките? Или да попълним тези празни стойности с нещо друго?
Ето приблизителна схема, която може да ви помогне да определите какво може да се направи с празните стойности:
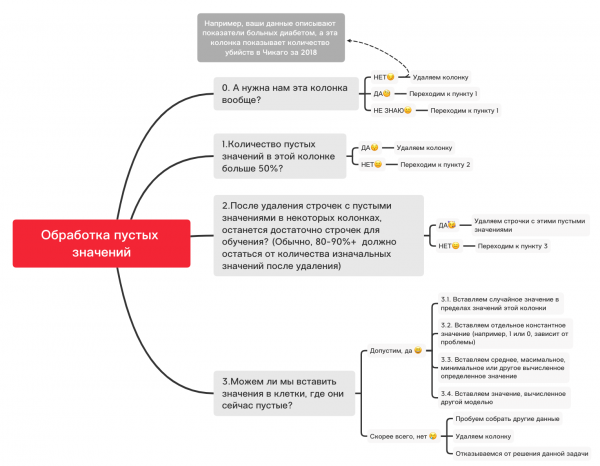
0. Премахваме ненужните колонки
df_numerical.drop(labels=["kolonka1", "kolonka2"], axis=1, inplace=True)1. Броят на празните стойности в тази колонка надвишава ли 50%?
print(df_numerical.isnull().sum() / df_numerical.shape[0] * 100)df_numerical.drop(labels=["kolonka1", "kolonka2"], axis=1, inplace=True)# Премахваме, ако някоя колонка има повече от 50 празни стойности2. Премахваме редовете с празни стойности
df_numerical.dropna(inplace=True)#Odstranimo vrstice z praznimi vrednostmi, če bodo na voljo dovolj podatkov za usposabljanje3.1. Vstavite naključne vrednosti
import random #uvozimo random
df_numerical["kolona"].fillna(lambda x: random.choice(df[df[column] != np.nan]["kolona"]), inplace=True) #vstavimo naključne vrednosti v prazne celice tabele
3.2. Vstavite konstanto
from sklearn.impute import SimpleImputer #uvozimo SimpleImputer, ki pomaga pri vnosu vrednosti
imputer = SimpleImputer(strategy='constant', fill_value="") #vstavimo določeno vrednost s pomočjo SimpleImputer
df_numerical[["nova_kolona1",'nova_kolona2','nova_kolona3']] = imputer.fit_transform(df_numerical[['kolona1', 'kolona2', 'kolona3']]) #To uporabimo za našo tabelo
df_numerical.drop(labels = ["kolona1","kolona2","kolona3"], axis = 1, inplace = True) #Odstranimo stolpce s starimi vrednostmi
3.3. Vstavite povprečno ali najpogostejšo vrednost
from sklearn.impute import SimpleImputer #uvozimo SimpleImputer, ki pomaga pri vnosu vrednosti
imputer = SimpleImputer(strategy='mean', missing_values = np.nan) #namesto mean lahko uporabimo tudi most_frequent
df_numerical[["nova_kolona1",'nova_kolona2','nova_kolona3']] = imputer.fit_transform(df_numerical[['kolona1', 'kolona2', 'kolona3']]) #To uporabimo za našo tabelo
df_numerical.drop(labels = ["kolona1","kolona2","kolona3"], axis = 1, inplace = True) #Odstranimo stolpce s starimi vrednostmi
3.4. Vstavite vrednost, izračunano z drugo metodo
Včasih je mogoče vrednosti izračunati s pomočjo regresijskih modelov, pri čemer uporabimo modele iz knjižnice sklearn ali drugih podobnih knjižnic. Naša ekipa bo posvetila posebno članek, kako to doseči v bližnji prihodnosti.
Torej, vse dokler se pripoved o kvantitativnih podatkih prekine, ker je še veliko drugih vidikov o tem, kako najbolje izvajati pripravo podatkov in predobdelavo za različne naloge. Osnovne zadeve za kvantitativne podatke so bile upoštevane v tem članku in zdaj je čas, da se vrnemo k kvalitativnim podatkom, ki smo jih ločili nekaj korakov nazaj od kvantitativnih. Ta zveznik lahko prilagajate po svoji želji, da bo predobdelava podatkov potekala zelo hitro!
Kvalitativni podatki
Za kvalitativne podatke se uglavnom koristi metoda One-hot-encoding kako bi ih formatirali iz string (ili object) u broj. Pre nego što pređemo na ovu tačku, koristićemo šemu i kod iznad kako bismo razjasnili prazne vrednosti.
df_categorical.nunique()sns.heatmap(df_categorical.isnull(), yticklabels=False, cbar=False, cmap='viridis') 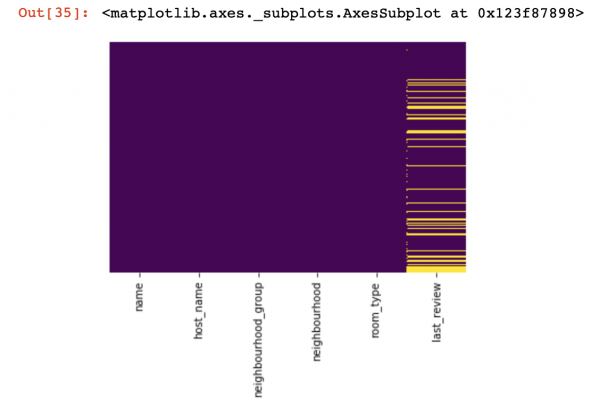
0. Премахваме ненужните колонки
df_categorical.drop(labels=["kolona1", "kolona2"], axis=1, inplace=True)1. Броят на празните стойности в тази колонка надвишава ли 50%?
print(df_categorical.isnull().sum() / df_numerical.shape[0] * 100)df_categorical.drop(labels=["kolona1", "kolona2"], axis=1, inplace=True) # Brišemo ako neka kolona
# ima više od 50% praznih vrednosti2. Премахваме редовете с празни стойности
df_categorical.dropna(inplace=True) # Brišemo redove sa praznim vrednostima,
                                   # ako će posle ostati dovoljno podataka za obučavanje
3.1. Vstavite naključne vrednosti
import random
df_categorical["kolona"].fillna(lambda x: random.choice(df[df[column] != np.nan]["kolona"]), inplace=True)
3.2. Vstavite konstanto
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='constant', fill_value="")
df_categorical[["nova_kolona1", 'nova_kolona2', 'nova_kolona3']] = imputer.fit_transform(df_categorical[['kolona1', 'kolona2', 'kolona3']])
df_categorical.drop(labels=["kolona1", "kolona2", "kolona3"], axis=1, inplace=True)
Dakle, konačno smo se pozabavili praznim vrednostima u kvalitativnim podacima. Sada je vreme za izvođenje one-hot-encoding za vrednosti koje se nalaze u vašoj bazi podataka. Ova metoda se veoma često koristi kako bi vaš algoritam mogao da se obučava uzimajući u obzir kvalitativne podatke.
def encode_and_bind(original_dataframe, feature_to_encode):
    dummies = pd.get_dummies(original_dataframe[[feature_to_encode]])
    res = pd.concat([original_dataframe, dummies], axis=1)
    res = res.drop([feature_to_encode], axis=1)
    return(res)
features_to_encode = ["kolona1", "kolona2", "kolona3"]
for feature in features_to_encode:
df_categorical = encode_and_bind(df_categorical, feature)Dakle, konačno smo završili sa odvojenim obradama kvalitativnih i kvantitativnih podataka — vreme je da ih ponovo spojimo.
new_df = pd.concat([df_numerical, df_categorical], axis=1)Nakon što smo spojili dataset-e u jedan, na kraju možemo koristiti transformaciju podataka uz pomoć MinMaxScaler-a iz sklearn biblioteke. To će učiniti naše vrednosti u opsegu od 0 do 1, što će pomoći prilikom obučavanja modela u budućnosti.
from sklearn.preprocessing import MinMaxScaler
min_max_scaler = MinMaxScaler()
new_df = min_max_scaler.fit_transform(new_df)
Ovi podaci su sada spremni za sve — za neuronske mreže, standardne ML algoritme itd!
V tem članku nismo upoštevali dela z podatki, povezanimi s časovnimi vrstami, saj za te podatke veljajo nekoliko drugačne tehnike obravnave, odvisno od vaše naloge. V prihodnosti bo naša ekipa tej temi posvetila poseben članek, in upamo, da bo lahko prinesel nekaj zanimivega, novega in koristnega v vaše življenje, tako kot ta.
Izvor: habr.com
