

Na začetku je bila tehnologija, imenovana BPF. Na to smo se osredotočili v , svetopisemski, članku te serije. Leta 2013 so Alexei Starovoitov in Daniel Borkman razvili izboljšano različico, ki je bila vključena v jedro Linuxa in optimizirana za sodobne 64-bitne naprave. Ta nova tehnologija je kratek čas nosila ime Internal BPF, potem je bila preimenovana v Extended BPF, danes pa jo vsi preprosto imenujejo BPF.
Na grob način, BPF omogoča izvajanje poljubne kode, ki jo zagotavlja uporabnik, v prostoru jedra Linuxa, nova arhitektura pa se je izkazala tako uspešna, da bomo potrebovali še deset člankov, da opišemo vse njene uporabe. (Edino, kar razvijalci niso uspeli ustvariti, kot lahko vidite na spodnjem kpdv, je dober logotip.)
Ta članek opisuje strukturo virtualnega stroja BPF, vmesnike jedra za delo z BPF, razvojna orodja, ter kratek, zelo kratek pregled obstoječih možnosti, torej vse tisto, kar bomo potrebovali za bolj poglobljeno raziskovanje praktičnih aplikacij BPF.
Povzetek članka
Na začetku se bomo na arhitekturo BPF pogledali z višine ptice in označili glavne komponente.
Že z razumevanjem arhitekture na splošno bomo opisali strukturo virtualnega stroja BPF.
V tem razdelku bomo podrobneje proučili življenjski cikel objektov BPF - programov in map.
Imeti neko predstavo o sistemu, končno pa se bomo osredotočili na to, kako ustvarjati in upravljati objekte iz uporabniškega prostora s pomočjo posebnega sistemskega klica - bpf(2).
Seveda je mogoče pisati programe s sistemskim klicem. Ampak je zahtevno. Za bolj realističen scenarij so jedrski programerji razvili knjižnico libbpf. Ustvarili bomo najpreprostejši okvir aplikacije BPF, ki ga bomo uporabili v naslednjih primerih.
Tukaj bomo spoznali, kako lahko programe BPF dostopajo do funkcij-pomočnikov jedra — orodja, ki skupaj z mape bistveno širi zmogljivosti novega BPF v primerjavi s klasičnim.
Do tega trenutka bomo vedeli dovolj, da bomo razumeli, kako pravzaprav lahko ustvarimo programe, ki uporabljajo mape. In celo z enim očesom pokukamo v veličastni verifikator.
Pomožni odsek o tem, kako zgraditi potrebna orodja in jedro za eksperimente.
Na koncu članka bodo tisti, ki so prišli do sem, našli motivacijske besede in kratek opis tega, kar bo v naslednjih člankih. Prav tako bomo navedli nekaj povezav za samostojno učenje za tiste, ki nimajo želje ali priložnosti, da bi čakali na nadaljevanje.
Uvod v arhitekturo BPF
Preden začnemo obravnavati arhitekturo BPF, se še enkrat (ali res?) sklicujemo na , ki je bil zasnovan kot odgovor na pojav RISC računalnikov in reševal problem učinkovitega filtriranja paketov. Arhitektura je bila tako uspešna, da je, rojena v divjih devetdesetih v Berkeley UNIX, bila portirana na večino obstoječih operacijskih sistemov, dočakala nore dvajsete in še vedno najde nove uporabe.
Nov BPF je bil zasnovan kot odgovor na razširjenost 64-bitnih računalnikov, oblačnih storitev in povečane potrebe po orodjih za ustvarjanje SDN (Software-defined networking). Zasnovan s strani mrežnih inženirjev jedra kot izboljšana zamenjava klasičnega BPF, je nov BPF dobesedno v pol leta našel uporabo v težkem delu sledenja sistemom Linux, danes, šest let po svojem pojavu, pa bomo potrebovali celoten naslednji članek samo za to, da naštejemo različne vrste programov.
VeSëLëE KaRtInKe
BPF je v osnovi virtualna peskovnik, ki omogoča izvajanje "poljubne" kode v jedrni prostor brez ogrožanja varnosti. BPF programi se ustvarjajo v uporabniškem prostoru, nalagajo v jedro in povezujejo z nekim virom dogodkov. Dogodek je lahko dostava paketa na omrežnem vmesniku, zagon kakšne funkcije jedra itd. V primeru paketa so programu BPF na voljo podatki in metapodatki paketa (za branje in morda tudi pisanje, odvisno od vrste programa), v primeru zagona funkcije jedra pa argumenti funkcije, vključno s kazalci na jedrski pomnilnik itd.
Poglejmo ta postopek podrobneje. Najprej bomo govorili o prvi razliki od klasičnega BPF, katerih programi so bili napisani v assemblerju. V novi različici je bila arhitektura dopolnjena tako, da je možno programe pisati v visokih programskih jezikih, predvsem C. Za to je bil razvit backend za llvm, ki omogoča generiranje bajt kode za BPF arhitekturo.
Arhitektura BPF je bila razvita, da bi učinkovito delovala na sodobnih strojih. Da bi to delovalo v praksi, se bajt koda BPF, po nalaganju v jedro, prevede v naravno kodo s pomočjo komponente, imenovane JIT compiler (Just In Time). Nadalje, če se spomnite, je v klasičnem BPF program nalagali v jedro in ga atomarno povezovali z virom dogodkov — v okviru enega sistemskega klica. V novi arhitekturi to poteka v dveh korakih — najprej se koda naloži v jedro s sistemskim klicem bpf(2), nato pa se pozneje, z različnimi mehanizmi, odvisnimi od vrste programa, program poveže (attaches) z virom dogodkov.
Tukaj se lahko bralcu porajajo vprašanja: ali je to res mogoče? Kako se zagotavlja varnost izvajanja take kode? Varnost izvajanja nam zagotavlja faza nalaganja BPF programov, imenovana preverjevalnik (v angleščini imenovana verifier in bom naprej uporabljal angleški izraz):
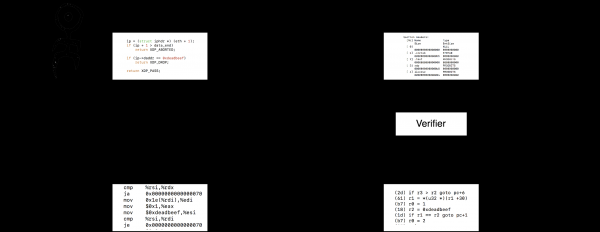
Verifier je statični analitik, ki zagotavlja, da program ne bo zrušil normalnega delovanja jedra. To seveda ne pomeni, da program ne more posegati v delovanje sistema — BPF programi lahko, odvisno od tipa, berejo in prepisujejo dele jedrskega pomnilnika, vračajo vrednosti funkcij, izrezujejo, dopolnjujejo, prepisujejo in celo preusmerjajo mrežne pakete. Verifier zagotavlja, da se jedro ne bo zrušilo ob zagonu BPF programa in da program, ki lahko po pravilih piše, na primer, podatke odlaznega paketa, ne bo mogel prepisati jedrskega pomnilnika izven paketa. Malo podrobneje si bomo ogledali verifier v ustreznem razdelku, potem ko se bomo seznanili z vsemi ostalimi komponentami BPF.
Torej, kaj smo do sedaj izvedeli? Uporabnik napiše program v jeziku C, ga naloži v jedro s pomočjo sistemskega klica bpf(2), kjer opravi preverjanje na verifierju in se prenese v nativno bajtkodno obliko. Nato se ta ali drug uporabnik poveže s programom na vir dogodkov in začne se izvajati. Ločevanje nalaganja in povezovanja je potrebno iz več razlogov. Prvič, zagon verifierja je sorazmerno drag, in ko isto program nalagamo večkrat, zapravljamo računalniški čas brez koristi. Drugič, način, kako se program povezuje, je odvisen od njegovega tipa, in en sam "univerzalni" vmesnik, razvit pred letom dni, morda ne bo primeren za nove tipe programov. (Čeprav zdaj, ko tehnologija postaja bolj zrela, obstaja ideja o poenotenju tega vmesnika na ravni) libbpf.)
Pozoren bralec lahko opazi, da še nismo končali s slikami. Res je, vse zgoraj navedeno ne pojasnjuje, kako BPF bistveno spreminja sliko v primerjavi s klasičnim BPF. Dve novosti, ki bistveno širita meje uporabe, sta možnost uporabe deljene pomnilnika in funkcij-pomočnikov jedra (kernel helpers). V BPF je deljena pomnilnika realizirana s pomočjo tako imenovanih maps — deljenih struktur podatkov s specifičnim API. Takšno ime so verjetno dobile, ker je prvi tip map, ki je bil uveden, bila hashtable. Kasneje so se pojavili še seznami, lokalne (per-CPU) hashtable in lokalni seznami, iskalna drevesa, mape, ki vsebujejo kazalce na BPF programe, in še veliko več. Zdaj nas zanima dejstvo, da imajo BPF programi možnost shranjevanja stanja med klici in deljenja tega stanja z drugimi programi ter s prostorom uporabnika.
Dostop do maps je mogoč iz uporabniških procesov s pomočjo sistemskega klica bpf(2), medtem ko iz BPF programov, ki delujejo v jedru, dostopamo preko funkcij-pomočnikov. Še več, helpers ne obstajajo samo za delo z maps, temveč tudi za dostop do drugih možnosti jedra. Na primer, BPF programi lahko uporabljajo funkcije-pomočnike za preusmerjanje paketov na druge vmesnike, za generiranje dogodkov podskupine perf, dostop do struktur jedra itd.
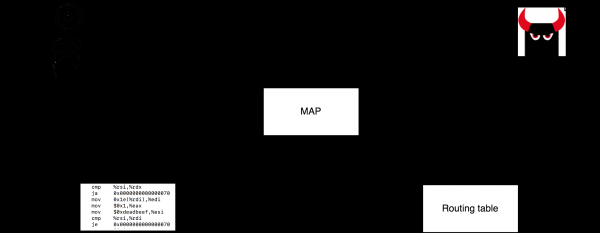
Skupaj, BPF omogoča nalaganje poljubnega, t.j., kodiranega s preveritvijo na verifierju, uporabniškega kode v jedro sistema. Ta koda lahko shranjuje stanje med klici in izmenjuje podatke s prostorom uporabnika ter ima dostop do dovoljenih podsistemov jedra za to vrsto programov.
To je podobno sposobnostim, ki jih nudijo jedrne module, pri čemer ima BPF določene prednosti (seveda je mogoče primerjati le podobne aplikacije, na primer, sledenje sistemu - ne morete napisati poljubnega gonilnika z BPF). Omeniti je mogoče nižjo stopnjo vstopa (nekateri pripomočki, ki uporabljajo BPF, ne predvidevajo, da ima uporabnik znanje o programiranju jedra, pa tudi splošno znanje o programiranju), varnost med izvajanjem (dvignite roko v komentarjih tisti, ki niste zlomili sistema pri pisanju ali testiranju modulov), atomarnost - pri ponovnem nalaganju modulov je čas zastoja, medtem ko podgradnja BPF zagotavlja, da ne bo zamujenih nobenih dogodkov (za poštenost, to ne velja za vse vrste programov BPF).
Na voljo takšne možnosti BPF postavljajo za vsestransko orodje za širitev jedra, kar se praktično potrjuje: vse novejši in novejši tipi programov se dodajajo v BPF, vse večje podjetja uporabljajo BPF na produkcijskih strežnikih 24×7, vse več zagonskih podjetij gradi svoje poslovanje na rešitvah, ki temeljijo na BPF. BPF se uporablja povsod: v zaščiti pred DDoS napadi, za ustvarjanje SDN (na primer, implementacija omrežij za kubernetes), kot glavno orodje za sledenje sistemom in zbiranje statistike, v sistemih za odkrivanje vdorov in sistemih peskovnikov itd.
Tukaj končajmo pregledni del članka in si podrobneje oglejmo virtualni stroj in ekosistem BPF.
Odmik: orodja
Da bi lahko izvajali primere iz naslednjih razdelkov, boste morda potrebovali nekaj orodij, vsaj llvm/clang s podporo bpf in bpftool. V razdelku lahko preberete navodila za sestavljanje orodij in svojega jedra. Ta razdelek je umeščen nižje, da ne moti tekočnosti našega opisa.
Register in nabor ukazov virtualnega stroja BPF
BPF architecture and command system was developed with consideration that programs would be written in C and then compiled into native code after being loaded into the kernel. Therefore, the number of registers and the instruction set was chosen with an eye towards the intersection, in a mathematical sense, of the capabilities of modern machines. Additionally, various restrictions were imposed on the programs; for example, until recently it was not possible to write loops and subprograms, and the number of instructions was limited to 4096 (now, privileged programs can load up to a million instructions).
In BPF, there are eleven available 64-bit user-accessible registers. r0—r10 and the program counter. The register r10 contains a pointer to the stack (frame pointer) and is read-only. Programs during execution have access to a 512-byte stack and an unlimited amount of shared memory in the form of maps.
BPF programs are allowed to invoke a specific set of kernel helper functions depending on the type of program and, recently, regular functions as well. Each invoked function can take up to five arguments passed in registers r1—r5, and the return value is transmitted in r0. It is guaranteed that after returning from the function, the contents of the registers r6—r9 will not be altered.
For efficient program translation, the registers r0—r11 are mapped unambiguously to real registers for all supported architectures, taking into account the specifics of the current architecture's ABI. For example, in x86_64 the registers r1—r5, which are used for passing function parameters, are mapped to rdi, rsi, rdx, rcx, r8, which are used for passing parameters to functions in x86_64. For example, the code on the left translates to the code on the right as follows:
1:  (b7) r1 = 1                    mov    $0x1,%rdi
2:  (b7) r2 = 2                    mov    $0x2,%rsi
3:  (b7) r3 = 3                    mov    $0x3,%rdx
4:  (b7) r4 = 4                    mov    $0x4,%rcx
5:  (b7) r5 = 5                    mov    $0x5,%r8
6:  (85) call pc+1                 callq  0x0000000000001ee8
The register r0 is also used to return the result of the program's execution, and in the register r1 the program receives a pointer to the context — depending on the type of program, this could be, for example, the structure (for XDP) or the structure (for various network programs) or the structure (for different types of tracing programs), etc.
Torej, imeli smo niz registrov, kernel helperje, sklad, pokazatelj na kontekst in deljeno pomnilnik v obliki maps. Ni da bi bilo vse to nujno v potovanju, ampak...
Nadaljujmo z opisom in povejmo o sistemu ukazov za delo s temi objekti. Vse () instrukcije BPF imajo fiksno 64-bitno velikost. Če pogledate eno instrukcijo na 64-bitnem Big Endian stroju, boste videli

Tukaj Koda — to je kodiranje instrukcije, Dst/Src — to sta kodiranja sprejemnika in vira, ustrezno, Izklopljeno — 16-bitni znakovit offset, ter Imm — to je 32-bitno znakovo celo število, uporabljeno v nekaterih ukazih (podobno konstantni K iz cBPF). Kodiranje Koda ima enega od dveh vrst:
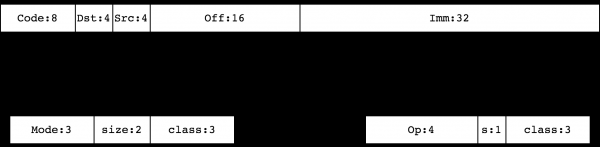
Razredi instrukcij 0, 1, 2, 3 določajo ukaze za delo s pomnilnikom. Imenujejo se , BPF_LDX, BPF_ST, BPF_STX, , ustrezno. Razredi 4, 7 (BPF_ALUBPF_ALU64, ) sestavljajo niz ALU instrukcij. Razredi 5, 6 (BPF_JMPBPF_JMP32, ) vključujejo ukaze skoka.Dodatni načrt za preučevanje sistema ukazov BPF je tak: namesto da natančno naštevamo vse ukaze in njihove parametre, bomo obravnavali nekaj primerov v tem razdelku in iz njih bo jasno, kako so strukture ukazov v resnici in kako ročno disassemblerati katerikoli binarni datoteka za BPF. Da utrdimo znanje, se bomo v nadaljevanju članka še srečali z individualnimi ukazi v razdelkih o Verifierju, JIT kompajlerju, prenosu klasičnega BPF ter pri preučevanju maps, klicu funkcij itd.
Ko bomo govorili o individualnih ukazih, se bomo sklicevali na datoteke jedra
bpf.h in Neuradna eBPF specifikacija , , Primer: disassembleramo BPF v mislih
Poglejmo primer, v katerem bomo skompilirali program
readelf-example.c in si ogledali nastali binarni datoteko. Razkrili bomo izvirno vsebino spodaj, potem ko bomo obnovili njegovo logiko iz binarnih kod: in si ogledali nastali binarni datoteko. Razkrili bomo izvirno vsebino $ clang -target bpf -c readelf-example.c -o readelf-example.o -O2 $ llvm-readelf -x .text readelf-example.o Hex dump of section '.text': 0x00000000 b7000000 01000000 15010100 00000000 ................ 0x00000010 b7000000 02000000 95000000 00000000 ................
$ clang -target bpf -c readelf-example.c -o readelf-example.o -O2
$ llvm-readelf -x .text readelf-example.o
Hex dump of section '.text':
0x00000000 b7000000 01000000 15010100 00000000 ................
0x00000010 b7000000 02000000 95000000 00000000 ................
Prvi stupac u izlazu readelf — to je uvlačenje i naš program se, dakle, sastoji od četiri komande:
Kod Dst Src Off  Imm
b7   0   0   0000 01000000
15   0   1   0100 00000000
b7   0   0   0000 02000000
95   0   0   0000 00000000
Kodovi komandi su jednaki b7, 15, b7 in 95. Podsetimo se da su tri najsitnija bita klasa instrukcije. U našem slučaju je četvrti bit svih instrukcija prazan, pa su klase instrukcija jednake, odnosno, 7, 5, 7, 5. Klasa 7 je ) sestavljajo niz ALU instrukcij. Razredi 5, 6 (, a 5 je BPF_JMP32. Za obe klase format instrukcije je isti (vidi gorenavedeno) i možemo prepisati naš program ovako (usput ćemo prepisati i ostale stupce u ljudski razumljiv oblik):
Op S  Klasa   Dst Src Off  Imm
b  0  ALU64   0   0   0    1
1  0  JMP     0   1   1    0
b  0  ALU64   0   0   0    2
9  0  JMP     0   0   0    0
Operacija b klasa ALU64 — to je . Ona dodeljuje vrednost registru-prijemniku. Ako je bit s (izvor), onda se vrednost uzima iz registra-izvora, a ako, kao u našem slučaju, nije postavljen, tada se vrednost uzima iz polja Imm. Dakle, u prvoj i trećoj instrukciji izvršavamo operaciju r0 = Imm. Dalje, operacija 1 klase JMP — to je (skakanje ako je jednako). U našem slučaju, pošto je bit S jednak nuli, ona upoređuje vrednost registra-izvora sa poljem Imm. Ako se vrednosti poklapaju, onda se prelazi na PC + Off, gde PC, kao što uvek biva, sadrži adresu sledeće instrukcije. Na kraju, operacija 9 klase JMP — to je . Ova instrukcija završava rad programa, vraćajući jezgru r0. Dodajmo novi stupac našoj tabeli:
Op    S  Klasa   Dst Src Off  Imm    Disassm
MOV   0  ALU64   0   0   0    1      r0 = 1
JEQ   0  JMP     0   1   1    0      if (r1 == 0) goto pc+1
MOV   0  ALU64   0   0   0    2      r0 = 2
EXIT  0  JMP     0   0   0    0      exit
Možemo to prepisati u pristupačnijem obliku:
     r0 = 1
     if (r1 == 0) goto KRAJ
     r0 = 2
KRAJ:
     exit
Ako se setimo da registru r1 nulti kontekst od jezgra, a u registru r0 se vraća vrednost u jezgro, onda možemo da vidimo da ako je pokazivač na kontekst jednak nuli, vraćamo 1, a u suprotnom 2. Proverimo da nismo u pravu pogledom na izvorni kod:
$ cat readelf-example.c
int foo(void *ctx)
{
        return ctx ? 2 : 1;
}
Da, ovo je besmislena programa, ali se prevodi u svega četiri jednostavne instrukcije.
Primer-izuzetak: 16-bajtna instrukcija
Ranije smo pomenuli da neke instrukcije zauzimaju više od 64 bita. To se odnosi na instrukciju lddw (Kod = 0x18 = | | ) — učitati u registar dvostruku reč iz polja Imm. Problem je u tome da Imm ima velikost 32, dvojna beseda pa 64 bita, zato v register ne moremo naložiti 64-bitne neposredne vrednosti v enem 64-bitnem ukazu. Dve sosednji ukazi se zato uporabljata za shranjevanje drugega dela 64-bitne vrednosti na polju Imm. Primer:
$ cat x64.c
long foo(void *ctx)
{
        return 0x11223344aabbccdd;
}
$ clang -target bpf -c x64.c -o x64.o -O2
$ llvm-readelf -x .text x64.o
Hex dump of section '.text':
0x00000000 18000000 ddccbbaa 00000000 44332211 ............D3".
0x00000010 95000000 00000000                   ........
V binarni programi sta samo dva ukaza:
Binary                                 Disassm
18000000 ddccbbaa 00000000 44332211    r0 = Imm[0]|Imm[1]
95000000 00000000                      exit
Še srečamo z ukazom lddw, ko se bomo pogovarjali o relokacijah in delu z maps.
Primer: disasemble BPF z uporabo standardnih orodij
Torej, naučili smo se brati binarne kode BPF in smo pripravljeni analizirati katerikoli ukaz, če bo potrebno. Vendar pa velja omeniti, da je v praksi bolj priročno in hitreje disasembilirati programe z uporabo standardnih orodij, na primer:
$ llvm-objdump -d x64.o

Disassembly of section .text:

0000000000000000 <foo>:
 0: 18 00 00 00 dd cc bb aa 00 00 00 00 44 33 22 11 r0 = 1234605617868164317 ll
 2: 95 00 00 00 00 00 00 00 exit
Življenjski cikel objektov BPF, datotečni sistem bpffs
(Nekatere podrobnosti, opisane v tem podrazdelku, sem prvič izvedel iz Alexei Starovoitov v .)
Objekti BPF - programi in mape - se ustvarjajo iz uporabniškega prostora s pomočjo ukazov BPF_PROG_LOAD in BPF_MAP_CREATE sistemskega klica bpf(2), pogovarjali se bomo o tem, kako točno se to zgodi v naslednjem razdelku. Pri tem se ustvarijo strukture podatkov jedra in za vsako od njih refcount (števec sklicev) se nastavi na ena, uporabniku pa se vrne datotečni descriptor, ki kaže na objekt. Po zaprtju deskriptorja refcount objekt zmanjša za eno enoto, in ko doseže nič, se objekt uniči.
Če program uporablja mape, se refcount teh map poveča za eno enoto po nalaganju programa, torej jih datotečni deskriptorji lahko zapremo iz uporabniškega procesa in pri tem refcount ne postane nič:
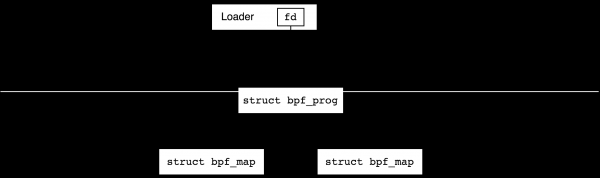
Po uspešnem nalaganju programa jo običajno povežemo z nekim generatorjem dogodkov. Na primer, lahko jo namestimo na omrežni vmesnik za obdelavo prihajajočih paketov ali pa jo povežemo z nečim tracepoint v jedru. V tem trenutku se števec sklicev prav tako poveča za eno enoto in datotečni deskriptor v programu za nalaganje lahko zapremo.
Kaj se zgodi, če zdaj zaključimo delo nalagalnika? To je odvisno od vrste dogodkovnega generatorja (hook). Vse omrežne hooks bodo obstajale po zaključku nalagalnika, to so tako imenovani globalni hooks. Na primer, sledi pa bodo sproščene po zaključku procesa, ki jih je ustvaril (in zato se imenujejo lokalni, od »local to the process«). Tehnično imajo lokalni hooks vedno ustrezen datotečni descriptor v uporabniškem prostoru in se zato zaprejo s končno obdelavo procesa, medtem ko globalni ne. Na naslednjem diagramu poskušam s pomočjo rdečih križcev prikazati, kako zaključek programa nalagalnika vpliva na življenjsko dobo objektov v primeru lokalnih in globalnih hooks.
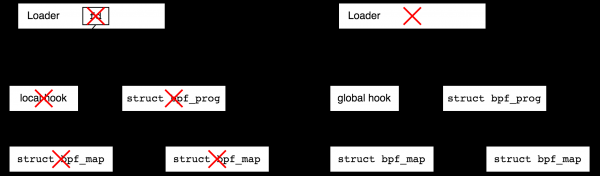
Zakaj obstaja ločitev na lokalne in globalne hooks? Zagon nekaterih vrst omrežnih programov ima smisel tudi brez uporabniškega prostora, na primer, predstavljajte si zaščito pred DDoS — nalagalnik povečuje pravila in povezuje BPF program z omrežnim vmesnikom, nato pa se nalagalnik lahko ustavi. Po drugi strani pa si predstavljajte programsko orodje za sledenje, ki ste ga napisali na hitro v desetih minutah — po zaključku bi želeli, da v sistemu ne ostane smeti, kar zagotavljajo lokalni hooks.
Po drugi strani pa si predstavljajte, da se želite povezati na tracepoint v jedru in zbirati statistiko več let. V tem primeru bi želeli zaključiti uporabniški del in se občasno vračati k statistiki. To možnost nudi datotečni sistem bpf. To je pseudo-datotečni sistem, ki obstaja samo v pomnilniku in omogoča ustvarjanje datotek, ki se nanašajo na objekte BPF in s tem povečujejo refcount objekte. Po tem lahko nalagalnik zaključimo, objekti, ki jih je ustvaril, pa ostanejo živi.
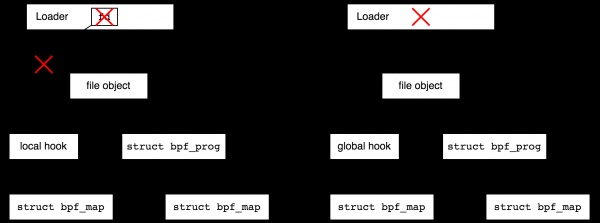
Ustvarjanje datotek v bpffs, ki se nanašajo na objekte BPF, se imenuje "zaklepanje" ("pin", kot v naslednji frazi: "process can pin a BPF program or map"). Ustvarjanje datotečnih objektov za objekte BPF ima smisel ne le za podaljšanje življenjske dobe lokalnih objektov, temveč tudi za lažjo uporabo globalnih objektov — ob vračanju k primeru z globalnim programom za zaščito pred DDoS želimo imeti možnost, da občasno prispemo in pogledamo statistiko.
Datotečni sistem BPF se običajno montira v /sys/fs/bpf, vendar ga je mogoče montirati tudi lokalno, na primer tako:
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Imena v datotečnem sistemu se ustvarjajo z ukazom BPF_OBJ_PIN sistemskega klica BPF. Kot ilustracijo vzamemo neko programo, jo skompajliramo, naložimo in jo pritrdimo v bpffs. Naša programa ne dela nič koristnega, njen koda je zgolj za to, da lahko ponovite primer:
$ cat test.c
__attribute__((section("xdp"), used))
int test(void *ctx)
{
        return 0;
}

char _license[] __attribute__((section("license"), used)) = "GPL";
Skompilirali bomo to programo in ustvarili lokalno kopijo datotečnega sistema bpffs:
$ clang -target bpf -c test.c -o test.o
$ mkdir bpf-mountpoint
$ sudo mount -t bpf none bpf-mountpoint
Zdaj naložimo našo programo z orodjem bpftool in si ogledamo pripadajoče sistemske klice bpf(2) (nekateri nepovezani vnosi so odstranjeni iz izhoda strace):
$ sudo strace -e bpf bpftool prog load .\/test.o bpf-mountpoint\/test
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="test", ...}, 120) = 3
bpf(BPF_OBJ_PIN, {pathname="bpf-mountpoint\/test", bpf_fd=3}, 120) = 0
Tukaj smo naložili program z BPF_PROG_LOAD, dobili od jedra datotečni deskriptor 3 in z ukazom BPF_OBJ_PIN pritrdili ta datotečni deskriptor v obliki datoteke "bpf-mountpoint\/test". Po tem se je nalagalnik programov bpftool končal, vendar naša programa ostaja v jedru, čeprav je nismo pritrdili nobenemu omrežnemu vmesniku:
$ sudo bpftool prog | tail -3
783: xdp  name test  tag 5c8ba0cf164cb46c  gpl
        loaded_at 2020-05-05T13:27:08+0000  uid 0
        xlated 24B  jited 41B  memlock 4096B
Datotečni objekt lahko odstranimo z običajnim unlink(2) in po tem bo ustrezna programa odstranjena:
$ sudo rm .\/bpf-mountpoint\/test
$ sudo bpftool prog show id 783
Error: get by id (783): No such file or directory
Odstranitev objektov
Ko govorimo o odstranitvi objektov, je treba pojasniti, da po tem, ko smo program odklopili od vzvoda (generatorskega dogodka), nobena nova dogodka ne bo povzročila njenega zagona, vendar pa bodo vsi trenutni izvodi programa zaključeni na normalen način.
Nekatere vrste BPF programov omogočajo zamenjavo programa med izvajanjem, tj. zagotavljajo atomarnost zaporedja replace = detach old program, attach new program. Pri tem bodo vsi aktivni izvodi stare različice programa zaključili svoje delovanje, novi obdelovalci dogodkov pa bodo ustvarjeni iz novega programa, atomarnost pa pomeni, da noben dogodek ne bo zamujen.
Povezovanje programov z viri dogodkov
V tem članku ne bomo posebej opisovali povezovanja programov z viri dogodkov, saj to ima smisel raziskovati v okviru določene vrste programa. Glej. spodaj, kjer prikazujemo, kako se povezujejo programi tipa XDP.
Upravljanje objektov s pomočjo sistemskega klica bpf
Programi BPF
Vsi objekti BPF se ustvarjajo in upravljajo iz uporabniškega prostora s pomočjo sistemskega klica bpf, ki ima naslednjo prototipno strukturo:
#include <linux/bpf.h>

int bpf(int cmd, union bpf_attr *attr, unsigned int size);
Tukaj je ukaz cmd — to je ena od vrednosti tipa , attr — kazalec na parametre za določen program in size — velikost objekta po kazalcu, torej običajno je to sizeof(*attr). V jedru 5.8 sistemski klic bpf podpira 34 različnih ukazov, medtem ko union bpf_attr zavzema 200 vrstic. Vendar nas to ne bi smelo prestrašiti, saj se bomo s ukazi in parametri spoznavali skozi več člankov.
Začeli bomo z ukazom BPF_PROG_LOAD, ki ustvari programe BPF — vzame niz BPF ukazov in ga naloži v jedro. Ob nalaganju se zažene verifier, nato JIT prevajalnik in po uspešni izvedbi se uporabniku vrne datotečni descriptor programa. Videli smo, kaj se z njim zgodi naprej v prejšnjem razdelku .
Zdaj bomo napisali uporabniški program, ki bo naložil preprost program BPF, ampak najprej se moramo odločiti, kakšen program želimo naložiti — morali bomo izbrati in v okviru te vrste napisati program, ki bo prestal preverjanje na verifierju. Vendar, da ne bi zapletali procesa, imamo tukaj pripravljeno rešitev: vzeli bomo program tipa BPF_PROG_TYPE_XDP, ki bo vračal vrednost XDP_PASS (spusti vse pakete). V BPF assemblerju to izgleda zelo preprosto:
r0 = 2
exit
Ko smo se odločili za to, To vam omogoča, da rekonstruirate ne le kar bomo nalagali, lahko povemo, kako to storimo:
#define _GNU_SOURCE
#include <string.h>
#include <unistd.h>
#include <sys/syscall.h>
#include <linux/bpf.h>

static inline __u64 ptr_to_u64(const void *ptr)
{
        return (__u64) (unsigned long) ptr;
}

int main(void)
{
    struct bpf_insn insns[] = {
        {
            .code = BPF_ALU64 | BPF_MOV | BPF_K,
            .dst_reg = BPF_REG_0,
            .imm = XDP_PASS
        },
        {
            .code = BPF_JMP | BPF_EXIT
        },
    };

    union bpf_attr attr = {
        .prog_type = BPF_PROG_TYPE_XDP,
        .insns     = ptr_to_u64(insns),
        .insn_cnt  = sizeof(insns)/sizeof(insns[0]),
        .license   = ptr_to_u64("GPL"),
    };

    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));

    for ( ;; )
        pause();
}
Zanimivi dogodki v programu se začnejo z določanjem niza insns — našega programa BPF v strojnih kodah. Pri tem je vsaka naloga programa BPF zapakirana v strukturo . Prvi element insns ustreza nalogi r0 = 2, drugi — exit.
Odmik. V jedru so opredeljeni bolj priročni makroji za pisanje strojnih kod, in z uporabo jedrskega glaveza tools/include/linux/filter.h bi lahko napisali
struct bpf_insn insns[] = {
    BPF_MOV64_IMM(BPF_REG_0, XDP_PASS),
    BPF_EXIT_INSN()
};
Однако, поскольку разработка BPF-программ на машинном коде требуется только для написания тестов в ядре и статей по BPF, отсутствие этих макросов на самом деле не усложняет жизнь разработчика.
После того как мы определили программу BPF, мы переходим к ее загрузке в ядро. Наш минималистский набор параметров attr включает тип программы, набор и количество инструкций, обязательную лицензию, а также имя "woo", которое мы будем использовать для поиска нашей программы в системе после загрузки. Программа, как и было обещано, загружается в систему с помощью системного вызова bpf.
В конце программы мы попадаем в бесконечный цикл, имитирующий полезную нагрузку. Без него программа будет уничтожена ядром при закрытии файлового дескриптора, который был возвращён нам системным вызовом bpf, и мы не сможем увидеть ее в системе.
Что ж, мы готовы к тестированию. Соберем и запустим программу под strace, чтобы убедиться, что все работает как надо:
$ clang -g -O2 simple-prog.c -o simple-prog

$ sudo strace .\/simple-prog
execve(".\/simple-prog", [".\/simple-prog"], 0x7ffc7b553480 /* 13 vars */) = 0
...
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0x7ffe03c4ed50, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(0, 0, 0), prog_flags=0, prog_name="woo", prog_ifindex=0, expected_attach_type=BPF_CGROUP_INET_INGRESS}, 72) = 3
pause(
Все в порядке, bpf(2) он вернул нам дескриптор 3 и мы вошли в бесконечный цикл с pause(). Давайте попробуем найти нашу программу в системе. Для этого мы откроем другой терминал и используем утилиту bpftool:
# bpftool prog | grep -A3 woo
390: xdp  name woo  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-31T24:66:44+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        pids simple-prog(10381)
Мы видим, что в системе загруженная программа woo , у которой глобальный ID равен 390, и что в данный момент в процессе simple-prog имеется открытый файловый дескриптор, указывающий на программу (и если simple-prog он завершит работу, то woo исчезнет). Как и ожидалось, программа woo занимает 16 байт — две инструкции — бинарных кода в архитектуре BPF, но в нативном виде (x86_64) — это уже 40 байт. Давайте взглянем на нашу программу в оригинальном виде:
# bpftool prog dump xlated id 390
   0: (b7) r0 = 2
   1: (95) exit
без сюрпризов. Теперь посмотрим на код, созданный JIT-компилятором:
# bpftool prog dump jited id 390
bpf_prog_3b185187f1855c4c_woo:
   0:   nopl   0x0(%rax,%rax,1)
   5:   push   %rbp
   6:   mov    %rsp,%rbp
   9:   sub    $0x0,%rsp
  10:   push   %rbx
  11:   push   %r13
  13:   push   %r14
  15:   push   %r15
  17:   pushq  $0x0
  19:   mov    $0x2,%eax
  1e:   pop    %rbx
  1f:   pop    %r15
  21:   pop    %r14
  23:   pop    %r13
  25:   pop    %rbx
  26:   leaveq
  27:   retq
не очень эффективно для exit(2), но справедливости ради, наша программа слишком проста, а для нетривиальных программ пролог и эпилог, добавленные JIT-компилятором, конечно, необходимы.
Maps
Programi BPF mogu koristiti strukturirane oblasti memorije, dostupne kako drugim programima BPF, tako i programima iz prostora korisnika. Ovi objekti se nazivaju maps, a u ovom odeljku ćemo pokazati kako njima upravljati pomoću sistemskog poziva. bpf.
Odmah da kažemo, mogućnosti maps nije ograničena samo na pristup zajedničkoj memoriji. Postoje mape posebne namene, koje sadrže, na primer, pokazivače na BPF programe ili pokazivače na mrežne interfejse, mape za rad sa perf događajima itd. O njima ovde nećemo govoriti kako ne bismo zbunili čitaoca. Pored toga, zanemarujemo probleme sinhronizacije, jer to nije važno za naše primere. Potpunu listu dostupnih tipova mapova možete pronaći u , a u ovom odeljku kao primer uzimamo istorijski prvi tip, heš-tabelu. BPF_MAP_TYPE_HASH.
Ako kreirate heš-tabelu, recimo, u C++, reći ćete unordered_map woo, što na srpskom znači „treba mi tabela woo neograničenog veličine, sa ključevima koji imaju tip int, a vrednosti — tip long“. Da bismo kreirali BPF heš-tabelu, moramo uraditi otprilike isto, uz napomenu da ćemo morati da navedemo maksimalnu veličinu tabele, a umesto tipova ključeva i vrednosti, moramo navesti njihove veličine u bajtovima. Za kreiranje mapova koristi se komanda BPF_MAP_CREATE sistemskega klica bpf. Pogledajmo više-manje minimalan program koji kreira map. Nakon prethodnog programa koji učitava BPF programe, ovaj bi vam trebao delovati jednostavno:
$ cat simple-map.c
#define _GNU_SOURCE
#include
#include
#include
#include

int main(void)
{
    union bpf_attr attr = {
        .map_type = BPF_MAP_TYPE_HASH,
        .key_size = sizeof(int),
        .value_size = sizeof(int),
        .max_entries = 4,
    };
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));

    for ( ;; )
        pause();
}
Ovde definišemo set parametara attr, u kojem kažemo „treba mi heš-tabela sa ključevima i vrednostima veličine sizeof(int), u koju mogu staviti najviše četiri elementa“. Prilikom kreiranja BPF mapova mogu se navoditi i drugi parametri, na primer, kao što smo u primeru sa programom naveli naziv objekta kao "woo".
Skompajliraćemo i pokrenuti program:
$ clang -g -O2 simple-map.c -o simple-map
$ sudo strace ./simple-map
execve("./simple-map", ["./simple-map"], 0x7ffd40a27070 /* 14 vars */) = 0
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_HASH, key_size=4, value_size=4, max_entries=4, map_name="woo", ...}, 72) = 3
pause(
Tukaj je sistemski klic bpf(2) nam je vrnil opisovalec mape s številko 3 in nato program, kot je bilo pričakovano, čaka na nadaljnja navodila v sistemskem klicu pause(2).
Zdaj bomo svojo aplikacijo poslali v ozadje ali odprli drugo terminal in si ogledali naš objekt s pomočjo orodja bpftool (lahko razlikujemo našo mapo od drugih po njenem imenu):
$ sudo bpftool map
...
114: hash  name woo  flags 0x0
        key 4B  value 4B  max_entries 4  memlock 4096B
...
Številka 114 je globalni ID našega objekta. Katerekoli program v sistemu lahko uporabi ta ID, da odpre že obstoječo mapo z ukazom BPF_MAP_GET_FD_BY_ID sistemskega klica bpf.
Zdaj se lahko igramo z našo hash tabelo. Oglejmo si njeno vsebino:
$ sudo bpftool map dump id 114
Našli smo 0 elementov
Prazno. Dajmo vanjo dodati vrednost hash[1] = 1:
$ sudo bpftool map update id 114 key 1 0 0 0 value 1 0 0 0Oglejmo tabelo še enkrat:
$ sudo bpftool map dump id 114
key: 01 00 00 00  value: 01 00 00 00
Našli smo 1 element
Hura! Uspešno smo dodali en element. Opazite, da za to delamo na ravni bajtov, saj bpftool ne ve, kakšno vrsto imajo vrednosti v hash tabeli. (To znanje mu lahko posredujemo z uporabo BTF, vendar o tem ne zdaj.)
Kako natančno bpftool bere in dodaja elemente? Poglejmo pod pokrov:
$ sudo strace -e bpf bpftool map dump id 114
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=NULL, next_key=0x55856ab65280}, 120) = 0
bpf(BPF_MAP_LOOKUP_ELEM, {map_fd=3, key=0x55856ab65280, value=0x55856ab652a0}, 120) = 0
key: 01 00 00 00  value: 01 00 00 00
bpf(BPF_MAP_GET_NEXT_KEY, {map_fd=3, key=0x55856ab65280, next_key=0x55856ab65280}, 120) = -1 ENOENT
Najprej smo odprli mapo po njenem globalnem ID z uporabo ukaza BPF_MAP_GET_FD_BY_ID in bpf(2) nam je vrnil opisovalec 3. Nato s pomočjo ukaza BPF_MAP_GET_NEXT_KEY smo našli prvi ključ v tabeli, tako da smo poslali NULL kot kazalec na "prejšnji" ključ. Ko imamo ključ, lahko izpeljemo BPF_MAP_LOOKUP_ELEM, ki vrne vrednost v kazalec value. Naslednji korak — poskušamo najti naslednji element, tako da posredujemo kazalec na trenutni ključ, vendar naša tabela vsebuje le en element in ukaz BPF_MAP_GET_NEXT_KEY vračajo ENOENT.
V redu, spremenimo vrednost pod ključem 1, recimo, da naša poslovna logika zahteva zapisati hash[1] = 2:
$ sudo strace -e bpf bpftool map update id 114 key 1 0 0 0 value 2 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x55dcd72be260, value=0x55dcd72be280, flags=BPF_ANY}, 120) = 0
Kot je bilo pričakovano, je to zelo enostavno: ukaz BPF_MAP_GET_FD_BY_ID odpre našo mapo po ID, ukaz BPF_MAP_UPDATE_ELEM prepisuje element.
После создания хэш-таблицы из одной программы мы можем читать и записывать её содержимое из другой. Обратите внимание, что если это возможно из командной строки, значит, так сможет сделать и любая другая программа в системе. Кроме команд, описанных выше, для работы с мапами из пространства пользователя доступны :
BPF_MAP_LOOKUP_ELEM: найти значение по ключуBPF_MAP_UPDATE_ELEM: обновить/создать значениеBPF_MAP_DELETE_ELEM: удалить ключBPF_MAP_GET_NEXT_KEY: найти следующий (или первый) ключBPF_MAP_GET_NEXT_ID: позволяет пройтись по всем существующим мапам, так работаетbpftool mapBPF_MAP_GET_FD_BY_ID: открыть существующий мап по его глобальному IDBPF_MAP_LOOKUP_AND_DELETE_ELEM: атомарно обновить значение объекта и вернуть староеBPF_MAP_FREEZE: сделать мап неизменяемым из userspace (эту операцию нельзя отменить)BPF_MAP_LOOKUP_BATCH,BPF_MAP_LOOKUP_AND_DELETE_BATCH,BPF_MAP_UPDATE_BATCH,BPF_MAP_DELETE_BATCH: массовые операции. Например,BPF_MAP_LOOKUP_AND_DELETE_BATCH— это единственный надежный способ прочитать и обнулить все значения из мапа
Не все из этих команд работают для всех типов мапов, но, в общем, работа с другими типами мапов из пространства пользователя выглядит точно так же, как и работа с хэш-таблицами.
Для порядка давайте завершим наши эксперименты с хэш-таблицей. Помните, что мы создали таблицу, в которой может содержаться до четырёх ключей? Добавим ещё несколько элементов:
$ sudo bpftool map update id 114 key 2 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 3 0 0 0 value 1 0 0 0
$ sudo bpftool map update id 114 key 4 0 0 0 value 1 0 0 0
Пока всё хорошо:
$ sudo bpftool map dump id 114
key: 01 00 00 00  value: 01 00 00 00
key: 02 00 00 00  value: 01 00 00 00
key: 04 00 00 00  value: 01 00 00 00
key: 03 00 00 00  value: 01 00 00 00
Найдено 4 элемента
Попробуем добавить ещё один:
$ sudo bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
Ошибка: обновление не удалось: Список аргументов слишком длинный
Как и ожидалось, у нас не получилось. Давайте посмотрим на ошибку подробнее:
$ sudo strace -e bpf bpftool map update id 114 key 5 0 0 0 value 1 0 0 0
bpf(BPF_MAP_GET_FD_BY_ID, {map_id=114, next_id=0, open_flags=0}, 120) = 3
bpf(BPF_OBJ_GET_INFO_BY_FD, {info={bpf_fd=3, info_len=80, info=0x7ffe6c626da0}}, 120) = 0
bpf(BPF_MAP_UPDATE_ELEM, {map_fd=3, key=0x56049ded5260, value=0x56049ded5280, flags=BPF_ANY}, 120) = -1 E2BIG (Список аргументов слишком длинный)
Ошибка: обновление не удалось: Список аргументов слишком длинный
+++ вышел с 255 +++
Всё в порядке: как и ожидалось, команда BPF_MAP_UPDATE_ELEM пытается создать новый, пятый ключ, но завершается с E2BIG.
Torej, znamo ustvarjati in nalagati programe BPF, prav tako pa tudi ustvarjati in upravljati mape iz uporabniškega prostora. Zdaj je smiselno pogledati, kako lahko uporabljamo mape iz samih programov BPF. Lahko bi o tem govorili v jeziku težko berljivih programov v strojnih kodah-makrosih, vendar je dejansko prišel čas, da pokažemo, kako se programe BPF resnično piše in vzdržuje — s pomočjo libbpf.
(Za bralce, ki so nezadovoljni z odsotnostjo nizko nivojnega primera: podrobno bomo obravnavali programe, ki uporabljajo mape in pomožne funkcije, ustvarjene s pomočjo libbpf in razložili, kaj se dogaja na ravni navodil. Za bralce, ki so nezadovoljni zelo močno, smo dodali na ustreznem mestu članka.)
Pisanje programov BPF z uporabo libbpf.
Pisanje programov BPF s pomočjo strojnih kodov je morda zanimivo le na začetku, nato pa pride do zasičenja. V tem trenutku je treba usmeriti pogled na llvm, ki vsebuje backend za generiranje kode za arhitekturo BPF, kot tudi na knjižnico libbpf, ki omogoča pisanje uporabniškega dela aplikacij BPF in nalaganje kode programov BPF, ustvarjene s pomočjo llvm/clang.
V resnici, kot bomo videli v tem in naslednjih člankih, libbpf opravi precej dela in brez nje (ali podobnih orodij — iproute2, libbcc, libbpf-go, itd.) ni mogoče živeti. Ena od killer funkcij projekta libbpf je BPF CO-RE (Compile Once, Run Everywhere) — projekt, ki omogoča pisanje prenosljivih programov BPF z enega jedra na drugo, z možnostjo izvajanja na različnih API-jih (na primer, ko se struktura jedra spreminja z različice na različico). Da bi imeli možnost delati s CO-RE, mora biti vaše jedro skompilirano s podporo za BTF (kako to narediti, razlagamo v poglavju . Preveriti, ali je vaše jedro z BTF ali ne, je zelo preprosto — po obstoju naslednje datoteke:
$ ls -lh /sys/kernel/btf/vmlinux
-r--r--r-- 1 root root 2.6M Jul 29 15:30 /sys/kernel/btf/vmlinux
Ta datoteka vsebuje informacije o vseh vrstah podatkov, uporabljenih v jedru, in se uporablja v vseh naših primerih, ki uporabljajo libbpf. O CO-RE bomo podrobno govorili v naslednjem članku, v tem pa — preprosto si zgradite jedro z CONFIG_DEBUG_INFO_BTF.
Biblioteka libbpf živi neposredno v direktoriju tools/lib/bpf jedra in se njen razvoj odvija prek mailing liste bpf@vger.kernel.org. Vendar pa za potrebe aplikacij, ki delujejo izven jedra, podpiramo ločeno shrambo , v kateri se jedrska knjižnica zrcali za branje več ali manj takšna, kot je.
V tem razdelku bomo pogledali, kako lahko ustvarimo projekt, ki uporablja libbpf, napisali bomo nekaj (več ali manj nepomembnih) testnih programov in podrobno razložili, kako vse to deluje. To nam bo omogočilo, da v naslednjih razdelkih lažje razložimo, kako točno programi BPF komunicirajo z maps, kernel helpers, BTF itd.
Običajno projekti, ki uporabljajo libbpf , dodajo GitHubovo shramba kot git submodule, kar bomo storili tudi mi:
$ mkdir /tmp/libbpf-example
$ cd /tmp/libbpf-example/
$ git init-db
Initialized empty Git repository in /tmp/libbpf-example/.git/
$ git submodule add https://github.com/libbpf/libbpf.git
Cloning into '/tmp/libbpf-example/libbpf'...
remote: Enumerating objects: 200, done.
remote: Counting objects: 100% (200/200), done.
remote: Compressing objects: 100% (103/103), done.
remote: Total 3354 (delta 101), reused 118 (delta 79), pack-reused 3154
Receiving objects: 100% (3354/3354), 2.05 MiB | 10.22 MiB/s, done.
Resolving deltas: 100% (2176/2176), done.
Zgradi se libbpf zelo preprosto:
$ cd libbpf/src
$ mkdir build
$ OBJDIR=build DESTDIR=root make -s install
$ find root
root
root/usr
root/usr/include
root/usr/include/bpf
root/usr/include/bpf/bpf_tracing.h
root/usr/include/bpf/xsk.h
root/usr/include/bpf/libbpf_common.h
root/usr/include/bpf/bpf_endian.h
root/usr/include/bpf/bpf_helpers.h
root/usr/include/bpf/btf.h
root/usr/include/bpf/bpf_helper_defs.h
root/usr/include/bpf/bpf.h
root/usr/include/bpf/libbpf_util.h
root/usr/include/bpf/libbpf.h
root/usr/include/bpf/bpf_core_read.h
root/usr/lib64
root/usr/lib64/libbpf.so.0.1.0
root/usr/lib64/libbpf.so.0
root/usr/lib64/libbpf.a
root/usr/lib64/libbpf.so
root/usr/lib64/pkgconfig
root/usr/lib64/pkgconfig/libbpf.pc
Naš nadaljnji načrt v tem razdelku je naslednji: napisali bomo BPF program tipa BPF_PROG_TYPE_XDP, enak, kot je v prejšnjem primeru, vendar v C-ju, ga bomo prevedli z uporabo clang, in napisali bomo pomočnik program, ki bo naložil v jedro. V naslednjih razdelkih bomo razširili funkcionalnosti tako BPF programa kot pomočnika programa.
Primer: ustvarjanje polnopravne aplikacije s pomočjo libbpf
Na začetku bomo uporabili datoteko /sys/kernel/btf/vmlinux, o kateri smo govorili zgoraj, in ustvarili njen ekvivalent v obliki header datoteke:
$ bpftool btf dump file /sys/kernel/btf/vmlinux format c > vmlinux.hV tej datoteki bodo shranjene vse podatkovne strukture, ki so v našem jedru, na primer, tukaj je, kako v jedru definiramo glavo IPv4:
$ grep -A 12 'struct iphdr {' vmlinux.h
struct iphdr {
    __u8 ihl: 4;
    __u8 version: 4;
    __u8 tos;
    __be16 tot_len;
    __be16 id;
    __be16 frag_off;
    __u8 ttl;
    __u8 protocol;
    __sum16 check;
    __be32 saddr;
    __be32 daddr;
};
Zdaj bomo napisali naš BPF program v jeziku C:
$ cat xdp-simple.bpf.c
#include "vmlinux.h"
#include

SEC("xdp/simple")
int simple(void *ctx)
{
        return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Čeprav je naš program zelo preprost, moramo vseeno posvetiti pozornost številnim podrobnostim. Prvi header datoteka, ki jo vključujemo, je vmlinux.h, ki smo jo pravkar generirali s pomočjo bpftool btf dump — zdaj ne potrebujemo več namestiti paketa kernel-headers, da bi izvedeli, kakšne so strukture jedra. Naslednji header prihaja iz knjižnice libbpf. Ta nam je trenutno potreben samo, da se določi makro SEC, ki pošilja simbol v ustrezni odsek objektne datoteke ELF. Naš program se nahaja v odseku xdp/simple, kjer pred poševnico določimo vrsto programa BPF — to je dogovor, ki se uporablja v libbpf, na podlagi imena odseka bo podal pravilno vrsto ob zagonu bpf(2). Sam program BPF na C — je zelo preprost in sestoji iz enega stavka return XDP_PASS. Nazadnje, poseben odsek "license" ima naziv licence.
Naš program lahko prevedemo s pomočjo llvm/clang, različice >= 10.0.0, še bolje — višje (glej oddelek ):
$ clang --version
clang version 11.0.0 (https://github.com/llvm/llvm-project.git afc287e0abec710398465ee1f86237513f2b5091)
...

$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
Med zanimivimi lastnostmi: določimo ciljno arhitekturo -target bpf in pot do headerjev libbpf, ki smo jih nedavno namestili. Prav tako ne pozabite na -O2, brez te možnosti vas lahko čakajo presenečenja v prihodnje. Poglejmo našo kodo, ali nam je uspelo napisati program, ki smo si ga želeli?
$ llvm-objdump --section=xdp/simple --no-show-raw-insn -D xdp-simple.bpf.o

xdp-simple.bpf.o:       file format elf64-bpf

Disassembly of section xdp/simple:

0000000000000000 :
       0:       r0 = 2
       1:       exit
Da, uspelo je! Zdaj imamo binarno datoteko s programom in želimo ustvariti aplikacijo, ki jo bo naložila v jedro. Za to knjižnica libbpf ponuja dve možnosti — uporabiti nizko nivojski API ali visoko nivojski API. Odšli bomo po drugi poti, saj se želimo naučiti pisati, nalagati in povezovati programe BPF z minimalnim trudom za nadaljnje učenje.
Za začetek moramo generirati 'skelet' našega programa iz njegove binarne datoteke s pomočjo istega orodja bpftool — švicarskega noža sveta BPF (kar se lahko razume tudi dobesedno, saj je Daniel Borkman eden od ustvarjalcev in vzdrževalcev BPF — Švicar):
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.hV datoteki xdp-simple.skel.h vsebuje binarno kodo naše programa in funkcije za upravljanje — nalaganje, povezovanje, odstranjevanje našega objekta. V našem preprostem primeru se to zdi pretirano, vendar deluje tudi, ko objekta vsebuje veliko programov BPF in map, in za nalaganje tega velikega ELF-a nam zadostuje, da generiramo okostje in pokličemo eno do dve funkciji iz uporabniške aplikacije, o kateri bomo zdaj govorili.
Naša nalagalna programa je pravzaprav trivialna:
#include <err.h>
#include <unistd.h>
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "failed to open and/or load BPF objectn");

    pause();

    xdp_simple_bpf__destroy(obj);
}
Tukaj struct xdp_simple_bpf je definirana v datoteki xdp-simple.skel.h in opisuje našo objektno datoteko:
struct xdp_simple_bpf {
    struct bpf_object_skeleton *skeleton;
    struct bpf_object *obj;
    struct {
        struct bpf_program *simple;
    } progs;
    struct {
        struct bpf_link *simple;
    } links;
};
Opazimo lahko sledi nizkonivojskega API-ja: strukturo struct bpf_program *simple in struct bpf_link *simple. Prva struktura opisuje našo program, zabeleženo v razdelku xdp/simple, druga pa opisuje način, kako se program povezuje z virom dogodkov.
Funkcija xdp_simple_bpf__open_and_load, odpre ELF objekt, ga analizira, ustvari vse strukture in podstrukture (poleg programa v ELF so v njem še druge sekcije — podatki, podatki le za branje, informacije o odpravljanju napak, licenca itd.), nato pa ga naloži v jedro s sistemskim klicem bpf, kar lahko preverimo tako, da skompiliramo in zaženemo program:
$ clang -O2 -I ./libbpf/src/root/usr/include/ xdp-simple.c -o xdp-simple ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz

$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_BTF_LOAD, 0x7ffdb8fd9670, 120)  = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=2, insns=0xdfd580, license="GPL", log_level=0, log_size=0, log_buf=NULL, kern_version=KERNEL_VERSION(5, 8, 0), prog_flags=0, prog_name="simple", prog_ifindex=0, expected_attach_type=0x25 /* BPF_??? */, ...}, 120) = 4
Zdaj si oglejmo naš program s pomočjo bpftool. Ugotovimo njen ID:
# bpftool p | grep -A4 simple
463: xdp  name simple  tag 3b185187f1855c4c  gpl
        loaded_at 2020-08-01T01:59:49+0000  uid 0
        xlated 16B  jited 40B  memlock 4096B
        btf_id 185
        pids xdp-simple(16498)
in dumpamo (uporabljamo skrajšano različico ukaza bpftool prog dump xlated):
# bpftool p d x id 463
int simple(void *ctx):
; return XDP_PASS;
   0: (b7) r0 = 2
   1: (95) exit
Nekaj novega! Program je natisnil kose našega izvornega datoteka v jeziku C. To je storila knjižnica libbpf, ki je našla razdelek za odpravljanje napak v binarcu, ga skompilirala v objekt BTF, ga naložila v jedro s pomočjo BPF_BTF_LOAD, nato pa je navedla pridobljen deskriptor datoteke pri nalaganju programa z ukazom BPG_PROG_LOAD.
Pomočniki jedra
BPF программы могут запускать «внешние» функции — kernel helpers. Эти функции-помощники позволяют BPF программам получать доступ к структурам ядра, управлять картами (maps), а также взаимодействовать с «реальным миром» — создавать события производительности (perf events), управлять оборудованием (например, перенаправлять пакеты) и т.п.
Пример: bpf_get_smp_processor_id
Согласно парадигме «учимся на примерах», рассмотрим одну из функций-помощников, bpf_get_smp_processor_id(), в файле kernel/bpf/helpers.c. Она возвращает номер процессора, на котором выполняется вызывающая программа BPF. Но нас интересует не её семантика, а то, что её реализация занимает одну строчку:
BPF_CALL_0(bpf_get_smp_processor_id)
{
    return smp_processor_id();
}
Определения функций-помощников BPF похожи на определения системных вызовов Linux. Здесь, например, определяется функция, не имеющая аргументов. (Функция, принимающая, скажем, три аргумента, определяется с помощью макроса BPF_CALL_3. Максимальное количество аргументов — пять.) Однако это лишь первая часть определения. Вторая часть заключается в определении структуры типа struct bpf_func_proto, которая содержит описание функции-помощника, понятное проверщику (verifier):
const struct bpf_func_proto bpf_get_smp_processor_id_proto = {
    .func     = bpf_get_smp_processor_id,
    .gpl_only = false,
    .ret_type = RET_INTEGER,
};
Регистрация функций-помощников
Для того чтобы программы BPF определенного типа могли использовать эту функцию, они должны зарегистрировать её, например, для типа BPF_PROG_TYPE_XDP в ядре определяется функция xdp_func_proto, которая по ID функции-помощника определяет, поддерживает ли XDP эту функцию или нет. Наша функция :
static const struct bpf_func_proto *
xdp_func_proto(enum bpf_func_id func_id, const struct bpf_prog *prog)
{
    switch (func_id) {
    ...
    case BPF_FUNC_get_smp_processor_id:
        return &bpf_get_smp_processor_id_proto;
    ...
    }
}
Новые типы программ BPF «определяются» в файле с помощью макроса BPF_PROG_TYPE. Определяются взято в кавычки, так как это логическое определение, а в терминах языка C определение целого набора конкретных структур происходит в других местах. В частности, в файле kernel/bpf/verifier.c все определения из файла bpf_types.h используются для создания массива структур bpf_verifier_ops[]:
static const struct bpf_verifier_ops *const bpf_verifier_ops[] = {
#define BPF_PROG_TYPE(_id, _name, prog_ctx_type, kern_ctx_type)
    [_id] = & _name ## _verifier_ops,
#include
#undef BPF_PROG_TYPE
};
To je, za vsak tip programov BPF se določi kazalec na strukturo podatkov tipa struct bpf_verifier_ops, ki se inicializira z vrednostjo _name ## _verifier_ops, tj. xdp_verifier_ops za xdp. Struktura xdp_verifier_ops в файле net/core/filter.c takole:
const struct bpf_verifier_ops xdp_verifier_ops = {
    .get_func_proto     = xdp_func_proto,
    .is_valid_access    = xdp_is_valid_access,
    .convert_ctx_access = xdp_convert_ctx_access,
    .gen_prologue       = bpf_noop_prologue,
};
Tukaj vidimo našo znano funkcijo xdp_func_proto, ki se bo izvajala verifier vsakič, ko se sreča z klicem neke funkcije znotraj programa BPF, glej. .
Poglejmo, kako hipotetični program BPF uporablja funkcijo bpf_get_smp_processor_id. Za to bomo prepisali program iz našega prejšnjega razdelka na naslednji način:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

SEC("xdp/simple")
int simple(void *ctx)
{
    if (bpf_get_smp_processor_id() != 0)
        return XDP_DROP;
    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Simbol bpf_get_smp_processor_id u <bpf/bpf_helper_defs.h> knjižnice libbpf kako
static u32 (*bpf_get_smp_processor_id)(void) = (void *) 8;tj. bpf_get_smp_processor_id — to je kazalec na funkcijo, katere vrednost je 8, kjer je 8 — vrednost BPF_FUNC_get_smp_processor_id tipa enum bpf_fun_id, ki je določena za nas v datoteki vmlinux.h (datoteka bpf_helper_defs.h v jedru se generira s skripto, zato so 'magične' številke v redu). Ta funkcija ne sprejema argumentov in vrača vrednost tipa __u32. Ko jo pokličemo v našem programu, clang generira ukaz BPF_CALL »prave oblike«. Poglejmo program in si oglejmo sekcijo xdp/simple:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ llvm-objdump -D --section=xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       file format elf64-bpf

Disassembly of section xdp/simple:

0000000000000000 <simple>:
       0:       85 00 00 00 08 00 00 00 call 8
       1:       bf 01 00 00 00 00 00 00 r1 = r0
       2:       67 01 00 00 20 00 00 00 r1 <<= 32
       3:       77 01 00 00 20 00 00 00 r1 >>= 32
       4:       b7 00 00 00 02 00 00 00 r0 = 2
       5:       15 01 01 00 00 00 00 00 if r1 == 0 goto +1 <LBB0_2>
       6:       b7 00 00 00 01 00 00 00 r0 = 1

0000000000000038 <LBB0_2>:
       7:       95 00 00 00 00 00 00 00 exit
V prvi vrstici vidimo ukaz call, parameter IMM ki je enak 8, ter SRC_REG — nič. Po ABI dogovoru, ki ga uporablja verifier, je to klic funkcije-pomočnika pod številko osem. Po njenem zagonu je logika preprosta. Vrnjena vrednost iz registra r0 se kopira v r1 in na vrsticah 2,3 se pretvori v tip u32 — zgornji 32 biti so ničlirani. Na vrsticah 4,5,6,7 vračamo 2 (XDP_PASS) ali 1 (XDP_DROP) odvisno od tega, ali je funkcija-pomočnik na vrstici 0 vrnila ničelno ali nenihovno vrednost.
Preverimo se: naložimo program in si oglejmo izhod bpftool prog dump xlated:
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple &
[2] 10914

$ sudo bpftool p | grep simple
523: xdp  name simple  tag 44c38a10c657e1b0  gpl
        pids xdp-simple(10915)

$ sudo bpftool p d x id 523
int simple(void *ctx):
; if (bpf_get_smp_processor_id() != 0)
   0: (85) call bpf_get_smp_processor_id#114128
   1: (bf) r1 = r0
   2: (67) r1 <>= 32
   4: (b7) r0 = 2
; }
   5: (15) if r1 == 0x0 goto pc+1
   6: (b7) r0 = 1
   7: (95) exit
Добре, верификатор нашел правильный kernel-helper.
Пример: передаем аргументы и, наконец, запускаем программу!
Все функции-помощники на уровне выполнения имеют прототип
u64 fn(u64 r1, u64 r2, u64 r3, u64 r4, u64 r5)Параметры функциям-помощникам передаются в регистрах r1—r5, а значение возвращается в регистре r0. Функций, принимающих больше пяти аргументов, нет и добавлять их поддержку в будущем не предполагается.
Давайте посмотрим на новый kernel helper и то, как BPF передает параметры. Перепишем xdp-simple.bpf.c следующим образом (остальные строки не изменились):
SEC("xdp/simple")
int simple(void *ctx)
{
    bpf_printk("running on CPU%un", bpf_get_smp_processor_id());
    return XDP_PASS;
}
Наша программа печатает номер CPU, на котором она запущена. Скомпилируем ее и посмотрим на код:
$ llvm-objdump -D --section=xdp/simple --no-show-raw-insn xdp-simple.bpf.o

0000000000000000 :
       0:       r1 = 10
       1:       *(u16 *)(r10 - 8) = r1
       2:       r1 = 8441246879787806319 ll
       4:       *(u64 *)(r10 - 16) = r1
       5:       r1 = 2334956330918245746 ll
       7:       *(u64 *)(r10 - 24) = r1
       8:       call 8
       9:       r1 = r10
      10:       r1 += -24
      11:       r2 = 18
      12:       r3 = r0
      13:       call 6
      14:       r0 = 2
      15:       exit
В строках 0-7 мы записываем на стек строку running on CPU%un, а затем на строке 8 запускаем знакомый нам bpf_get_smp_processor_id. В строках 9-12 мы подготавливаем аргументы хелпера bpf_printk — регистры r1, r2, r3. Почему их три, а не два? Потому что bpf_printk — вокруг настоящего хелпера bpf_trace_printk, которому требуется передать размер форматной строки.
Давайте теперь добавим пару строчек к xdp-simple.c, чтобы наша программа подсоединялась к интерфейсу lo и по-настоящему запускалась!
$ cat xdp-simple.c
#include
#include
#include
#include "xdp-simple.skel.h"

int main(int argc, char **argv)
{
    __u32 flags = XDP_FLAGS_SKB_MODE;
    struct xdp_simple_bpf *obj;

    obj = xdp_simple_bpf__open_and_load();
    if (!obj)
        err(1, "failed to open and/or load BPF objectn");

    bpf_set_link_xdp_fd(1, -1, flags);
    bpf_set_link_xdp_fd(1, bpf_program__fd(obj->progs.simple), flags);

cleanup:
    xdp_simple_bpf__destroy(obj);
}
Здесь мы используем функцию bpf_set_link_xdp_fd, которая подсоединяет программы BPF типа XDP к сетевым интерфейсам. Мы захардкодили номер интерфейса lo, ki je vedno enak 1. Funkcijo zaženemo dvakrat, da najprej odklopimo star program, če je bil priključen. Opazite, da sedaj ne potrebujemo klica pausa ali neskončna zanka: naš boot program se bo končal, vendar program BPF ne bo uničen, saj je priključen na vir dogodkov. Po uspešnem nalaganju in priključitvi bo program deloval za vsak omrežni paket, ki prihaja na lo.
Naložimo program in pogledamo v vmesnik lo:
$ sudo ./xdp-simple
$ sudo bpftool p | grep simple
669: xdp  ime simple  oznaka 4fca62e77ccb43d6  gpl
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue stanje NEPOZNANO način PRIVZETO skupina privzeto qlen 1000
    povezava/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 669
Program, ki smo ga naložili, ima ID 669, in točno ta ID vidimo na vmesniku lo. Pošljimo nekaj paketov na 127.0.0.1 (zahteva + odgovor):
$ ping -c1 localhostin zdaj poglejmo vsebino odločitvenega virtualnega datoteke /sys/kernel/debug/tracing/trace_pipe, v katero bpf_printk piše svoje sporočila:
# cat /sys/kernel/debug/tracing/trace_pipe
ping-13937 [000] d.s1 442015.377014: bpf_trace_printk: running on CPU0
ping-13937 [000] d.s1 442015.377027: bpf_trace_printk: running on CPU0
Dva paketa sta bila opažena na lo in obdelana na CPU0 — naš prvi pravi brezsmiselni program BPF je deloval!
Upoštevati je treba, da bpf_printk ne piše brez razloga v odločitveni datoteki: to ni najboljša podpora za uporabo v produkciji, ampak naš cilj je bil prikazati nekaj preprostega.
Dostop do maps iz programov BPF
Primer: uporabljamo map iz programa BPF
V prejšnjih razdelkih smo se naučili ustvarjati in uporabljati mape iz prostora uporabnika, zdaj pa si oglejmo jedrski del. Začnimo, kot ponavadi, z example. Prepisali bomo naš program xdp-simple.bpf.c takole:
#include "vmlinux.h"
#include <bpf/bpf_helpers.h>

struct {
    __uint(type, BPF_MAP_TYPE_ARRAY);
    __uint(max_entries, 8);
    __type(key, u32);
    __type(value, u64);
} woo SEC(".maps");

SEC("xdp/simple")
int simple(void *ctx)
{
    u32 key = bpf_get_smp_processor_id();
    u32 *val;

    val = bpf_map_lookup_elem(&woo, &key);
    if (!val)
        return XDP_ABORTED;

    *val += 1;

    return XDP_PASS;
}

char LICENSE[] SEC("license") = "GPL";
Na začetek programa smo dodali definicijo mape woo: to je tabela z 8 elementi, v kateri so shranjene vrednosti tipa u64 (v C bi takšno tabelo definirali kot u64 woo[8]). V programu "xdp/simple" pridobimo številko trenutnega procesorja v spremenljivko key in nato s pomočjo pomožne funkcije bpf_map_lookup_element pridobimo kazalec na ustrezen zapis v tabeli, katerega povečamo za ena. Prevedeno v slovenščino: štejeva statistiko, na katerem CPU so bili obdelani vhodni paketi. Poskusimo zagnati program:
$ clang -O2 -g -c -target bpf -I libbpf/src/root/usr/include xdp-simple.bpf.c -o xdp-simple.bpf.o
$ bpftool gen skeleton xdp-simple.bpf.o > xdp-simple.skel.h
$ clang -O2 -g -I ./libbpf/src/root/usr/include/ -o xdp-simple xdp-simple.c ./libbpf/src/root/usr/lib64/libbpf.a -lelf -lz
$ sudo ./xdp-simple
Preverimo, da se je priključil na lo in pošljemo nekaj paketov:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 108

$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
Poglejmo zdaj vsebino polja:
$ sudo bpftool map dump name woo
[
    { "key": 0, "value": 0 },
    { "key": 1, "value": 400 },
    { "key": 2, "value": 0 },
    { "key": 3, "value": 0 },
    { "key": 4, "value": 0 },
    { "key": 5, "value": 0 },
    { "key": 6, "value": 0 },
    { "key": 7, "value": 46400 }
]
Skoraj vsi procesi so bili obdelani na CPU7. To nam ni pomembno, pomembno je, da program deluje in da smo razumeli, kako dostopati do map iz BPF programov — s pomočjo .
Mistični kazalec
Torej, do mape v programu BPF lahko dostopamo s klici takšne vrste
val = bpf_map_lookup_elem(&woo, &key);kjer funkcija pomočnica izgleda takole
void *bpf_map_lookup_elem(struct bpf_map *map, const void *key)ampak mi predajamo kazalec &woo na anonimno strukturo struct { ... }…
Če si ogledamo assembler program, bomo videli, da vrednost &woo v resnici ni definirana (vrstica 4):
llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

xdp-simple.bpf.o:       file format elf64-bpf

Disassembly of section xdp/simple:

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
...
in je vsebovano v relokacijah:
$ llvm-readelf -r xdp-simple.bpf.o | head -4

Relocation section '.relxdp/simple' at offset 0xe18 contains 1 entries:
    Offset             Info             Type               Symbol's Value  Symbol's Name
0000000000000020  0000002700000001 R_BPF_64_64            0000000000000000 woo
Ampak, če si ogledamo že naložen program, bomo videli kazalec na pravilno mapo (vrstica 4):
$ sudo bpftool prog dump x name simple
int simple(void *ctx):
   0: (85) call bpf_get_smp_processor_id#114128
   1: (63) *(u32 *)(r10 -4) = r0
   2: (bf) r2 = r10
   3: (07) r2 += -4
   4: (18) r1 = map[id:64]
...
Tako lahko zaključimo, da je ob zagonu našega vnosnega programa povezava na &woo bila zamenjana z nečim knjigo libbpf. Najprej si bomo ogledali izhod strace:
$ sudo strace -e bpf ./xdp-simple
...
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, key_size=4, value_size=8, max_entries=8, map_name="woo", ...}, 120) = 4
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, prog_name="simple", ...}, 120) = 5
Vidi se, da libbpf je ustvarila mapo woo in nato naložila naš program simple. Poglejmo podrobneje, kako nalagamo program:
- klicamo
xdp_simple_bpf__open_and_loadiz datotekexdp-simple.skel.h - ki pokliče
xdp_simple_bpf__loadiz datotekexdp-simple.skel.h - ki pokliče
bpf_object__load_skeletoniz datotekelibbpf/src/libbpf.c - ki pokliče
bpf_object__load_xattrizlibbpf/src/libbpf.c
Zadnja funkcija, poleg vsega, bo poklicala bpf_object__create_maps, ki ustvarja ali odpre obstoječe maps, jih pretvori v datotečne descriptorje. (To je mesto, kjer vidimo BPF_MAP_CREATE v izhodu strace.) Nato se pokliče funkcijo bpf_object__relocate , in prav ta nas zanima, saj se spomnimo, da smo videli woo v tabeli relokacij. Če jo raziskujemo, na koncu prispemo do funkcije bpf_program__relocate, ki :
case RELO_LD64:
    insn[0].src_reg = BPF_PSEUDO_MAP_FD;
    insn[0].imm = obj->maps[relo->map_idx].fd;
    break;
Torej, vzamemo našo instrukcijo
18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 llin zamenjamo registrsko izvorno vrednost z BPF_PSEUDO_MAP_FD, prvi IMM pa z datotečnim descriptorjem našega mapa in, če je enak, na primer, 0xdeadbeef, bomo na koncu dobili instrukcijo
18 11 00 00 ef eb ad de 00 00 00 00 00 00 00 00 r1 = 0 llTako se informacije o mapah prenašajo v posebno naloženo BPF programa. Pri tem se map lahko ustvari z BPF_MAP_CREATE, ali se odpre po ID-ju z BPF_MAP_GET_FD_BY_ID.
Torej, pri uporabi libbpf je algoritem naslednji:
- med kompilacijo se ustvarjajo zapisi v tabeli relokacij za reference na mape
libbpfodpre ELF objekt, najde vse uporabljene mape in jim ustvari datotečne descriptorje- datotečni descriptorji se naložijo v jedro kot del instrukcije
LD64
Kot razumete, to še ni vse, in morali bomo pogledati v jedro. Na srečo imamo namig - zapisali smo vrednost BPF_PSEUDO_MAP_FD v registrsko izvorno vrednost in ga lahko raziščemo, kar nas pripelje v svetišče vseh svetij - kernel/bpf/verifier.c, kjer funkcija s karakterističnim imenom zamenja datotečni descriptor z naslovom strukture tipa struct bpf_map:
static int replace_map_fd_with_map_ptr(struct bpf_verifier_env *env) {
    ...

    f = fdget(insn[0].imm);
    map = __bpf_map_get(f);
    if (insn->src_reg == BPF_PSEUDO_MAP_FD) {
        addr = (unsigned long)map;
    }
    insn[0].imm = (u32)addr;
    insn[1].imm = addr >> 32;
(celoten koda je na voljo ). Tako da lahko dopolnimo naš algoritem:
- med nalaganjem programa verifier preverja pravilno uporabo mapa in zapisuje naslov ustrezne strukture
struct bpf_map
Pri nalaganju ELF binarne datoteke libbpf se zgodi še veliko dogodkov, a o tem bomo razpravljali v okviru drugih člankov.
Nalaganje programov in map brez libbpf
Kot obljubljeno, tukaj je primer za bralce, ki želijo vedeti, kako ustvariti in naložiti program, ki uporablja mape, brez pomoči libbpf. To je lahko koristno, ko delate v okolju, kjer ne morete zbrati odvisnosti, ali ko varčujete vsak bit ali pišete program tipo , ki dinamično generira BPF binarno kodo.
Da bi bilo lažje slediti logiki, bomo za te namene prenovili naš primer xdp-simple. Celotna in nekoliko razširjena koda programa, obravnavana v tem primeru, je na voljo na .
Logika našega aplikacije je naslednja:
- ustvariti mapo tipa
BPF_MAP_TYPE_ARRAYs pomočjo ukazaBPF_MAP_CREATE, - ustvariti program, ki uporablja to mapo,
- povezati program z vmesnikom,
lo,
kar se v človeščini prevaja kot
int main(void)
{
    int map_fd, prog_fd;

    map_fd = map_create();
    if (map_fd < 0)
        err(1, "bpf: BPF_MAP_CREATE");

    prog_fd = prog_load(map_fd);
    if (prog_fd < 0)
        err(1, "bpf: BPF_PROG_LOAD");

    xdp_attach(1, prog_fd);
}
Tukaj map_create ustvari mapo natanko tako, kot smo to storili v prvem primeru o sistemskem klicu bpf — „jedro, prosim, naredi mi novo mapo v obliki tabele z 8 elementi tipa __u64 in mi vrni datotečni descriptor“:
static int map_create()
{
    union bpf_attr attr;

    memset(&attr, 0, sizeof(attr));
    attr.map_type = BPF_MAP_TYPE_ARRAY,
    attr.key_size = sizeof(__u32),
    attr.value_size = sizeof(__u64),
    attr.max_entries = 8,
    strncpy(attr.map_name, "woo", sizeof(attr.map_name));
    return syscall(__NR_bpf, BPF_MAP_CREATE, &attr, sizeof(attr));
}
Program se tudi enostavno naloži:
static int prog_load(int map_fd)
{
    union bpf_attr attr;
    struct bpf_insn insns[] = {
        ...
    };

    memset(&attr, 0, sizeof(attr));
    attr.prog_type = BPF_PROG_TYPE_XDP;
    attr.insns     = ptr_to_u64(insns);
    attr.insn_cnt  = sizeof(insns)/sizeof(insns[0]);
    attr.license   = ptr_to_u64("GPL");
    strncpy(attr.prog_name, "woo", sizeof(attr.prog_name));
    return syscall(__NR_bpf, BPF_PROG_LOAD, &attr, sizeof(attr));
}
Zahtevna del: prog_load — je definicija naše BPF programa v obliki tabele struktur struct bpf_insn insns[]. Vendar pa lahko, ker uporabljamo program, ki ga imamo v C, malce prevaramo:
$ llvm-objdump -D --section xdp/simple xdp-simple.bpf.o

0000000000000000 :
       0:       85 00 00 00 08 00 00 00 call 8
       1:       63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0
       2:       bf a2 00 00 00 00 00 00 r2 = r10
       3:       07 02 00 00 fc ff ff ff r2 += -4
       4:       18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll
       6:       85 00 00 00 01 00 00 00 call 1
       7:       b7 01 00 00 00 00 00 00 r1 = 0
       8:       15 00 04 00 00 00 00 00 if r0 == 0 goto +4
       9:       61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0)
      10:       07 01 00 00 01 00 00 00 r1 += 1
      11:       63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1
      12:       b7 01 00 00 02 00 00 00 r1 = 2

0000000000000068 :
      13:       bf 10 00 00 00 00 00 00 r0 = r1
      14:       95 00 00 00 00 00 00 00 exit
Skupaj, potrebno je napisati 14 ukazov v obliki struktur tipa struct bpf_insn (nasvet: выполните дамп сверху, перечитайте раздел с инструкциями, откройте in и попытайтесь определить struct bpf_insn insns[] самостоятельно):
struct bpf_insn insns[] = {
    /* 85 00 00 00 08 00 00 00 call 8 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 8,
    },

    /* 63 0a fc ff 00 00 00 00 *(u32 *)(r10 - 4) = r0 */
    {
        .code = BPF_MEM | BPF_STX,
        .off = -4,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_10,
    },

    /* bf a2 00 00 00 00 00 00 r2 = r10 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_10,
        .dst_reg = BPF_REG_2,
    },

    /* 07 02 00 00 fc ff ff ff r2 += -4 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_2,
        .imm = -4,
    },

    /* 18 01 00 00 00 00 00 00 00 00 00 00 00 00 00 00 r1 = 0 ll */
    {
        .code = BPF_LD | BPF_DW | BPF_IMM,
        .src_reg = BPF_PSEUDO_MAP_FD,
        .dst_reg = BPF_REG_1,
        .imm = map_fd,
    },
    { }, /* placeholder */

    /* 85 00 00 00 01 00 00 00 call 1 */
    {
        .code = BPF_JMP | BPF_CALL,
        .imm = 1,
    },

    /* b7 01 00 00 00 00 00 00 r1 = 0 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 0,
    },

    /* 15 00 04 00 00 00 00 00 if r0 == 0 goto +4  */
    {
        .code = BPF_JMP | BPF_JEQ | BPF_K,
        .off = 4,
        .src_reg = BPF_REG_0,
        .imm = 0,
    },

    /* 61 01 00 00 00 00 00 00 r1 = *(u32 *)(r0 + 0) */
    {
        .code = BPF_MEM | BPF_LDX,
        .off = 0,
        .src_reg = BPF_REG_0,
        .dst_reg = BPF_REG_1,
    },

    /* 07 01 00 00 01 00 00 00 r1 += 1 */
    {
        .code = BPF_ALU64 | BPF_ADD | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 1,
    },

    /* 63 10 00 00 00 00 00 00 *(u32 *)(r0 + 0) = r1 */
    {
        .code = BPF_MEM | BPF_STX,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    /* b7 01 00 00 02 00 00 00 r1 = 2 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_K,
        .dst_reg = BPF_REG_1,
        .imm = 2,
    },

    /* : bf 10 00 00 00 00 00 00 r0 = r1 */
    {
        .code = BPF_ALU64 | BPF_MOV | BPF_X,
        .src_reg = BPF_REG_1,
        .dst_reg = BPF_REG_0,
    },

    /* 95 00 00 00 00 00 00 00 exit */
    {
        .code = BPF_JMP | BPF_EXIT
    },
};
Упражнение для тех, кто не стал писать это сам — найдите map_fd.
В нашей программе осталась еще одна нераскрытая часть — xdp_attach. К сожалению, программы типа XDP нельзя подсоединить при помощи системного вызова bpf. Люди, создававшие BPF и XDP, пришли из сетевого сообщества Linux, а значит, они использовали самый привычный для них (но не для нормальных людей) интерфейс взаимодействия с ядром: , см. также . Самый простой способ реализации xdp_attach — это копирование кода из libbpf, а именно, из файла , что мы и проделали, немного укоротив его:
Добро пожаловать в мир netlink сокетов
Открываем netlink сокет типа NETLINK_ROUTE:
int netlink_open(__u32 *nl_pid)
{
    struct sockaddr_nl sa;
    socklen_t addrlen;
    int one = 1, ret;
    int sock;

    memset(&sa, 0, sizeof(sa));
    sa.nl_family = AF_NETLINK;

    sock = socket(AF_NETLINK, SOCK_RAW, NETLINK_ROUTE);
    if (sock < 0)
        err(1, "socket");

    if (setsockopt(sock, SOL_NETLINK, NETLINK_EXT_ACK, &one, sizeof(one)) < 0)
        warnx("netlink error reporting not supported");

    if (bind(sock, (struct sockaddr *)&sa, sizeof(sa)) < 0)
        err(1, "bind");

    addrlen = sizeof(sa);
    if (getsockname(sock, (struct sockaddr *)&sa, &addrlen) < 0)
        err(1, "getsockname");

    *nl_pid = sa.nl_pid;
    return sock;
}
Читаем из такого сокета:
static int bpf_netlink_recv(int sock, __u32 nl_pid, int seq)
{
    bool multipart = true;
    struct nlmsgerr *errm;
    struct nlmsghdr *nh;
    char buf[4096];
    int len, ret;

    while (multipart) {
        multipart = false;
        len = recv(sock, buf, sizeof(buf), 0);
        if (len nlmsg_pid != nl_pid)
                errx(1, "wrong pid");
            if (nh->nlmsg_seq != seq)
                errx(1, "INVSEQ");
            if (nh->nlmsg_flags & NLM_F_MULTI)
                multipart = true;
            switch (nh->nlmsg_type) {
                case NLMSG_ERROR:
                    errm = (struct nlmsgerr *)NLMSG_DATA(nh);
                    if (!errm->error)
                        continue;
                    ret = errm->error;
                    // libbpf_nla_dump_errormsg(nh); too many code to copy...
                    goto done;
                case NLMSG_DONE:
                    return 0;
                default:
                    break;
            }
        }
    }
    ret = 0;
done:
    return ret;
}
Наконец, вот наша функция, которая открывает сокет и посылает в него специальное сообщение, содержащее файловый дескриптор:
static int xdp_attach(int ifindex, int prog_fd)
{
    int sock, seq = 0, ret;
    struct nlattr *nla, *nla_xdp;
    struct {
        struct nlmsghdr  nh;
        struct ifinfomsg ifinfo;
        char             attrbuf[64];
    } req;
    __u32 nl_pid = 0;

    sock = netlink_open(&nl_pid);
    if (sock nla_type = NLA_F_NESTED | IFLA_XDP;
    nla->nla_len = NLA_HDRLEN;

    /* add XDP fd */
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FD;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(int);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &prog_fd, sizeof(prog_fd));
    nla->nla_len += nla_xdp->nla_len;

    /* if user passed in any flags, add those too */
    __u32 flags = XDP_FLAGS_SKB_MODE;
    nla_xdp = (struct nlattr *)((char *)nla + nla->nla_len);
    nla_xdp->nla_type = IFLA_XDP_FLAGS;
    nla_xdp->nla_len = NLA_HDRLEN + sizeof(flags);
    memcpy((char *)nla_xdp + NLA_HDRLEN, &flags, sizeof(flags));
    nla->nla_len += nla_xdp->nla_len;

    req.nh.nlmsg_len += NLA_ALIGN(nla->nla_len);

    if (send(sock, &req, req.nh.nlmsg_len, 0) < 0)
        err(1, "send");
    ret = bpf_netlink_recv(sock, nl_pid, seq);

cleanup:
    close(sock);
    return ret;
}
Tako, sve je spremno za testiranje:
$ cc nolibbpf.c -o nolibbpf
$ sudo strace -e bpf ./nolibbpf
bpf(BPF_MAP_CREATE, {map_type=BPF_MAP_TYPE_ARRAY, map_name="woo", ...}, 72) = 3
bpf(BPF_PROG_LOAD, {prog_type=BPF_PROG_TYPE_XDP, insn_cnt=15, prog_name="woo", ...}, 72) = 4
+++ exited with 0 +++
Pogledajmo, da li se naš program povezao s lo:
$ ip l show dev lo
1: lo:  mtu 65536 xdpgeneric qdisc noqueue state UNKNOWN mode DEFAULT group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    prog/xdp id 160
Pošaljimo pingove i pogledajmo mapu:
$ for s in `seq 234`; do sudo ping -f -c 100 127.0.0.1 >/dev/null 2>&1; done
$ sudo bpftool m dump name woo
key: 00 00 00 00  value: 90 01 00 00 00 00 00 00
key: 01 00 00 00  value: 00 00 00 00 00 00 00 00
key: 02 00 00 00  value: 00 00 00 00 00 00 00 00
key: 03 00 00 00  value: 00 00 00 00 00 00 00 00
key: 04 00 00 00  value: 00 00 00 00 00 00 00 00
key: 05 00 00 00  value: 00 00 00 00 00 00 00 00
key: 06 00 00 00  value: 40 b5 00 00 00 00 00 00
key: 07 00 00 00  value: 00 00 00 00 00 00 00 00
Found 8 elements
Ura, sve radi. Usput, primetite da se naša mapa opet prikazuje u obliku bajtova. To se događa jer, za razliku od libbpf nismo učitali informacije o tipovima (BTF). Ali o tome ćemo razgovarati sledeći put.
Razvojni alati
U ovom odeljku ćemo pogledati minimalni alat za developere BPF-a.
Uopšteno, za razvoj BPF programa nije potrebno ništa posebno — BPF radi na bilo kojoj razumnom distribucijskom jezgru, a programi se sastavljaju pomoću clang, ki ga je mogoče namestiti iz paketa. Vendar pa se, ker je BPF v postopku razvoja, jedro in orodja nenehno spreminjajo, če nočete pisati BPF programov na 'staromoden' način iz leta 2019, boste morali zgraditi
llvm/clangpahole- svoje jedro
bpftool
(Za referenco: ta odsek in vsi primeri v članku so bili zagnani na Debian 10.)
llvm/clang
BPF deluje z LLVM in čeprav je mogoče od nedavnega BPF programe prevajati tudi s gcc, se ves trenutni razvoj izvaja za LLVM. Zato bomo najprej zgradili trenutno različico clang iz git:
$ sudo apt install ninja-build
$ git clone --depth 1 https://github.com/llvm/llvm-project.git
$ mkdir -p llvm-project/llvm/build/install
$ cd llvm-project/llvm/build
$ cmake .. -G "Ninja" -DLLVM_TARGETS_TO_BUILD="BPF;X86"
                      -DLLVM_ENABLE_PROJECTS="clang"
                      -DBUILD_SHARED_LIBS=OFF
                      -DCMAKE_BUILD_TYPE=Release
                      -DLLVM_BUILD_RUNTIME=OFF
$ time ninja
... veliko časa kasneje
$
Zdaj lahko preverimo, ali je vse pravilno zgrajeno:
$ ./bin/llc --version
LLVM (http://llvm.org/):
  Različica LLVM 11.0.0git
  Optimizirana gradnja.
  Privzeti cilj: x86_64-unknown-linux-gnu
  Gostiteljski CPU: znver1

  Registrirani cilji:
    bpf    - BPF (gostiteljski red)
    bpfeb  - BPF (big endian)
    bpfel  - BPF (little endian)
    x86    - 32-bitni X86: Pentium-Pro in novejši
    x86-64 - 64-bitni X86: EM64T in AMD64
(Navodila za gradnjo clang so bila moja iz .)
Ne bomo namestili pravkar zgrajenih programov, temveč jih bomo preprosto dodali v PATH, na primer:
export PATH="`pwd`/bin:$PATH"(To lahko dodate v .bashrc ali v ločeno datoteko. Osebno takšne stvari dodajam v ~/bin/activate-llvm.sh in ko je to potrebno, naredim . activate-llvm.sh.)
Pahole in BTF
Orodje pahole se uporablja pri gradnji jedra za ustvarjanje razhroščevalnih informacij v formatu BTF. O tej tehnologiji BTF ne bomo podrobno razpravljali, razen tega, da je uporabna in jo želimo uporabiti. Zato, če boste gradili svoje jedro, najprej zgradite pahole (brez pahole ne boste mogli zgraditi jedra z možnostjo CONFIG_DEBUG_INFO_BTF:
$ git clone https://git.kernel.org/pub/scm/devel/pahole/pahole.git
$ cd pahole/
$ sudo apt install cmake
$ mkdir build
$ cd build/
$ cmake -D__LIB=lib ..
$ make
$ sudo make install
$ which pahole
/usr/local/bin/pahole
Jedra za eksperimente z BPF
Ko raziskovanju možnosti BPF je dobro zgraditi svoje jedro. To na splošno ni nujno, saj lahko zbirate in nalagate programe BPF tudi na distribucijskem jedru, vendar pa vam lastno jedro omogoča uporabo najnovejših možnosti BPF, ki se v vaši distribuciji povprečno pojavijo šele čez mesece ali pa, kot v primeru nekaterih orodij za odpravljanje napak, sploh ne bodo pakirana v bližnji prihodnosti. Prav tako vam lastno jedro omogoča, da se počutite pomembne in eksperimentirate s kodo.
Za izgradnjo jedra potrebujete, najprej, samo jedro, in drugič, datoteko konfiguracije jedra. Za eksperimentiranje z BPF lahko uporabimo običajno jedro ali eno od razvijalskih jeder. Zgodovinsko gledano se je razvoj BPF odvijal v okviru mrežne skupnosti Linux, zato vse spremembe рано ali pozno preidejo skozi Davida Millera — vzdrževalca mrežnega dela Linuxa. Glede na svojo naravo — popravki ali nove funkcije — mrežne spremembe končajo v enem od dveh jeder — ili . Spremembe za BPF se na enak način porazdelijo med in , ki se nato pošljejo v net in net-next, ustrezno. Več si oglejte v in . Torej izberite jedro glede na svoje okuse in potrebe po stabilnosti sistema, na katerem testirate (*-next jedra so najbolj nestabilna med naštetimi).
V sklopu tega članka ni razloženo, kako upravljati s datotekami konfiguracije jedra — predpostavlja se, da to že znate ali se sami. Vendar pa bi morale biti naslednje navodila, bolj ali manj, dovolj, da boste imeli delujoči sistem s podporo za BPF.
Prenesite eno od zgoraj omenjenih jeder:
$ git clone git://git.kernel.org/pub/scm/linux/kernel/git/bpf/bpf-next.git
$ cd bpf-next
Zgradite minimalno delujočo konfiguracijo jedra:
$ cp /boot/config-`uname -r` .config
$ make localmodconfig
Vklopite možnosti BPF v datoteki .config po svoji izbiri (najverjetneje bo že CONFIG_BPF vklopljen, saj ga uporablja systemd). Tu je seznam možnosti iz jedra, ki je bilo uporabljeno za ta članek:
CONFIG_CGROUP_BPF=y
CONFIG_BPF=y
CONFIG_BPF_LSM=y
CONFIG_BPF_SYSCALL=y
CONFIG_ARCH_WANT_DEFAULT_BPF_JIT=y
CONFIG_BPF_JIT_ALWAYS_ON=y
CONFIG_BPF_JIT_DEFAULT_ON=y
CONFIG_IPV6_SEG6_BPF=y
# CONFIG_NETFILTER_XT_MATCH_BPF is not set
# CONFIG_BPFILTER is not set
CONFIG_NET_CLS_BPF=y
CONFIG_NET_ACT_BPF=y
CONFIG_BPF_JIT=y
CONFIG_BPF_STREAM_PARSER=y
CONFIG_LWTUNNEL_BPF=y
CONFIG_HAVE_EBPF_JIT=y
CONFIG_BPF_EVENTS=y
CONFIG_BPF_KPROBE_OVERRIDE=y
CONFIG_DEBUG_INFO_BTF=y
Далее мы можем легко собрать и установить модули и ядро (кстати, можно собрать ядро при помощи только что собранного clang, добавив CC=clang):
$ make -s -j $(getconf _NPROCESSORS_ONLN)
$ sudo make modules_install
$ sudo make install
и перезагрузиться с новым ядром (я использую для этого kexec iz paketa kexec-tools):
v=5.8.0-rc6+ # если вы пересобираете текущее ядро, то можно делать v=`uname -r`
sudo kexec -l -t bzImage /boot/vmlinuz-$v --initrd=/boot/initrd.img-$v --reuse-cmdline &&
sudo kexec -e
bpftool
Наиболее часто используемой утилитой в статье будет утилита bpftool, поставляемая в составе ядра Linux. Она написана и поддерживается разработчиками BPF для разработчиков BPF и с ее помощью можно управляться со всеми типами объектов BPF — загружать программы, создавать и изменять maps, исследовать жизнедеятельность экосистемы BPF, и т.п. Документацию в виде исходников к man pages можно найти или, уже скомпилированную, .
Ob času pisanja članka bpftool поставляется в готовом виде только для RHEL, Fedora и Ubuntu (см., например, , в котором рассказывается неоконченная история опакечивания bpftool в Debian). Но если вы уже собрали свое ядро, то собрать bpftool проще простого:
$ cd ${linux}/tools/bpf/bpftool
# ... пропишите пути к последнему clang, как рассказано выше
$ make -s

Auto-detecting system features:
...                        libbfd: [ on  ]
...        disassembler-four-args: [ on  ]
...                          zlib: [ on  ]
...                        libcap: [ on  ]
...               clang-bpf-co-re: [ on  ]

Auto-detecting system features:
...                        libelf: [ on  ]
...                          zlib: [ on  ]
...                           bpf: [ on  ]

$
(здесь ${linux} — это ваша директория с ядром.) После выполнения этих команд bpftool будет собрана в директории ${linux}/tools/bpf/bpftool и ее можно будет прописать в путь (прежде всего пользователю root) или просто скопировать в /usr/local/sbin.
Собирать bpftool лучше всего при помощи последнего clang, собранного, как рассказано выше, а проверить, правильно ли она собралась — при помощи, например, команды
$ sudo bpftool feature probe kernel
Scanning system configuration...
bpf() syscall for unprivileged users is enabled
JIT compiler is enabled
JIT compiler hardening is disabled
JIT compiler kallsyms exports are enabled for root
...
которая покажет, какие фичи BPF включены у вас в ядре.
Кстати, предыдущую команду можно запустить как
# bpftool f p kЭто сделано по аналогии с утилитами из пакета iproute2, kjer lahko na primer rečemo ip a s eth0 namesto ip addr show dev eth0.
Zaključek
BPF omogoča učinkovito merjenje in dinamično spreminjanje funkcionalnosti jedra. Sistem se je izkazal za zelo uspešnega, v najboljših tradicijah UNIX-a: preprost mehanizem, ki omogoča (pre)programiranje jedra, je ogromnemu številu ljudi in organizacij omogočil eksperimentiranje. Čeprav eksperimentiranje, kot tudi razvoj same infrastrukture BPF, še zdaleč ni končano, sistem že ima stabilno ABI, ki omogoča gradnjo zanesljive in, kar je najpomembnejše, učinkovite poslovne logike.
Omeniti je treba, da je po meni tehnologija tako priljubljena, ker lahko po eni strani igrajo (arhitekturo stroja lahko razumemo bolj-če ali manj v enem večeru), po drugi strani pa rešujejo naloge, ki jih pred njenim pojavom ni bilo mogoče rešiti (lepo). Ti dve komponenti skupaj spodbujata ljudi k eksperimentiranju in sanjanju, kar privede do novih in novih inovativnih rešitev.
Ta članek, četudi ni posebej kratek, predstavlja le uvod v svet BPF in ne opisuje 'naprednih' možnosti ter pomembnih delov arhitekture. Nadaljnji načrt je približno tak: naslednji članek bo pregled tipov programov BPF (v jedru 5.8 je podprtih 30 tipov programov), nato se bomo končno poglobili v to, kako napisati prave aplikacije za BPF z uporabo programov za sledenje jedru, nato pa bo prišel čas za bolj poglobljen tečaj o arhitekturi BPF, sledili pa bodo primeri mrežnih in varnostnih aplikacij BPF.
Prejšnji članki te serije
Povezave
— dokumentacija o BPF od cilium, natančneje od Daniela Borkmana, enega izmed ustvarjalcev in vzdrževalcev BPF. To je eno prvih resnih opisov, ki se od drugih odlikuje po tem, da Daniel natanko ve, o čem piše in napak tam ni. V tem dokumentu se posebej obravnava, kako delati s programi BPF tipov XDP in TC s pomočjo znane enote
ipiz paketaiproute2.— izvirni dokument z dokumentacijo o klasičnem in nato razširjenem BPF. Koristno je brati, če želite raziskovati assembler in tehnične podrobnosti arhitekture.
. Redko se posodablja, a točno, saj vanj pišeta Alexei Starovoitov (avtor eBPF) in Andrii Nakryiko — (vzdrževalec
libbpf).. Zanimljiv Twitter thread od Quentina Monneta s primjerima i tajnama korištenja bpftool.
. Ogroman (i dalje podržavan) popis linkova na dokumentaciju o BPF-u od Quentina Monneta.
Izvor: habr.com
